

V svoji pracy se často setkávám s novými technickými řešeními/softwarovými produkty, o nichž je na českém internetu málo informací. Touto článkem se pokusím zaplnit jednu takovou mezeru příkladem z nedávné praxe, kdy bylo potřeba nastavit odesílání CDC událostí z dvou populárních DBMS (PostgreSQL a MongoDB) do Kafka clusteru pomocí Debezia. Doufám, že tento přehledný článek, který vznikl na základě provedené práce, bude užitečný i dalším.
Co je Debezium a vlastně CDC?
je zástupce kategorie softwaru CDC (), a přesněji řečeno, je to soubor konektorů pro různé DBMS, které jsou kompatibilní s rámcem Apache Kafka Connect.
To který používá licenci Apache License v2.0 a je sponzorován společností Red Hat. Vývoj započal v roce 2016 a v současnosti má oficiální podporu pro následující DBMS: MySQL, PostgreSQL, MongoDB, SQL Server. K dispozici jsou také konektory pro Cassandru a Oracle, ale ty jsou v současnosti ve stavu 'early access' a nové verze nezaručují zpětnou kompatibilitu.
Pokud srovnáme CDC s tradičním přístupem (kdy aplikace čte data přímo z DBMS), pak jeho hlavními výhodami jsou realizace streamování změny dat na úrovni řádků s nízkou latencí, vysokou spolehlivostí a dostupností. Poslední dva body jsou dosaženy díky použití clusteru Kafka jako úložiště CDC událostí.
Dalšími výhodami je fakt, že pro ukládání událostí se používá jednotný model, takže koncová aplikace se nemusí starat o nuance používání různých DBMS.
Nakonec, díky použití zprostředkovatele zpráv se otevírá prostor pro horizontální škálování aplikací, které sledují změny v datech. Přitom je vliv na zdroj dat minimalizován, protože získávání dat probíhá nikoli přímo z DBMS, ale z clusteru Kafka.
O architektuře Debezium
Použití Debezia lze shrnout do takto jednoduché schémy:
DBMS (jako zdroj dat) → konektor v Kafka Connect → Apache Kafka → konzument
Jako ilustraci uvedu schéma z webu projektu:
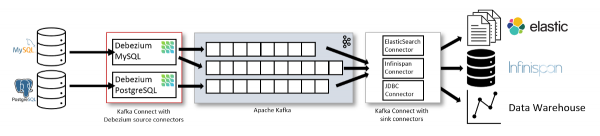
Tato schéma se mi však moc nelíbí, protože vyvolává dojem, že je možné pouze použití sink konektoru.
V resnici se situacija razlikuje: polnjenje vaše Data Lake (zadnji člen na zgornji shemi) — to ni edini način uporabe Debezium. Dogodki, posredovani v Apache Kafka, se lahko uporabljajo v vaših aplikacijah za reševanje različnih situacij. Na primer:
- odstranjevanje zastarelih podatkov iz predpomnilnika;
- pošiljanje obvestil;
- posodobitve iskalnih indeksov;
- nekaj podobnega dnevnikom revizije;
- …
V primeru, da imate aplikacijo v Javi in nimate potrebe/možnosti uporabljati klaster Kafka, obstaja tudi možnost dela preko . Očitna prednost je v tem, da se lahko odpoveste dodatni infrastrukturi (v obliki konektorja in Kafka). Vendar je ta rešitev od različice 1.1 razglašena za zastarelo (deprecated) in ni več priporočljiva za uporabo (v prihodnjih različicah morda ne bo več podprta).
V tem članku bomo obravnavali priporočeno arhitekturo, ki jo predlagajo razvijalci in ki zagotavlja odpornost na okvare ter možnost skaliranja.
Konfiguracija konektorja
Da bi začeli spremljati spremembe najpomembnejše vrednosti — podatkov, — potrebujemo:
- vir podatkov, ki je lahko MySQL od različice 5.7, PostgreSQL 9.6+, MongoDB 3.2+ ();
- klaster Apache Kafka;
- instanco Kafka Connect (različice 1.x, 2.x);
- konfiguriran konektor Debezium.
Dela pri prvih dveh točkah, tj. postopek namestitve DBMS in Apache Kafka, presegajo okvir članka. Vendar pa za tiste, ki želijo vse razporediti v peskovniku, v uradnem repozitoriju s primeri obstaja pripravljen .
Mi pa se bomo bolj podrobno osredotočili na zadnji dve točki.
0. Kafka Connect
Tukaj in v nadaljevanju članka so vsi primeri konfiguracije obravnavani v kontekstu Docker-slike, ki jo distribuirajo razvijalci Debezium. Vsebuje vse potrebne datoteke vtičnikov (konektorje) in omogoča konfiguracijo Kafka Connect s pomočjo okolijskih spremenljivk.
V primeru, da je predvidena uporaba Kafka Connect od Confluent, bo treba samostojno dodati vtičnike potrebnih konektorjev v direktorij, ki je naveden v plugin.path ali določen s pomočjo okoljske spremenljivke CLASSPATH. Nastavitve delavca Kafka Connect in konektorjev so določene preko konfiguracijskih datotek, ki se posredujejo kot argumenti ukazu za zagon delavca. Več informacij najdete v .
Celoten postopek nastavitve Debeziuma z vtičnikom poteka v dveh fazah. Oglejmo si vsako od njih:
1. Nastavitev okvira Kafka Connect
Za pretakanje podatkov v grozd Apache Kafka v okviru Kafka Connect se določajo specifični parametri, kot so:
- parametri za povezavo z grozdom,
- imena tem, v katerih bo shranjena dejanska konfiguracija samega vtičnika,
- ime skupine, v kateri je vtičnik zagnan (v primeru uporabe distribuiranega načina).
Uradna Docker slika projekta podpira konfiguracijo s pomočjo okoljskih spremenljivk - to bomo izkoristili. Torej, prenesemo sliko:
docker pull debezium/connectMinimalni komplet okoljskih spremenljivk, potrebnih za zagon vtičnika, izgleda takole:
-
BOOTSTRAP_SERVERS=kafka-1:9092,kafka-2:9092,kafka-3:9092— začetni seznam strežnikov grozda Kafka za pridobitev celotnega seznama članov grozda; -
OFFSET_STORAGE_TOPIC=connector-offsets— tema za shranjevanje položajev, na katerih se trenutno nahaja vtičnik; -
CONNECT_STATUS_STORAGE_TOPIC=connector-status— tema za shranjevanje statusa vtičnika in njegovih nalog; -
CONFIG_STORAGE_TOPIC=connector-config— tema za shranjevanje podatkov o konfiguraciji vtičnika in njegovih nalog; -
GROUP_ID=1— identifikator skupine delavcev, na katerih se lahko izvaja naloga vtičnika; potreben pri uporabi distribuiranega (distributed) načina.
Zaženemo kontejner s temi spremenljivkami:
docker run
  -e BOOTSTRAP_SERVERS='kafka-1:9092,kafka-2:9092,kafka-3:9092'
  -e GROUP_ID=1
  -e CONFIG_STORAGE_TOPIC=my_connect_configs
  -e OFFSET_STORAGE_TOPIC=my_connect_offsets
  -e STATUS_STORAGE_TOPIC=my_connect_statuses  debezium/connect:1.2
Opomba o Avro
Privzeto Debezium zapisuje podatke v formatu JSON, kar je sprejemljivo za peskovnike in majhne količine podatkov, vendar lahko postane težava pri visoko obremenjenih bazah. Alternativa JSON pretvorniku je serializacija sporočil s pomočjo v binarni format, kar zmanjšuje obremenitev na sistemu I/O v Apache Kafka.
Za uporabo Avra je potrebno namestiti ločen (za shranjevanje shem). Spremenljivke za pretvornik bodo izgledale takole:
name: CONNECT_VALUE_CONVERTER_SCHEMA_REGISTRY_URL
value: http://kafka-registry-01:8081/
name: CONNECT_KEY_CONVERTER_SCHEMA_REGISTRY_URL
value: http://kafka-registry-01:8081/
name: VALUE_CONVERTER
value: io.confluent.connect.avro.AvroConverter
Podrobnosti o uporabi Avra in nastavitvi registryja presegajo obseg tega članka - nadalje za prikaz bomo uporabili JSON.
2. Nastavitev samega konnektorja
Sedaj se lahko neposredno lotimo konfiguracije samega konnektorja, ki bo bral podatke iz vira.
Osredotočili se bomo na primere konnektorjev za dve SDB: PostgreSQL in MongoDB, pri katerih imam izkušnje in obstajajo razlike (čeprav majhne, so v nekaterih primerih lahko bistvene!).
Konfiguracija je opisana v JSON notaciji in se naloži v Kafka Connect s pomočjo POST zahteve.
2.1. PostgreSQL
Primer konfiguracije konnektorja za PostgreSQL:
{
  "name": "pg-connector",
  "config": {
    "connector.class": "io.debezium.connector.postgresql.PostgresConnector",
    "plugin.name": "pgoutput",
    "database.hostname": "127.0.0.1",
    "database.port": "5432",
    "database.user": "debezium",
    "database.password": "definitelynotpassword",
    "database.dbname" : "dbname",
    "database.server.name": "pg-dev",
    "table.include.list": "public.(.*)",
    "heartbeat.interval.ms": "5000",
    "slot.name": "dbname_debezium",
    "publication.name": "dbname_publication",
    "transforms": "AddPrefix",
    "transforms.AddPrefix.type": "org.apache.kafka.connect.transforms.RegexRouter",
    "transforms.AddPrefix.regex": "pg-dev.public.(.*)",
    "transforms.AddPrefix.replacement": "data.cdc.dbname"
  }
}
Načelo delovanja konnektorja po takšni nastavitvi je precej preprosto:
- Ob prvem zagonu se poveže z bazo, navedeno v konfiguraciji, in se zažene v načinu initial snapshot, pošiljajoč v Kafka začetni niz podatkov, pridobljenih z uporabo pogojnega
SELECT * FROM table_name. - Ko bo inicializacija zaključena, konnektor preide v način branja sprememb iz WAL datotek PostgreSQL.
O uporabljenih možnostih:
-
name— ime konnektorja, za katerega se uporablja konfiguracija, opisana spodaj; to ime se nato uporablja za delo s konnektorjem (tj. za ogled statusa / ponovni zagon / posodobitev konfiguracije) preko REST API Kafka Connect; -
connector.class— razred konnektorja SDB, ki ga bo uporabljal konfigurirani konnektor; -
plugin.name— ime vtičnika za logično dekodiranje podatkov iz WAL datotek. Na voljo sowal2json,decoderbuffsinpgoutput. Prva dva zahtevata namestitev ustreznih razširitev v SDB, medtem kopgoutputza PostgreSQL različice 10 in višje to ne zahteva dodatnih manipulacij; -
database.*— možnosti za povezavo z BDB, kjerdatabase.server.name— ime instance PostgreSQL, ki se uporablja za oblikovanje imena teme v klastru Kafka; -
table.include.list— seznam tabel, v katerih želimo spremljati spremembe; določa se v formatuschema.table_name; ni mogoče uporabiti skupaj ztable.exclude.list; -
heartbeat.interval.ms— interval (in milliseconds) at which the connector sends heartbeat messages to a specific topic; -
heartbeat.action.query— the query that will be executed when sending each heartbeat message (this option was introduced in version 1.1); -
slot.name— the name of the replication slot that will be used by the connector; publication.name— name in PostgreSQL that the connector uses. If it does not exist, Debezium will attempt to create it. If the user connected does not have sufficient permissions for this action, the connector will terminate with an error;-
transformsdefines how to modify the name of the target topic:-
transforms.AddPrefix.typeindicates that we will use regular expressions; -
transforms.AddPrefix.regex— the pattern by which the name of the target topic is overridden; -
transforms.AddPrefix.replacement— the actual value to which we will override.
-
More about heartbeat and transforms
By default, the connector sends data to Kafka with each committed transaction, and its LSN (Log Sequence Number) is recorded in a service topic offset. But what will happen if the connector is set to read not the entire database but only a part of its tables (where data updates do not occur frequently)?
- The connector will read WAL files and not detect commits in the transactions in those tables it is monitoring.
- Therefore, it will not update its current position in either the topic or the replication slot.
- This, in turn, will lead to the 'holding' of WAL files on the disk and the potential exhaustion of all disk space.
And here the options come to the rescue. heartbeat.interval.ms in heartbeat.action.queryUsing these options in tandem allows you to execute a query to modify data in a separate table each time a heartbeat message is sent. Thus, the LSN, at which the connector currently stands (in the replication slot), is constantly updated. This allows the DBMS to delete WAL files that are no longer needed. To learn more about how the options work, you can consult .
Another option worth closer attention is transforms. Although it is more about convenience and aesthetics...
By default, Debezium creates topics based on the following naming policy: serverName.schemaName.tableName. This is not always convenient. Options transforms s pomočjo regularnih izrazov je možno določiti seznam tabel, katerih dogodke je treba usmeriti v temo z določenim imenom.
V naši konfiguraciji zahvaljujoč Na koncu opisa konfiguracije konektorja za PostgreSQL je vredno omeniti naslednje posebnosti/omejitve njegovega delovanja: Torej, naložimo našo konfiguracijo v konektor: Preverjamo, da je nalaganje uspelo in da se je konektor zagnal: Odlično: nastavljen je in pripravljen za delo. Zdaj se pretvarjamo, da smo potrošniki, in se povežemo z Kafka, nato pa dodamo in spremenimo zapis v tabeli: V naši temi se bo to prikazalo na naslednji način: Zelo dolg JSON z našimi spremembami V obeh primerih zapisi sestavljajo ključ (PK) zapisa, ki je bil spremenjen, in neposredno samo bistvo sprememb: kakšen je bil zapis pred in kakšen je zdaj. Ta konektor uporablja standardni mehanizem replikacije MongoDB, ki bere informacije iz oplog-a primarnega vozlišča DB. Podobno kot pri že opisanem konektorju za PgSQL, se tudi tukaj ob prvem zagonu posname primarni snapshot podatkov, po čemer se konektor preklopi v način branja oplog-a. Primer konfiguracije: Kot lahko opazite, tu ni novih možnosti v primerjavi s prejšnjim primerom, vendar se je zmanjšalo le število možnosti, ki so odgovorne za povezovanje z DB in njihovimi prefiksami. Nastavitve Vprašanje odpornosti in visoke razpoložljivosti je danes pomembnejše kot kdaj koli prej — še posebej, ko govorimo o podatkih in transakcijah, in spremljanje sprememb podatkov ne stoji ob strani. Poglejmo, kaj lahko sploh gre narobe in kaj se bo zgodilo z Debeziumom v vsakem od primerov. Obstajajo tri možnosti odpovedi: Vendar pa obstajajo izjeme. Če je konektor dlje časa ostal izključen (ali se ni mogel povezati s primerkom MongoDB), medtem ko je oplog medtem šel v rotacijo, bo konektor ob ponovni vzpostavitvi povezave mirno nadaljeval z branjem podatkov z prve dostopne pozicije, kar bo povzročilo, da bo del podatkov v Kafka ne prispe. Debezium je moje prvo izkušnjo z CDC sistemi in na splošno zelo pozitivno. Projekt me je prepričal s podporo glavnim DBMS, enostavno konfiguracijo, podporo za klasterizacijo in aktivno skupnostjo. Tistim, ki jih zanima praksa, toplo priporočam, da si ogledajo vodnike za in . V primerjavi z JDBC konektorjem za Kafka Connect je glavna prednost Debezium, da se spremembe berejo iz dnevnikov DBMS, kar omogoča pridobivanje podatkov z minimalno zakasnitvijo. JDBC konektor (iz ponudbe Kafka Connect) izvaja poizvedbe na spremljani tabeli z fiksnimi intervali in (iz istega razloga) ne generira sporočil ob brisanju podatkov (kako lahko zahtevate podatke, ki ne obstajajo?). Za reševanje podobnih nalog lahko upoštevate naslednje rešitve (poleg Debezium): Preberite tudi na našem blogu: Izvor: habr.comtransforms se dogaja naslednje: vsi CDC dogodki iz spremljane Baze podatkov bodo prišli v temo z imenom data.cdc.dbname. V nasprotnem primeru (brez teh nastavitev) bi Debezium privzeto ustvaril temo za vsako tabelo v obliki: pg-dev.public..
Omejitve konektorja
Uporaba konfiguracije
curl -i -X POST -H "Accept:application/json"
-H "Content-Type:application/json" http://localhost:8083/connectors/
-d @pg-con.json$ curl -i http://localhost:8083/connectors/pg-connector/status
HTTP/1.1 200 OK
Date: Thu, 17 Sep 2020 20:19:40 GMT
Content-Type: application/json
Content-Length: 175
Server: Jetty(9.4.20.v20190813)
{"name":"pg-connector","connector":{"state":"RUNNING","worker_id":"172.24.0.5:8083"},"tasks":[{"id":0,"state":"RUNNING","worker_id":"172.24.0.5:8083"}],"type":"source"}$ kafka/bin/kafka-console-consumer.sh
--bootstrap-server kafka:9092
--from-beginning
--property print.key=true
--topic data.cdc.dbname
postgres=# insert into customers (id, first_name, last_name, email) values (1005, 'foo', 'bar', 'foo@bar.com');
INSERT 0 1
postgres=# update customers set first_name = 'egg' where id = 1005;
UPDATE 1{
"schema":{
"type":"struct",
"fields":[
{
"type":"int32",
"optional":false,
"field":"id"
}
],
"optional":false,
"name":"data.cdc.dbname.Key"
},
"payload":{
"id":1005
}
}{
"schema":{
"type":"struct",
"fields":[
{
"type":"struct",
"fields":[
{
"type":"int32",
"optional":false,
"field":"id"
},
{
"type":"string",
"optional":false,
"field":"first_name"
},
{
"type":"string",
"optional":false,
"field":"last_name"
},
{
"type":"string",
"optional":false,
"field":"email"
}
],
"optional":true,
"name":"data.cdc.dbname.Value",
"field":"before"
},
{
"type":"struct",
"fields":[
{
"type":"int32",
"optional":false,
"field":"id"
},
{
"type":"string",
"optional":false,
"field":"first_name"
},
{
"type":"string",
"optional":false,
"field":"last_name"
},
{
"type":"string",
"optional":false,
"field":"email"
}
],
"optional":true,
"name":"data.cdc.dbname.Value",
"field":"after"
},
{
"type":"struct",
"fields":[
{
"type":"string",
"optional":false,
"field":"version"
},
{
"type":"string",
"optional":false,
"field":"connector"
},
{
"type":"string",
"optional":false,
"field":"name"
},
{
"type":"int64",
"optional":false,
"field":"ts_ms"
},
{
"type":"string",
"optional":true,
"name":"io.debezium.data.Enum",
"version":1,
"parameters":{
"allowed":"true,last,false"
},
"default":"false",
"field":"snapshot"
},
{
"type":"string",
"optional":false,
"field":"db"
},
{
"type":"string",
"optional":false,
"field":"schema"
},
{
"type":"string",
"optional":false,
"field":"table"
},
{
"type":"int64",
"optional":true,
"field":"txId"
},
{
"type":"int64",
"optional":true,
"field":"lsn"
},
{
"type":"int64",
"optional":true,
"field":"xmin"
}
],
"optional":false,
"name":"io.debezium.connector.postgresql.Source",
"field":"source"
},
{
"type":"string",
"optional":false,
"field":"op"
},
{
"type":"int64",
"optional":true,
"field":"ts_ms"
},
{
"type":"struct",
"fields":[
{
"type":"string",
"optional":false,
"field":"id"
},
{
"type":"int64",
"optional":false,
"field":"total_order"
},
{
"type":"int64",
"optional":false,
"field":"data_collection_order"
}
],
"optional":true,
"field":"transaction"
}
],
"optional":false,
"name":"data.cdc.dbname.Envelope"
},
"payload":{
"before":null,
"after":{
"id":1005,
"first_name":"foo",
"last_name":"bar",
"email":"foo@bar.com"
},
"source":{
"version":"1.2.3.Final",
"connector":"postgresql",
"name":"dbserver1",
"ts_ms":1600374991648,
"snapshot":"false",
"db":"postgres",
"schema":"public",
"table":"customers",
"txId":602,
"lsn":34088472,
"xmin":null
},
"op":"c",
"ts_ms":1600374991762,
"transaction":null
}
}{
"schema":{
"type":"struct",
"fields":[
{
"type":"int32",
"optional":false,
"field":"id"
}
],
"optional":false,
"name":"data.cdc.dbname.Key"
},
"payload":{
"id":1005
}
}{
"schema":{
"type":"struct",
"fields":[
{
"type":"struct",
"fields":[
{
"type":"int32",
"optional":false,
"field":"id"
},
{
"type":"string",
"optional":false,
"field":"first_name"
},
{
"type":"string",
"optional":false,
"field":"last_name"
},
{
"type":"string",
"optional":false,
"field":"email"
}
],
"optional":true,
"name":"data.cdc.dbname.Value",
"field":"before"
},
{
"type":"struct",
"fields":[
{
"type":"int32",
"optional":false,
"field":"id"
},
{
"type":"string",
"optional":false,
"field":"first_name"
},
{
"type":"string",
"optional":false,
"field":"last_name"
},
{
"type":"string",
"optional":false,
"field":"email"
}
],
"optional":true,
"name":"data.cdc.dbname.Value",
"field":"after"
},
{
"type":"struct",
"fields":[
{
"type":"string",
"optional":false,
"field":"version"
},
{
"type":"string",
"optional":false,
"field":"connector"
},
{
"type":"string",
"optional":false,
"field":"name"
},
{
"type":"int64",
"optional":false,
"field":"ts_ms"
},
{
"type":"string",
"optional":true,
"name":"io.debezium.data.Enum",
"version":1,
"parameters":{
"allowed":"true,last,false"
},
"default":"false",
"field":"snapshot"
},
{
"type":"string",
"optional":false,
"field":"db"
},
{
"type":"string",
"optional":false,
"field":"schema"
},
{
"type":"string",
"optional":false,
"field":"table"
},
{
"type":"int64",
"optional":true,
"field":"txId"
},
{
"type":"int64",
"optional":true,
"field":"lsn"
},
{
"type":"int64",
"optional":true,
"field":"xmin"
}
],
"optional":false,
"name":"io.debezium.connector.postgresql.Source",
"field":"source"
},
{
"type":"string",
"optional":false,
"field":"op"
},
{
"type":"int64",
"optional":true,
"field":"ts_ms"
},
{
"type":"struct",
"fields":[
{
"type":"string",
"optional":false,
"field":"id"
},
{
"type":"int64",
"optional":false,
"field":"total_order"
},
{
"type":"int64",
"optional":false,
"field":"data_collection_order"
}
],
"optional":true,
"field":"transaction"
}
],
"optional":false,
"name":"data.cdc.dbname.Envelope"
},
"payload":{
"before":{
"id":1005,
"first_name":"foo",
"last_name":"bar",
"email":"foo@bar.com"
},
"after":{
"id":1005,
"first_name":"egg",
"last_name":"bar",
"email":"foo@bar.com"
},
"source":{
"version":"1.2.3.Final",
"connector":"postgresql",
"name":"dbserver1",
"ts_ms":1600375609365,
"snapshot":"false",
"db":"postgres",
"schema":"public",
"table":"customers",
"txId":603,
"lsn":34089688,
"xmin":null
},
"op":"u",
"ts_ms":1600375609778,
"transaction":null
}
}
INSERT: vrednost pred (before) je enaka null, po tem pa je niz, ki je bil dodan. UPDATE: v payload.before se prikaže prejšnje stanje niza, v payload.after pa je novo z bistvom sprememb.2.2 MongoDB
{
"name": "mp-k8s-mongo-connector",
"config": {
"connector.class": "io.debezium.connector.mongodb.MongoDbConnector",
"tasks.max": "1",
"mongodb.hosts": "MainRepSet/mongo:27017",
"mongodb.name": "mongo",
"mongodb.user": "debezium",
"mongodb.password": "dbname",
"database.whitelist": "db_1,db_2",
"transforms": "AddPrefix",
"transforms.AddPrefix.type": "org.apache.kafka.connect.transforms.RegexRouter",
"transforms.AddPrefix.regex": "mongo.([a-zA-Z_0-9]*).([a-zA-Z_0-9]*)",
"transforms.AddPrefix.replacement": "data.cdc.mongo_$1"
}
}transforms tokrat naredijo naslednje: spremenijo ime ciljne teme iz sheme .. u data.cdc.mongo_.Odporna zasnova
Zaključek
P.S.
