

V letu 2010 je imelo podjetje 50 strežnikov in preprost omrežni model: backend, frontend in požarni zid. Število strežnikov se je povečevalo, model pa se je zapletel: stadi, izolirani VLAN z ACL, nato VPN z VRF, VLAN z ACL na L2, VRF z ACL na L3. Se vam je zavrtelo? Naprej bo še bolj zabavno.
Ko je število strežnikov naraslo na 16.000, je bilo nemogoče delati brez solz s tako velikim številom raznolikih segmentov. Zato so prišli do druge rešitve. Vzeli so sklad Netfilter, mu dodali Consul kot vir podatkov in dobili hiter distribucijski požarni zid. S tem so nadomestili ACL na usmerjevalnikih in ga uporabljali kot zunanji in notranji požarni zid. Za dinamično upravljanje z orodjem so razvili sistem BEFW, ki so ga uporabili povsod: od upravljanja dostopa uporabnikov v proizvodno omrežje do izolacije segmentov omrežja drug od drugega.
Kako vse to deluje in zakaj bi se morali zanimati za ta sistem, bo predstavil Ivan Agarokov () — vodja skupine infrastrukturne varnosti oddelka Maintenance v Minskem razvojnem centru podjetja. Ivan je oboževalec SELinux, ljubi Perl, piše kodo. Kot vodja skupine za varnost informacij redno dela z logi, varnostnimi kopijami in R&D, da zaščiti Wargaming pred hekerji in zagotovi nemoteno delovanje vseh igralnih strežnikov v podjetju.
Zgodovinski pregled
Preden povem, kako smo to počeli, bom razložil, kako smo sploh prišli do tega in zakaj je bilo to potrebno. Zato se vrnimo devet let nazaj: leto 2010, ko so se prvič pojavile igre World of Tanks. Podjetje Wargaming je imelo približno 50 strežnikov.
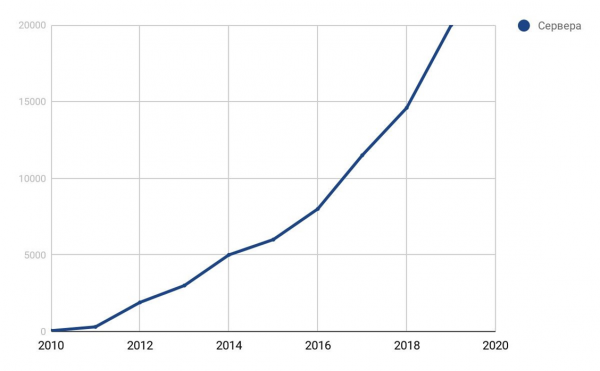
Graf rasti strežnikov podjetja.
Imeli smo omrežni model. Za tisti čas je bil najboljši.
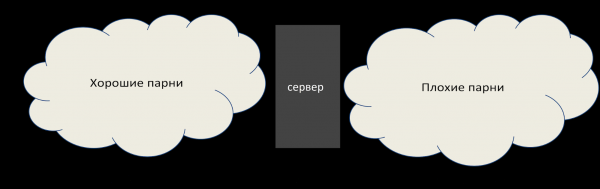
Omrežni model leta 2010.
Na frontend-u živijo slabi fantje, ki nas želijo zlomi, vendar tam obstaja požarni zid. Na backendu pa ni požarnega zida, vendar tam deluje 50 strežnikov, vse jih poznamo. Vse deluje dobro.
V štirih letih se je število strežnikov povečalo 100-krat, na 5000. Pojavili so se prvi izolirani omrežja — stadi: ne morejo v produkcijo, pogosto pa so se tam vrteli nevarni elementi.
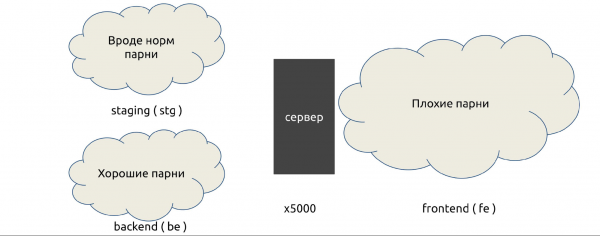
Omrežni model leta 2014.
Po inerciji so uporabljali iste strojne naprave in vse delo je potekalo na izoliranih VLAN: na VLAN-ih so zapisani ACL, ki dovolijo ali prepovejo določeno povezavo.
V letu 2016 je število strežnikov doseglo 8000. Wargaming je prevzel druge studije, pojavile so se dodatne partnerske mreže. Teoretično so naši, a niso popolnoma: za partnerje VLAN pogosto ne deluje, zato je potrebno uporabiti VPN z VRF, izolacije pa se zapletajo. Mešanica izolacij ACL je naraščala.
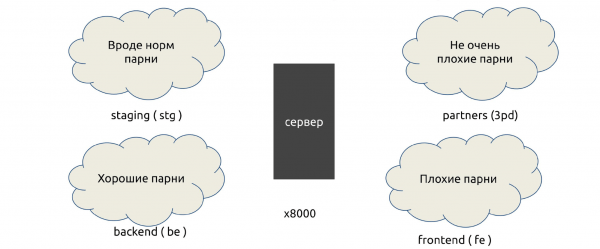
Mrežni model v letu 2016.
Do začetka leta 2018 je število strojev naraslo na 16.000. Imeli smo 6 segmentov, ostale smo ignorirali, vključno s skritimi, v katerih so bili shranjeni finančni podatki. Pojavili so se omrežni kontejnerji (Kubernetes), DevOps, oblačna omrežja, povezana preko VPN, na primer iz IWS. Pravil je bilo preveč – bilo je boleče.
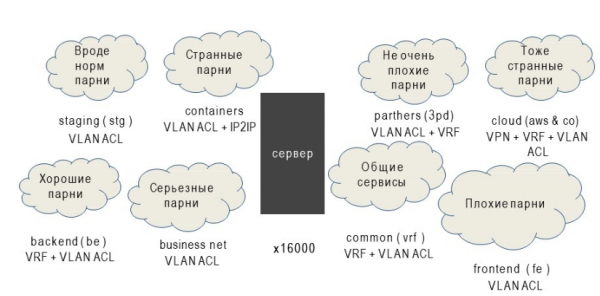
Mrežni model in načini izolacije v letu 2018.
Za izolacijo smo uporabljali: VLAN z ACL na L2, VRF z ACL na L3, VPN in še marsikaj drugega. Preveč je bilo.
Težave
Vsi živijo z ACL in VLAN. Kaj je sploh narobe? Na to vprašanje bo odgovoril Harold, ki skriva bolečino.
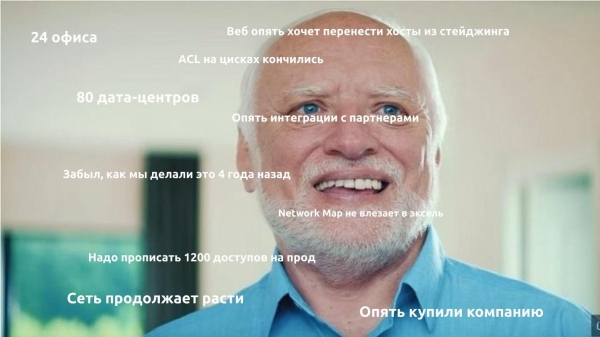
Bilo je veliko težav, a množičnih – pet.
- Geometrijska rast cene novih pravil. Vsako novo pravilo je bilo dodano dlje kot prejšnje, ker je bilo najprej treba preveriti, ali takšno pravilo že obstaja.
- V segmentih ni požarnega zidu. Segmenti so se nekako ločili med seboj, znotraj pa je že primanjkovalo virov.
- Pravila so se dolgo uporabljala. Operaterji so lahko eno lokalno pravilo napisali ročno v eni uri. Globalno je trajalo več dni.
- Težave z revizijo pravil. Natančneje, to ni bilo mogoče. Prva pravila so bila napisana že leta 2010 in večina njihovih avtorjev že ni delala v podjetju.
- Nizka raven nadzora nad infrastrukturo. To je glavni problem – slabo smo vedeli, kaj se sploh dogaja.
Tako je izgledal omrežni inženir v letu 2018, ko je slišal: 'Potrebujemo še malo ACL'.
Rešitve
Na začetku leta 2018 je bilo odločeno, da je treba nekaj narediti glede tega.
Cena integracij nenehno raste. Izhodiščna točka je bila, da so veliki datcentri prenehali podpirati izolirane VLAN in ACL, ker so se naprave napolnile.
Rešitev: odpravili smo človeški faktor in čim bolj avtomatizirali zagotavljanje dostopa.
Nova pravila se dolgo uporabljajo. Rešitev: pospešiti uporabo pravil, jo narediti distribuirano in paralelno. Za to potrebujemo distribucijski sistem, da se pravila dostavljajo sama, brez rsync ali SFTP na tisoč sistemov.
Odsotnost požarnega zidu znotraj segmentov. V notranjih segmentih se je začel pojavljati požarni zid, ko so se znotraj iste mreže pojavile različne storitve. Rešitev: uporabiti požarni zid na ravni gostitelja — host-based firewalls. Praktično povsod imamo Linux in povsod so iptables, to ni težava.
Težave z revizijo pravil. Rešitev: shraniti vsa pravila na enem mestu za pregled in upravljanje, tako bomo lahko vse revizirali.
Nizek nivo nadzora nad infrastrukturo. Rešitev: opraviti inventuro vseh storitev in dostopov med njimi.
To je bolj administrativen proces kot tehničen. Včasih imamo 200-300 novih izdaj na teden, še posebej med promocijami in prazniki. Pri tem gre le za eno ekipo naših DevOps. S tako številnimi izdajami je nemogoče videti, katere porte, IP, integracije so potrebne. Zato smo potrebovali posebej usposobljene vodje storitev, ki so spraševali ekipe: 'Kaj sploh imate in zakaj ste to postavili?'
Po vsem, kar smo zagnali, je leta 2019 naš mrežni inženir izgledal že tako.
Consul
Odločili smo se, da vse, kar smo našli s pomočjo vodij storitev, postavimo v Consul in od tam napišemo pravila iptables.
Kako smo se odločili to narediti?
- Zbrali bomo vse storitve, mreže in uporabnike.
- Na njihovi osnovi bomo oblikovali pravila iptables.
- Avtomatizirali bomo nadzor.
- ….
- PROFIT.
Consul ni oddaljen API, deluje lahko na vsakem vozlišču in piše v iptables. Ostane le še, da zmirovanja nadzora, ki bodo odstranjevala odvečne elemente, in večina težav bo rešena! Preostalo bomo dodelali v postopku.
Zakaj Consul?
Se je dobro izkazal. V letih 2014-15 smo ga uporabljali kot backend za Vault, kjer shranjujemo gesla.
Ne izgublja podatkov.. Med uporabo Consula ni izgubil podatkov v nobeni nesreči. To je ogromen plus za sistem upravljanja požarnega zidu.
P2P povezave pospešujejo širjenje sprememb.. S P2P vse spremembe pridejo hitro, ni potrebno čakati več ur.
Priročen REST API. Opremljali smo tudi Apache ZooKeeper, vendar nima REST API, zato bi morali postaviti delovne obrate.
Deluje tako kot shranjevanje ključev (KV) kot tudi kot katalog (Service Discovery).. Hraniti je mogoče storitve, kataloge, podatkovne centre. To je priročno ne le za nas, ampak tudi za sosednje ekipe, ker pri ustvarjanju globalne storitve razmišljamo na obsežen način.
Napisano v Go, ki je del skladov Wargaming. Obožavamo ovaj jezik, imamo mnogo Go programera.
Moćan ACL sistem. U Consulu, pomoću ACL-a, možete upravljati time ko i šta može pisati. Garantujemo da pravila vatrozida neće biti u sukobu i da nećemo imati problema s tim.
Ali Consul ima i nedostataka.
- Ne skalira se unutar data centra ako nemate poslovnu verziju. Skalira se samo federacijom.
- Veoma zavisi od kvaliteta mreže i opterećenja servera. Consul neće raditi ispravno kao server na opterećenom serveru ako su u mreži neki lagovi, na primer, neujednačena brzina. To je povezano sa P2P povezivanjem i modelima distribucije ažuriranja.
- Teškoće s praćenjem dostupnosti. U statusu Consula može pisati da je sve u redu, a on je već davno umro.
Većinu ovih problema smo rešavali tokom korišćenja Consula, zato smo ga i izabrali. U firmi postoje planovi za alternativni backend, ali smo naučili da se borimo s problemima i trenutno živimo s Consulom.
Kako funkcioniše Consul
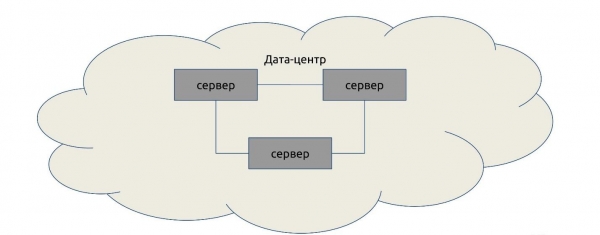
U hipotetički data centar instaliramo servere — od tri do pet. Jedan ili dva servera neće odgovarati: neće moći da organizuju kvorum i odluče ko je u pravu, a ko nije, kada se podaci ne podudaraju. Više od pet servera nije smisleno, performanse će opasti.
K.serverima se klijenti povezuju u bilo kom redu: isti agenti, samo sa oznakom server = false.
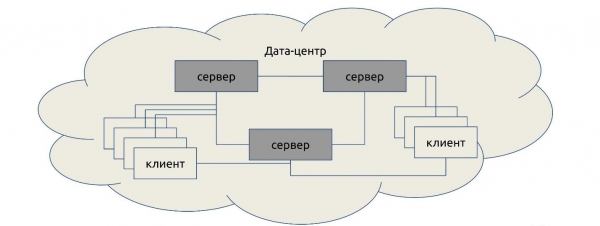
. Nakon toga, klijenti dobijaju listu P2P veza i uspostavljaju međusobne veze.
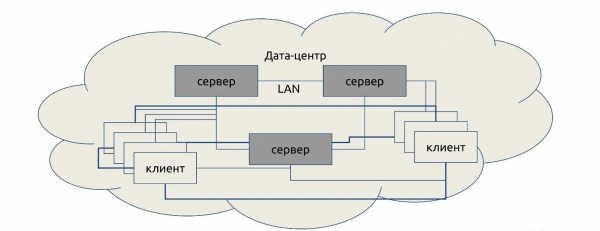
Na globalnom nivou povezujemo nekoliko data centara međusobno. Oni se takođe povezuju P2P i komuniciraju.
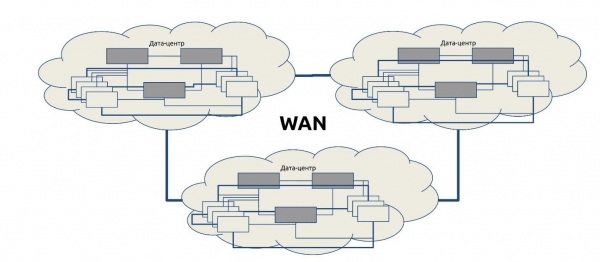
Kada želimo da preuzmemo podatke iz drugog data centra, zahtev ide od servera do servera. Ova šema se naziva Serf protokol. Serf protokol, kao i Consul, je razvoj HashiCorp-a.
Nekoliko važnih činjenica o Consulu
Consul ima dokumentaciju koja opisuje njegov rad. Navesti ću samo selektivne činjenice koje bi trebalo znati.
Consul serveri biraju vođu iz redova glasova. Consul bira vođu iz liste servera za svaki data centar, i svi zahtevi idu samo njemu, bez obzira na broj servera. Zagušenje vođe ne dovodi do ponovnog izbora. Ako vođa nije izabran — zahtevi se ne obrađuju.
Da li ste želeli horizontalno skaliranje? Žao nam je, nema toga.
Zahteva za drugem podatkovnem centru poteka od mojstra do mojstra, ne glede na to, na katerem strežniku se je pojavila. Izbrani mojster prevzame 100 % obremenitve, razen obremenitve za posredovanje zahtev. Aktualna kopija podatkov je na vseh strežnikih podatkovnega centra, vendar odgovarja samo en.
Edini način za povečanje obremenitve je, da omogočite stale-način na odjemalcu.
V stale-načinu lahko odgovarjate brez kvoruma. To je način, v katerem se odpovemo doslednosti podatkov, vendar beremo nekoliko hitreje kot običajno, in odgovori kateri koli strežnik. Seveda se zapisuje samo preko mojstra.
Consul ne kopira podatkov med podatkovnimi centri.Pri zbiranju federacije ima vsak strežnik samo svoje podatke. Po drugih se vedno obrača na nekoga drugega.
Atomarnost operacij ni zagotovljena izven transakcije.Ne pozabite, da lahko nekaj spremenite ne le vi. Če želite drugače, izvedite transakcijo z zaklepanjem.
Zaklepne operacije ne zagotavljajo zaklepanja.Zahteva poteka od mojstra do mojstra, ne neposredno, zato ni zagotovil, da bo zaklep deloval, ko zaklepate, na primer, v drugem podatkovnem centru.
ACL tudi ne zagotavlja dostopa (v mnogih primerih).ACL morda ne bo deloval, ker se shranjuje v enem podatkovnem centru federacije — v ACL podatkovnem centru (Primarni DC). Če vam DC ne odgovori, ACL ne bo deloval.
Eden zamrznjen mojster bo povzročil zamrznitev celotne federacije.Na primer, v federaciji je 10 podatkovnih centrov, v enem pa je slaba mreža in eden mojster pade. Vsi, ki komunicirajo z njim, se bodo zaleteli nazaj: zahteva, ni odgovora, nit se zastoji. Ničesar ne boste mogli storiti, da bi vedeli, kdaj se bo to zgodilo, preprosto bo čez uro ali dve padla cela federacija.
Status, kvorum in volitve obravnava ločena nit. Ponovne volitve ne bodo potekale, status ne bo ničesar pokazal. Mislite, da imate živi Consul, pošljete zahtevo, in nič se ne zgodi — ni odgovora. Medtem pa status kaže, da je vse v redu.
S to težavo smo se srečali, morali smo preoblikovati določene dele podatkovnih centrov, da bi se ji izognili.
V poslovni različici Consul Enterprise ni nekaterih zgoraj navedenih pomanjkljivosti.To je polno uporabnih funkcij: izbira volivcev, razporejanje, razširjanje. Obstaja le ena "ampak" — licenčni sistem za razdeljen sistem je zelo drag.
Koristni nasvet: rm -rf /var/lib/consul — zdravilo za vse bolezni agenta. Če vam kaj ne deluje, preprosto izbrišite svoje podatke in naložite podatke iz varnostne kopije. Verjetno bo Consul začel delovati.
BEFW
Zdaj se pogovorimo o tem, kar smo dodali v Consul.
— je akronim za BackEndFireWall. Morali smo dati nekako ime izdelku, ko sem ustvarjal repozitorij za prve testne predloge. To ime je ostalo.
Predloge pravil
Pravila so napisana v sintaksi iptables.
- -N BEFW
- -P INPUT DROP
- -A INPUT -m state --state RELATED,ESTABLISHED -j ACCEPT
- -A INPUT -i lo -j ACCEPT
- -A INPUT -j BEFW
Vse gre v verigo BEFW, razen ESTABLISHED, RELATED in localhost. Predloga je lahko kakršna koli, to je le primer.
Kaj prinaša BEFW?
Storitve
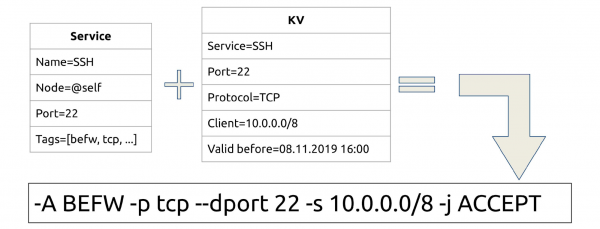
Imamo storitev, vedno ima vrata, nod, na kateri deluje. Z naše node lahko lokalno vprašamo agenta in ugotovimo, da imamo kakšno storitev. Tudi oznake lahko dodajamo.
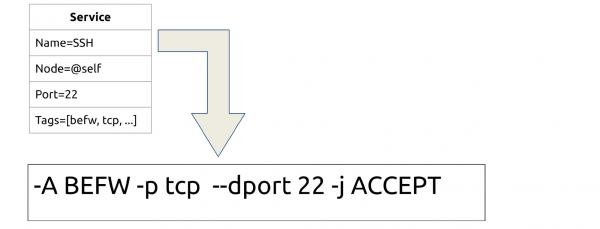
Vsaka storitev, ki se izvaja in je registrirana v Consul, postane pravilo iptables. Imamo SSH — odpiramo vrata 22. Bash skript je preprost: curl in iptables, nič drugega ne potrebujemo.
Klijenti
Kako odpreti dostop ne vsem, temveč selektivno? Po imenu storitve sestaviti IP-sezname v KV-shranjevanju.
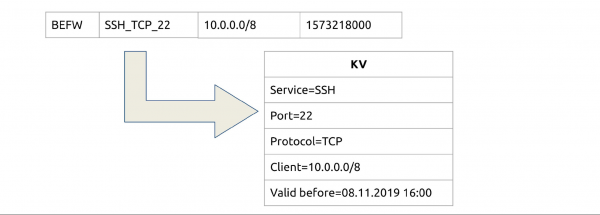
Na primer, želimo, da se vsi iz desete mreže lahko povežejo s storitvijo SSH_TCP_22. Dodamo eno majhno polje TTL? in zdaj imamo začasne dovoljenja, na primer, za en dan.
Dostopi
Povezujemo storitve in stranke: imamo storitev, za vsak pripravljeno KV-shranjevanje. Zdaj dajemo dostop ne vsem, temveč selektivno.
Skupine
Če bomo vsakokrat pisali tisoče IP-jev za dostop, se bomo utrudili. Ustanovimo grupacije — ločen podmnožek v KV. Poimenovali ga bomo Alias (ali skupine) in tam hranimo skupine po istem principu.
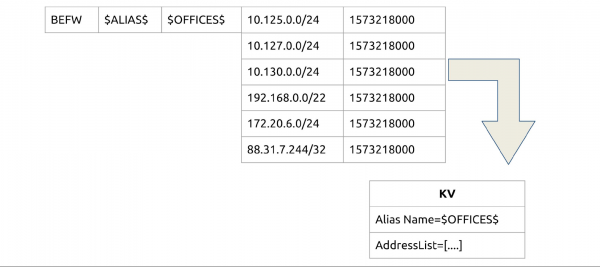
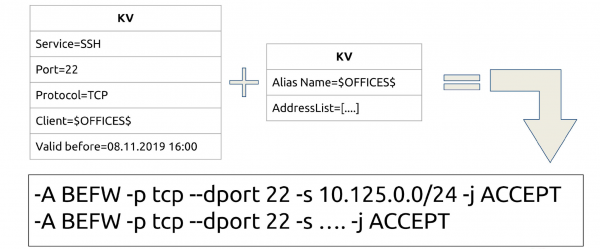
Povezujemo: zdaj lahko odprete SSH ne samo na P2P, temveč na celo skupino ali več skupin. Enako velja za TTL — lahko dodajate v skupino in začasno odstranjujete iz skupine.
Integracija
Naša težava — človeški faktor in avtomatizacija. Dokler smo jo rešili na ta način.
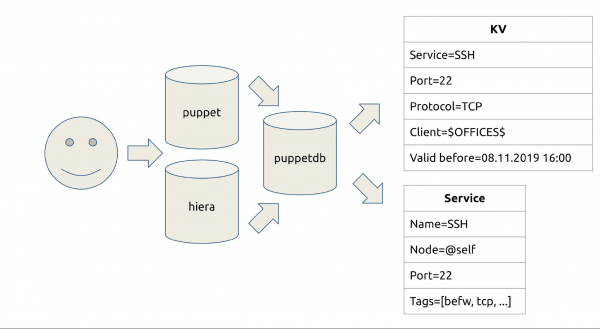
Sodelujemo s Puppet-ter in prenašamo vse, kar se nanaša na sistem (kodo aplikacij). V puppetdb (običajni PostgreSQL) hranimo seznam storitev, ki so tam zagnane, te lahko najdemo po vrsti virov. Prav tako lahko ugotovimo, kdo se kam obrača. Imamo tudi sistem za pull request in merge request za to.
Napisali smo befw-sync – najpreprostejšo rešitev, ki pomaga pri prenosu podatkov. Najprej se sync cookies obrnejo na puppetdb. Tam je nastavljen HTTP API: povprašamo, katere storitve imamo, kaj je treba opraviti. Nato se izvede poizvedba v Consul.
Ali obstaja integracija? Da: napisali smo pravila, dovolili sprejemanje Pull Requesta. Potreben je nek port ali dodati gostitelja v kakšno skupino? Pull Request, pregled – brez iskanja 'najdi 200 drugih ACL in poskusi to rešiti'.
Optimizacija
Ping localhost z praznim verižnim nizom pravil traja 0,075 ms.
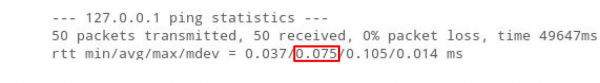
Dodali bomo v to verigo 10.000 naslovov iptables. Posledično se ping poveča petkrat: iptables je popolnoma linearno, obdelava vsakega naslova traja določen čas.
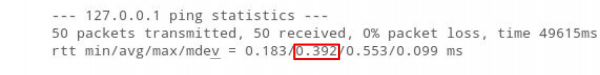
Za požarni zid, v katerega migriramo tisoče ACL, imamo veliko pravil, to pa prinaša zamudo. Za igralne protokole je to slabo.
Ampak če jih postavimo 10.000 naslovov v ipset se ping celo zmanjša.
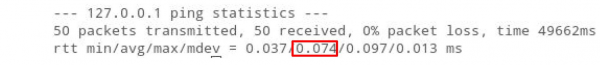
Namen je v tem, da je 'O' (zapletenost algoritma) za ipset vedno enaka 1, ne glede na to, koliko pravil je tam. Res je, da obstaja omejitev – pravil ne more biti več kot 65535. Zaenkrat smo s tem zadovoljni: lahko jih kombiniramo, širimo, naredimo dva ipset v enem.
Хранение
Logična nadaljevanja procesa iteracij je shranjevanje informacij o strankah za storitev v ipset.
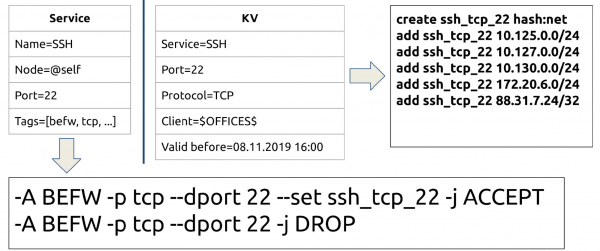
Zdaj imamo isti SSH, in ne vpisujemo takoj 100 IP, ampak določimo ime ipseta, s katerim se moramo povezati, in naslednje pravilo DROP. Lahko ga preoblikujemo v eno pravilo 'Kdor ni tukaj, tisti DROP', ampak tako je bolj pregledno.
Zdaj imamo pravila in sete. Glavna naloga je narediti set, preden napišemo pravilo, ker sicer iptables ne bo zabeležil pravila.
Splošni diagram
V obliki sheme izgleda vse, kar sem povedal, tako.
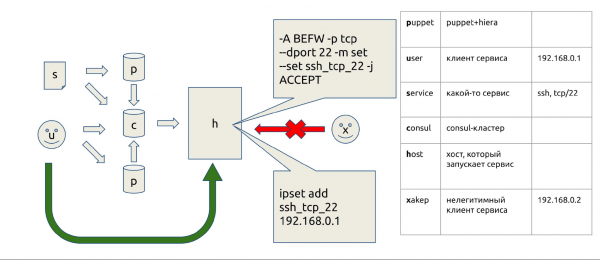
Commitamo v Puppet, vse se pošlje na gostitelja, storitve so tukaj, ipset tam, tistih, ki tam niso zapisani, ne spustijo.
Allow & deny
Da bi hitro rešili svet ali hitro nekomu onemogočili dostop, smo na začetku vseh verig naredili dva ipset: rules_allow in rules_deny. Kako to deluje?
Na primer, nekdo ustvarja obremenitve z botom na naši spletni strani. Pred tem je bilo potrebno poiskati njegov IP naslov v dnevnikih, ga predati omrežnim inženirjem, da bi našli vir prometa in ga blokirali. Zdaj to izgleda drugače.
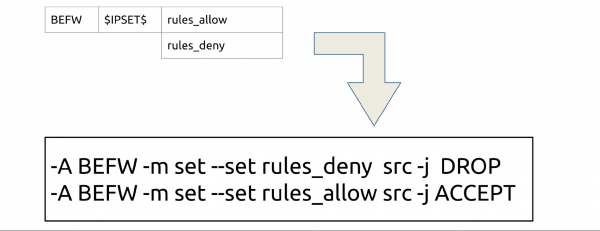
Pošljemo v Consul, počakamo 2,5 sekunde in to je to. Ker Consul hitro distribuira preko P2P, deluje povsod, kjerkoli v svetu.
Enkrat sem povsem ustavil WOT, ker sem se zmotil s požarnim zidom. rules_allow — to je naš zavarovanje v takih primerih. Če kje naredimo napako s požarnim zidom in nekaj blokiramo, lahko vedno pošljemo pogojni 0.0/0, da hitro vse sprostimo. Potem pa bomo vse popravili ročno.
Drugi nizi
Lahko dodajate vse druge nize v prostoru $IPSETS$.
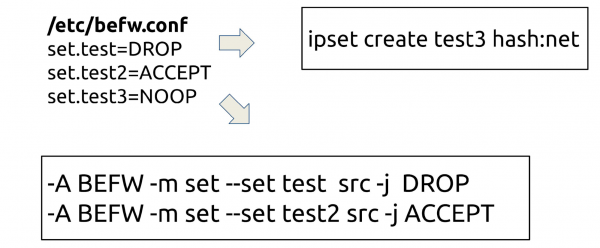
Zakaj? Včasih nekdo potrebuje ipset, na primer, da emulira izklop nekega dela klasterja. Vsak lahko prinese kakršnekoli nize, jih poimenuje in ti se bodo pobrali iz Consula. Hkrati lahko nizi sodelujejo v pravilih iptables ali pa služijo kot ekipa NOOP: konzistentnost bo vzdrževana z demonom.
Korisnici
Prej je bilo tako: uporabnik se je povezal v omrežje in preko domene prejel parametre. Pred pojavom nove generacije požarnih zidov Cisco ni znala razumeti, kje je uporabnik in kje IP. Zato je bilo dostop omogočeno le preko ime stroj.
Kaj smo naredili? Vklučili smo se v trenutku pridobivanja naslova. Običajno je to dot1x, Wi-Fi ali VPN — vse gre preko RADIUS-a. Za vsakega uporabnika ustvarimo skupino po imenu uporabnika in vanjo umestimo IP s TTL, ki enak njegovemu dhcp.lease — takoj ko poteče, pravilo izgine.
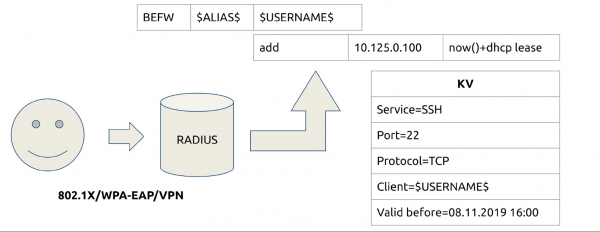
Zdaj lahko odpiramo dostop do storitev, kot v druge skupine, po uporabniškem imenu. Oznanili smo se težav, ko se ime stroj spremeni, in razbremenili omrežne inženirje, ker jim več ni treba upravljati s Cisco. Zdaj inženirji sami zapisujejo dostop na svojih strežnikih.
Izolacija
Hkrati smo začeli obravnavati izolacijo. Upravitelji storitev so naredili inventuro, mi pa smo analizirali vsa omrežja. Razdelili jih bomo v enake skupine, na potrebne strežnike pa dodali skupine, na primer, v deny. Izolacija stanja zdaj pade v rules_deny pri produkciji, vendar ne v samo produkcijo.
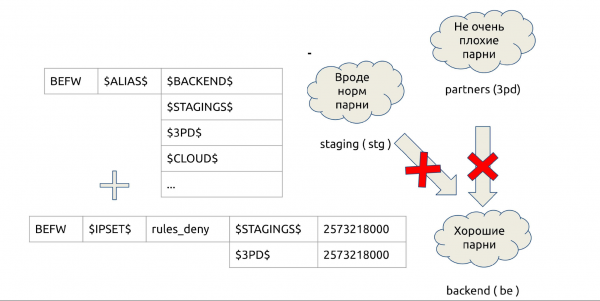
Načrt deluje hitro in preprosto: odstranimo vse ACL s strežnikov, razbremenimo strojno opremo in zmanjšamo število izoliranih VLAN-ov.
Nadzor celovitosti
V preteklosti smo imeli poseben sprožilec, ki je obveščal, ko je kdo ročno spremenil pravilo požarnega zidu. Napisal sem velik linter za preverjanje pravil požarnega zidu, kar je bilo zahtevno. Zdaj celovitost nadzira BEFW. Skrbno spremlja, da se pravila, ki jih ustvarja, ne spreminjajo. Če kdo spremeni pravila požarnega zidu, se vrnejo nazaj. "Hitro sem vzpostavil proxy, da delam od doma" — takšnih možnosti več ni.
BEFW nadzira ipset iz storitev in seznama v befw.conf, pravila storitev v verigi BEFW. Ne spremlja pa drugih verig in pravil ter drugih ipsetov.
Zaščita pred napakami
BEFW vedno shrani zadnje uspešno stanje neposredno v binarni strukturi state.bin. Če gre kaj narobe, se vedno vrne na to state.bin.
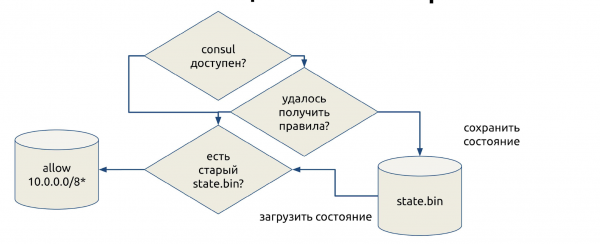
To je zavarovanje pred nestabilnim delovanjem Consula, ko podatki niso bili poslani ali je kdo naredil napako in uporabil pravila, ki jih ni mogoče uporabiti. Da ne bi ostali brez požarnega zidu, se BEFW vrne na zadnje stanje, če pride do napake na kateremkoli koraku.
V kritičnih situacijah je to jamstvo, da bomo ostali z delujočim požarnim zidom. Odpremo vse sive omrežne povezave v upanju, da bo skrbnik prišel in to popraviti. Nekoč bom to prenesel v konfiguracije, a zdaj imamo preprosto tri sive mreže: 10/8, 172/12 in 192.168/16. V sklopu našega Consula je to pomembna značilnost, ki nam pomaga napredovati.
Demo: med predstavitvijo Ivan prikazuje demo način delovanja BEFW. Prikaz je lažje gledati na . Izvorna koda demota je dostopna .
Skrbi
Povedal bom o napakah, s katerimi smo se srečali.
ipset add set 0.0.0.0/0. Kaj se zgodi, če dodamo v ipset 0.0.0.0/0? Ali se dodajo vsi IP naslovi? Se odpre dostop do interneta?
Ne, dobili bomo napako, ki nas je stala dveh ur zastoja. Ta napaka namreč ne deluje že od leta 2016, leži v RedHat Bugzilli pod številko #1297092, odkrili pa smo jo povsem naključno — iz poročila razvijalca.
Zdaj v BEFW velja strogo pravilo, da 0.0.0.0/0 se spremeni v dve naslovni številki: 0.0.0.0/1 in 128.0.0.0/1.
ipset restore set < file. Kaj naredi ipset, ko mu rečete restore? Вы думаете, он работает также, как iptables? Восстановит данные?
Ni tako — izvede združitev, in stari naslovi nikamor ne gredo, dostopa ne zaprete.
Napako smo našli, ko smo testirali izolacijo. Zdaj tam deluje precej zapleten sistem — namesto restore poteka create temp, zatim restore flush temp in restore temp. Na koncu swap: za atomarnost, ker če najprej izvedete flush In this moment, if a package comes, it will be discarded and something will go wrong. So there’s a bit of black magic involved.
consul kv get -datacenter=other. As I mentioned earlier, we think we are requesting some data, but we will either get data or an error. We can do this through Consul locally, but in this case, both will hang.
The local Consul client is a wrapper around the HTTP API. But it hangs and doesn't respond to either Ctrl+C, Ctrl+Z, or anything, only to kill -9 a neighboring console. We faced this when building a large cluster. But we currently have no solution; we are preparing to fix this bug in Consul.
The Consul leader is not responding. Our master in the data center is not responding, and we think: “Surely, the reelection algorithm will kick in now?”
No, it won't, and the monitoring will show nothing: Consul will say that the commitment index exists, the leader is found, everything is fine.
How are we fighting this? service consul restart in cron every hour. If you have 50 servers, it’s not a problem. When you have 16,000, you will understand how it works.
Zaključek
As a result, we gained the following advantages:
- 100% coverage of all Linux machines.
- Hitrost.
- Automation.
- We freed hardware and network engineers from slavery.
- Integration opportunities have become virtually limitless: with Kubernetes, Ansible, or Python.
Недостатки: Consul, with which we now have to live, and the cost of mistakes is extremely high. For example, once at 6 PM (prime time in Russia), I was editing network lists. We were just building isolation on BEFW. I made a mistake somewhere, apparently specified the wrong mask, and everything crashed in two seconds. Monitoring lights up, the support on duty comes running: “Everything is down!” The head of the department turned gray explaining to the business why this happened.
The cost of mistakes is so high that we devised our own complex preventive procedure. If you’re implementing this in a large production environment, do not grant the master token over Consul to everyone randomly. It will end poorly.
Costs. I wrote code for 400 hours alone. My team of 4 spends 10 hours a month to support everyone. Compared to the cost of any next-gen firewall, this is free.
Plans. The long-term plan is to look for an alternative transport to replace or supplement Consul. Perhaps it will be Kafka or something similar. But for the next few years, we will live with Consul.
Najbližji načrti: integracija s Fail2ban, nadzorom, z nftables, morda tudi z drugimi distribucijami, metrike, razširjeni nadzor, optimizacija. Podpora za Kubernetes je prav tako v načrtu, saj imamo trenutno več klasterjev in željo.
Še iz načrtov:
- iskanje anomalij v prometu;
- upravljanje s topologijo omrežja;
- podpora za Kubernetes;
- kompilacija paketov za vse sisteme;
- Web-UI.
Stalno delamo na razširitvi konfiguracije, povečevanju metrik in optimizaciji.
Pridružite se projektu. Projekt je izjemen, a žal je trenutno to projekt enega človeka. Pridite na in poskusite nekaj storiti: oddajte prispevek, testirajte, predlagajte, dajte svoje mnenje.
Medtem se pripravljamo na , ki bo 6. in 7. aprila v Sankt Peterburgu, in vabimo razvijalce visoko obremenjenih sistemov, . Izkušeni predavatelji že vedo, kaj storiti, novince v nastopih pa priporočamo, da si vsaj . Udeležba na konferenci kot predavatelj prinaša vrsto prednosti. Kaj, si lahko preberete, na primer, na koncu .
Izvor: habr.com
