

Hello, Habr!
Po novogodišnjih praznika ponovo smo pokrenuli katastrofu-otporno oblak na bazi dve lokacije. Danas ćemo objasniti kako to funkcioniše i prikazati šta se događa sa klijentovim virtuelnim mašinama prilikom kvara pojedinačnih elemenata klastera i pada cele lokacije (spoiler – sve je u redu).
SASD katastrofu-otpornog oblaka na lokaciji OST.
Šta je unutra
Ispod haube klastera su serveri Cisco UCS sa hipervizorom VMware ESXi, dva SASD INFINIDAT InfiniBox F2240, mrežna oprema Cisco Nexus, kao i SAN prekidači Brocade. Klaster je raspoređen na dve lokacije – OST i NORD, tj. u svakom data centru je identičan skup opreme. To ga upravo čini katastrofu-otpornim.
Unutar jedne lokacije takođe su duplirani glavni elementi (hostovi, SAN prekidači, mreža).
Dve lokacije su povezane posvećenim optičkim vlaknima, takođe rezervisanim.
Nekoliko reči o SASD. Prva verzija katastrofu-otpornog oblaka koju smo gradili temeljila se na NetApp. Ovde smo odabrali INFINIDAT, i evo zašto:
- Opcija Active-Active replikacije. Ona omogućava virtuelnoj mašini da ostane u funkcionalnom stanju čak i pri potpunom otkazu jednog od SASD. O replikaciji ću detaljnije pričati kasnije.
- Tri disk kontrolera za povećanje otpornosti sistema. Obično ih ima dva.
- Gotovo rešenje. Do nas je stigla već sastavljena ormarić, koju treba samo povezati na mrežu i konfigurisati.
- Pažljiva tehnička podrška. Inženjeri INFINIDAT stalno analiziraju logove i događaje SASD-a, instaliraju nove verzije u firmveru, pomažu sa podešavanjima.
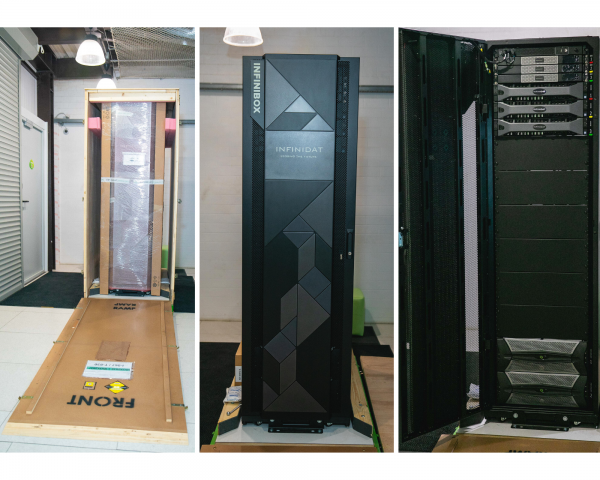
Evo nekoliko fotografija sa unpacking-a:
Kako deluje
Oblak je već interno katastrofu-otporan. On štiti klijenta od pojedinačnih hardverskih i softverskih kvarova. Katastrofu-otporan obezbeđuje zaštitu od masovnih kvarova unutar jedne lokacije: na primer, otkaz SASD (ili klastera SDS, što se često dešava 🙂), masovne greške u mreži skladišta itd. I najvažnije: takav oblak spašava kada cela lokacija postane nedostupna zbog požara, nestanka struje, otmice, invazije vanzemaljaca.
U svim tim slučajevima, klijentove virtuelne mašine nastavljaju da rade, i evo zašto.
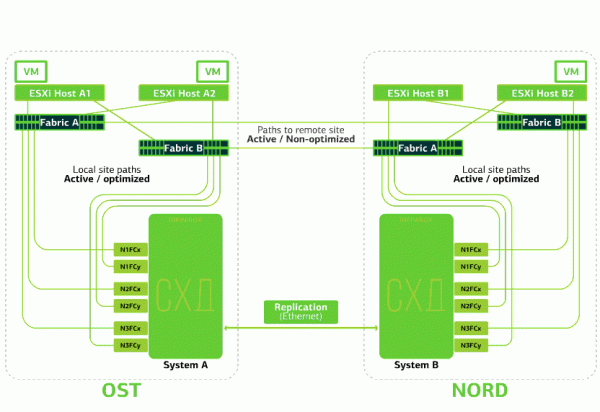
Shema klastera je uređena tako da bilo koji ESXi host s klijentskim virtuelnim mašinama može pristupiti bilo kojoj od dve SAN. Ako SAN na lokaciji OST otkaže, virtuelne mašine će nastaviti raditi: hostovi na kojima rade će se obraćati za podatke SAN-u na NORD-u.
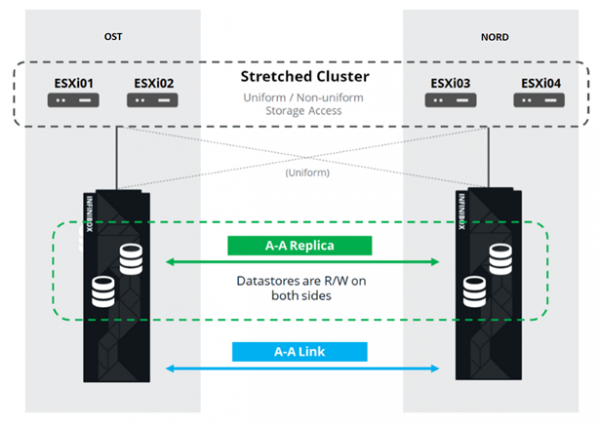
Ovako izgleda shema povezivanja u klasteru.
To je moguće zahvaljujući tome što je između SAN-fabrika dvaju lokacija podešen Inter-Switch Link: SAN-switch Fabric A OST je povezan sa SAN-switch-om Fabric A NORD, slično je i sa SAN-switch-ima Fabric B.
I da bi sve ove složene radnje SAN-fabrika imale smisla, između dva SAN-a je postavljena Active-Active replikacija: informacije se praktično istovremeno snimaju na lokalni i udaljeni SAN, RPO=0. Tako da se na jednom SAN-u čuva original podataka, a na drugom – njihova replika. Podaci se replikacijom prenose na nivou volumena SAN-a, a na njima se čuvaju podaci VM (njeni diskovi, konfiguracijska datoteka, swap-datoteka itd.).
ESXi host vidi osnovni volumen i njegovu repliku kao jedan uređaj za skladištenje (Storage Device). Od ESXi hosta do svakog skladišnog uređaja vode 24 puta:
12 puteva povezuje ga s lokalnim SAN-om (optimalni putevi), a ostalih 12 – sa udaljenim (neoptimalni putevi). U normalnoj situaciji ESXi se obraća podacima na lokalnom SAN-u, koristeći “optimalne” puteve. Kada otkaže ovaj SAN, ESXi gubi optimalne puteve i prelazi na “neoptimalne”. Ovako to izgleda na shemi.
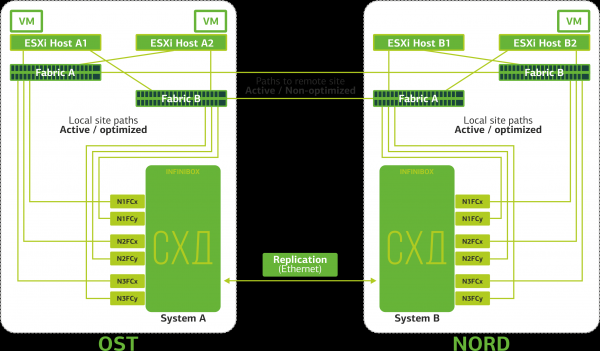
Shema katastrofootpornog klastera.
Sve klijentske mreže su povezane na obe lokacije kroz zajedničku mrežnu fabriku. Na svakoj lokaciji radi Provider Edge (PE), na kojem se terminiraju mreže klijenta. PE su povezani u zajednički klaster. Kada PE na jednoj lokaciji otkaže, sav saobraćaj se preusmerava na drugu lokaciju. Zahvaljujući tome, virtuelne mašine sa lokacije koja je ostala bez PE ostaju dostupne putem mreže za klijenta.
Hajde da sada pogledamo šta će se dešavati sa virtuelnim mašinama klijenta u slučaju različitih otkaza. Počinjemo sa najlakšim slučajevima i završavamo sa najtežim – otkazom cele lokacije. U primerima će osnovna lokacija biti OST, a rezervna, sa replikama podataka, – NORD.
Šta se dešava sa virtuelnom mašinom klijenta ako…
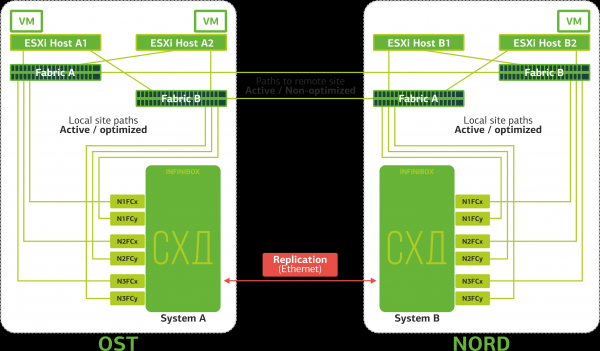
Otkazuje Replication Link. Replikacija između SAN-ova dvaju lokacija prestaje.
ESXi bodo delovali samo z lokalnimi diski (po optimalnih poteh).
Virtualne naprave še naprej delujejo.
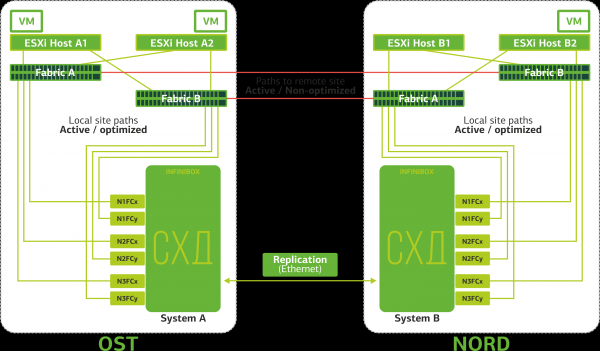
Povezava ISL (Inter-Switch Link) je prekinjena. Še zdaleč ni verjetno. Razen če kakšen norec z buldožerjem prekopa več optičnih poti hkrati, ki potekajo po neodvisnih poteh in so pripeljane na lokacije preko različnih vhodov. V tem primeru ESXi gostitelji izgubijo polovico poti in lahko dostopajo le do svojih lokalnih shranjevalnih sistemov. Replike se zbirajo, toda gostitelji ne bodo mogli dostopati do njih.
Virtualne naprave delujejo normalno.
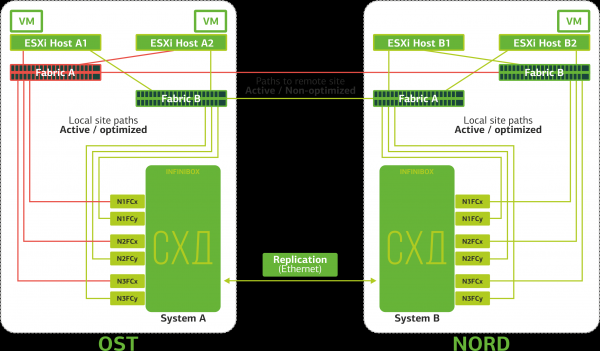
SAN stikalo na eni lokaciji je odpovedalo. ESXi gostitelji izgubljajo del poti do shranjevalnih sistemov. V tem primeru bodo gostitelji na tisti lokaciji, kjer je stikalo odpovedalo, delovali le preko enega svojega HBA.
Virtualne naprave ob tem še naprej delujejo normalno.
Vsa SAN stikala na eni lokaciji odpovedujejo. Recimo, da se ta težava zgodi na lokaciji OST. V tem primeru bodo ESXi gostitelji na tej lokaciji izgubili vse poti do svojih diskovnih naprav. Vključuje se standardni mehanizem VMware vSphere HA: ponovno bo zagnal vse virtualne naprave na lokaciji OST v NORD-u največ po 140 sekundah.
Virtualne naprave, ki delujejo na gostiteljih lokacije NORD, delujejo normalno.
ESXi gostitelj na eni lokaciji odpove. Tukaj se ponovno aktivira mehanizem vSphere HA: virtualne naprave s odpovedanim gostiteljem se ponovno zaženejo na drugih gostiteljih – na isti ali oddaljeni lokaciji. Čas ponovnega zagona virtualne naprave je do 1 minute.
Če vsi ESXi gostitelji na lokaciji OST odpovejo, ni več možnosti: VM se ponovno zažene na drugi. Čas ponovnega zagona je enak.
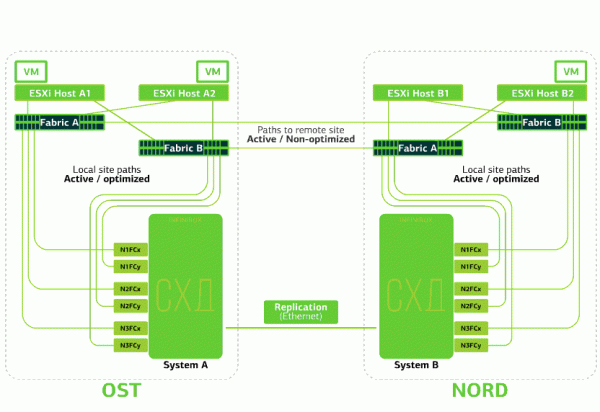
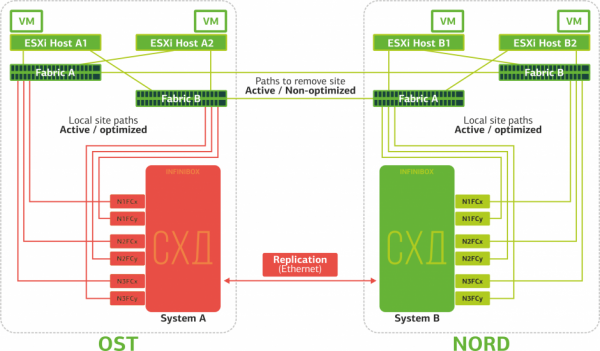
SHD na eni lokaciji odpove. Predpostavimo, da je SHD na lokaciji OST odpovedal. Takrat se ESXi gostitelji lokacije OST preklopijo na delovanje z replikami SHD v NORD-u. Po tem, ko se okvarjena SHD vrne v obratovanje, pride do prisilne replikacije, ESXi gostitelji OST pa se ponovno začnejo povezovati z lokalno SHD.
Virtualne naprave vso to čas delujejo normalno.
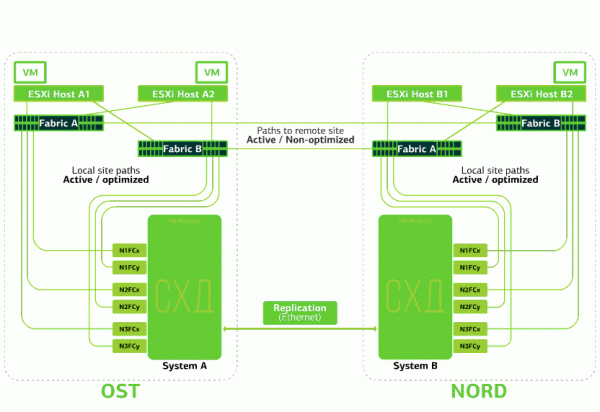
Ena izmed lokacij odpove. V tem primeru se vse virtualne naprave ponovno zaženejo na rezervni lokaciji preko mehanizma vSphere HA. Čas ponovnega zagona VM je 140 sekund. Pri tem vse omrežne nastavitve virtualne naprave ostanejo shranjene, in ostaja dostopna za odjemalca po omrežju.
Da bi se ponovni pokret mašine na rezervnoj lokaciji odvijao bez problema, svaka lokacija je ispunjena samo napola. Druga polovina služi kao rezervni kapacitet u slučaju premještanja svih virtuelnih mašina sa druge, oštećene, lokacije.
To su odbijanja od kojih štiti katastrofno otpornije oblak baze dva data centra.
Ovo zadovoljstvo nije jeftino, jer pored osnovnih resursa, potrebno je imati rezervu na drugoj lokaciji. Stoga se u ovakvom oblaku postavljaju poslovno kritične usluge, čije dugotrajno nezadovoljstvo nosi velike finansijske i reputacione gubitke, ili kada su na informacijski sistem postavljeni zahtevi za katastrofnu otpornost od strane regulatore ili unutrašnjih propisa kompanije.
Viri:
Izvor: habr.com
