

Data Science za začetnike
1. Analiza čustev (Analiza čustev preko besedila)
Oglejte si popolno izvedbo projekta Data Science z uporabo izvorne kode — .
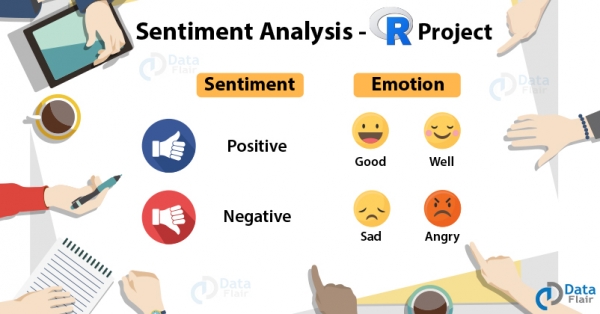
Analiza čustev — to je analiza besed za določitev čustev in mnenj, ki so lahko pozitivna ali negativna. To je vrsta klasifikacije, kjer so lahko razredi bodisi binarni (pozitivni in negativni) bodisi večrazredni (srečni, jezni, žalostni, gnusni …). Ta projekt Data Science bomo izvedli v programskem jeziku R in uporabili podatkovni niz iz paketa «janeaustenR». Uporabili bomo splošne slovarje, kot so AFINN, bing in loughran, izvedli notranje povezovanje in na koncu ustvarili oblak besed, da prikažemo rezultat.
Jezik: R
Podatkovni niz/Paket: janeaustenR
Članek je bil preveden s podporo podjetja EDISON Software, ki , kao i .
2. Odkrivanje lažnih novic (Odkrivanje lažnih novic)
Povečajte svoje veščine na novi ravni, ko delate na projektu Data Science za začetnike — .
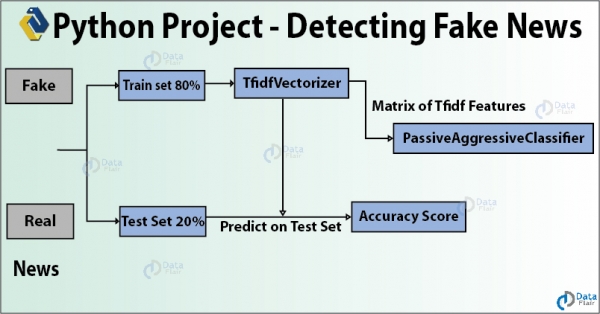
Lažne novice so lažne informacije, ki se širijo preko družbenih omrežij in drugih spletnih medijev za dosego političnih ciljev. V tej ideji projekta Data Science bomo uporabili Python za ustvarjanje modela, ki lahko natančno določi, ali je novica resnična ali lažna. Ustvarili bomo TfidfVectorizer in uporabili PassiveAggressiveClassifier za klasifikacijo novic na 'resnične' in 'lažne'. Uporabili bomo podatkovni niz v obliki 7796 × 4 in vse izvedli v Jupyter Lab.
Jezik: Python
Podatkovni niz/Paket: news.csv
3. Odkritje Parkinsonove bolezni (Odkritje Parkinsonove bolezni)
Napredуйте naprej, ko delate na ideji projekta Data Science Project Idea — .
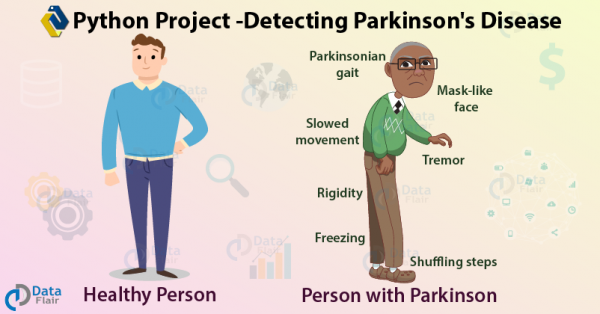
Začeli smo uporabljati podatkovne znanosti za izboljšanje zdravstvenih storitev — če lahko napovemo bolezen v zgodnji fazi, bomo imeli veliko prednosti. V tej ideji projekta podatkovne znanosti se bomo naučili prepoznati Parkinsonovo bolezen s pomočjo Pythona. Gre za nevrodegenerativno, progresivno bolezen osrednjega živčnega sistema, ki vpliva na gibanje ter povzroča tresenje in togost. Vpliva na dopaminergične nevrone v možganih, vsako leto pa prizadene več kot 1 milijon ljudi v Indiji.
Jezik: Python
Podatkovni niz/Paket: UCI ML Parkinsons dataset
Projekti podatkovne znanosti srednje zahtevnosti
4. Prepoznavanje čustev v govoru
Oglejte si celotno izvedbo projekta podatkovne znanosti — .
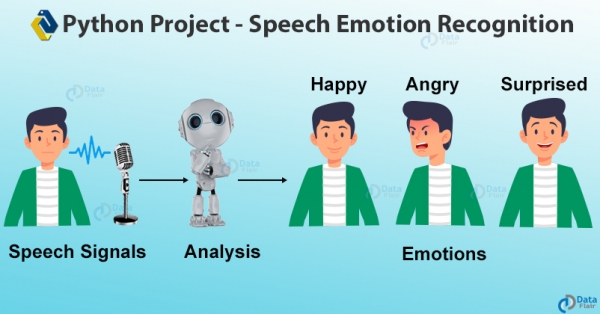
Sedaj se naučimo uporabljati različne knjižnice. Ta projekt podatkovne znanosti uporablja librosa za prepoznavanje govora. SER je proces določanja človeških čustev in afektivnih stanj na podlagi govora. Ker uporabljamo ton in višino za izražanje čustev z glasom, je SER pomemben. Vendar pa so čustva subjektivna, zato je označevanje zvoka zahtevna naloga. Uporabili bomo funkcije mfcc, chroma in mel ter podatkovni niz RAVDESS za prepoznavanje čustev. Ustvarili bomo MLPC klasifikator za to različico.
Jezik: Python
Podatkovni niz/Paket: RAVDESS dataset
5. Odkrivanje spola in starosti
Navdušite delodajalce z najnovejšim projektom podatkovne znanosti — .
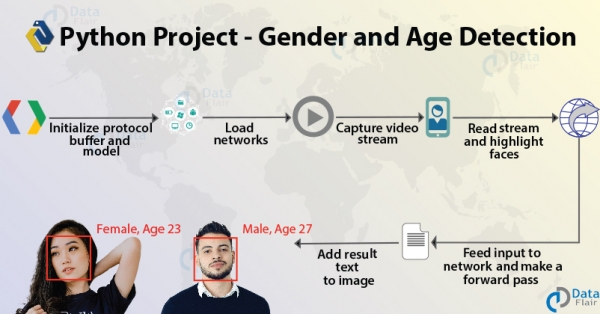
To je zanimiv projekt podatkovne znanosti s Pythonom. Z uporabo le ene slike se boste naučili napovedovati spol in starost osebe. Tu vas bomo seznanili z računalniškim vidom in njegovimi načeli. Zgradili bomo in uporabljali modele, usposobljene z uporabo Tal Haassnerja in Gila Levi za podatkovni niz Adience. Na poti bomo uporabili nekatere datoteke .pb, .pbtxt, .prototxt in .caffemodel.
Jezik: Python
Podatkovni niz/Paket: Adience
6. Analiza podatkov Uber
Oglejte si celotno izvedbo projekta podatkovne znanosti z izvorno kodo — .
To je projekt vizualizacije podatkov z ggplot2, v katerem bomo uporabili R in njegove knjižnice ter analizirali različne parametre. Uporabili bomo podatkovni niz Uber Pickups v New Yorku in ustvarili vizualizacije za različne časovne okvire v letu. To nam pove, kako čas vpliva na vožnje strank.
Jezik: R
Podatkovni niz/Paket: Uber Pickups in New York City dataset
7. Odkrivanje zaspanosti voznika
Izpopolnite svoje veščine z delom na Top Data Science projektu — .
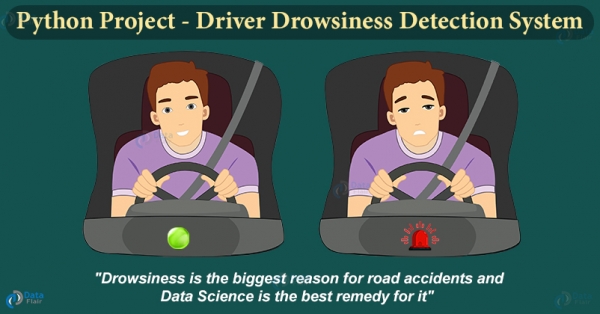
Zaspanost pri vožnji je izjemno nevarna in vsako leto se zgodi okoli tisoč nesreč zaradi tega, ker vozniki med vožnjo zaspijo. V tem projektu v Pythonu bomo ustvarili sistem, ki bo lahko odkrival zaspanost voznikov in jih obveščal z zvočnim signalom.
Ta projekt je izveden z uporabo Keras in OpenCV. Uporabili bomo OpenCV za odkrivanje obraza in oči, Keras pa bomo uporabili za razvrščanje stanja oči (Odprte ali Zasclosed) z uporabo globokih nevronskih mrež.
8. Klepetalni robot
Ustvarite klepetalnega robota s pomočjo Pythona in naredite korak naprej v svoji karieri — .
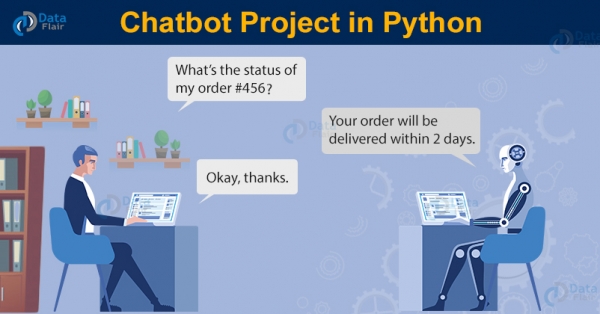
Klepetalni roboti so nepogrešljiv del poslovanja. Mnogim podjetjem je treba nuditi storitve svojim strankam, kar zahteva veliko delovne sile, časa in truda. Klepetalni roboti lahko avtomatizirajo večino interakcij s strankami, odgovarjajoč na pogosta vprašanja, ki jih postavljajo stranke. Običajno obstajata dve vrsti klepetalnih robotov: posebni za določen domen in odprti domen. Klepetalni robot posebne domene se pogosto uporablja za reševanje specifičnih težav; zato ga je treba prilagoditi, da učinkovito deluje v vašem področju. Odprti domen klepetalnih robotov je možno vprašati, katera koli vprašanja, zato potrebujemo ogromno podatkov za njihovo usposabljanje.
Nabor podatkov: JSON datoteka z nameni
Jezik: Python
Napredni projekti Data Science
9. Generator opisov slik
Preverite popolno izvedbo projekta s izvorno kodo — .
Opis tega, kar je na sliki, je za ljudi lahek naloga, toda za računalnike je slika zgolj niz številk, ki predstavljajo barvne vrednosti posameznih pikslov. To je zahtevna naloga za računalnike. Razumeti, kaj je na sliki, in nato ustvariti opis v naravnem jeziku (npr. angleščini) je še ena zahtevna naloga. Ta projekt uporablja metode globokega učenja, v katerih izvajamo konvolucijsko nevronsko mrežo (CNN) z rekurenčno nevronsko mrežo (LSTM) za ustvarjanje generatorja opisov slik.
Nabor podatkov: Flickr 8K
Jezik: Python
Okvir: Keras
10. Odkrivanje prevar s kreditnimi karticami
Naredite vse, kar je v vaši moči, pri razvoju ideje projekta Data Science — .
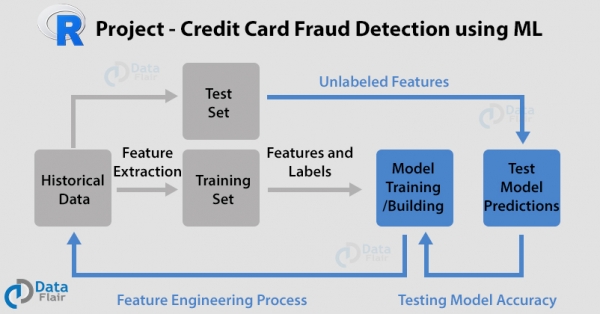
Do sedaj ste začeli razumeti metode in koncepte. Preidimo na nekaj naprednejših projektov na področju podatkovne znanosti. V tem projektu bomo uporabili jezik R z algoritmi, kot so , logistična regresija, umetne nevronske mreže in klasifikator gradientnega dviga. Uporabili bomo nabor podatkov o transakcijah s karticami, da bomo razvrstili transakcije s kreditnimi karticami kot prevarantske in pristne. Prilagodili bomo različne modele in zgradili krivulje uspešnosti.
Jezik: R
Podatkovni niz/Paket: Nabor podatkov o transakcijah s karticami
11. Sistem priporočenih filmov
Raziščite izvedbo najboljšega projekta Data Science s izvorno kodo —
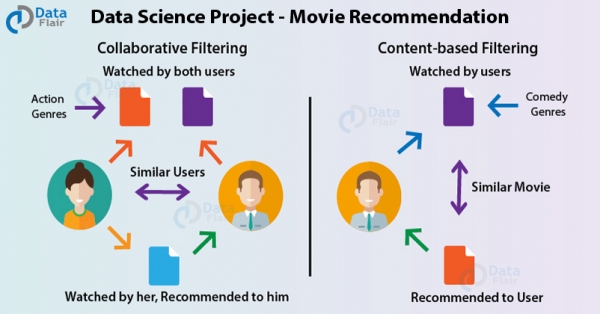
V tem projektu Data Science bomo uporabili R, da bomo izvedli priporočila filmov z uporabo strojnega učenja. Sistem priporočil pošilja predloge uporabnikom preko procesa filtracije, ki temelji na preferencah drugih uporabnikov in zgodovini ogledov. Če A in B imata radi Sam doma, in B obožuje Dekleta z Mean Girls, lahko predlagamo A — to jima morda tudi ustreza. To omogoča strankam, da se povežejo s platformo.
Jezik: R
Podatkovni niz/Paket: Nabor podatkov MovieLens
12. Segmentacija strank
Navdušite delodajalce s projektom Data Science (vključno z izvorno kodo) — .
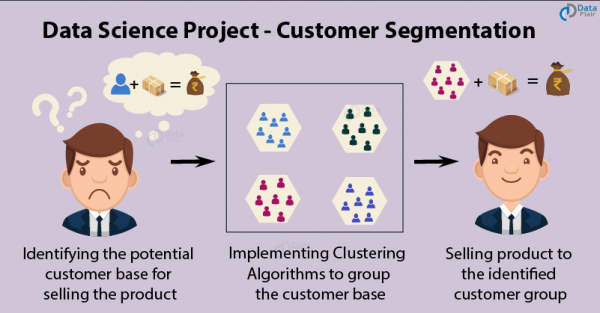
Segmentacija strank je priljubljena aplikacija Z uporabo klusteringa kompanije določajo segmente strank za delo s potencialnimi uporabniki. Stranke razdelijo v skupine glede na skupne značilnosti, kot so spol, starost, interesi in nakupne navade, da lahko učinkovito prodajajo svoje izdelke vsakemu segmentu. Uporabili bomo , ter vizualizirali razporeditev po spolu in starosti. Nato bomo analizirali njihove letne dohodke in raven porabe.
Jezik: R
Podatkovni niz/Paket: Nabor podatkov Mall_Customers
13. Klasifikacija raka dojk
Oglejte si celovito izvedbo projekta Data Science v Pythonu — .
Vrnete se k medicinskemu prispevku znanosti o podatkih in naučimo se prepoznati rak dojk s pomočjo Pythona. Uporabili bomo podatkovni niz IDC_regular za prepoznavo invazivnega duktalnega karcinoma, najbolj razširjene oblike raka dojk. Ta se razvija v mlečnih vodih, prodira v vlaknasto ali maščobno tkivo dojk zunaj vodov. V tej ideji znanstvenega projekta za zbiranje podatkov bomo uporabili in knjižnico Keras za klasifikacijo.
Jezik: Python
Podatkovni niz/Paket: IDC_regular
14. Prepoznavanje prometnih znakov
Dosego natančnosti v tehnologiji avtonomnega vožnje vozila s pomočjo projekta Data Science z odprto kodo.
Prometni znaki in prometna pravila so zelo pomembni za vsakega voznika, da se izogne nesrečam. Da bi sledili pravilom, najprej razumeti, kako izgleda prometni znak. Oseba se mora naučiti vseh prometnih znakov, preden ji podelijo vozniško dovoljenje za upravljanje kateregakoli vozila. A zdaj se število avtonomnih vozil povečuje in v bližnji prihodnosti osebe ne bodo več samostojno upravljale vozil. V projektu „Prepoznavanje prometnih znakov“ boste izvedeli, kako lahko program prepozna vrsto prometnih znakov na podlagi slike kot vhodnega signala. Za gradnjo globoke nevronske mreže za prepoznavo razreda, kateremu pripada prometni znak, uporabljamo podatkovni niz za prepoznavo prometnih znakov v Nemčiji (GTSRB). Prav tako ustvarjamo preprost grafični vmesnik za interakcijo z aplikacijo.
Jezik: Python
Nabor podatkov: GTSRB (benchmark za prepoznavanje prometnih znakov v Nemčiji)
Preberite več
Izvor: habr.com
