

V Govorili smo o napovedovanju časovnih vrst. Logična nadaljevanja bo članek o odkrivanju anomalij.
Uporaba
Odkrivanje anomalij se uporablja na področjih, kot so:
1) Napovedovanje okvar opreme
Tako je leta 2010 iranske centrifuge napadel virus Stuxnet, ki je uvedel suboptimalne delovne razmere in povzročil okvare dela opreme zaradi pospešenega obrabe.
Če bi na opremi uporabljali algoritme za iskanje anomalij, bi lahko preprečili situacije s okvarami.
Iskanje anomalij v delovanju opreme se uporablja ne le v jedrski industriji, temveč tudi v metalurgiji in pri delovanju letalskih turbin. In v drugih področjih, kjer je uporaba napovedne diagnostike cenejša od možnih izgub zaradi nepredvidenih okvar.
2) Napovedovanje goljufij
Če se z vaše kartice, ki jo uporabljate v Podolsku, dvigujejo denar v Albaniji, je morda potrebno dodatno preveriti transakcije.
3) Odkrivanje nenormalnih potrošniških vzorcev
Če del kupcev kaže nenormalno vedenje, je morda težava, o kateri ne veste.
4) Odkrivanje nenormalnega povpraševanja in obremenitve
Če so prodaje v trgovini FMCG padle pod mejo zaupanja napovedi, je smiselno poiskati vzrok za to.
Pristopi k odkrivanju anomalij
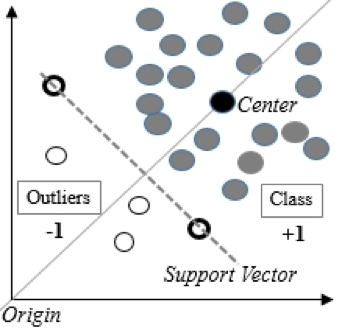
1) Metoda podpornih vektorjev z enim razredom One-Class SVM
Primerna je, ko podatki v učni množici sledijo normalni porazdelitvi, podatki v testni množici pa vsebujejo anomalije.
Metoda enega razreda podpornih vektorjev gradi nelinearno površino okoli izhodišča. Določiti je možno meje, katere podatke šteti za anomalne.
Glede na izkušnje naše ekipe DATA4 je One-Class SVM najpogosteje uporabljeni algoritem za reševanje problema iskanja anomalij.
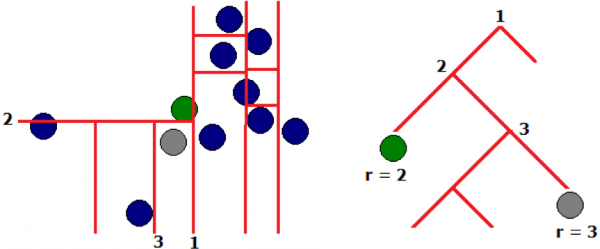
2) Metoda izolacijskega gozda – isolate forest
Pri 'naključnem' načinu gradnje dreves bodo odpadne vrednosti padle v liste na zgodnjih stopnjah (na majhni globini drevesa), torej je lažje 'izolirati' odpadne vrednosti. Izločanje anomalnih vrednosti poteka v prvih iteracijah delovanja algoritma.
3) Eliptična ovojnica in statistične metode
Uporablja se, kadar so podatki normalno porazdeljeni. Bolj ko se meritev približa repu mešanice porazdelitev, bolj nenormalna je vrednost.
V to skupino se uvrščajo tudi druge statistične metode.
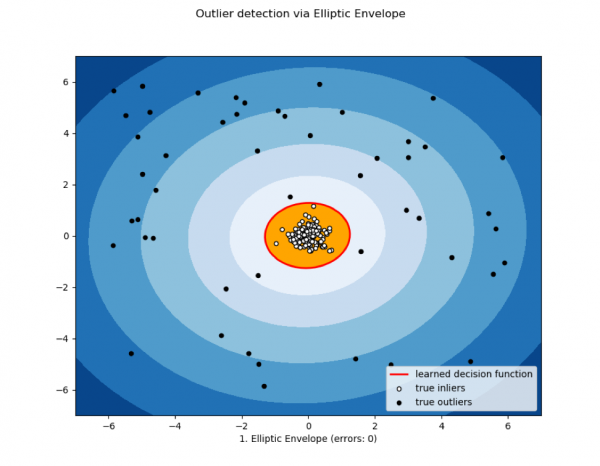
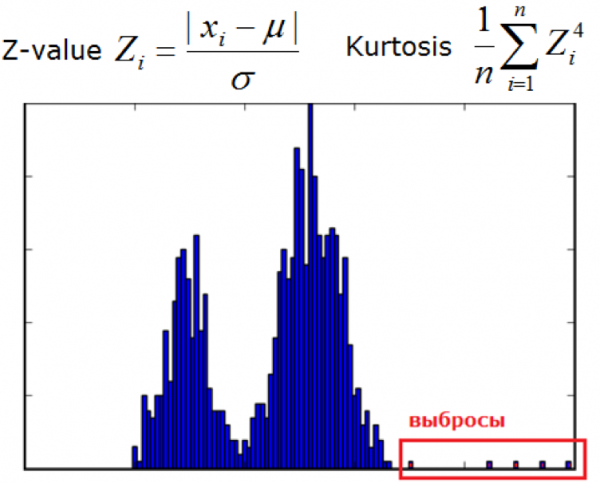
Slika s spletne strani dyakonov.org
4) Metrične metode
Med metode spadajo algoritmi, kot so k najbližjih sosedov, k-ti najbližji sosed, ABOD (odkrivanje odstopajočih vrednosti na osnovi kotov) ali LOF (faktor lokalnih odstopajočih vrednosti).
Primerni so, če so razdalje med vrednostmi v spremenljivkah enakovredne ali normalizirane (da ne merimo piščancev v meta).
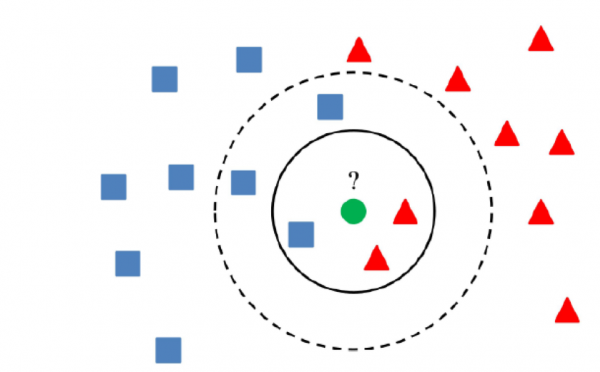
Algoritem k najbližjih sosedov domneva, da so normalne vrednosti razporejene v določenem območju večdimenzionalnega prostora, razdalja do odstopajočih vrednosti pa bo večja kot do ločilne hiperplošče.
5) Kluster metode
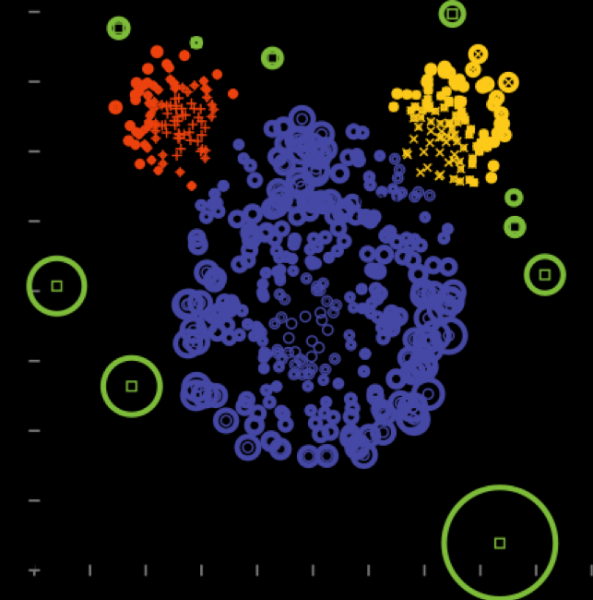
Bistvo kluster metod je, da če je vrednost oddaljena od centrov klustrov več kot za določeno količino, jo lahko štejemo za odstopajočo.
Najpomembnejše je uporabiti algoritem, ki pravilno klusterizira podatke, kar je odvisno od specifične naloge.
6) Metoda glavnih komponent
Primerno je, kjer se poudarijo smeri največjih sprememb varianc.
7) Algoritmi na osnovi napovedovanja časovnih serij
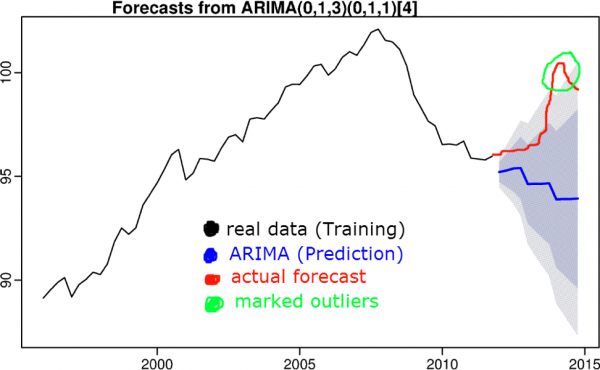
Ideja je, da če vrednost odstopa od zaupanja intervala napovedi, jo obravnavamo kot odstopajočo. Za napovedovanje časovne serije se uporabljajo algoritmi, kot so trojno gladjenje, S(ARIMA), boosting itd.
O algoritmih napovedovanja časovne serije smo govorili v prejšnjem članku.
8) Učenje s supervizijo (regresija, klasifikacija)
Če podatki to omogočajo, uporabljamo algoritme od linearne regresije do rekurenčnih mrež. Izmerili bomo razliko med napovedjo in dejansko vrednostjo ter ugotovili, kako zelo odstopajo podatki od norme. Pomembno je, da ima algoritem dovolj dobro generalizacijsko sposobnost in da učna vzorčna skupina ne vsebuje odstopajočih vrednosti.
9) Modelski testi
K nalogi iskanja odstopajočih vrednosti se bomo lotili kot k nalogi iskanja priporočil. Našo matriko lastnosti bomo razložili z uporabo SVD ali faktorizacijskih strojev, ter vrednosti v novi matriki, ki se znatno razlikujejo od izvornih, sprejeli kot odstopajoče.
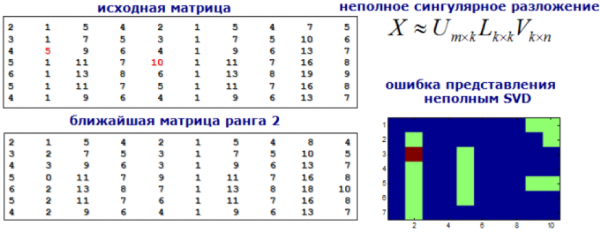
Slika s spletne strani dyakonov.org
Zaključek
V tem članku smo obravnavali glavne pristope k odkrivanju odstopajočih vrednosti.
Iskanje anomalij lahko v veliki meri imenujemo umetnost. Ni idealnega algoritma ali pristopa, katerega uporaba bi rešila vse naloge. Pogosteje se uporablja kompleks metod za reševanje konkretnega primera. Iskanje anomalij poteka s pomočjo enoklasnih metod podpornih vektorjev, izolacijskih gozdov, metrčnih in klaster metod, prav tako pa se uporabljajo glavne komponente in napovedovanje časovnih vrst.
Če poznate druge metode, jih prosimo delite v komentarjih pod člankom.
Izvor: habr.com
