

Sodobni informacijski sistemi so precej zapleteni. Njihova zapletenost ni zanemarljiva, saj je pogojena s kompleksnostjo podatkov, ki jih obdelujejo. Zapletenost podatkov je pogosto povezana z različnostjo uporabljenih podatkovnih modelov. Na primer, ko podatki postanejo "veliki", je ena od neprijetnih značilnosti ne le njihova količina ("volume"), ampak tudi njihova raznolikost ("variety").
Če zaenkrat ne vidite pomanjkljivosti v razmišljanjih, berite naprej.
Vsebina
Polyglot persistence
To, kar je bilo povedano zgoraj, vodi v to, da je v okviru celo enega samega sistema včasih potrebno za shranjevanje podatkov in reševanje različnih nalog njihove obdelave uporabiti več različni DBMS, od katerih vsak podpira svoj podatkovni model. Pod vplivom M. Fowlerja, vrstice znanih knjig in enega od Agile Manifesto, je to situacijo poimenoval mnogovariantno shranjevanje ("polyglot persistence").
Fowler je predstavil tudi naslednji primer organizacije shranjevanja podatkov v polno funkcionalni in visoko obremenjeni aplikaciji na področju spletnega poslovanja.
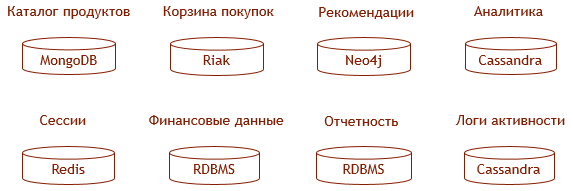
Ta primer je seveda nekoliko pretiran, vendar lahko najdete nekatere razloge v prid izbire ene ali druge DBMS za ustrezen cilj, na primer, .
Jasno je, da je biti skrbnik v takem živalskem vrtu zahtevno.
- Količina kode, ki izvaja shranjevanje podatkov, raste sorazmerno s številom uporabljenih DBMS; količina kode, ki sinhronizira podatke, pa je dobro, če ne raste sorazmerno s kvadratom tega števila.
- Stroški zagotavljanja enterprise lastnosti (razširljivosti, odpornosti na napake, visoke razpoložljivosti) pri vsakem od uporabljenih DBMS narašča večkratno.
- Nemogoče je zagotoviti enterprise značilnosti shranjevanja kot celote — posebej transakcijskost.
Z vidika direktorja živalskega vrta vse izgleda tako:
- Večkratno povečanje stroškov licenc in tehnične podpore s strani proizvajalca DBMS.
- Razširitev kadra in podaljšanje rokov.
- Neposredne finančne izgube ali kazenske sankcije zaradi neusklajenosti podatkov.
Prihaja do občutnega povečanja skupnih stroškov lastništva sistema (TCO). Ali obstaja izhod iz situacije 'večvariantnega shranjevanja'?
Múltimodelnost
Termin 'večvariantno shranjevanje' se je uveljavil leta 2011. Zavedanje problemov pristopa in iskanje rešitev sta trajala nekaj let, do leta 2015 pa so analitiki Gartner izrazili odgovor:
- Iz '»:
Prihodnost DBMS-jev, njihove arhitekture in načini uporabe — multimožnost.
- Iz '»:
Vodilni operativni DBMS-ji bodo ponudili več modelov — relacijski in nerelacijski — kot del ene same platforme.
Zdi se, da analitiki Gartner tokrat niso zgrešili s predvidevanjem. Če obiščete stran z DBMS na DB-Engines, lahko vidite, da večina njegovih voditeljev svoje mesto označuje kot multimodelne DBMS. To lahko opazite tudi na strani s katerim koli specifičnim seznamom.oV spodnji tabeli so navedeni vodilni DBMS-ji v vsakem izmed specifičnih seznamov, ki trdijo, da so multimožni. Za vsak DBMS so navedeni prvotni podprti model (ki je bil nekoč edini) in poleg njega modeli, ki jih podpirajo zdaj. Prav tako so navedeni DBMS-ji, ki se pozicionirajo kot 'prvotno multimožni', ki po trditvah ustvarjalcev nimajo nobenega prvotnega dedovanega modela.
DBMS
| Prvotni model | Dodatni modeli | Relacijski |
|---|---|---|
| Oracle | Grafični, dokumentni | MS SQL |
| Grafični*, dokumentni | Grafični, dokumentni | MS SQL |
| PostgreSQL | Grafični, dokumentni | MarkLogic |
| Dokumentni | Grafični, relacijski | Ključ-vrednost, grafični* |
| MongoDB | Grafični, relacijski | DataStax |
| Široka kolona | Dokumentni, grafični | Ključ-vrednost |
| Redis | Dokumentni, grafični* | Grafični, dokumentni, relacijski |
| ArangoDB | — | MS SQL |
| OrientDB | — | Opombe k tabeli |
| Azure CosmosDB | — | Opombe k tabeli |
Z zvezdicami v tabeli so označene trditve, ki zahtevajo pojasnila:
DBMS PostgreSQL ne podpira grafičnega modela podatkov, vendar ga podpira tak izdelek
- na njegovi osnovi V povezavi z MongoDB je pravilneje govoriti o prisotnosti grafičnih operatorjev v jeziku poizvedb (
- $lookup, ), kot podpora za grafni model, čeprav je seveda njihovo uvajanje zahtevalo nekatere optimizacije na ravni fizičnega shranjevanja v smeri podpore grafnemu modelu.
- V kontexte Redis se jedná o rozšíření .
Dále pro každou z kategorii ukážeme, jak se implementuje podpora více modelů v DBMS této kategorie. Za nejdůležitější budeme považovat relační, dokumentovou a grafovou modely a na příkladech konkrétních DBMS ukážeme, jak se implementují "chybějící".
Múltimodelne DBMS na osnovi relacijskega modela
V současnosti jsou předními DBMS relační databáze, prognózu Gartnera by nebylo možné považovat za naplněnou, pokud by RDBMS neprokazovaly pokroky směrem k multimodelovosti. A prokazují. Nyní se úvahy o tom, že multimodelová DBMS je jako švýcarský nůž, kterým nelze nic dokonale provést, mohou okamžitě směrovat k Larrymu Ellisonovi.
Autorovi se však více líbí implementace multimodelovosti v Microsoft SQL Server, na příkladu kterého bude popsána podpora RDBMS dokumentových a grafových modelů.
Dokumentni model v MS SQL Server
O tom, jak je v MS SQL Server implementována podpora dokumentového modelu, již na Habrе byly dvě vynikající články, omezím se na stručný přehled a komentář:
Způsob podpory dokumentového modelu v MS SQL Server je dost typický pro relační DBMS: JSON dokumenty se doporučuje ukládat do běžných textových polí. Podpora dokumentového modelu spočívá v poskytování speciálních operátorů pro zpracování tohoto JSON:
- pro extrakci skalárních hodnot atributů,
- pro extrakci poddokumentů.
Druhým argumentem obou operátorů je výraz v syntaxi podobné JSONPath.
Abstraktně lze říci, že uložené tímto způsobem dokumenty nejsou v relační DBMS "prvními třídami", na rozdíl od n-tic. Konkrétně v MS SQL Server v současnosti chybí indexy na polích JSON dokumentů, což ztěžuje operace spojení tabulek podle hodnot těchto polí a dokonce i výběr dokumentů podle těchto hodnot. Nicméně je možné vytvořit na takovém poli počítaný sloupec a index na něm.
Navíc MS SQL Server poskytuje možnost pohodlně konstruovat JSON dokument z obsahu tabulek pomocí operátoru — možnost, ki je na nek način nasprotna prejšnjemu običajnemu shranjevanju. Jasno je, da kakorkoli hiter je RDBMS, tak pristop nasprotuje ideologiji dokumentnih DBMS, ki v bistvu shranjujejo pripravljene odgovore na priljubljena vprašanja in lahko rešujejo le težave udobnosti razvoja, ne pa hitrosti delovanja.
Nazadnje, MS SQL Server omogoča reševanje naloge, nasprotne konstrukciji dokumenta: JSON lahko razdelite v tabele s pomočjo . Če dokument ni povsem plosko strukturiran, bo potrebno uporabiti CROSS APPLY.
Grafični model v MS SQL Server
Podpora grafični (LPG) modelu je v Microsoft SQL Serverju prav tako zagotovo : predlagano je uporabiti posebne tabele za shranjevanje vozlišč in za shranjevanje robov grafa. Takšne tabele se ustvarijo z uporabo izrazov CREATE TABLE AS NODE in CREATE TABLE AS EDGE ustrezno.
Tabele prvega tipa so podobne običajnimi tabelam za shranjevanje zapisov, pri čemer obstaja le ena zunanja razlika, da tabela vsebuje sistemsko polje $node_id — unikatni identifikator vozlišča grafa v okviru baze podatkov.
Podobno imajo tabele drugega tipa sistemska polja $from_id in $to_id, zapisi v takih tabelah jasno določajo povezave med vozlišči. Za shranjevanje povezav vsake vrste se uporablja ločena tabela.
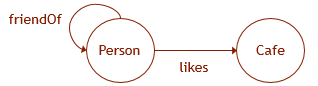 Ilustrirajmo povedano s primerom. Recimo, da imajo grafični podatki shemo, kot je prikazana na priloženi sliki. Takrat je za ustvarjanje ustrezne strukture v bazi podatkov potrebno izvesti naslednje DDL poizvedbe:
CREATE TABLE Person (
  ID INTEGER NOT NULL,
  name VARCHAR(100)
) AS NODE;

CREATE TABLE Cafe (
  ID INTEGER NOT NULL,
  name VARCHAR(100),
) AS NODE;

CREATE TABLE likes (
  rating INTEGER
) AS EDGE;

CREATE TABLE friendOf
  AS EDGE;

ALTER TABLE likes
  ADD CONSTRAINT EC_LIKES CONNECTION (Person TO Cafe);
Osnovna specifika takih tabel je v tem, da lahko v poizvedbah uporabljate grafične vzorce s sintakso, podobno Cypherju (vendar pa „*“ in druge še niso podprte). Na podlagi meritev zmogljivosti lahko prav tako domnevamo, da je način shranjevanja podatkov v teh tabelah drugačen od mehanizma shranjevanja podatkov v običajnih tabelah in optimiziran za izvajanje takšnih grafičnih poizvedb.
SELECT Cafe.name
  FROM Person, likes, Cafe
  WHERE MATCH (Person-(friendOf)-(likes)->Cafe)
  AND Person.name = 'John';
Poleg tega je precej težko delati s takšnimi tabelami, ne da bi uporabili te grafične vzorce, saj bi v običajnih SQL poizvedbah za reševanje podobnih nalog bilo treba vložiti dodatne napore, da bi pridobili sistemske 'grafične' identifikatorje vozlov ($node_id, $from_id, $to_id; iz istega razloga poizvedbe za vstavljanje podatkov tukaj niso navedene, ker so preveč obsežne).
Sklepajoč opis realizacij dokumentnega in grafičnega modela v MS SQL Serverju, bi poudaril, da se takšne realizacije enega modela nad drugim na prvi pogled ne zdijo uspešne predvsem z vidika jezikovnega dizajna. Potrebno je širiti en jezik z drugim, jeziki niso povsem 'ortogonalni', pravila združljivosti so lahko precej izvirna.
Múltimodelne DBMS na osnovi dokumentnega modela
V tem razdelku bi rad ponazoril realizacijo večmodelnosti v dokumentnih DBMS-ih na primeru ne najbolj priljubljene izmed njih, MongoDB (kot je bilo omenjeno, vsebuje le pogojno grafične operaterje $graphLookup in ), kot pa o podpori grafičnega modela, čeprav je njihovo uvedbo zahtevalo nekaj optimizacij na fizičnem nivoju shranjevanja v smeri podpore grafičnemu modelu., ki ne delujejo na razdeljenih zbirkah), temveč na primeru bolj zrele in 'enterprisne' DBMS. .
Torej, naj zbirka vsebuje niz XML-dokumentov naslednje oblike (shranjevanje JSON-dokumentov MarkLogic prav tako omogoča):
Janez
  Novak
Relacijski model v MarkLogic
Relacijska predstavitev zbirke dokumentov je mogoče ustvariti s pomočjo (vsebina elementov value v spodnjem primeru je lahko poljubni XPath):
/Person


      Oseba


          SSN
          @SSN
          string


          ime
          name


          priimek
          surname
Na ustvarjeni prikaz lahko naslovimo SQL poizvedbo (na primer, preko ODBC):
SELECT name, surname FROM Person WHERE name="Janez"Na žalost je relacijska predstavitev, ustvarjena s pomočjo predloge za prikaz, dostopna le za branje. Pri obdelavi poizvedbe do nje bo MarkLogic poskušal uporabiti . Pred tem je imel MarkLogic tudi omejene relacijske predstavitve, popolnoma in dostopne za pisanje, vendar se zdaj štejejo za zastarele.
Grafični model v MarkLogic
S podporo grafnega (RDF) modela je situacija podobna. Tudi tukaj lahko z uporabo ustvarimo RDF-reprezentacijo zbirke dokumentov iz zgoraj navedenega primera:
/Person
PREFIX
"http://example.org/example#"
sem:iri( $PREFIX || @SSN )
sem:iri( $PREFIX || surname )
sem:iri( $PREFIX || @SSN )
sem:iri( $PREFIX || name )
Na prejeti RDF-graf se lahko naslovi SPARQL poizvedba:
PREFIX :
SELECT ?name ?surname {
  :631803299804 :name ?name ; :surname ?surname .
}
Za razliko od relacijskega modela MarkLogic podpira grafni model še na dva druga načina:
- RDBMS lahko predstavlja popolno ločeno skladišče RDF-podatkov (v tem se bodo trojčki imenovali v nasprotju z zgoraj opisanimi ).
- RDF lahko v posebni serializaciji preprosto vstavi v XML- ali JSON-dokumenti (in trojčki bodo takrat imenovani ). Verjetno je to alternativa mehanizmom
idrefitd.
Dober vpogled v to, kako je "v resnici" vse v MarkLogic, daje , ki je v tem smislu nizko nivojski, čeprav je njegova naloga pravzaprav obratna — poskusiti se abstrahirati od uporabljene podatkovne strukture, omogočiti dosledno delo s podatki v različnih modelih, transakcijsko učinkovitost itd.
Múltimodelne DBMS "brez osnovnega modela"
Na trgu so tudi RDBMS-ji, ki se pozicionirajo kot izvorno večmodelni, brez dediščine osnovnega modela. Med njimi so , (od leta 2018 razvijalec podjetja pripada SAP) in (storitev v okviru oblaka Microsoft Azure).
V resnici v ArangoDB in OrientDB obstajajo "osnovni" modeli. V obeh primerih gre za lastne podatkovne modele, ki so poenostavitve dokumentnih. Poenostavitve se v glavnem nanašajo na olajšanje možnosti izvajanja poizvedb grafnega in relacijskega značaja.
Ti modeli so v navedenih SGBD edini, ki so na voljo za uporabo, za delo z njimi pa so namenjeni lastni jeziki poizvedb. Nedvomno so ti modeli in SGBD perspektivni, a pomanjkanje združljivosti s standardnimi modeli in jeziki onemogoča njihovo uporabo v dednih sistemih — zamenjave za že uporabljene SGBD ni mogoče.
O ArangoDB in OrientDB je že bila odlična objava na Habrju: .
ArangoDB
ArangoDB trdi, da podpira grafni model podatkov.
Vrhovi grafa v ArangoDB so običajni dokumenti, medtem ko so robovi dokumenti posebne vrste, ki imajo poleg običajnih sistemskih polj (_key, _id, _rev) sistemska polja _from in _to. Dokumenti v dokumentnih SGBD se tradicionalno združujejo v zbirke. Zbirke dokumentov, ki predstavljajo robove, se v ArangoDB imenujejo edge-zbirke. Mimogrede, dokumenti edge-zbirke so prav tako dokumenti, zato robovi v ArangoDB lahko delujejo tudi kot vrhovi.
Izvorni podatki
Recimo, da imamo zbirko persons, dokumenti katere izgledajo tako:
[
  {
    "_id"  : "people/alice" ,
    "_key" : "alice" ,
    "name" : "Alisa"
  },
  {
    "_id"  : "people/bob" ,
    "_key" : "bob" ,
    "name" : "Bob"
  }
]
Recimo, da obstaja tudi zbirka cafes:
[
  {
    "_id" : "cafes/jd" ,
    "_key" : "jd" ,
    "name" : "John Donne"
  },
  {
    "_id" : "cafes/jj" ,
    "_key" : "jj" ,
    "name" : "Jean-Jacques"
  }
]
Potem bi zbirka likes lahko izgledala takole:
[
  {
    "_id" : "likes/1" ,
    "_key" : "1" ,
    "_from" : "persons/alice" ,
    "_to" : "cafes/jd",
    "since" : 2010
  },
  {
    "_id" : "likes/2" ,
    "_key" : "2" ,
    "_from" : "persons/alice" ,
    "_to" : "cafes/jj",
    "since" : 2011
  } ,
  {
    "_id" : "likes/3" ,
    "_key" : "3" ,
    "_from" : "persons/bob" ,
    "_to" : "cafes/jd",
    "since" : 2012
  }
]
Poizvedbe in rezultati
Poizvedba v grafnem slogu v jeziku AQL, ki se uporablja v ArangoDB, ki vrača čitljive informacije o tem, katero kavarno ima kdo rad, izgleda takole:
FOR p IN persons
  FOR c IN OUTBOUND p likes
  RETURN { person : p.name , likes : c.name }
V relacijskem slogu, ko bolj 'računamo' povezave, kot jih hranimo, je to poizvedbo mogoče prepisati takole (mimogrede, brez zbirke likes bi se dalo obiti):
FOR p IN persons
  FOR l IN likes
  FILTER p._key == l._from
    FOR c IN cafes
    FILTER l._to == c._key
    RETURN { person : p.name , likes : c.name }
Rezultat bo v obeh primerih enak:
[
  { "person" : "Alisa" , likes : "Jean-Jacques" } ,
  { "person" : "Alisa" , likes : "John Donne" } ,
  { "person" : "Bob" , likes : "John Donne" }
]
Še poizvedbe in rezultati
Če se zdi, da je format rezultata zgoraj bolj značilen za relacijsko DBMS kot za dokumentno, lahko poskusite z naslednjim poizvedovanjem (ali pa lahko uporabite ):
FOR p IN persons
  RETURN {
    person : p.name,
    likes : (
      FOR c IN OUTBOUND p likes
      RETURN c.name
    )
}
Rezultat bo imel naslednjo obliko:
[
  { "person" : "Alisa" , likes : ["Žan-Žak" , "Džon Don" ] } ,
  { "person" : "Bob" , likes : ["Džon Don"] }
]
OrientDB
Osnova za implementacijo grafnega modela na vrhu dokumentne baze v OrientDB je polja dokumentov, ki morajo imeti poleg več ali manj standardnih skalarnih vrednosti tudi vrednosti takih tipov, kot so LINK, LINKLIST, LINKSET, LINKMAP in LINKBAG. Vrednosti teh tipov so reference ali zbirke sklicev na dokumentov.
Dodeljen sistemski identifikator dokumenta ima "fizični pomen", ki kaže na položaj zapisa v bazi, in izgleda približno tako: @rid : #3:16. Tako so vrednosti referenčnih lastnosti v resnici bolj kazalci (kot v grafnem modelu), ne pa kriteriji za izbiro (kot v relacijski).
Kot v ArangoDB, so v OrientDB robovi predstavljeni kot ločeni dokumenti (čeprav, če rob nima svojih lastnosti, ga lahko naredite , in mu ne bo ustrezal ločen dokument).
Izvorni podatki
V formatu, ki se približuje baze OrientDB, bi podatki iz prejšnjega primera za ArangoDB izgledali približno tako:
[
     {
      "@type": "document",
      "@rid": "#11:0",
      "@class": "Person",
      "name": "Alisa",
      "out_likes": [
        "#30:1",
        "#30:2"
      ],
      "@fieldTypes": "out_likes=LINKBAG"
    },
    {
      "@type": "document",
      "@rid": "#12:0",
      "@class": "Person",
      "name": "Bob",
      "out_likes": [
        "#30:3"
      ],
      "@fieldTypes": "out_likes=LINKBAG"
    },
    {
      "@type": "document",
      "@rid": "#21:0",
      "@class": "Cafe",
      "name": "Žan-Žak",
      "in_likes": [
        "#30:2",
        "#30:3"
      ],
      "@fieldTypes": "in_likes=LINKBAG"
    },
    {
      "@type": "document",
      "@rid": "#22:0",
      "@class": "Cafe",
      "name": "Džon Don",
      "in_likes": [
        "#30:1"
      ],
      "@fieldTypes": "in_likes=LINKBAG"
    },
    {
      "@type": "document",
      "@rid": "#30:1",
      "@class": "likes",
      "in": "#22:0",
      "out": "#11:0",
      "since": 1262286000000,
      "@fieldTypes": "in=LINK,out=LINK,since=date"
    },
    {
      "@type": "document",
      "@rid": "#30:2",
      "@class": "likes",
      "in": "#21:0",
      "out": "#11:0",
      "since": 1293822000000,
      "@fieldTypes": "in=LINK,out=LINK,since=date"
    },
    {
      "@type": "document",
      "@rid": "#30:3",
      "@class": "likes",
      "in": "#21:0",
      "out": "#12:0",
      "since": 1325354400000,
      "@fieldTypes": "in=LINK,out=LINK,since=date"
    }
  ]
Kot vidimo, vrhovi prav tako hranijo podatke o vhodnih in izhodnih robovih. Pri Document API za referenčno celovitost je potrebno spremljati samo, Graph API pa to nalogo prevzame nase. Poglejmo, kako izgledajo poizvedbe v OrientDB v 'čistih', v programske jezike nepovezanih poizvedbenih jezikih.
Poizvedbe in rezultati
Poizvedba, ki je enaka poizvedbi iz primera za ArangoDB, v OrientDB izgleda tako:
SELECT name AS person_name, OUT('likes').name AS cafe_name
   FROM Person
   UNWIND cafe_name
Rezultat bo prejet v naslednji obliki:
[
  { "person_name": "Alisa", "cafe_name": "John Donne" },
  { "person_name": "Alisa", "cafe_name": "Jean-Jacques" },
  { "person_name": "Bob",  "cafe_name": "Jean-Jacques" }
]
Če se format rezultata ponovno zdi preveč 'relacijski', odstranite vrstico z :
[
  { "person_name": "Alisa", "cafe_name": [ "John Donne", "Jean-Jacques" ] },
  { "person_name": "Bob",  "cafe_name": [ "Jean-Jacques" ] }
]
Jezik poizvedb OrientDB lahko opišemo kot SQL s podobnimi vstavki Gremlina. V različici 2.2 se je pojavila oblika poizvedbe, podobna Cypherju, :
MATCH {CLASS: Person, AS: person}-likes-> {CLASS: Cafe, AS: cafe}
RETURN person.name AS person_name, LIST(cafe.name) AS cafe_name
GROUP BY person_name
Format rezultata bo enak tistemu iz prejšnje poizvedbe. Razmislite, kaj je treba odstraniti, da bo bolj 'relacijski', kot v prvi poizvedbi.
Azure CosmosDB
Manjša želja, da kar je bilo omenjeno o ArangoDB in OrientDB, velja za Azure CosmosDB. CosmosDB ponuja naslednje API-je za dostop do podatkov: SQL, MongoDB, Gremlin in Cassandra.
SQL API in MongoDB API se uporabljata za dostop do podatkov v dokumentnem modelu. Gremlin API in Cassandra API sta namenjena dostopu do podatkov v grafnem in kolonskem formatu. Podatki v vseh modelih so shranjeni v formatu notranjega modela CosmosDB: („atom-record-sequence“), ki je prav tako blizu dokumentnemu.
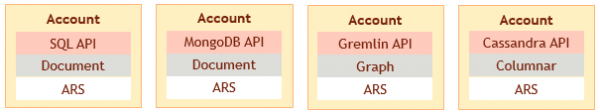
Toda izbrani model podatkov in uporabljeni API se določita ob ustvarjanju računa v storitvi. Ni mogoče dostopati do podatkov, naloženih v enem modelu, v formatu drugega modela, kar bi bilo približno tako prikazano:
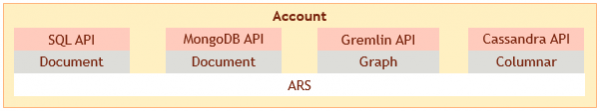
Tako je multimodelnost v Azure CosmosDB trenutno le možnost uporabe več baz podatkov, ki podpirajo različne modele, enega proizvajalca, kar ne rešuje vseh težav večvariantnega shranjevanja.
Múltimodelne DBMS na osnovi grafičnega modela?
Opazno je, da na trgu trenutno ni multimodelnih DBMS-jev, ki bi imele grafni model kot osnovo (razen pogledu na multimodelnost, ki podpira hkrati dva grafna modela: RDF in LPG; glej o tem v ). Največja težava je izvajanje na dokumentnem grafnem modelu, ne pa na relacijskem.
Vprašanje, kako izvajati relacijski model na grafnem, je bilo obravnavano že v času oblikovanja slednjega. Kot , na primer, :
Ne obstaja nič inherentnega v grafnem pristopu, kar bi preprečilo ustvarjanje plasti (npr. z ustrezno indeksacijo) na grafični bazi podatkov, ki omogoča relacijski pogled z (1) pridobivanjem tuplov iz običajnih ključnih vrednostnih parov in (2) grupiranjem tuplov po vrsti relacije.
Pri izvajanju dokumentnega modela na grafičnem je treba upoštevati, na primer, naslednje:
- Elementi JSON-matrice se smatrajo za urejene, izhajajoče iz vrha roba grafa – ne;
- Podatki v dokumentnem modelu so običajno denormalizirani, shranjevanje več kopij istega vgrajenega dokumenta si ne želimo, poleg tega poddokumenti ponavadi nimajo identifikatorjev;
- Po drugi strani pa ideologija dokumentnih DBMS temelji na tem, da so dokumenti pripravljeni 'agregati', ki jih ni treba vsakič znova graditi. Potrebno je omogočiti v grafičnem modelu hitro pridobitev podgrafa, ki ustreza pripravljenemu dokumentu.
Malo reklame
Avtor članka je povezan z razvojem DBMS NitrosBase, katere notranji model je grafni, zunanji modeli pa so relacijski in dokumentni, ki so njegovi prikazi. Vsi modeli so enakovredni: praktično kateri koli podatki so dostopni v katerem koli izmed njih z uporabo naravnega jezika poizvedb. Poleg tega je mogoče podatke spremeniti v katerem koli prikazu. Spremembe se bodo odražale v notranjem modelu in posledično v drugih prikazih.
Kako izgledajo ustreznosti modelov v NitrosBase – bom opisal, upam, v enem izmed naslednjih člankov.
Zaključek
Upam, da so splošne konture tistega, kar imenujemo multimodelnost, bralcu bolj ali manj jasne. Multimodelne DBMS so dokaj različne, in 'podpora več modelom' se lahko izgleda različno. Za razumevanje tega, kar imenujejo 'multimodelnost' v vsakem konkretnem primeru, je koristno odgovoriti na naslednja vprašanja:
- Ali gre za podporo tradicionalnim modelom ali pa za neko 'hibridno' eno samo model?
- So modeli 'enakovredni', ali je eden izmed njih podrejen drugim?
- So are models indifferent to each other? Can data written in one model be read in another or even overwritten?
I think we can already answer positively about the relevance of multimodel DBMS, but the interesting question is which specific types will be more in demand in the near future. It seems that the more in demand will be the multimodel DBMS that support traditional models, primarily relational; the popularity of multimodel DBMS offering new models that combine the advantages of various traditional ones is likely a matter for the more distant future.
Samo registrovani korisnici mogu učestvovati u anketi. , molim vas.
Do you use multimodel DBMS?
We do not use them, we store everything in one DBMS and in one model.
We utilize the multimodel capabilities of traditional DBMS.
We practice polyglot persistence.
We use new multimodel DBMS (Arango, Orient, CosmosDB).
19 users voted. 4 users abstained.
Izvor: habr.com
