

tl;dr:
- Strojno učenje išče vzorce v podatkih. Vendar pa je umetna inteligenca lahko 'pristranska' – torej najde napačne vzorce. Na primer, sistem za odkrivanje kožnega raka na fotografiji lahko posebej pozorno obravnava posnetke, narejene v zdravniški pisarni. Strojno učenje ne zna razumeti: njegovi algoritmi le razkrijejo vzorce v številkah, in če podatki niso reprezentativni, bo tudi rezultat njihove obdelave takšen. In odkrivanje takih napak je lahko zahtevno zaradi same mehanike strojenega učenja.
- Najbolj očitno in zastrašujoče problematično področje je človeška raznolikost. Obstoja mnogo razlogov, zakaj lahko podatki o ljudeh izgubijo objektivnost že v fazi zbiranja. Vendar pa ne smemo misliti, da se ta problematika nanaša le na ljudi: podobne težave se pojavijo pri poskusih odkrivanja poplave v skladišču ali okvarjene plinske turbine. Nekateri sistemi lahko imajo predsodke glede barve kože, drugi pa bodo pristransko obravnavali senzorje Siemens.
- Takšne težave niso novost za strojno učenje in so značilne daleč ne le zanj. Napačne predpostavke se pojavijo v katerikoli kompleksni strukturi, in razumeti, zakaj je bilo sprejeto takšno ali drugačno odločitev, je vedno težko. Boriti se je treba s tem celovito: ustvariti orodja in procese za preverjanje – in izobraževati uporabnike, da ne sledijo slepo priporočilom AI. Strojno učenje resnično opravi nekatere stvari bistveno bolje od nas – a psi so na primer mnogo učinkovitejši od ljudi pri odkrivanju drog, kar ni razlog, da bi jih pritegnili kot priče in izrekli sodbe na podlagi njihovih izjav. In psi, mimogrede, so bistveno pametnejši od katerekoli sistema strojenega učenja.
Strojno učenje danes predstavlja enega najpomembnejših temeljev tehnoloških trendov. To je eden glavnih načinov, kako bo tehnologija spreminjala svet v naslednjem desetletju. Nekateri vidiki teh sprememb vzbujajo skrb. Na primer, potencialni vpliv strojenega učenja na trg dela ali njegova uporaba za neetične namene (na primer, avtoritarni režimi). Obstaja še en problem, ki mu je posvečen ta post: pristranskost umetne inteligence.
To je zapletena zgodba.
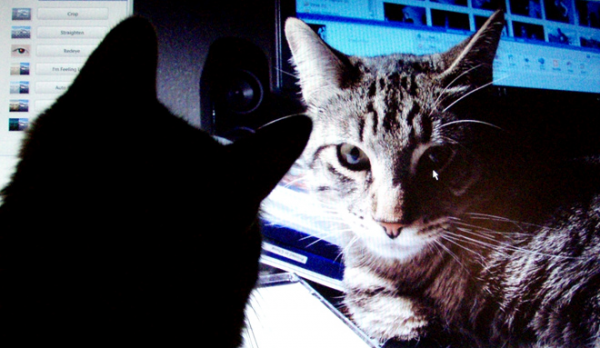
Google-ov AI zna najti mačke. Ta novica iz leta 2012 je bila tedaj nekaj posebnega.
Kaj je 'pristranskost AI'?
'Surovi podatki' so hkrati oksimoron in slaba ideja; podatke je treba dobro in skrbno pripraviti. —Jeffrey Boker
Pred letom 2013 je bilo za ustvarjanje sistema, ki, recimo, prepoznava mačke na fotografijah, potrebno opisovati logične korake. Kako najti kote na sliki, prepoznati oči, analizirati teksture za prisotnost dlake, prešteti tačke, in podobno. Nato zbrati vse komponente — in ugotoviti, da vse to pravzaprav ne deluje. Nekaj like mehaničnega konja — teoretično ga je mogoče izdelati, vendar je v praksi preveč zapleten za opis. Na koncu imate stotine (ali celo tisoče) ročno napisanih pravil. In nobene delujoče modele.
Z nastankom strojnega učenja smo prenehali uporabljati 'ročna' pravila za prepoznavanje določenih predmetov. Namesto tega vzamemo tisoč primerkov 'nečesa', X, tisoč primerkov 'nečesa drugega', Y, in prisilimo računalnik, da zgradi model na podlagi njihove statistične analize. Nato damo temu modelu neki primer podatkov in z določeno natančnostjo določi, ali ustreza enemu od nizov. Strojno učenje generira model na podlagi podatkov, ne pa s pomočjo človeka, ki ga piše. Rezultati so osupljivi, zlasti na področju prepoznavanja slik in vzorcev, zato se celotna IT industrija zdaj spreminja v strojno učenje (ML).
Toda ni vse tako enostavno. V resničnem svetu vaši tisoči primerkov X ali Y vsebujejo tudi A, B, J, L, O, R in celo L. Morda so neenakomerno porazdeljeni in nekateri se morda pojavljajo tako pogosto, da se sistem osredotoči nanje bolj kot na objekte, ki vas zanimajo.
Kaj to pomeni v praksi? Moj najljubši primer je, ko sistemi za prepoznavanje slik . Jasno je zakaj: večina fotografij primerov 'ovca' je posneta na travnikih, kjer živijo, in na teh slikah trava zavzema veliko več prostora kot majhni belkasti puhasti, in prav travo sistemi štejejo kot najpomembnejšo.
So tudi resnejši primeri. Od nedavnega — en o odkrivanju raka kože na fotografijama. Ispostavilo se da dermatolozi često fotografišu lenjir zajedno sa manifestacijama raka kože kako bi zabeležili veličinu formacija. Na primerima fotografija zdrave kože lenjira nema. Za AI sistem, takvi lenjiri (tačnije, pikseli koje određujemo kao „lenjir“) postali su jedna od razlika između setova primera, i ponekad važniji od sitne osipe na koži. Tako je sistem, koji je napravljen za prepoznavanje raka kože, ponekad umesto njega prepoznavao lenjire.
Ključna tačka ovde je da sistem nema semantičko razumevanje onoga što gleda. Mi gledamo na skup piksela i vidimo u njima ovcu, kožu ili lenjire, dok sistem vidi samo numerički niz. On ne vidi trodimenzionalni prostor, ne vidi ni objekte, ni teksture, ni ovce. On jednostavno vidi obrasce u podacima.
Složenost dijagnostikovanja takvih problema je u tome što neuronska mreža (model koji je generisan vašim sistemom mašinskog učenja) consists of thousands, hundreds of thousands of nodes. Ne postoji jednostavan način da se zaviri u model i vidi kako donosi odluke. Imati takav način značilo bi da je proces dovoljno jednostavan da bi se svi pravila mogla opisati ručno, bez korišćenja mašinskog učenja. Ljudi se brinu da je mašinsko učenje postalo neka vrsta „crne kutije“. (Objaasniću kasnije zašto je ovo poređenje ipak preterano.)
To je, u opšte rečeno, problem pristrasnosti veštačke inteligencije ili mašinskog učenja: sistem za pronalaženje obrazaca u podacima može pronalaziti pogrešne obrasce, a vi to možete ne primetiti. To je fundamentalna karakteristika tehnologije i to je očigledno svima koji rade s njom u naučnim krugovima i velikim tehnološkim kompanijama. Ali njene posledice su složene, a naša moguća rešenja tih posledica — takođe.
Počnimo prvo o posledicama.
AI može implicitno za nas donositi odluke u korist određenih kategorija ljudi, oslanjajući se na mnoštvo nevidljivih signala.
Slučajevi pristrasnosti AI-a
Najočiglednije i najzastrašujuće je to što se ovaj problem može ispoljiti kada je reč o ljudskoj raznolikosti. Nedavno , da je Amazon poskušal zgraditi sistem strojnega učenja za začetno preverjanje kandidatov za zaposlitev. Ker je med zaposlenimi v Amazonu več moških, je bilo tudi več primerov »uspešnega zaposlovanja« moškega spola, zato je v pregledih življenjepisov, ki jih je predlagal sistem, bilo več moških. Amazon je to opazil in sistema ni izdal v produkcijo.
Najpomembnejše pri tem primeru je, da je sistem, po govoricah, dajal prednost moškim kandidatom, kljub temu da spol ni bil naveden v življenjepisu. Sistem je opazil druge vzorce v primerih »uspešnega zaposlovanja«: na primer, ženske lahko uporabljajo posebne besede za opis svojih dosežkov ali imajo posebna hobija. Seveda sistem ni vedel, kaj pomeni »hokej«, kdo so »ljudje« ali kaj pomeni »uspeh« — preprosto je izvajal statistično analizo besedila. A vzorci, ki jih je opazil, bi verjetno ostali neopaženi s strani ljudi, nekaterih pa (na primer, da ljudje različnih spolov različno opisujejo uspeh) bi morda težko opazili, tudi če bi jih gledali.
Nato postane še slabše. Sistem strojnega učenja, ki zelo dobro prepoznava rak na svetli koži, morda slabše deluje na temni koži, ali obratno. Ne nujno zaradi pristranskosti, temveč zato, ker boste verjetno morali zgraditi ločen model za drugo barvo kože, izbrati druge značilnosti. Sistemi strojnega učenja niso zamenljivi, tudi v tako ozkem področju, kot je prepoznavanje slik. Prilagoditi morate sistem, včasih zgolj s poskusi in napakami, da dobro zaznate posebnosti v podatkih, ki vas zanimajo, dokler ne dosežete želenega natančnega rezultata. Vendar morda ne boste opazili, da je sistem natančen v 98 % primerov pri delu z eno skupino in le v 91 % (čeprav je to bolj natančno kot analiza, ki jo opravi človek) — z drugo.
Zaenkrat sem večinoma uporabljal primere, povezane z ljudmi in njihovimi značilnostmi. Na to tematiko se predvsem osredotoča razprava okoli te težave. Vendar je pomembno razumeti, da je pristranskost do ljudi le del problema. Uporabljali bomo strojno učenje za mnoge stvari, in napaka vzorčenja bo relevantna pri vseh njih. Po drugi strani pa, če delate z ljudmi, lahko pristranskost podatkov ni povezana z njimi.
Da bi to razumeli, vratimo se na primer s rakom kože i razmotrimo tri hipotetičke mogućnosti sistemskog kvara.
- Neujednačena raspodela ljudi: neuravnotežen broj slika kože različitih tonova, što dovodi do lažno pozitivnih ili lažno negativnih rezultata vezanih za pigmentaciju.
- Podaci na kojima se obučava sistem sadrže često prisutnu i neujednačeno raspoređenu osobinu, koja nije povezana s ljudima i nema dijagnostičku vrednost: lenjir na slikama manifestacija raka kože ili trava na slikama ovaca. U tom slučaju, rezultat će se razlikovati ako sistem na slici pronađe пикселе nečega što ljudsko oko prepoznaje kao 'lenjir'.
- Podaci sadrže spoljnu osobinu koju čovek ne može videti, čak i ako je traži.
Šta to znači? A priori znamo da podaci mogu različito predstavljati različite grupe ljudi, i barem možemo planirati potragu za sličnim izuzecima. Drugim rečima, postoji mnoštvo društvenih razloga da se pretpostavi da podaci o grupama ljudi već sadrže određena predrasuda. Ako pogledamo fotografiju s lenjirom, videćemo taj lenjir — samo smo ga ranije ignorisali, znajući da nije bitan, i zaboravili da sistemu ništa nije poznato.
Ali šta ako su sve vaše fotografije nezdrave kože napravljene u kancelariji gde se koriste sijalice sa žarnom niti, a zdrave — pri fluorescentnom svetlu? Šta ako ste, nakon snimanja zdrave kože, pre snimanja nezdrave ažurirali operativni sistem na telefonu, a Apple ili Google su malo promenili algoritam suzbijanja šuma? Čovek to ne može primetiti, koliko god tražio takve osobine. Ali sistem mašinskog učenja odmah će to primetiti i iskoristiti. On ne zna ništa.
Medtem ko smo govorili o lažnih korelacijah, se lahko zgodi, da so podatki točni in rezultati pravilni, vendar jih iz etičnih, pravnih ali upravljalskih razlogov nočete uporabiti. V nekaterih jurisdikcijah, na primer, ni dovoljeno ženskam zagotavljati popusta na zavarovanje, kljub temu da morda žene vožnjo obvladajo bolje. Zlahka si lahko predstavljamo sistem, ki bi ženskam dodelil nižji koeficient tveganja, ko analizira zgodovinske podatke. V redu, odstranimo imena iz vzorca. A spomnite se primera z Amazonom: sistem lahko določi spol na podlagi drugih dejavnikov (čeprav ne ve, kaj je spol, niti kaj je avtomobil), vi pa tega ne opazite, dokler regulator ne pregleda ponujenih tarif in vam ne naloži kazni.
Nazadnje, pogosto se domneva, da bomo takšne sisteme uporabljali le za projekte, povezane z ljudmi in socialnimi interakcijami. To ni res. Če izdelujete plinske turbine, boste zagotovo želeli uporabiti strojno učenje za telemetrijo, ki jo prenaša deset ali več senzorjev iz vašega izdelka (avdio, video, temperatura in vsi drugi senzorji generirajo podatke, ki jih je zelo enostavno prilagoditi za ustvarjanje modela strojnega učenja). Hipotetično lahko rečete: 'Tukaj so podatki o tisoč pokvarjenih turbinah, pridobljeni pred njihovo okvaro, in tukaj so podatki tisoč turbin, ki se niso pokvarile. Zgradite model, da ugotovite, kakšna je razlika med njimi.' Zdaj pa si predstavljajte, da so senzorji Siemens nameščeni na 75 % slabih turbinah in le na 12 % dobrih (pri tem ni povezave z okvarami). Sistem bo zgradil model, da bi našel turbine s senzorji Siemens. Oops!

Slika — Moritz Hardt, UC Berkeley
Upravljanje pristranskosti umetne inteligence
Kaj lahko s tem naredimo? Problematiko lahko obravnamo z treh strani:
- Metodološka strogost pri zbiranju in upravljanju podatkov za usposabljanje sistema.
- Tehnična orodja za analizo in diagnostiko vedenja modela.
- Usposabljanje, izobraževanje in previdnost pri uvajanju strojnega učenja v izdelke.
V knjigi „Meščan v plemstvu“ Molièra je šala: enemu moškemu so povedali, da se literatura deli na prozo in poezijo, in on z navdušenjem ugotavlja, da je celo življenje govoril prozo, ne da bi to vedel. Verjetno se statistiki danes počutijo prav tako: ne da bi se tega zavedali, so svoje karriere posvetili umetni inteligenci in napaki pri izbiri vzorca. Iskanje napak pri izbiri vzorca in skrbi zaradi njih ni nov problem, preprosto moramo sistemsko pristopiti k njegovi rešitvi. Kot omenjeno zgoraj, je včasih res lažje to početi z raziskovanjem težav, povezanih s podatki o ljudeh. A priori predvidevamo, da imamo lahko pristranskosti glede različnih skupin ljudi, toda pristranskost glede senzorjev Siemens si težko sploh predstavljamo.
Novo v tem je seveda to, da ljudje več ne izvajajo statističnih analiz neposredno. Te izvajajo stroji, ki ustvarjajo velike kompleksne modele, ki jih je težko razumeti. Vprašanje preglednosti je eden glavnih vidikov problema pristranskosti. Bojimo se, da sistem ni le pristranski, ampak da ni nikakršne možnosti za odkrivanje njegove pristranskosti, in da se strojno učenje v tem razlikuje od drugih oblik avtomatizacije, ki domnevno temeljijo na jasnih logičnih korakih, ki jih je mogoče preveriti.
Tukaj sta dve težavi. Morda lahko vseeno izvedemo nekakšen pregled sistemov strojnega učenja. In pregled katerega koli drugega sistema v resnici ni nič lažji.
Prvič, eno od smeri sodobnih raziskav na področju strojnega učenja je iskanje metod za ugotavljanje pomembne funkcionalnosti sistemov strojnega učenja. Pri tem pa je strojno učenje (v svojem trenutnem stanju) povsem nova znanstvena disciplina, ki se hitro spreminja, zato ni smiselno misliti, da danes nemogoče stvari ne morejo kmalu postati povsem resnične. Projekt je zanimiv temu primer.
Drugič, ideja, da lahko preverjamo in razumemo proces odločanja v obstoječih sistemih ali organizacijah, je dobra v teoriji, v praksi pa ni tako preprosta. Razumeti, kako se odločajo v veliki organizaciji, ni enostavno. Tudi če obstaja formalni proces odločanja, ta ne odraža, kako ljudje dejansko komunicirajo, poleg tega pogosto nimajo logičnega sistemskega pristopa k sprejemanju svojih odločitev. Tako je dejal moj kolega , ljudje so tudi črne škatle.
Če vzamete tisoč ljudi v več prepletenih podjetjih in institucijah, postane problem še bolj zapleten. Po dejstvu vemo, da je bilo »Space Shuttle« usojeno razpadati ob vračanju, in posamezni ljudje znotraj NASA so imeli informacije, ki so jim dale razlog za domnevo, da se lahko zgodi kaj slabega, toda sistem na splošno tega ni vedel. NASA je ravno opravila podobno revizijo, ko je izgubila prejšnji shuttle, in kljub temu je še eno izgubila — iz zelo podobnega razloga. Enostavno je trditi, da organizacije in ljudje sledijo jasnim logičnim pravilom, ki jih je mogoče preveriti, razumeti in spremeniti — toda izkušnje dokazujo nasprotno. To je »».
Pogosto primerjam strojno učenje z bazami podatkov, zlasti relacijskimi — z novo temeljno tehnologijo, ki je spremenila možnosti informatike in svet okoli nje, ki je postala del vsega, kar stalno uporabljamo, ne da bi se tega zavedali. Tudi v podatkovnih bazah so težave, ki so podobne: sistem je lahko zgrajen na napačnih predpostavkah ali slabih podatkih, kar je težko opaziti, ljudje, ki uporabljajo sistem, pa bodo počeli, kar jim govori, ne da bi postavljali vprašanja. Obstaja kup starih šalo o davčnih uslužbencih, ki so nekoč narobe zapisali vaše ime, in prepričati jih, da popravijo napako, je veliko težje, kot pa dejansko spremeniti ime. O tem lahko razmišljamo na različne načine, ni pa jasno, kateri je boljši: kot tehnična težava v SQL-u, napaka v različici Oracle ali kot neuspeh birokratskih institucij? Kako težko je najti napako v procesu, ki je privedel do tega, da sistem nima funkcije, kot je popravilo tipkarskih napak? Ali je bilo mogoče to razumeti, preden so se ljudje začeli pritoževati?
To težavo še bolj ilustrirajo zgodbe, ko vozniki zavijejo v reke zaradi zastarelih podatkov v navigaciji. V redu, karte je treba neprestano posodabljati. A koliko je TomTom odgovoren za to, da vas odnese v morje?
To govorim zato, ker ja – pristranskost strojnega učenja bo povzročila težave. A te težave bodo podobne tistim, s katerimi smo se srečali v preteklosti, in jih bo mogoče opaziti in rešiti (ali pa ne) približno toliko, kot smo to znali v preteklosti. Zato je scenarij, v katerem bi pristranskost umetne inteligence povzročila škodo, malo verjeten z vodilnimi raziskovalci, ki delajo v veliki organizaciji. Verjetneje je, da bo nek nepomemben tehnološki izvajalec ali dobavitelj programske opreme napisal nekaj na hitro, z uporabo odprtokodnih komponent, knjižnic in orodij, ki jih ne razume. In malomarnemu kupcu bo stavek „umetna inteligenca“ v opisu izdelka zvenel mamljivo, ter brez dodatnih vprašanj dal svojim slabo plačanim delavcem, ki bodo kaznovani, če ne bodo počeli tega, kar jim pravi AI. To se je pravzaprav zgodilo s podatkovnimi bazami. To ni težava umetne inteligence in niti ne težava programske opreme. To je človeški dejavnik.
Zaključek
Strojno učenje lahko naredi vse, česar lahko naučite psa – toda nikoli ne morete biti prepričani, česa ste ga pravzaprav naučili.
Pogosto imam občutek, da izraz „umetna inteligenca“ le otežuje pogovore, kot je ta. Ta izraz ustvarja lažen vtis, da smo to inteligenco dejansko ustvarili. Da smo na poti do HAL9000 ali Skyneta — do nečesa, kar dejansko razume. Vendar ni tako. To so le stroji, ki jih je veliko pravilneje primerjati, recimo, s pralnim strojem. Ta se veliko bolje spoprime s pranjem kot človek, toda če vanj postavite posodo namesto perila, bo to… opralo. Posoda bo celo postala čista. a to ne bo tisto, kar ste pričakovali, in to se ne bo zgodilo, ker bi sistem imel kakšna vnaprejšnja prepričanja o posodi. Pralni stroj ne ve, kaj je posoda, in kaj obleka — to je le primer avtomatizacije, konceptualno ne drugačen od tiste, ki je bila uporabljena pri prejšnji avtomatizaciji procesov.
Ne glede na to, o čem gre — o strojih, letalih ali podatkovnih bazah — bodo ti sistemi hkrati zelo močni in zelo omejeni. Popolnoma bodo odvisni od tega, kako ljudje uporabljajo te sisteme, kakšne namene imajo ob tem in koliko razumejo njihovo delovanje.
Zato je povsem napačno govoriti, da „umetna inteligenca je matematika, zato ne more imeti predsodkov“. Toda prav tako je napačno trditi, da je strojno učenje „po svoji naravi subjektivno“. Strojno učenje najde vzorce v podatkih, kateri vzorci bodo najti, pa je odvisno od podatkov, ti podatki pa so odvisni od nas. Tako kot to, kar počnemo z njimi. Strojno učenje dejansko obvlada nekatere stvari veliko bolje od nas — vendar so psi, na primer, mnogo bolj učinkoviti pri odkrivanju drog kot ljudje, kar pa ni razlog, da bi jih vabili kot priče in izrekli sodbe na podlagi njihovih pričevanj. In psi, mimogrede, so veliko pametnejši od katerega koli sistema strojnega učenja.
Prevod: .
Uredništvo: .
Skupnost: .
Izvor: habr.com
