

Razvijalci OrioleDB so analizirali trenutno stanje nizkovrhnjega API-ja, ki se uporablja za dostop razširitev do tabel in indeksov v PostgreSQL (Table/Index Access Method (AM) API), in predlagali načine za njegovo izboljšanje. Od pojava takšnega API-ja v PostgreSQL 12 so razvijalci dobili možnost ustvarjanja alternativnih mehanizmov shranjevanja podatkov. Vendar pa kljub obstoju tega API-ja in znanim omejitvam vgrajenega mehanizma shranjevanja do sedaj niso nastali polnofunkcionalni transakcijski motorji shranjevanja, implementirani izključno kot razširitve.
Najbolj iskane funkcije za alternativne tabelarne motorje PostgreSQL so:
- Alternativne implementacije MVCC, na primer, shranjevanja na osnovi dnevnika UNDO.
- Indeksno organizirane tabele, kjer indeks ni neobvezen dodatek k tabeli, ki pospešuje poizvedbe, ampak predstavlja osnovno podatkovno strukturo, v kateri so shranjeni podatki tabele.
Spremembe, potrebne v API-ju Table/Index AM za podporo alternativnim implementacijam MVCC, se obravnavajo ob upoštevanju razširitve OrioleDB, razvite za odpravo znanih pomanjkljivosti vgrajenega mehanizma shranjevanja PostgreSQL. Težava je, da so za popolno integracijo OrioleDB s PostgreSQL potrebne spremembe v kodi PostgreSQL, kar otežuje izvedbo projekta in poudarja potrebo po modernizaciji trenutnega API-ja Table AM.
API Table AM ne narekuje neposredno načina izvedbe MVCC. Kljub temu API Table AM in API Index AM delita to domnevo: vsak TID (Tuple/row Identifier) je bodisi indeksiran z vsemi indeksi bodisi sploh ni indeksiran. Tudi če ima Index AM več referenc na en TID (na primer, GIN), morajo vse te reference ustrezati istemu indeksiranemu vrednosti.
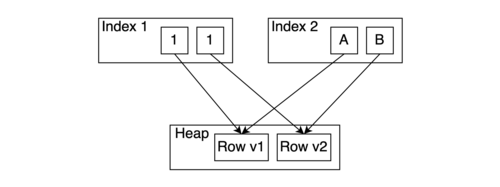
Ta princip je bil kritiziran zaradi povečanega števila operacij pisanja („write amplification“) — če se posodobi en indeksiran atribut, je potrebno posodobiti vsak indeks v tabeli. Za popolno izkoriščanje prednosti dnevnika UNDO ali za zgraditev drugega načina shranjevanja brez „povečevanja pisanja“ (na primer, metoda WARM) je treba to domnevo kršiti.
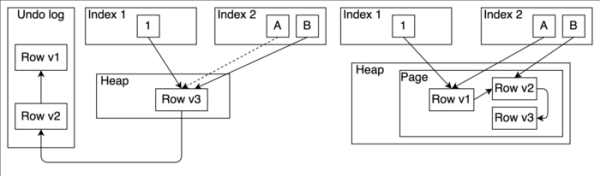
Tabela AM, zasnovana na UNDO, ki ne bo kršila te predpostavke, spominja na obstoječo metodo HOT (Heap-Only Tuples), s to razliko, da stare različice vrstic ostajajo v UNDO logu in ne smejo biti shranjene na isti strani. Vendar pa avtorji menijo, da ta prednost ni dovolj, da bi upravičila obstoj ločenega Table AM.
Praktične omejitve obstoječega API-ja:
- Med posodabljanjem vrstice tabele se indeksi posodabljajo po načelu 'vse ali nič'.
- Pomanjkanje v API-ju Index AM možnosti točkovnega brisanja določenih tupljev. Trenutno je mogoče brišeti tuplje iz indeksov masovno s pomočjo metod ambulkdelete in amvacuumcleanup. Poskus implementacije točkovnega brisanja prek tega API-ja bi privedel do nizke učinkovitosti, saj bi večina trenutnih implementacij morala skenirati celoten indeks. Poleg tega API ne omogoča določanja, kateri od tupljev, ki se nanašajo na isti TID, naj se izbrišejo. Lahko izbriše le vse.
- Indeksi se trenutno nanašajo na vrstice tabele po številu bloka (32 bitov) in številu odmika (16 bitov). In le 11 bitov številke odmika se lahko varno prenese iz TID tabele v vse metode dostopa do indeksov. Pri tem bi lahko alternativnim implementacijam MVCC bilo potrebno shraniti dodatno uporabno obremenitev (payload) skupaj s TID. Na primer, v OrioleDB je potrebnih en ali več bitov za implementacijo indeksov 'delete-marking' ali celotne informacije o vidnosti.
Predlagana sta dva načina za premagovanje omejitev v praksi:
Pristop 1: API Index AM zagotavlja možnosti za alternativno implementacijo MVCC.
Medtem ko Table AM še naprej odgovarja za vse komponente MVCC, Index AM zagotavlja potrebne možnosti za alternativno implementacijo MVCC, in sicer: shranjevanje uporabne obremenitve (payload) skupaj s TID, metoda točkovnega brisanja in celo metoda točkovnega posodabljanja (če TID v indeksu ne more biti spremenjen, se uporabna obremenitev – lahko). Poleg tega, ker je potrebno dovoliti večem tupljem v indeksu, da se nanašajo na isti TID, se morajo tudi metode API, uporabljene za skeniranje indeksa, posodobiti.
Pristop 2: Indeksi, ki podpirajo MVCC.
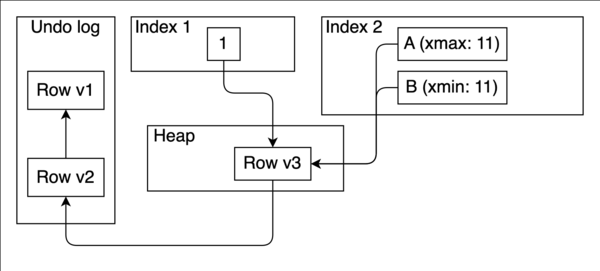
Alternativa bi bila omogućavanje indeksa koji podržavaju MVCC. To jest, „executor“ (ili možda Table AM) jednostavno poziva metode insert() i delete() u Index AM, dok Index AM pruža mogućnost skeniranja uzimajući u obzir MVCC. Ovo bi značajno pojednostavilo skeniranje koristeći samo indekse (index-only). Čak bi i sav Table AM u tom slučaju mogao postati posrednički sloj koji čuva podatke u indeksu.
Na dijagramu ispod prikazan je primer. Vrednost indeksa 2 ažurira transakcija 11 sa vrednosti „A“ na vrednost „B“. Stoga je vrednost „A“ označena kao xmax == 11, a vrednost „B“ označena kao xmin == 11. Na taj način se može skenirati indeks 2 i dobijati samo vidljivi tuple u skladu sa MVCC bez provere heap-a. Očistite indeks 2 takođe može biti obavljeno bez upotrebe heap-a.
Prilikom implementacije svih navedenih inovacija u API indeksnih metoda pristupa, malo je verovatno da će biti moguće istovremeno doraditi sve indekse za podršku svim novim mogućnostima. Realističnije je dozvoliti nekoliko implementacija za jednu indeksnu metodu pristupa. Na primer, pored uobičajenog B-treeda, proširenje bi moglo implementirati alternativni B-tree sa podrškom za MVCC unutar indeksa i podrškom za identifikatore zapisa proizvoljne dužine.
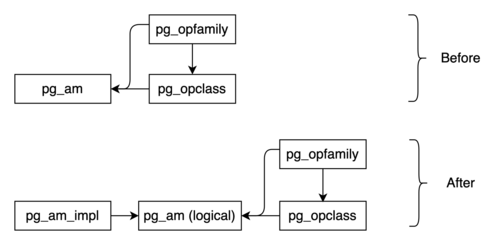
Stoga se predlaže preispitivanje ne samo API Table AM, već i API Index AM, koji je odavno služio zajednici PostgreSQL. Štaviše, predlaže se podela Index AM na logički sloj i sloj implementacije. Ova revidirana arhitektura će omogućiti PostgreSQL-u da podrži različite modele skladištenja.
Izvor: opennet.ru
