

Uspelo nam je!
„Cilj ovog kursa je da vas pripremi za vašu tehničku budućnost.”
 Pozdrav, Habr. Sećate se sjajnog članka (+219, 2588 u oznakama, 429k pregleda)?
Dakle, kod Haminga (da, da, samokontrolisani i samokorektivni ) postoji cela , napisana prema njegovim predavanjima. Prevodićemo je, jer je tip govorio o pravim stvarima.
Ova knjiga nije samo o IT-u, to je knjiga o načinu razmišljanja neverovatno sjajnih ljudi. „To nije samo naboj pozitivnog razmišljanja; u njoj su opisani uslovi koji povećavaju šanse za postizanje velikog dela.”
Zahvaljujemo Andreju Pakhomovu na prevodu.
Teoriju informacija razvio je C. E. Shannon krajem 1940-ih. Uprava Bell Laboratories-a je insistirala da je nazove „Teorija komunikacije”, jer je to mnogo precizniji naziv. Iz očiglednih razloga, naziv „Teorija informacija” ima daleko veći uticaj na javnost, pa je Shannon izabrao upravo njega, i upravo je on poznat do danas. Sam naziv sugeriše da se teorija bavi informacijom, što je čini važnom dok ulazimo dublje u informatičko doba. U ovom poglavlju ću se osvrnuti na nekoliko ključnih uvida iz ove teorije, izložiti intuitivno razumljiva objašnjenja nekih pojedinačnih postavki ove teorije, kako biste shvatili šta zapravo predstavlja „Teorija informacija”, gde je možete primeniti, a gde ne.
Pre svega, šta je „informacija”? Shannon identifikuje informaciju sa nesigurnošću. Odabrao je negativni logaritam verovatnoće događaja kao meru količine informacija koju dobijate kada se dogodi događaj sa verovatnoćom p. Na primer, ako vam kažem da u Los Anđelesu ima maglovito vreme, tada je p blizu 1, što nam u suštini ne daje mnogo informacija. Ali ako kažem da u junu u Monteriju pada kiša, tada će ova informacija sadržavati nesigurnost i više informacija. Događaj sa potpunom sigurnošću ne sadrži informacije, pošto je log 1 = 0.
Poglejmo to bolj podrobno. Shannon je menil, da bi morala biti količinska mera informacije neprekinjena funkcija verjetnosti dogodka p, in da mora biti za neodvisne dogodke aditivna – količina informacije, pridobljena z uresničitvijo dveh neodvisnih dogodkov, mora biti enaka količini informacije, pridobljeni z realizacijo skupnega dogodka. Na primer, izid metanja kocke in kovanca običajno obravnavamo kot neodvisne dogodke. Prevedimo zgoraj omenjeno v matematični jezik. Če je I (p) količina informacije, ki jo vsebuje dogodek s verjetnostjo p, potem za skupni dogodek, sestavljen iz dveh neodvisnih dogodkov x s verjetnostjo p1 in y s verjetnostjo p2 dobimo
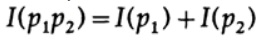
(x in y sta neodvisna dogodka)
To je funkcionalna enačba Cauchy, resnična za vse p1 in p2. Za rešitev te funkcionalne enačbe predpostavimo, da
p1 = p2 = p,
to daje
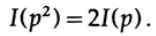
Če je p1 = p2 in p2 = p, potem
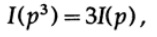
itd. S širjenjem tega postopka, z uporabo standardne metode za eksponente, velja za vse racionalne števce m/n naslednje
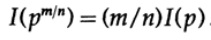
Iz predvidevanja neprekinjenosti informacijske mere sledi, da je logaritmična funkcija edina neprekinjena rešitev funkcionalne enačbe Cauchy.
V teoriji informacij je običajno sprejeti, da je osnova logaritma enaka 2, zato binarna izbira vsebuje natanko 1 bit informacije. Zato se informacija meri po formuli
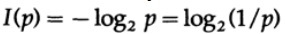
Ustavimo se in razjasnimo, kaj se je zgodilo zgoraj. Najprej nismo podali definicije pojma 'informacija', le opredelili smo formulo za njeno količinsko mero.
Drugič, ta mera je odvisna od negotovosti in, čeprav je dovolj primerna za naprave – na primer, telefonske sisteme, radio, televizijo, računalnike itd. – ne odraža običajnega človeškega odnosa do informacij.
Tretjič, to je relativna mera, ki je odvisna od trenutnega stanja vašega znanja. Če gledate na tok 'naključnih števil' iz generatorja naključnih števil, predpostavljate, da je vsako naslednje število negotovo, a če poznate formulo za izračun 'naključnih števil', bo naslednje število znano in zato ne bo vsebovalo informacije.
Tako je definicija, ki jo je Shannon dal za informacijo, v mnogih primerih primerna za stroje, a se zdi, da ne ustreza človeškemu razumevanju te besede. Iz tega razloga bi bilo treba 'Teorijo informacij' imenovati 'Teorija povezovanja'. Vendar je zdaj prepozno, da bi spreminjali definicije (zaradi katerih je teorija pridobila svojo prvotno priljubljenost in ki še vedno prepričujejo ljudi, da ta teorija obravnava 'informacijo'), zato se moramo s tem sprijazniti, vendar morate jasno razumeti, kako daleč je definicija informacije, ki jo je dal Shannon, od njenega splošno razumljenega pomena. Shannonova informacija se ukvarja s povsem drugim, in sicer z negotovostjo.
To je tisto, o čemer bi morali razmisliti, ko predlagate kakršnokoli terminologijo. Kako se predlagana definicija, na primer definicija informacije, ki jo je dal Shannon, ujema z vašo prvotno idejo in kako se razlikuje? Komajda obstaja izraz, ki bi natančno odražal vašo prejšnjo vizijo koncepta, vendar na koncu terminologija, ki jo uporabljamo, odraža pomen koncepta, zato formalizacija nečesa s jasnimi definicijami vedno prinaša določen šum.
Razmislimo o sistemu, katerega abeceda je sestavljena iz simbolov q s verjetnostmi pi. V tem primeru povprečno število informacij v sistemu (njegova pričakovana vrednost) je:
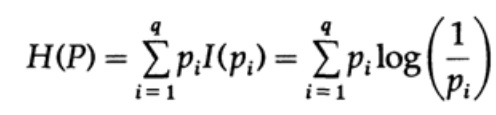
To se imenuje entropija sistema z verjetnostnim porazdeljenjem {pi}. Uporabljamo izraz 'entropija', ker ista matematična oblika nastane tudi v termodinamiki in statistični mehaniki. Zato izraz 'entropija' ustvarja okoli sebe določeno avro pomembnosti, ki na koncu ni upravičena. Enaka matematična oblika zapisa ne pomeni enake interpretacije simbolov!
Entropija verjetnostnega porazdeljenja igra ključno vlogo v teoriji kodiranja. Gibbsova neenačba za dve različni verjetnostni porazdelitvi pi in qi je ena od pomembnih posledic te teorije. Tako moramo dokazati, da
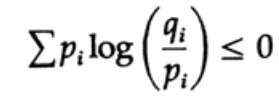
Dokaz temelji na očitnem grafu, slika 13.I, ki prikazuje, da
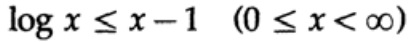
je enakost dosežena le pri x = 1. Uporabimo neenačbo za vsak člen vsote iz leve strani:
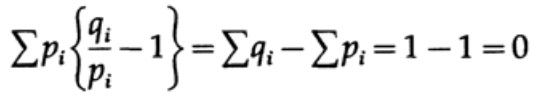
Če je abeceda komunikacijskega sistema sestavljena iz q simbolov, ob upoštevanju verjetnosti prenosa vsakega simbola qi = 1/q in vstavitvi q, dobimo iz Gibbsove neenakosti.
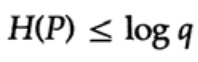
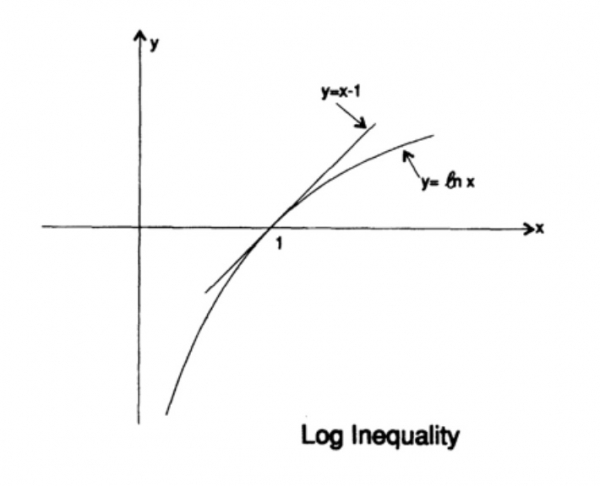
Risba 13.I
To pomeni, da če je verjetnost prenosa vseh q simbolov enaka in je 1/q, je največja entropija enaka ln q; v nasprotnem primeru velja neenakost.
V primeru nedvoumno dekodirajočega kodeksa imamo Kraftovo neenakost.
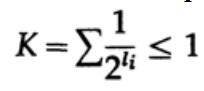
Zdaj, če opredelimo pseudo-verjetnosti,
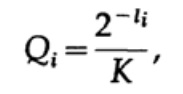
kjer je seveda, 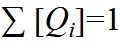 = 1, kar sledi iz Gibbsove neenakosti,
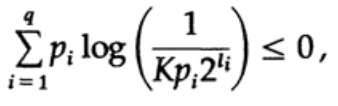
in malo algebre (spomnite se, da je K ≤ 1, zato lahko opustimo logaritem, in morda kasneje ojačimo neenakost), dobimo
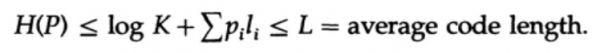
kjer je L povprečna dolžina kode.
Tako je entropija minimalna meja za katerikoli simbolni kodeks s povprečno dolžino kodne besede L. To je Shannonova teorema za brezšumni kanal.
Zdaj obravnavamo glavno teoremo o omejitvah komunikacijskih sistemov, kjer se informacije prenašajo v obliki toka neodvisnih bitov in prisotna je šum. Predpostavlja se, da je verjetnost pravilnega prenosa enega bita P > 1/2, verjetnost, da se bo vrednost bita ob prenosu obrnila (nastala bo napaka), pa je Q = 1 - P. Za enostavnost, domnevamo, da so napake neodvisne in da je verjetnost napake enaka za vsak poslan bit — torej je v komunikacijskem kanalu prisoten 'bel šum'.
Imamo dolg tok n bitov, zakodiranih v eno sporočilo — n-dimenzionalno širitev enobitnega kodeksa. Vrednost n bomo določili pozneje. Obravnavamo sporočilo, sestavljeno iz n bitov, kot točko v n-dimenzionalnem prostoru. Ker imamo n-dimenzionalni prostor — in za enostavnost domnevamo, da ima vsako sporočilo enako verjetnost nastanka — obstaja M možnih sporočil (M bo prav tako določeno pozneje), posledično je verjetnost katerega koli poslanega sporočila enaka

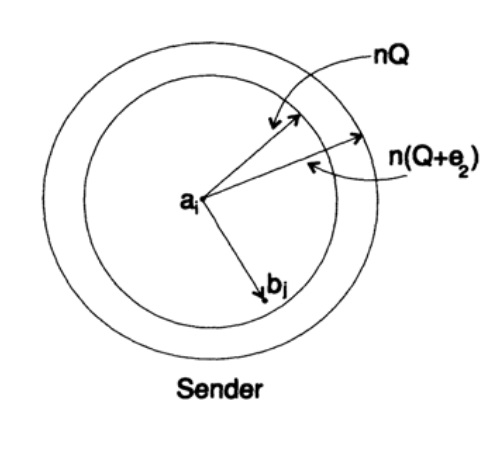
(pošiljatelj)
Graf 13.II
Vamos a considerar la idea del ancho de banda del canal. Sin entrar en detalles, el ancho de banda del canal se define como el máximo volumen de información que puede transmitirse de manera confiable a través de un canal de comunicación, teniendo en cuenta el uso de codificación máxima eficiente. No hay argumentos que apoyen que se pueda transmitir más información a través de un canal de comunicación que su capacidad. Esto se puede demostrar para un canal simétrico binario (que es el que utilizamos en nuestro caso). La capacidad del canal, en la transmisión bit a bit, se define como
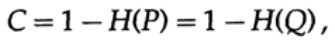
donde, como antes, P es la probabilidad de que no haya error en cualquier bit enviado. Al enviar n bits independientes, la capacidad del canal se define como
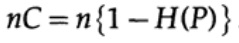
Si estamos cerca del ancho de banda del canal, debemos enviar casi el mismo volumen de información para cada uno de los símbolos ai, i = 1, …, M. Teniendo en cuenta que la probabilidad de aparición de cada símbolo ai es 1 / M, obtenemos
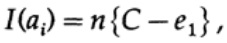
cuando enviamos cualquiera de los M mensajes equiprobables ai, tenemos
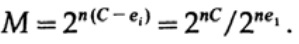
Al enviar n bits, esperamos que ocurran nQ errores. En la práctica, para un mensaje compuesto de n bits, tendremos aproximadamente nQ errores en el mensaje recibido. Con grandes n, la variación relativa (variación = ancho de la distribución,)
de la cantidad de errores será cada vez más estrecha a medida que n crezca.
Así que, desde el lado del transmisor, tomo el mensaje ai para enviarlo y dibujo una esfera alrededor de él con un radio
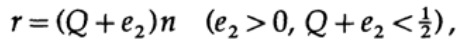
que es un poco más grande en una cantidad igual a e2 que el número esperado de errores Q, (figura 13.II). Si n es lo suficientemente grande, hay tan pequeña probabilidad de que el punto del mensaje bj en el lado del receptor esté fuera de esta esfera. Ilustremos la situación, como la veo desde el punto de vista del transmisor: tenemos cualquier radio desde el mensaje transmitido ai al mensaje recibido bj con una probabilidad de error igual (o casi igual) a una distribución normal, alcanzando un máximo en nQ. Para cualquier e2 dado, hay un n tan grande que la probabilidad de que el punto recibido bj, que está fuera de mi esfera, sea tan pequeña como desees.
Zdaj se bomo osredotočili na to situacijo z vaše strani (sl. 13.III). Na strani prejemnika obstaja krog S(r) istega radija r okoli sprejete točke bj v n-dimenzionalnem prostoru, kar pomeni, da če je sprejeta sporočilo bj znotraj moje sfere, se takrat poslano sporočilo ai nahaja znotraj vaše sfere.
Kako lahko pride do napake? Napaka se lahko zgodi v primerih, opisanih v spodnji tabeli:
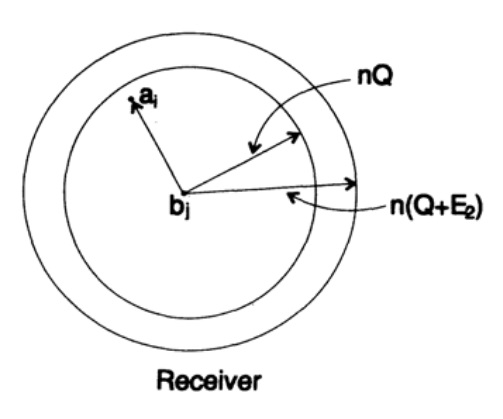
Slika 13.III
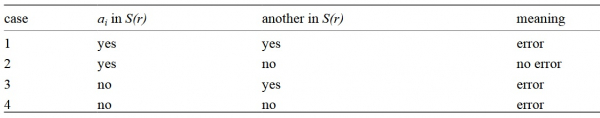
Tukaj vidimo, da, če obstaja v sferi, zgrajeni okoli sprejete točke, še vsaj ena točka, ki ustreza morebitnemu poslano nezakodiranemu sporočilu, je pri prenosu prišlo do napake, saj ne morete določiti, katero od teh sporočil je bilo poslano. Poslano sporočilo ne vsebuje napake le, če se točka, ki ji ustreza, nahaja v sferi in ne obstajajo druge točke, možne v tem kodu, ki se nahajajo v isti sferi.
Imamo matematično enačbo za verjetnost napake Re, če je bilo poslano sporočilo ai.
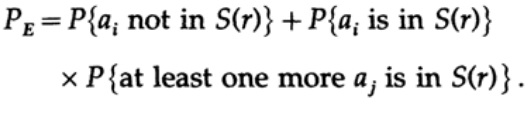
Lahko zavrnemo prvi faktor v drugem členu in ga obravnavamo kot 1. Tako dobimo neenakost.
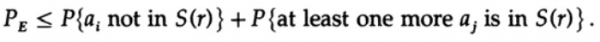
Očitno je, da
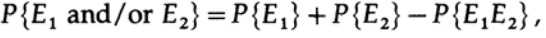
torej
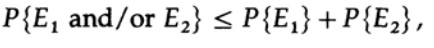
ponovno uporabimo za zadnji člen z desne
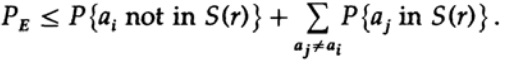
Sprejmejoč n dovolj veliko, se prvi člen lahko obravnava kot poljubno majhen, recimo manjši od nekega števila d. Tako imamo
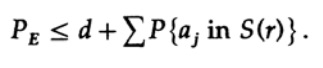
Zdaj razmislimo, kako lahko zgradimo kodo preproste zamenjave za kodiranje M sporočil, sestavljenih iz n bitov. Brez predstave o tem, kako zgraditi kodo (kode s popravkom napak še niso bile izumljene), je Shannon izbral naključno kodiranje. Vrzi kovanec za vsak od n bitov v sporočilu in postopek ponovite za M sporočil. Skupaj je treba narediti nM metov kovanca, zato so možni

kodni slovarji, ki imajo enako verjetnost ½nM. Seveda naključni postopek ustvarjanja kodnega slovarja pomeni, da obstaja možnost pojava podvojitev, pa tudi kodnih točk, ki bodo blizu druga drugi in tako predstavljajo vir morebitnih napak. Treba je dokazati, da če se to ne zgodi z verjetnostjo, ki je višja od katerega koli majhnega izbranega nivoja napake, je dano n dovolj veliko.
Ključni trenutak je u tome što je Shannon prosečio sve moguće kodne knjige kako bi pronašao prosečnu grešku! Koristimo simbol Av [.] da označimo prosečnu vrednost između svih mogućih slučajnih kodnih rečnika. Prosečenje po konstantnoj d, naravno, daje konstantu, jer se pri prosečenju svaki član poklapa s bilo kojim drugim članom u sumi,
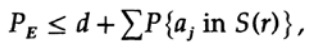
koji se može povećati (M–1 prelazi u M)
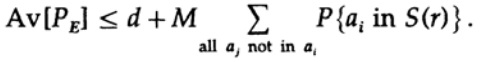
Za svaku konkretnu poruku, prilikom prosečenja svih kodnih knjiga, kodiranje prolazi kroz sve moguće vrednosti, tako da je prosečna verovatnoća da se tačka nalazi u sferi odnos zapremine sfere prema ukupnoj zapremini prostora. Zapremina sfere pri tome
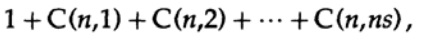
gde je s=Q+e2 <1/2 i ns mora biti ceo broj.
Zadnji član s desne strane je najveći u ovoj sumi. Prvo, procenićemo njegovu vrednost prema Stirlingovoj formuli za faktorijele. Zatim ćemo pogledati koeficijent smanjenja prethodnog člana, primetite da se ovaj koeficijent povećava kako se kreće levo, i stoga možemo: (1) ograničiti vrednost sume sumom Geometrijske progresije sa tim početnim koeficijentom, (2) proširiti Geometrijsku progresiju na ns članova do beskonačnog broja članova, (3) izračunati sumu beskonačne geometrijske progresije (standardna algebra, ništa suštinsko) i konačno dobiti granicu (za dovoljno veliko n):
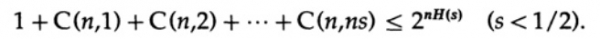
Obratite pažnju na to kako se entropija H(s) pojavila u binomnom identitetu. Primetite da Taylorov red H(s)=H(Q+e2) daje procenu koja je dobijena uzimajući u obzir samo prvu derivativu i ignorišući sve ostale. Sada ćemo formirati konačni izraz:
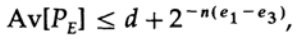
kjer
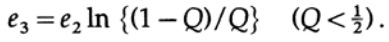
Sve što treba da uradimo je da izaberemo e2, tako da e3 < e1, i tada će poslednji član biti koliko god mali, pri dovoljno velikom n. Stoga, prosečna greška PE može biti koliko god mala pri propusnosti kanala koliko god blizu C.
Če je povprečna vrednost vseh kod dovolj majhna napaka, mora biti vsaj ena koda primerna, kar pomeni, da obstaja vsaj en primeren kodirni sistem. To je pomemben rezultat, ki ga je dosegel Shannon — "Shannonova teorema za kanale z motnjami", čeprav je treba opozoriti, da je to dokazal za veliko bolj splošen primer kot za preprost бинарный симметричен kanal, ki sem ga uporabil. Za splošni primer so matematični izračuni veliko bolj zapleteni, vendar ideje niso tako različne, zato pogosto lahko na primeru posebnega primera razkrijemo pravi pomen teoreme.
Poglejmo rezultate kritično. Večkrat smo ponovili: "Pri dovolj velikem n". Ampak kako veliko mora biti n? Zelo, zelo veliko, če resnično želite biti hkrati blizu kapacitete kanala in biti prepričani v pravilno prenos podatkov! Tako veliko, da boste dejansko morali dolgo čakati, da naberete sporočilo iz tako velikega števila bitov, da ga boste lahko kasneje kodirali. Pri tem bo velikost slovarja naključne kode preprosto ogromna (saj takega slovarja ni mogoče predstaviti v krajši obliki kot celoten seznam vseh Mn bitov, ob tem da sta n in M zelo velika)!
Kode za popravilo napak se izognejo čakanju na zelo dolgo sporočilo, z njegovim kasnejšim kodiranjem in dekodiranjem preko zelo velikih kodnih knjig, ker se izognejo kodnim knjigam kot takim in namesto tega uporabljajo navadne izračune. V preprosti teoriji takšne kode običajno izgubijo sposobnost približati se kapaciteti kanala in ob tem ohraniti dovolj nizko stopnjo napak, vendar, ko koda popravi veliko napak, prikažejo dobre rezultate. Drugimi besedami, če v kanal vgradite določeno kapaciteto za popravilo napak, morate to zmožnost popravila napak uporabljati večino časa, tj. v vsakem poslanem sporočilu bi moralo biti popravljeno veliko število napak, sicer to kapaciteto zapravljate.
Vendar pa zgoraj dokazana teorema vseeno ni brez pomena! Pokaže, da morajo učinkoviti sistemi prenosa uporabljati premišljene sheme kodiranja zelo dolgih bitnih nizov. Primer so sateliti, ki so odpotovali onkraj zunanjih planetov; ko se oddaljujejo od Zemlje in Sonca, morajo odpravljati vedno večje število napak v podatkovnem bloku: nekateri sateliti uporabljajo sončne celice, ki proizvajajo okoli 5 W, drugi pa atomžne vire napajanja, ki dajejo približno enako moč. Šibka moč vira napajanja, majhnost oddajnih anten in omejene velikosti sprejemnih anten na Zemlji, ogromna razdalja, ki jo mora prekiniti signal — vse to zahteva uporabo kod z visokim nivojem korekcije napak za izgradnjo učinkovitega komunikacijskega sistema.
Vrnimo se k n-dimenzionalnemu prostoru, ki smo ga uporabili v zgorajšnjem dokazu. Med razpravo o tem smo pokazali, da je skoraj ves volumen sfere skoncentriran okoli zunanje površine — tako da bo skoraj zagotovo poslan signal ležal na površini sfere, zgrajene okoli sprejetega signala, tudi pri relativno majhnem radiju te sfere. Zato ni presenetljivo, da je sprejeti signal po popravilu poljubno velikega števila napak, nQ, lahko poljubno blizu signalu brez napak. Kapaciteta komunikacijskega kanala, ki smo jo obravnavali prej, je ključ do razumevanja tega pojava. Upoštevajte, da se take sfere, zgrajene za Hammingove kode s korekcijo napak, med seboj ne prekrivajo. Veliko število praktično ortogonalnih meritev v n-dimenzionalnem prostoru prikazuje, zakaj lahko v prostoru namestimo M sfer z majhnim prekrivanjem. Če predpostavimo majhen, poljubno majhen prekrival, ki lahko povzroči le malo napak pri dekodiranju, lahko dosežemo gosto postavitev sfer v prostoru. Hamming je zagotovil določeno stopnjo korekcije napak, Shannon pa nizko verjetnost napake, pri čemer pa ohranja dejansko propustnost poljubno blizu kapaciteti komunikacijskega kanala, česar Hammingove kode ne morejo doseči.
Teorija informacij ne govori o tem, kako zasnovati učinkoviti sistem, vendar usmerja k učinkovitim komunikacijskim sistemom. To je dragoceno orodje za gradnjo komunikacijskih sistemov med stroji, vendar, kot je bilo omenjeno prej, nima posebne zveze s tem, kako ljudje izmenjujejo informacije med seboj. Stopnja, v kateri je biološka dediščina podobna tehničnim komunikacijskim sistemom, preprosto ni znana, zato trenutno ni jasno, kako uporabna je teorija informacij za gene. Edina možnost, ki nam ostane, je, da preizkusimo, in če bo uspeh pokazal strojno podobno naravo tega pojava, bo neuspeh kazal na druge pomembne vidike narave informacij.
Vamos se malo odmakniti. Videli smo, da vse začetne definicije v večji ali manjšini meri morajo izražati bistvo naših osnovnih prepričanj, toda te so nagnjene k določenemu izkrivljanju in zato se izkažejo za neuporabne. Tradicionalno je sprejeto, da pravzaprav definicija, ki jo uporabljamo, določa bistvo; toda to nam le pokaže, kako obravnavati stvari in nikakor ne prinaša nobenega pomena. Postulativni pristop, ki ga zelo odobravajo v matematičnih krogih, na praksi pušča veliko želja.
Sedaj bomo obravnavali primer IQ testov, kjer je definicija lahko tako ciklična, kot si želite, kar vas posledično zavaja. Ustvari se test, ki naj bi meril inteligenco. Nato se pregleda, da bi bil čim bolj dosleden, preden ga objavijo in s preprosto metodo kalibrirajo, da je "inteligenca", ki jo merimo, normalno porazdeljena (seveda po kalibracijski krivulji). Vse definicije je treba ponovno preveriti, ne le ob prvem predlaganju, temveč tudi veliko kasneje, ko se uporabljajo v sklenjenih zaključkih. Do katere mere so meje definicij primerne za rešeno nalogo? Kako pogosto se definicije, dane v enakih pogojih, začnejo uporabljati v precej različnih pogojih? To se dogaja precej pogosto! V družboslovju, s katerim se neizogibno srečate v svojem življenju, se to dogaja pogosteje.
Tako je eden od ciljev te predstavitve teorije informacij, poleg prikazovanja njene uporabnosti, tudi opozarjanje vas na to nevarnost ali prikazovanje, kako jo uporabiti za dosego želenega rezultata. Že dolgo je opazno, da prvotne definicije v mnogo večji meri vplivajo na to, kar na koncu najdete, kot se zdi. Prvotne definicije od vas zahtevajo veliko pozornosti ne le v vsaki novi situaciji, temveč tudi na področjih, s katerimi delate že dolgo. To vam bo omogočilo, da razumete, v kolikšni meri so pridobljeni rezultati tautologija, namesto da bi bili kaj uporabnega.
Znana zgodba o Eddingtonu pripoveduje o ljudeh, ki so lovili ribe v morju s mrežo. Potem ko so preučili velikost rib, ki so jih ujeli, so določili minimalno velikost ribe, ki živi v morju! Njihov zaključek je bil posledica uporabljenega orodja, ne pa resničnosti.
Nastaviće se…
Kdor želi pomagati s prevodom, postavitvijo in izdajo knjige – pišite v zasebna sporočila ali na e-pošto magisterludi2016@yandex.ru
Mimogrede, še vedno smo začeli prevod še ene odlične knjige — )
Še posebej iščemo tiste, ki bodo pomagali prevesti . (prevajamo po 10 minut, prvih 20 je že vzeto)
Vsebina knjige in prevedeni poglavji
- Intro to The Art of Doing Science and Engineering: Learning to Learn (28. marec 1995)
- «Foundations of the Digital (Discrete) Revolution» (30. marec 1995)
- «History of Computers — Hardware» (31. marec 1995)
- «History of Computers — Software» (4. april 1995)
- «History of Computers — Applications» (6. april 1995)
- «Artificial Intelligence — Part I» (7. april 1995)
- «Artificial Intelligence — Part II» (11. april 1995)
- «Artificial Intelligence III» (13. april 1995)
- «n-Dimensional Space» (14. april 1995)
- «Coding Theory — The Representation of Information, Part I» (18. april 1995)
- «Coding Theory — The Representation of Information, Part II» (20. april 1995)
- «Error-Correcting Codes» (21. april 1995)
- «Information Theory» (25. april 1995)
- «Digital Filters, Part I» (27. april 1995)
- «Digital Filters, Part II» (April 28, 1995)
- «Digital Filters, Part III» (May 2, 1995)
- «Digital Filters, Part IV» (May 4, 1995)
- «Simulation, Part I» (May 5, 1995)
- «Simulation, Part II» (May 9, 1995)
- «Simulation, Part III» (May 11, 1995)
- «Fiber Optics» (May 12, 1995)
- «Computer Aided Instruction» (May 16, 1995)
- «Mathematics» (May 18, 1995)
- «Quantum Mechanics» (May 19, 1995)
- «Creativity» (May 23, 1995). Превод:
- «Experts» (May 25, 1995)
- «Unreliable Data» (May 26, 1995)
- «Systems Engineering» (May 30, 1995)
- «You Get What You Measure» (June 1, 1995)
- (June 2, 1995) преводимо по 10 минутних делова
- Hamming, «You and Your Research» (June 6, 1995).
Kdor želi pomagati s prevodom, postavitvijo in izdajo knjige – pišite v zasebna sporočila ali na e-pošto magisterludi2016@yandex.ru
Izvor: habr.com
