

V tem članku bomo govorili o funkcionalnih odvisnostih v podatkovnih bazah — kaj so, kje se uporabljajo in kateri algoritmi obstajajo za njihovo iskanje.
Funkcionalne odvisnosti bomo obravnavali v kontekstu relacijskih podatkovnih baz. Poenostavljeno povedano, v takih podatkovnih bazah so informacije shranjene v tabelah. Nadalje bomo uporabili približne pojme, ki v strogi relacijski teoriji niso zamenljivi: samo tabelo bomo imenovali odnos, stolpce — atribute (njihovo množico — shemo odnosa), in množico vrednosti vrstice na podmnožju atributov — tuplen.
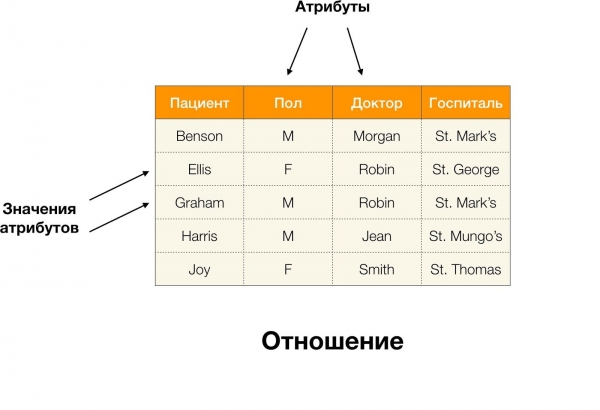
Na primer, v zgornji tabeli, (Benson, M, M organ) je tuplen po atributih (Pacient, Spol, Zdravnik).
Bolj formalno je to zapisano na naslednji način:  [Pacient, Spol, Zdravnik] = (Benson, M, M organ).
Zdaj lahko uvedemo pojem funkcionalne odvisnosti (FO):
Definicija 1. Odnosi R izpolnjujejo FO X → Y (kjer X, Y ⊆ R) takrat in samo takrat, ko za vsak tuplen  ,
 ∈ R velja: če
 [X] =
 [X], potem
 [Y ] =
 [Y ]. V tem primeru pravimo, da X (determinanta, ali določujoča množica atributov) funkcionalno določa Y (odvisna množica).
Drugimi besedami, prisotnost FO X → Y pomeni, da če imamo dva tuplena v R in se ujemata po atributih X, potem se bosta ujemala tudi po atributih Y.
Zdaj po vrsti. Oglejmo si atribute Pacient in Spol za katere želimo izvedeti, ali obstajajo med njimi odvisnosti ali ne. Za to množico atributov lahko obstajajo naslednje odvisnosti:
- Pacient → Spol
- Spol → Pacient
Po definiciji zgoraj, da bi se prva odvisnost ohranila, mora vsakemu edinstvenemu vrednosti stolpca Pacient ustrezati samo ena vrednost stolpca Spol. In za tabelo - primer to res velja. Vendar pa v obratni smeri to ne deluje, torej druga odvisnost ne velja, atribut Spol ni determinanta za Pacienta. Podobno, če vzamemo odvisnost Zdravnik → Pacient, lahko opazimo, da je ta kršena, saj vrednost Robin za ta atribut ima več različne vrednosti — Ellis in Graham.
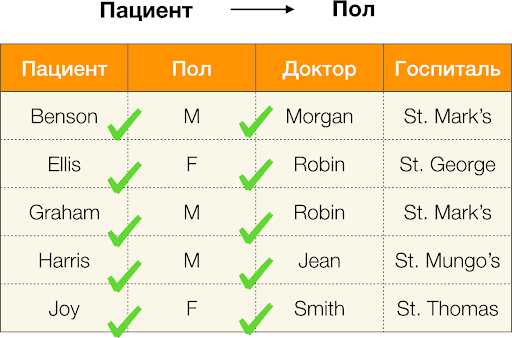
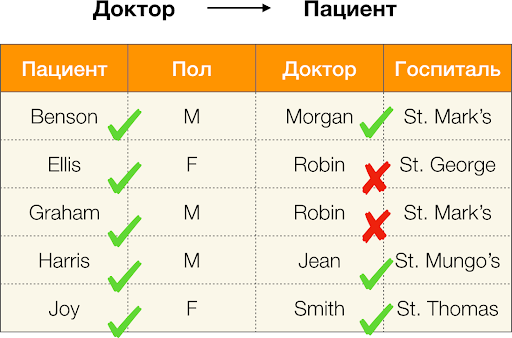
Tako, funkcionalne zavisnosti omogočajo opredelitev obstoječih povezav med množicami atributov tabele. Od tod naprej bomo preučevali najbolj zanimive povezave, natančneje take X → Y, ki so:
- netrivijalne, torej desna stran odvisnosti ni podmnožica leve (Y ̸⊆ X);
- minimalne, torej ne obstaja taka odvisnost Z → Y, da Z ⊂ X.
Zdaj so bile doslej obravnavane odvisnosti stroge, torej niso dovoljevale nobenih kršitev v tabeli, vendar pa obstajajo tudi takšne odvisnosti, ki dovoljujejo določeno neskladnost med vrednostmi tupljev. Takšne odvisnosti se premaknejo v poseben razred, imenujejo se približne in jim omogočijo kršitve na določenem številu tupljev. To število ureja kazalnik največje napake emax. Na primer, delež napake  = 0.01 pomeni, da se lahko odvisnost krši za 1 % obstoječih tupljev v obravnavani množici atributov. To pomeni, da lahko za 1000 zapisov največ 10 tupljev krši funkcionalne odvisnosti. Obrazi bomo obravnavali nekoliko drugačno metriko, ki temelji na parno različni vrednosti primerjanih tupljev. Za odvisnost X → Y na relaciji r se šteje tako:

Izračunajmo napako za Zdravnik → Pacient iz zgornjega primera. Imamo dva tuplja, katerih vrednosti se razlikujejo po atributu Pacient, vendar se ujemajo na Doktorju:  [Doktor, Pacient] = (Robin, Ellis) i
 [Doktor, Pacient] = (Robin, Graham). Po definiciji napake moramo upoštevati vse konfliktne pare, kar pomeni, da bosta takšna dva: (
 ,
 ) in njena inverzija (
 ,
 ). Vstavimo v formulo in dobimo:

Zdaj pa poskusimo odgovoriti na vprašanje: „Kam s tem?“. V resnici obstajajo različne vrste funkcionalnih odvisnosti. Prvi tip so take odvisnosti, ki jih določi skrbnik med načrtovanjem baze podatkov. Običajno jih je malo, so stroge, njihova glavna uporaba pa je normalizacija podatkov in oblikovanje sheme relacije.
Drugi tip — odvisnosti, ki predstavljajo "skrite" podatke in prej nepoznane povezave med atributi. To pomeni, da o takšnih odvisnostih niso razmišljali v času načrtovanja, ampak jih odkrijejo za obstoječi nabor podatkov, da bi na podlagi številnih ugotovljenih funkcionalnih odvisnosti oblikovali kakršne koli sklepe o shranjenih informacijah. Ravno s takšnimi odvisnostmi se ukvarjamo. S tem se ukvarja cela panoga podatkovnega rudarjenja z različnimi tehnikami iskanja in algoritmi, zgrajenimi na njihovi podlagi. Poglejmo, kako so lahko izsledne funkcionalne odvisnosti (natančne ali približne) koristne v nekaterih podatkih.
Danes med glavne področja uporabe odvisnosti spada čiščenje podatkov. To vključuje razvoj procesov za odkrivanje "umazanih podatkov" z njihovim kasnejšim popravljanjem. Izraziti predstavniki "umazanih podatkov" so podvojitve, napake v podatkih ali tipkarske napake, manjkajoče vrednosti, zastareli podatki, odvečni presledki in podobno.
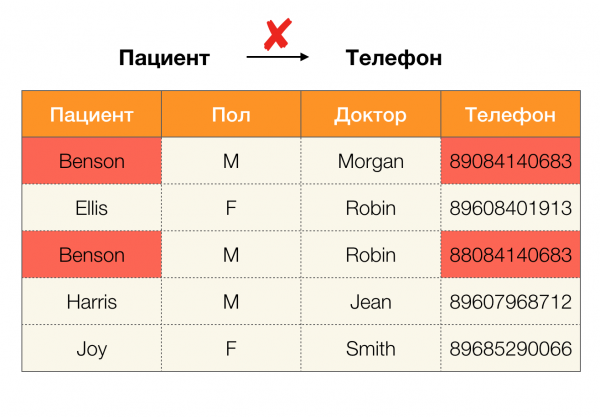
Primer napake v podatkih:
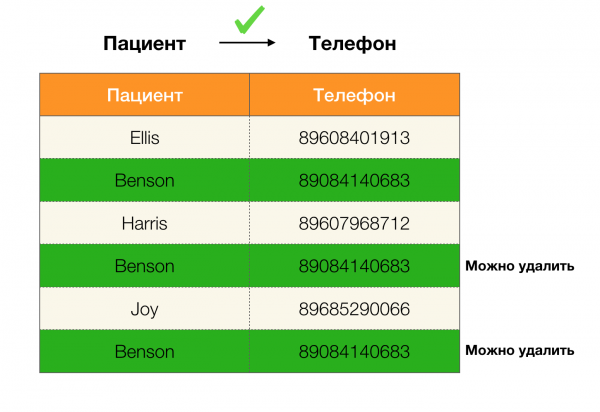
Primer podvojitev v podatkih:
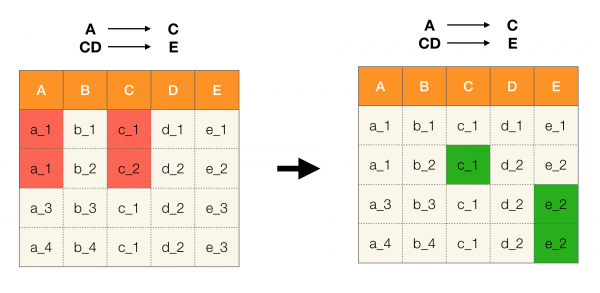
Na primer, imamo tabelo in nabor funkcionalnih odvisnosti, ki jih je treba spoštovati. Čiščenje podatkov v tem primeru pomeni, da se podatki spremenijo tako, da postanejo funkcionalne odvisnosti pravilne. Pri tem je število sprememb minimalno (za to odpravo obstajajo posebni algoritmi, na katere se v tem članku ne bomo osredotočali). Spodaj je prikazan primer takega preoblikovanja podatkov. Levo je izvorna tabela, v kateri očitno ne veljajo potrebne funkcionalne odvisnosti (rdeča barva označuje primer kršitve ene od teh odvisnosti). Desno je posodobljena tabela, kjer zelene celice prikazujejo spremenjene vrednosti. Po izvajanju tega postopka so potrebne odvisnosti začele veljati.
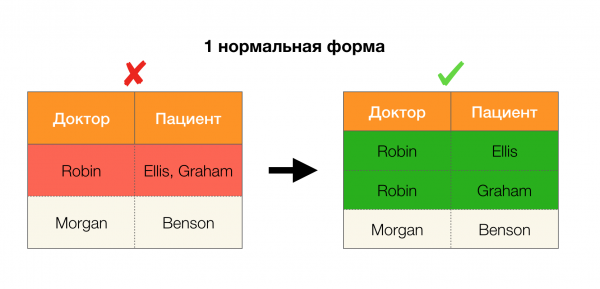
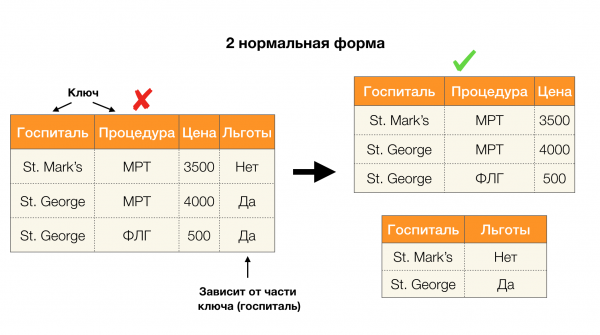
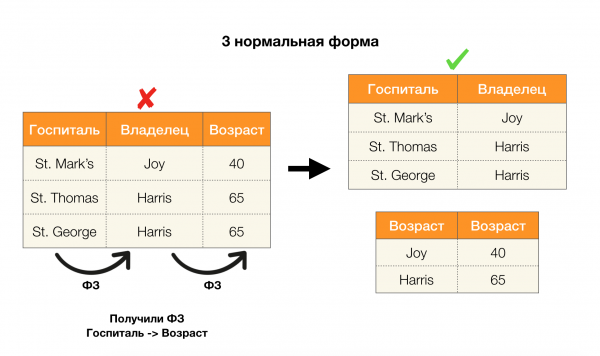
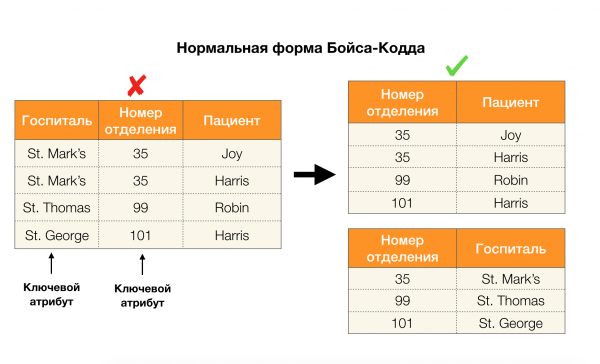
Druga popularna področja uporabe je oblikovanje podatkovnih baz. Tu velja omeniti normalne oblike in normalizacijo. Normalizacija je proces prilagajanja relacije določenemu naboru zahtev, ki jih vsaka normalna oblika definira na svoj način. Ne bomo se podrobno ukvarjali z zahtevami različnih normalnih oblik (to se obravnava v katerikoli knjigi o uvodu v podatkovne baze), ampak bomo le opazili, da vsaka od njih po svoje uporablja koncept funkcionalnih odvisnosti. Te odvisnosti so v svoji bistvu omejitve celovitosti, ki jih je treba upoštevati pri načrtovanju podatkovne baze (v kontekstu te naloge se funkcionalnim odvisnostim včasih reče superključi).
Oglejmo si njihovo uporabo za štiri normalne oblike na sliki spodaj. Spomnimo se, da je Boyce-Coddova normalna oblika strožja od tretje oblike, hkrati pa manj stroga od četrte. Četrte oblike trenutno ne obravnavamo, saj za njeno postavitev potrebujemo razumevanje večpomenskih odvisnosti, ki nas v tem članku ne zanimajo.
Še eno področje, kjer so odvisnosti našle svojo uporabo, je zmanjšanje dimenzionalnosti prostora značilnosti pri nalogah, kot so gradnja naivnega bayesovega klasifikatorja, izločanje pomembnih značilnosti in reparmeterizacija regresijske slike. V izvirnih člankih se ta naloga imenuje določanje odvečnih značilnosti (feature redundancy) in ustreznih (feature relevancy) [5, 6], pri čemer se aktivno uporablja koncept baz podatkov. Z nastankom takšnih del lahko govorimo, da danes opazimo povpraševanje po rešitvah, ki omogočajo združitev baz podatkov, analitike in uresničitev zgoraj omenjenih problemov optimizacije v en instrument [7, 8, 9].
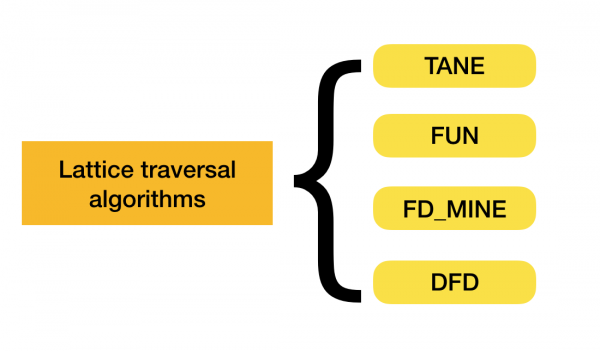
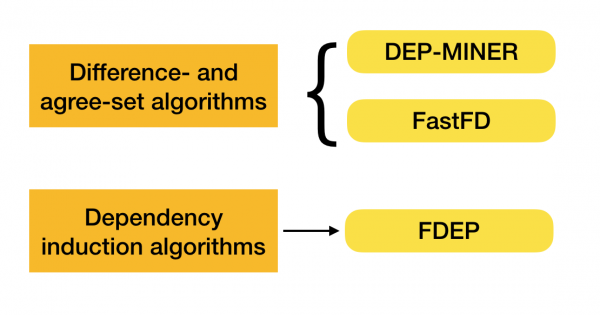
Za iskanje funkcionalnih odvisnosti v naboru podatkov obstaja številni algoritmi (tako sodobni kot manj sodobni). Ti algoritmi lahko razdelimo v tri skupine:
- Algoritmi, ki uporabljajo prehajanje skozi algebraične rešetke (Lattice traversal algorithms)
- Algoritmi, ki temeljijo na iskanju usklajenih vrednosti (Difference- and agree-set algorithms)
- Algoritmi, ki temeljijo na parnih primerjavah (Dependency induction algorithms)
Kratka opredelitev vsakega tipa algoritma je predstavljena v spodnji tabeli:
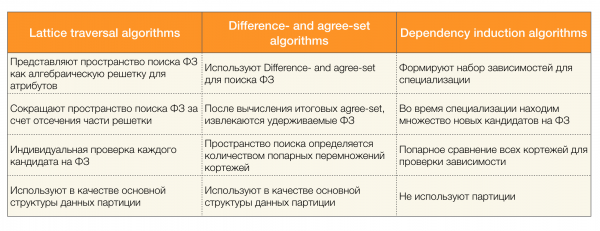
Več o tej klasifikaciji lahko preberete [4]. Spodaj so predstavljeni primeri algoritmov za vsak tip:
Trenutno se pojavljajo novi algoritemi, ki združujejo več pristopov k iskanju funkcionalnih odvisnosti. Med takšnimi algoritmi sta Pyro [2] in HyFD [3]. Razprava o njunem delovanju je predvidena v naslednjih člankih te serije. V tem članku se bomo osredotočili na osnovne pojme in lemme, ki so potrebni za razumevanje tehnik identifikacije odvisnosti.
Začnimo s preprostim — difference-set in agree-set, ki se uporabljata v drugem tipu algoritmov. Difference-set predstavlja množico potencialnih n-tork, ki se razlikujejo po vrednostih, medtem ko je agree-set obratno — n-torke, ki se ujemajo po vrednostih. Pomembno je omeniti, da obravnavamo le levo stran odvisnosti.
Prav tako je pomemben pojem, ki se je pojavil zgoraj, algebrajska mreža. Ker mnogi sodobni algoritmi delujejo s tem pojmom, moramo imeti predstavo o tem, kaj to je.
Za vpeljavo pojma mreže je potrebno določiti delno urejeno množico (ali partially ordered set, skrajšano — poset).
Določitev 2. Rečemo, da je množica S delno urejena z binarnim razmerjem ⩽, če za vse a, b, c ∈ S veljajo naslednje lastnosti:
- Refleksivnost, torej a ⩽ a
- Antisimetričnost, torej, če a ⩽ b in b ⩽ a, potem a = b
- Tranzitivnost, torej, če a ⩽ b in b ⩽ c, potem a ⩽ c
Takšno razmerje imenujemo razmerje (neostrga) delnega reda, same množice pa delno urejene množice. Formalna oznaka: ⟨S, ⩽⟩.
Kot najpreprostejši primer delno urejene množice lahko vzamemo množico vseh naravnih števil N z običajnim razmerjem reda ⩽. Ni težko preveriti, da so vse potrebne aksiome izpolnjene.
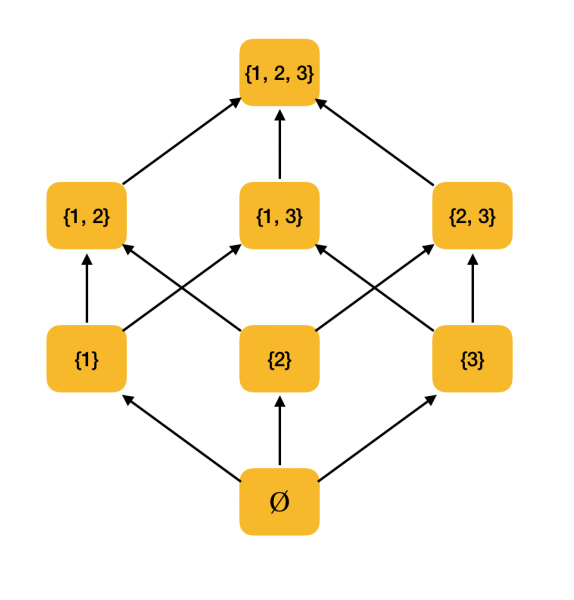
Bolj vsebinski primer. Oglejmo si množico vseh podmnožic {1, 2, 3}, urejeno z razmerjem vključevanja ⊆. Dejansko to razmerje izpolnjuje vse pogoje delnega reda, zato je ⟨P ({1, 2, 3}), ⊆⟩ — delno urejena množica. Na spodnjem diagramu je prikazana struktura te množice: če lahko iz enega elementa pridete preko puščic do drugega elementa, sta v razmerju reda.
Potrebovali bomo še dve preprosti definiciji iz področja matematike — supremum (supremum) in infimum (infimum).
Definicija 3. Naj bo ⟨S, ⩽⟩ — delno urejena množica, A ⊆ S. Zgornja meja A je element u ∈ S, tako da za vsak x ∈ S velja: x ⩽ u. Naj bo U množica vseh zgornjih meja S. Če v U obstaja najmanjši element, se ta imenuje supremum in označuje kot sup A.
Podobno se uvaja pojem natančne spodnje meje.
Definicija 4. Naj bo ⟨S, ⩽⟩ — delno urejena množica, A ⊆ S. Spodnja meja A je element l ∈ S, tako da za vsak x ∈ S velja: l ⩽ x. Naj bo L množica vseh spodnjih meja S. Če v L obstaja največji element, se ta imenuje infimum in označuje kot inf A.
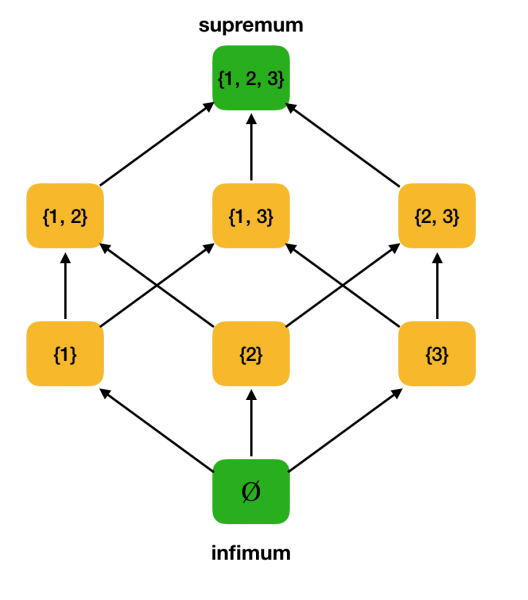
Poglejmo kot primer zgoraj omenjeno delno urejeno množico ⟨P ({1, 2, 3}), ⊆⟩ in v njej poiščimo supremum in infimum:
Zdaj lahko formuliramo definicijo algebrske rešetke.
Definicija 5. Naj bo ⟨P, ⩽⟩ — delno urejena množica, ki ima vsaka dva elementa natančne zgornje in spodnje meje. Takšna P se imenuje algebrska rešetka. Pri tem se sup{x, y} piše kot x ∨ y, inf {x, y} pa kot x ∧ y.
Preverimo, da je naš delovni primer ⟨P ({1, 2, 3}), ⊆⟩ rešetka. Res je, za vsak a, b ∈ P ({1, 2, 3}), a∨b = a∪b, a a∧b = a∩b. Na primer, poglejmo množici {1, 2} in {1, 3} ter poiščimo njun infimum in supremum. Če ju prerežemo, dobimo množico {1}, ki bo infimum. Supremum pa dobimo z njihovo združitvijo — {1, 2, 3}.
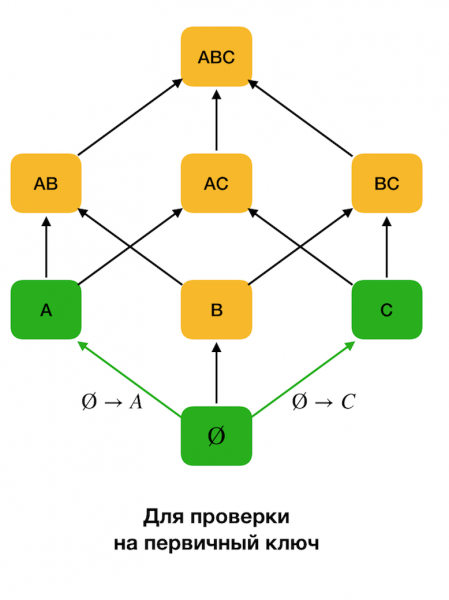
V algoritmih za odkrivanje FZ se prostor iskanja pogosto predstavlja v obliki rešetke, kjer množice z enim elementom (beri prvi nivo iskalne rešetke, kjer leva stran odvisnosti vsebuje en atribut) predstavljajo vsak atribut izvorne relacije.
Na začetku se obravnavajo odvisnosti oblike ∅ → Posamezni atribut. Ta korak omogoča določitev, kateri atributi so primarni ključi (za take atribute ni determinatov, zato je leva stran prazna). Nato takšni algoritmi napredujejo navzgor po rešetki. Pri tem je treba omeniti, da rešetke ni treba prehoditi v celoti, torej če se vnese želeni največji velikost leve strani, algoritma ne bo šla dlje od nivoja s to velikostjo.
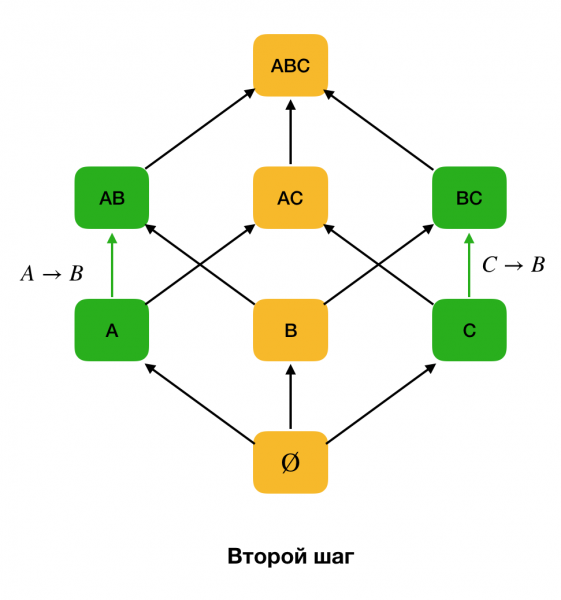
Na sliki spodaj je prikazano, kako lahko uporabimo algebrsko mrežo pri iskanju FZ. Tukaj vsaka povezava (X, XY) predstavlja odvisnost X → Y. Na primer, prešli smo na prvo raven in vemo, da se ohranja odvisnost A → B (to prikažemo z zeleno povezavo med vrhovi A in B). To pomeni, da, ko se bomo premikali navzgor po mreži, ne moremo preverjati odvisnosti A, C → B, ker ne bo več minimalna. Podobno je ne bi preverjali, če bi se ohranjala odvisnost C → B.
. Poleg tega uporabljajo skoraj vsi sodobni algoritmi za iskanje FZ takšno podatkovno strukturo, kot je particija (v izvoru - stripped partition [1]). Formalna definicija particije je naslednja:
Definicija 6. Naj bo X ⊆ R - množica atributov za odnos r. Klaster predstavlja množico indeksov tupljev iz r, ki imajo enako vrednost za X, torej c(t) = {i|ti[X] = t[X]}. Particija predstavlja množico klasterjev, ki izključuje enodimenzionalne klastre:

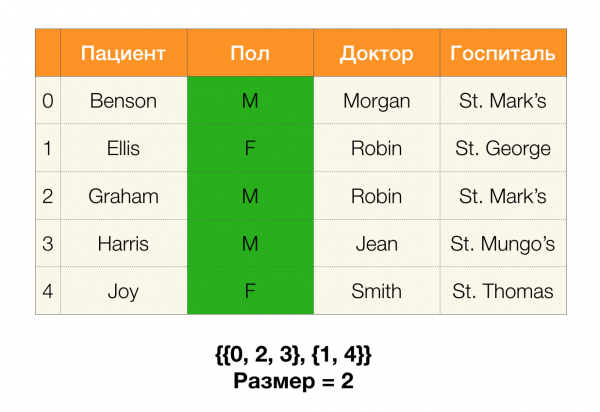
Poenostavljeno rečeno, particija za atribut X predstavlja množico seznamov, kjer vsak seznam vsebuje številke vrstic z enakimi vrednostmi za X. V sodobni literaturi se struktura, ki predstavlja particije, imenuje position list index (PLI). Enodimenzionalni klasterji so izključeni zaradi stiskanja PLI, ker so to klasterji, ki vsebujejo le številko zapisa z edinstveno vrednostjo, ki jo je vedno enostavno določiti.
Poglejmo primer. Vrnimo se k isti tabeli s pacienti in zgradimo particije za stolpce Pacient in Spol (na levi se je pojavil nov stolpec, v katerem so označene številke vrstic tabele):
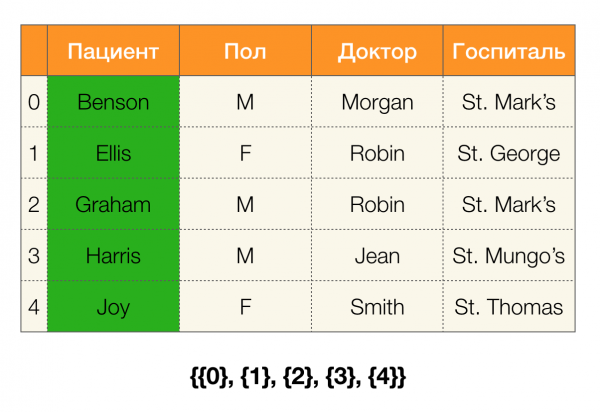
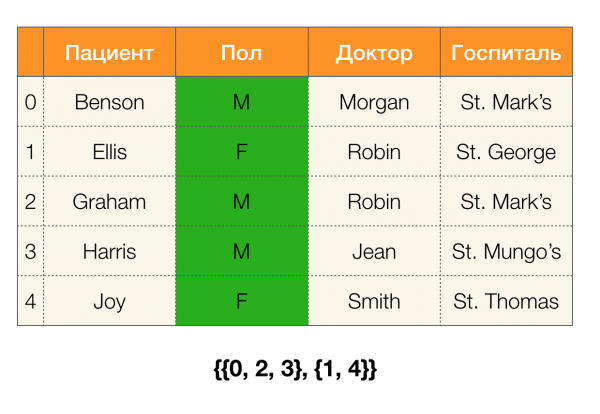
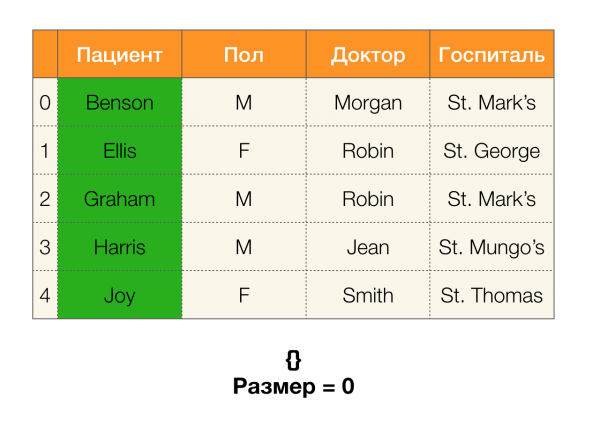
Pri tem bo, v skladu z definicijo, particija za stolpec Pacient v bistvu prazna, saj se enodimenzionalni klasterji izključujejo iz particije.
Particije lahko pridobimo po več atributih. In za to obstajata dve poti: prehod skozi tabelo in takojšnja gradnja particije za vse potrebne atribute, ali pa njena gradnja z operacijo preseka particij po podmnožici atributov. Algoritmi za iskanje FZ uporabljajo drugo možnost.
Poenostavljeno rečeno, da bi, na primer, pridobili particijo po stolpcih ABC, lahko vzamemo particije za AC in B (ali katerikoli drug niz nepregrešljivih podnizov) in jih med seboj križati. Operacija križanja dveh particij določa najsrednejše podsklopke, skupne za obe particiji.
Poglejmo primer:
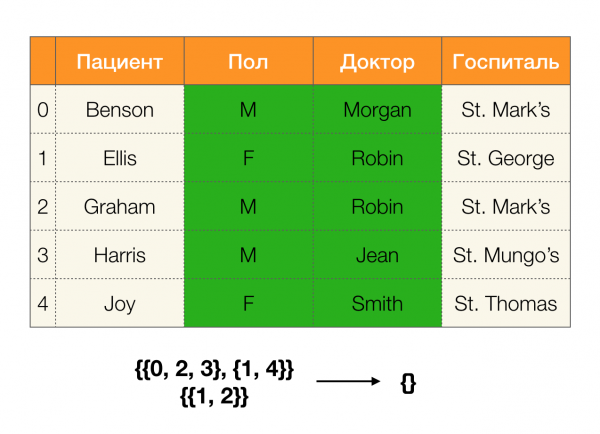
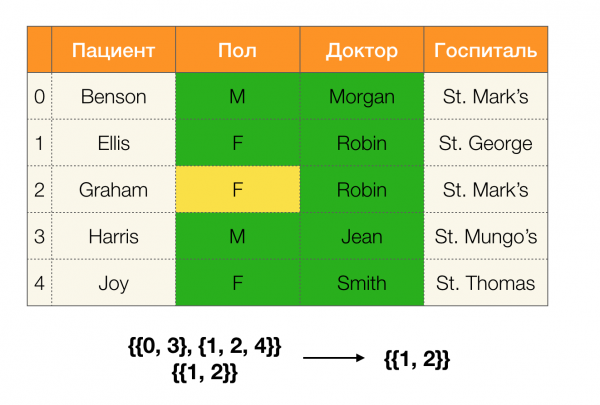
V prvem primeru smo dobili prazno particijo. Če se ozremo na tabelo, boste dejansko videli, da ni enakih vrednosti po dveh atributih. Če pa nekoliko spremenimo tabelo (primer desno), bomo že dobili neprazno križanje. V tem primeru imata vrstici 1 in 2 res enake vrednosti po atributih. Spol in Doktor.
Nato bomo potrebovali koncept, kot je velikost particije. Formalno:

Poenostavljeno povedano, velikost particije predstavlja število podklasi, ki vstopajo v particijo (ne pozabite, da enotni podklasi ne gredo v particijo!):
Zdaj lahko določimo enega ključnih lem, ki za dane particije omogoča ugotovitev, ali je odvisnost zadržana ali ne:
Lema 1. Odvisnost A, B → C je zadržana, če in samo če

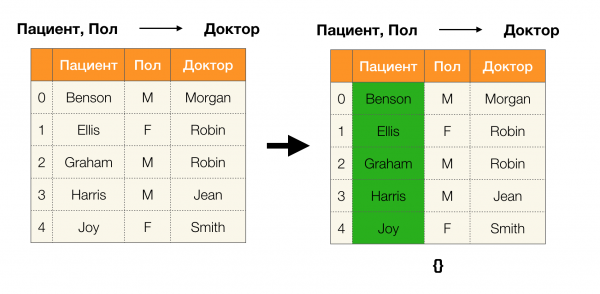
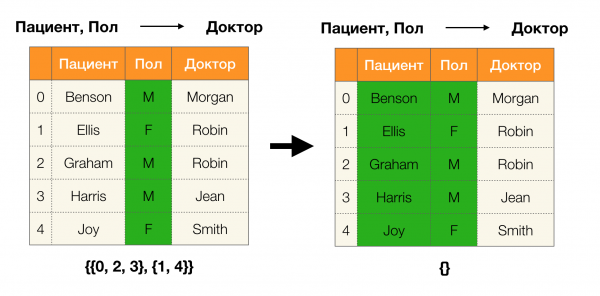
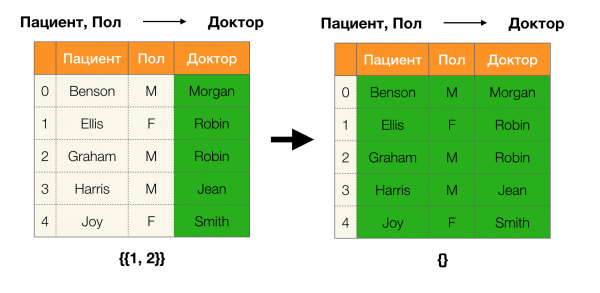
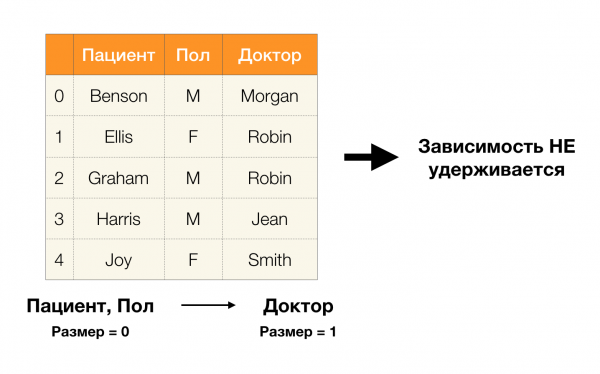
Po lemi za določanje, ali je odvisnost zadržana, je potrebno opraviti štiri korake:
- Izračunati particijo za levo stran odvisnosti
- Izračunati particijo za desno stran odvisnosti
- Izračunati produkt prvega in drugega koraka
- Primerjati velikosti particij, pridobljenih v prvem in tretjem koraku
Spodaj je predstavljen primer preverjanja, ali je odvisnost zadržana po tej lemi:
V tem članku smo obravnavali takšne pojme, kot so funkcionalna odvisnost, približna funkcionalna odvisnost, obravnavali smo, kje se uporabljajo, pa tudi katerih algoritmov iskanja funkcionalnih odvisnosti obstaja. Prav tako smo podrobno preučili osnovne, a pomembne pojme, ki se aktivno uporabljajo v sodobnih algoritmih iskanja funkcionalnih odvisnosti.
Reference:
- Huhtala Y. et al. TANE: Učinkovit algoritem za odkrivanje funkcionalnih in približnih odvisnosti // Računalniški časopis. – 1999. – T. 42. – št. 2. – str. 100-111.
- Kruse S., Naumann F. Učinkovito odkrivanje približnih odvisnosti // Zbornik dela VLDB. – 2018. – T. 11. – št. 7. – str. 759-772.
- Papenbrock T., Naumann F. Hibridni pristop k odkrivanju funkcionalnih odvisnosti // Zbornik dela Mednarodne konference o upravljanju podatkov. – ACM, 2016. – str. 821-833.
- Papenbrock T. et al. Odkritje funkcionalnih odvisnosti: Eksperimentalna ocena sedmih algoritmov // Zbornik dela VLDB. – 2015. – T. 8. – št. 10. – str. 1082-1093.
- Kumar A. et al. Se pridružiti ali ne?: Razmišljanje dvakrat o združitvah pred izbiro funkcionalnosti // Zbornik dela Mednarodne konference o upravljanju podatkov. – ACM, 2016. – str. 19-34.
- Abo Khamis M. et al. In-database learning with sparse tensors // Proceedings of the 37th ACM SIGMOD-SIGACT-SIGAI Symposium on Principles of Database Systems. – ACM, 2018. – P. 325-340.
- Hellerstein J. M. et al. The MADlib analytics library: or MAD skills, the SQL // Proceedings of the VLDB Endowment. – 2012. – Vol. 5. – No. 12. – P. 1700-1711.
- Qin C., Rusu F. Speculative approximations for terascale distributed gradient descent optimization // Proceedings of the Fourth Workshop on Data analytics in the Cloud. – ACM, 2015. – P. 1.
- Meng X. et al. Mllib: Machine learning in apache spark // The Journal of Machine Learning Research. – 2016. – Vol. 17. – No. 1. – P. 1235-1241.
Авторы статьи: , исследователь в , in , исследователь в
Izvor: habr.com
