

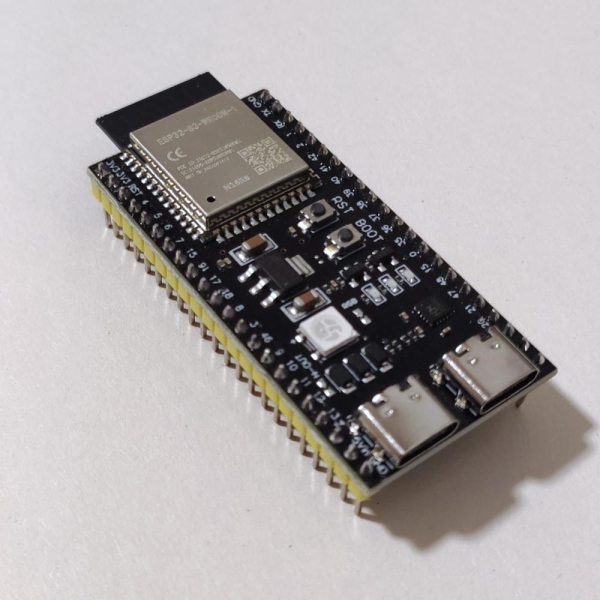
Razvijalec Vyacheslav Serbov, ki sliši na psevdonim slvDev, dokazano Popolnoma lokalno generiranje besedila na mikrokrmilniku ESP32-S3. Nastali jezikovni model vsebuje 28,9 milijona parametrov in ustvari približno 9,9 žetonov na sekundo brez dostopa do strežnika ali drugih zunanjih računalniških virov. Ustvarjene kratke zgodbe so prikazane na priključenem OLED zaslonu.
Projekt esp32-ai Testirano na modulu ESP32-S3 N16R8 z 512 KB vgrajenega SRAM-a, 8 MB PSRAM-a in 16 MB bliskovnega pomnilnika. 4-bitni kvantizirani model zaseda 14,9 MB. Repozitorij vsebuje izvorno kodo izvajalnega okolja C, orodja za učenje in kvantizacijo, vdelano programsko opremo, teste in skripte za nalaganje na ploščo.
Navedenih 28,9 milijona parametrov se ne sme neposredno primerjati s številom parametrov običajnih namiznih LLM-jev. Glede na podrobno poročilo razvijalcaModel je sestavljen iz gostega računskega jedra s približno 559 parametri, izhodne plasti s 3,1 milijona parametrov in tabele večplastnih vektorskih predstavitev s približno 25 milijoni parametrov. Slednja predstavlja večino formalne velikosti modela, vendar se pri generiranju vsakega žetona ne obdela v celoti.
Za shranjevanje modela se uporabljajo tri ravni pomnilnika. Najpogosteje dostopani podatki se nahajajo v notranjem SRAM-u, izhodna plast, predpomnilnik KV in začasni medpomnilniki se nahajajo v PSRAM-u, tabela s 25 milijoni elementov pa se nahaja v bliskovnem pomnilniku in je dostopna prek preslikave naslovnega prostora. Za vsak žeton se iz njega prebere le približno šest vrstic, kar skupaj znaša približno 450 bajtov.
Ta naprava temelji na tehnologiji Per-Layer Embeddings, ki jo Google uporablja v Gemmi 3n. Po navedbah Googlova dokumentacijaParametre PLE je mogoče shraniti zunaj delovnega pomnilnika modela in jih dodati v postopek sklepanja, ko se obdelujejo posamezne plasti. V esp32-ai je ta pristop razširjen na hierarhijo pomnilnika mikrokrmilnika, kjer je hiter SRAM še posebej omejen.
Prva pravilna različica izvajalnega okolja, ki temelji na jeziku C, je ustvarila le 0,57 žetonov na sekundo. Po namestitvi izhodne plasti v PSRAM, preklopu na osembitne aktivacije, porazdelitvi izračuna med dve jedri Xtensa LX7 in drugih optimizacijah se je latenca zmanjšala na 94,9 ms na korak modela. Končna izmerjena prepustnost je dosegla 9,88 žetonov na sekundo, ob upoštevanju celotnega procesa generiranja. Glavna omejitev je zdaj postala pasovna širina PSRAM-a pri branju izhodne plasti.
Model je bil usposobljen na sintetičnem naboru podatkov TinyStories, ki je sestavljen iz preprostih zgodb v angleškem jeziku z omejenim besediščem. Zato lahko nadaljuje stavke in sestavlja kratke, povezane zgodbe, vendar ni zasnovan za odgovarjanje na vprašanja, sledenje navodilom, programiranje ali reprodukcijo dejanskega znanja. Razvijalec delo vidi predvsem kot demonstracijo učinkovite namestitve modela v pomnilnik mikrokrmilnika in ne kot že pripravljenega, avtonomnega klepetalnega robota.
V trenutni dokumentaciji avtor posebej poudarja, da je esp32-ai neodvisen razvoj. Projekti lama2.c Delo Andreja Karpathyja in prejšnja predstavitev 260. modela na ESP32-S3 sta navedena le kot smernice in primera prejšnjega dela: koda, kontrolne točke in metodologija niso neposredno izposojene od njih. Izvorna koda esp32-ai distribuirano pod licenco MIT.
Vir: linux.org.ru
