

30. november – 1. december se je v Nižnem Novgorodu odvijala. Udeležencem je bilo predlagano, da ustvarijo prototip produkta z uporabo Intel OpenVINO orodij. Organizatorji so pripravili seznam primernih tem, na katere so se lahko osredotočili pri izbiri naloge, vendar je bila končna odločitev prepuščena ekipam. Poleg tega je bilo spodbujeno uporabo modelov, ki niso vključeni v izdelek.
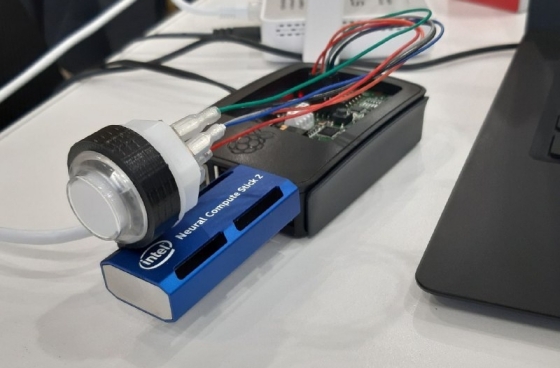
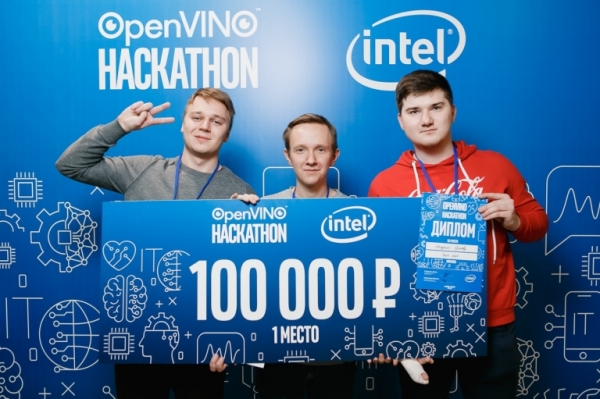
V članku bomo govorili o tem, kako smo razvili svoj prototip produkta, s katerim smo na koncu osvojili prvo mesto.
Hackathona se je udeležilo več kot 10 ekip. Lepo je, da so nekatere prišle iz drugih regij. Kraj prireditve hackathona je bila izbrana kompleks „Kremljski na Počajni“, kjer so bile notranjosti okrašene s starinskimi fotografijami Nižnega Novgoroda, kar je dalo posebno vzdušje! (pripominjam, da je trenutni centralni urad podjetja Intel pravzaprav v Nižnem Novgorodu). Udeležencem je bilo na voljo 26 ur za programiranje, na koncu pa so morali predstaviti svoje rešitve. Dodatna prednost je bila prisotnost demo-sesije, da so se prepričali, da je bilo vse, kar so zamislili, resnično realizirano, in ne le ideje v predstavitvi. Tudi merč, prigrizki, hrana – vse je bilo!
Poleg tega je podjetje Intel po želji nudilo kamere, Raspberry PI, Neural Compute Stick 2.
Izbira naloge
Ena izmed najtežjih delov priprave na hackathon s svobodno tematiko je izbira naloge. Takoj smo se odločili, da bomo izmislili nekaj, česar še ni v produktu, saj je bilo v napovedi omenjeno, da je to močno dobrodošlo.
Po analizi , ki so vključeni v izdelek v trenutni izdaji, ugotovimo, da večina rešuje različne naloge računalniškega vida. Zelo težko je izumiti nalogo s področja računalniškega vida, ki je ne mogoče rešiti z uporabo OpenVINO, in če bi jo tudi lahko izumili, je v odprtem dostopu težko najti predizobražene modele. Odločili smo se, da bomo raziskali še drug smer — obdelavo in analitiko govora. Razmišljamo o zanimivi nalogi prepoznavanja čustev na podlagi govora. Treba je povedati, da OpenVINO že ima model, ki določa čustva človeka na podlagi obraza, vendar:
- V teoriji bi bilo možno narediti združeni algoritem, ki bi deloval tako na podlagi zvoka kot na podlagi slike, kar bi moralo povečati natančnost.
- Kamere običajno imajo ozek kot gledanja, da pokrijejo veliko območje, potrebujemo več kot eno kamero, zvok pa nima tega omejitvenega faktorja.
Razvijamo idejo: vzeli bomo za osnovo idejo za retail segment. Lahko se določi zadovoljstvo kupca na blagajnah trgovin. Če je kdo od kupcev nezadovoljen s storitvijo in začne dvigovati ton — lahko takoj pokličete administratorja na pomoč.
V tem primeru je potrebno dodati prepoznavanje ljudi po glasu, kar nam bo omogočilo razlikovanje med zaposlenimi trgovine in kupci ter dajanje analitik o vsakem posamezniku. Poleg tega bo mogoče analizirati obnašanje samih zaposlenih trgovine in oceniti vzdušje v ekipi, zvenelo bo dobro!
Oblikujemo zahteve za našo rešitev:
- Majhna velikost ciljne naprave
- Delo v realnem času
- Nizka cena
- Enostavna razširljivost
Na koncu izberemo Raspberry Pi 3 kot ciljno napravo .
Tu je pomembno omeniti eno pomembno značilnost NCS — najbolje deluje s standardnimi CNN arhitekturami, če pa bo potrebno zagnati model z prilagojenimi plastmi, pričakujte natančno, da bo potrebna nizkotskala optimizacija.
Posledično potrebujemo mikrofon. Ustrezal bo tudi navaden USB mikrofon, saj se ne bo dobro ujemal z RPI. Toda rešitev je pravzaprav preprosta. Za zajemanje glasu bomo uporabili ploščo Voice Bonnet iz kompleta , na katerem je vgrajen stereo mikrofon.
Prenesemo Raspbian iz in ga prenesemo na USB ključek, testiramo, ali mikrofon deluje s pomočjo naslednjega ukaza (snemal bo zvok dolžine 5 sekund in shranil v datoteko):
arecord -d 5 -r 16000 test.wavTakoj opažam, da je mikrofon zelo občutljiv in dobro zajema šume. Da to popravimo, vstopimo v alsamixer, izberemo Capture devices in znižamo raven vhodnega signala na 50-60%.
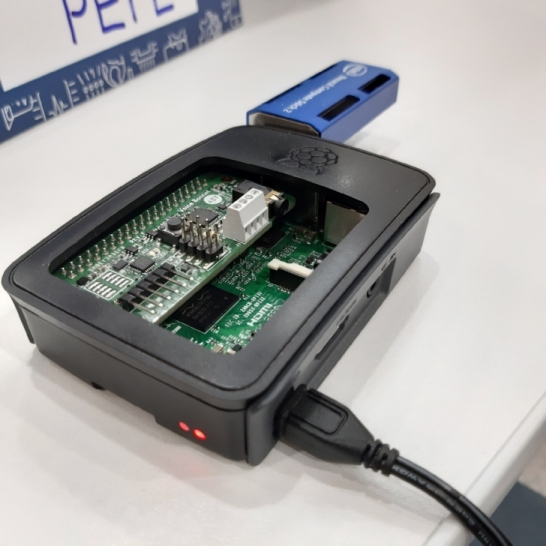
Oblikujemo ohišje z datoteko in vse se prilega, lahko celo zapremo s pokrovom.
Dodamo gumb-indikator
Med razstavljanjem AIY Voice Kit na dele se spomnimo, da tam obstaja RGB gumb, katerega osvetlitev lahko upravljamo programersko. Poiščemo "Google AIY Led" in najdemo dokumentacijo:
Zakaj ne bi uporabili tega gumba za prikaz prepoznane emocije, imamo le 7 razredov, gumb pa ima 8 barv, ravno dovolj!
Priključujemo gumb preko GPIO na Voice Bonnet, uvozimo potrebne biblioteke (one su već instalirane u distribuciji od AIY projekata)
from aiy.leds import Leds, Color
from aiy.leds import RgbLeds
Napravimo dict u kojem će svakoj emociji odgovarati boja u obliku RGB Tuple i objekat klase aiy.leds.Leds, kroz koji ćemo ažurirati boju:
led_dict = {'neutral': (255, 255, 255), 'happy': (0, 255, 0), 'sad': (0, 255, 255), 'angry': (255, 0, 0), 'fearful': (0, 0, 0), 'disgusted':  (255, 0, 255), 'surprised':  (255, 255, 0)}
leds = Leds()
I, konačno, nakon svakog novog predviđanja emocije, ažuriraćemo boju gumba u skladu s tim (prema ključnoj reči).
leds.update(Leds.rgb_on(led_dict.get(classes[prediction])))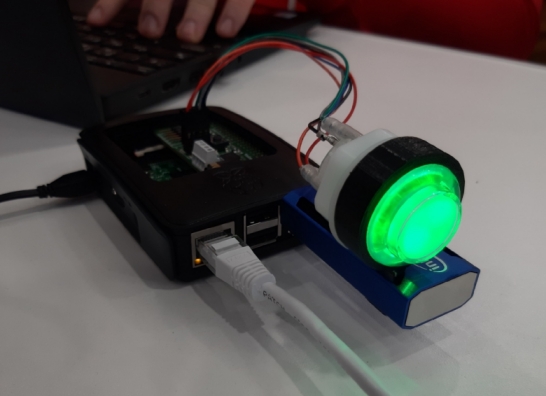
Gumb, sijaj!
Radimo s glasom
Koristićemo pyaudio za hvatanje toka sa mikrofona i webrtcvad za filtriranje šuma i detekciju glasa. Pored toga, kreiraćemo red u koji ćemo asinkrono dodavati i uzimati isječke s glasom.
Budući da webrtcvad ima ograničenje na veličinu podnijetog fragmenta — mora biti 10/20/30ms, a obuka modela za prepoznavanje emocija (kao što ćemo kasnije saznati) vršena je na datasetu od 48kHz, hvataćemo čunke veličine 48000×20ms/1000×1(mono)=960 bajtova. Webrtcvad će vraćati True/False za svaki od takvih čunaka, što odgovara prisustvu ili odsustvu glasa u čunku.
Realizovaćemo sledeću logiku:
- Dodavaćemo u listu one čunke gde ima glasa, ako glasa nema, inkrementiraćemo brojač praznih čunaka.
- Ako je brojač praznih čunaka >=30 (600 ms), gledamo veličinu liste nagomilanih čunaka, ako je >250, dodajemo u red, inače smatramo da je dužina snimka nedovoljna da bismo je predali modelu za identifikaciju govornika.
- Ako je brojač praznih čunaka i dalje < 30, a veličina liste nagomilanih čunaka prešla 300, dodajemo odlomak u red za preciznije predviđanje. (jer s vremenom emocije se menjaju)
 def to_queue(frames):
    d = np.frombuffer(b''.join(frames), dtype=np.int16)
    return d

framesQueue = queue.Queue()
def framesThreadBody():
    CHUNK = 960
    FORMAT = pyaudio.paInt16
    CHANNELS = 1
    RATE = 48000

    p = pyaudio.PyAudio()
    vad = webrtcvad.Vad()
    vad.set_mode(2)
    stream = p.open(format=FORMAT,
                channels=CHANNELS,
                rate=RATE,
                input=True,
                frames_per_buffer=CHUNK)
    false_counter = 0
    audio_frame = []
    while process:
        data = stream.read(CHUNK)
        if not vad.is_speech(data, RATE):
            false_counter += 1
            if false_counter >= 30:
                if len(audio_frame) > 250:
                    framesQueue.put(to_queue(audio_frame,timestamp_start))
                    audio_frame = []
                    false_counter = 0

        if vad.is_speech(data, RATE):
            false_counter = 0
            audio_frame.append(data)
            if len(audio_frame) > 300:
                framesQueue.put(to_queue(audio_frame,timestamp_start))
                    audio_frame = []
Čas je, da iščemo v odprtem dostopu predusposobljene modele, gremo na github, googlamo, a ne pozabimo, da imamo omejitev na uporabljeno arhitekturo. To je dokaj zapleten del, ker moramo testirati modele na svojih vhodnih podatkih, poleg tega pa jih pretvoriti v notranji format OpenVINO — IR (Intermediate Representation). Poskusili smo približno 5-7 različnih rešitev s githuba, in če je model za prepoznavanje čustev deloval takoj, je bilo s prepoznavanjem po glasu potrebno več časa — tam se uporabljajo bolj zapletene arhitekture.
Ostajamo pri naslednjih:
- Čustva iz glasu —
Deluje po naslednjem načelu: avdio se razreže na odseke določene velikosti, za vsak od teh odsekov izločimo in jih nato vnesemo v CNN - Prepoznavanje po glasu —
Tukaj namesto MFCC delamo s spektrogramom, po FFT vnesemo signal v CNN, kjer na izhodu dobimo vektorsko predstavitev glasu.
Naslednje se bo govorilo o pretvorbi modelov, začeli bomo s teorijo. OpenVINO vključuje več modulov:
- Open Model Zoo, modele iz katerega je mogoče uporabiti in vključiti v svoj izdelek
- Model Optimizer, zahvaljujoč kateremu lahko pretvorimo model iz različnih formatov okvirjev (Tensorflow, ONNX itd.) v format Intermediate Representation, s katerim bomo nadalje delali
- Inference Engine omogoča zagon modelov v IR formatu na Intel procesorjih, Myriad čipih in pospeševalnikih Neural Compute Stick
- Najbolj učinkovita različica OpenCV (s podporo za Inference Engine)
Vsak model v formatu IR je opisan z dvema datotekama: .xml in .bin.
Modeli se pretvarjajo v format IR preko Model Optimizer na naslednji način:python /opt/intel/openvino/deployment_tools/model_optimizer/mo_tf.py --input_model speaker.hdf5.pb --data_type=FP16 --input_shape [1,512,1000,1]--data_typeallows you to choose the data format with which the model will work. Supported formats are FP32, FP16, INT8. Choosing the optimal data type can provide a significant performance boost.
--input_shapespecifies the dimensions of the input data. The possibility to change it dynamically seems to exist in the C++ API, but we didn't dig that deep and just fixed it for one of the models.
Next, we'll try to load the already converted model into the IR format through the DNN module in OpenCV and perform a forward pass on it.import cv2 as cv emotionsNet = cv.dnn.readNet('emotions_model.bin', 'emotions_model.xml') emotionsNet.setPreferableTarget(cv.dnn.DNN_TARGET_MYRIAD)The last line here allows redirecting computations to the Neural Compute Stick; computations are executed on the processor by default, but in the case of Raspberry Pi, this won't work, and a stick is needed.
Next, the logic is as follows: we will divide our audio into windows of a certain size (in our case, 0.4s), each of these windows will be transformed into MFCCs, which will then be fed into the grid:
emotionsNet.setInput(MFCC_from_window)
result = emotionsNet.forward()
After that, we will take the most frequently occurring class for all windows. A simple solution, but for the hackathon, there's no need to overthink it unless there’s time. We still have a lot of work to do, so let's move on — figuring out voice recognition. We need to create a base where the spectrograms of pre-recorded voices will be stored. Since there’s not much time left, we’ll tackle this question as best we can.
Specifically, we create a script for recording a voice segment (it works just like described above, except when interrupted from the keyboard, it will save the voice to a file).
Let's try this:
python3 voice_db/record_voice.py test.wavWe record the voices of several people (in our case, three team members).
Next, for each recorded voice, we perform a fast Fourier transform, obtain the spectrogram, and save it as a numpy array (.npy):for file in glob.glob("voice_db/*.wav"): spec = get_fft_spectrum(file) np.save(file[:-4] + '.npy', spec)More details in the file
create_base.py
As a result, when running the main script, we will initially obtain embeddings from these spectrograms:for file in glob.glob("voice_db/*.npy"): spec = np.load(file) spec = spec.astype('float32') spec_reshaped = spec.reshape(1, 1, spec.shape[0], spec.shape[1]) srNet.setInput(spec_reshaped) pred = srNet.forward() emb = np.squeeze(pred)Po prejemu vdeljanja iz predvajane sekvence bomo lahko določili, komu pripada, s pomočjo kosinusne razdalje od odseka do vseh glasov v bazi (manjša kot je, bolj verjetno je) — za demo smo nastavili prag 0.3):
        dist_list = cdist(emb, enroll_embs, metric="cosine")
        distances = pd.DataFrame(dist_list, columns = df.speaker)
Na koncu naj omenim, da je bila hitrost inferenčnega postopka hitra in je omogočala dodajanje še 1-2 modela (za vzorec dolžine 7 sekund je bil potreben čas za inferenco 2.5). Nove modele nismo uspeli dodati in smo se osredotočili na pisanje prototipa spletne aplikacije.
Spletna aplikacija
Pomembna točka: prinesite si usmerjevalnik od doma in nastavite svojo lokalno omrežje, kar pomaga povezati naprave in prenosne računalnike v omrežje.
Backend predstavlja skrajno komunikacijsko mrežo med frontendom in Raspberry Pi, temelječo na tehnologiji websocket (http over tcp protokol).
Prvi korak je pridobitev obdelanih informacij z Raspberryja, to je paketi napovedi v json formatu, ki se na sredini svoje poti shranijo v bazo podatkov, da bi lahko oblikovali statistiko o čustvenem stanju uporabnika v določenem obdobju. Nato se ta paket pošlje na frontend, ki uporablja naročnino in prejemanje paketov z websocket končnega točke. Celoten backend mehanizem je zgrajen v programskem jeziku golang, izbira padla na njega, ker se dobro obnese pri asinhronih nalogah, s katerimi se gorutine dobro spopadajo.
Ob dostopu do končne točke se uporabnik registrira in doda v strukturo, nato se pridobi njegova sporočila. Uporabnik in sporočilo se zapišeta v skupni hub, iz katerega sporočila nato pošiljajo naprej (na naročen frontend), in če uporabnik prekine povezavo (Raspberry ali frontend), se njegova naročnina prekliče in odstrani iz huba.
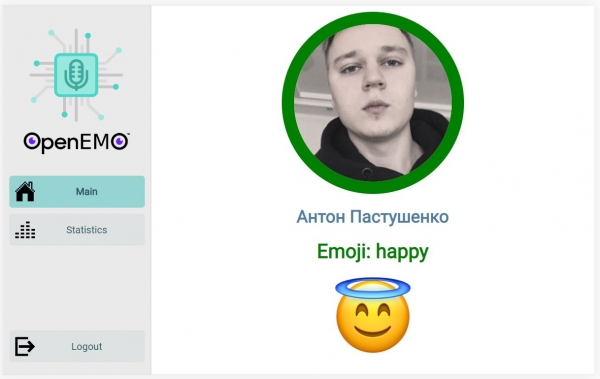
Pričakujemo povezavo z backendomFront-end je spletna aplikacija, napisana v JavaScriptu z uporabo knjižnice React, ki pospešuje in poenostavi postopek razvoja. Cilj te aplikacije je vizualizacija podatkov, pridobljenih s pomočjo algoritmov, ki tečejo na back-end strani in neposredno na Raspberry Pi. Na strani je implementirano usmerjanje po razdelkih s pomočjo react-router, vendar je glavni interes usmerjen na glavno stran, kjer v realnem času prihaja neprekinjen tok podatkov s strežnika prek tehnologije WebSocket. Raspberry Pi zaznava glas, določa pripadnost določenemu posamezniku iz registrirane baze in pošilja seznam verjetnosti stranki. Stranka prikazuje najnovejše relevantne podatke, prikaže avatar osebe, ki je z največjo verjetnostjo govorila v mikrofon, ter čustvo, s katerim izgovarja besede.

Glavna stran z ažuriranimi predikcijamiZaključek
Nismo uspeli dokončati vsega, kar smo si zamislili, preprosto nismo imeli dovolj časa, zato smo imeli veliko upanja v demo, da bo vse delovalo. V predstavitvi so predstavili, kako je vse urejeno, katere modele so vzeli, s katerimi težavami so se srečali. Nato je sledil del demo — strokovnjaki so se spuščali po dvorani naključno in pristopali k vsaki ekipi, da bi si ogledali delujoči prototip. Postavljali so vprašanja tudi nam, vsak je odgovarjal na svojem področju, na prenosniku so pustili spletno aplikacijo in vse je res delovalo, kot je bilo pričakovano.
Opozarjam, da je skupna cena naše rešitve znašala 150$:
- Raspberry Pi 3 ~ 35$
- Google AIY Voice Bonnet (lahko uporabite ploščo respeaker) ~ 15$
- Intel NCS 2 ~ 100$
Kako izboljšati:
- Uporabiti registracijo s stranke — prositi za branje besedila, ki ga generiramo naključno
- Dodati še nekaj modelov: po glasu lahko določimo spol in starost
- Ločiti hkrati se zaslišane glasove (diarizacija)
Shramba:

Utrujeni, vendar srečni smoNa koncu bi se želel zahvaliti organizatorjem in udeležencem. Med projekti drugih ekip nam je osebno najbolj všeč rešitev za spremljanje prostih parkirnih mest. To je bilo izjemno super doživetje potopa v izdelek in razvoj. Upam, da bo v regijah potekalo vse več zanimivih dogodkov, vključno s tematiko AI.
Izvor: habr.com
