

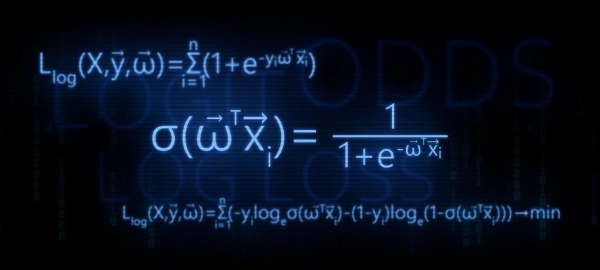
V tem članku bomo razdelali teoretične izpeljanke transformacije funkcije linearne regresije u funkcije obratne logit transformacije (drugače rečeno, funkcijo logistične reakcije). Nato bomo z uporabo arsenala metode maksimalne verjetnosti, v skladu z modelom logistične regresije, izpeljali funkcijo izgube Logistic Loss, oziroma drugimi besedami, definirali bomo funkcijo, s katero v modelu logistične regresije izbiramo parametre vektorja teže  .
Načrt članka:
- Ponovili bomo o linearni odvisnosti med dvema spremenljivkama
- Ugotovili bomo potrebo po transformaciji funkcije linearne regresije
 u funkcije logistične reakcije
- Izvedli bomo transformacije in izpeljali funkcije logistične reakcije
- Poskusili bomo razumeti, zakaj je metoda najmanjših kvadratov slaba pri izbiri parametrov funkcije Logistic Loss
- Uporabljamo metod maksimalne verovatnoće za ugotavljanje funkcije izbire parametrov :
5.1. Primer 1: funkcija Logistic Loss za objekte z oznakami razredov 0 in 1:
5.2. Primer 2: funkcija Logistic Loss za objekte z oznakami razredov -1 in +1:
 u funkcije logistične reakcije

 funkcije Logistic Loss
 :


Članek je poln preprostih primerov, kjer je vse izračune enostavno izvesti ustno ali na papirju, v nekaterih primerih pa je morda potreben kalkulator. Zato se pripravite 🙂
Ta članek je bolj namenjen podatkovnim znanstvenikom z osnovnim poznavanjem temeljev strojnega učenja.
V članku bo tudi koda za risanje grafikonov in izračune. Vsa koda je napisana v jeziku python 2.7. Vnaprej naj povem o 'novosti' uporabljene različice – to je eden od pogojev za uspešno zaključitev znanega tečaja od Yandex na prav tako znani spletni platformi za spletno izobraževanje Coursera, in, kot se lahko domisli, je bil material pripravljen na podlagi tega tečaja.
01. Linearna odvisnost
Popolnoma smiselno je postaviti vprašanje – kakšna povezava je med linearno odvisnostjo in logistično regresijo?
Vse je enostavno! Logistična regresija je ena izmed modelov, ki spadajo pod linearni klasifikator. Preprosto povedano, naloga linearnega klasifikatorja je napovedovanje ciljih vrednosti  iz spremenljivk (regressorjev)
 . Pri tem se domneva, da je odvisnost med značilnostmi
 in ciljnimi vrednostmi
 linearna. Od tod izhaja tudi ime klasifikatorja — linearni. Če malo poenostavimo, je v osnovi modela logistične regresije predpostavka o obstoju linearne odvisnosti med značilnostmi.
 in ciljnimi vrednostmi
 Tukaj je — povezava.
V studiu je prvi primer, ki se pravilno nanaša na neposredno odvisnost raziskovanih količin. Med pripravo članka sem naletel na primer, ki je mnogim že znan — odvisnost toka od napetosti. („Praktična regresijska analiza“, N.Dreper, G.Smith). Tudi tukaj ga bomo obravnavali.
U skladu s z Ohmovim zakonom:
 , gde
 — tok,
 — napetost,
 — upornost.
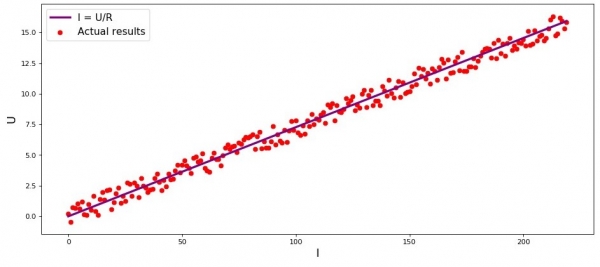
Če ne bi poznali Ohmovega zakona, bi lahko odvisnost našli empirično, tako da bi spremenili  in izmerili
 , pri čemer bi
 ostalo nespremenjeno. Takrat bi videli, da graf odvisnosti
 od
 prikazuje bolj ali manj ravno črto, ki poteka skozi izhodišče. Rekli smo „bolj ali manj“, saj, čeprav je odvisnost dejansko točna, lahko vsebuje naše meritve majhne napake, zato točke na grafu morda ne bodo točno na črti, temveč bodo razpršene okoli nje naključno.
Graf 1 „Odvisnost  od
 »
Koda za risanje grafa
import matplotlib.pyplot as plt
%matplotlib inline

import numpy as np

import random

R = 13.75

x_line = np.arange(0,220,1)
y_line = []
for i in x_line:
    y_line.append(i/R)

y_dot = []
for i in y_line:
    y_dot.append(i+random.uniform(-0.9,0.9))


fig, axes = plt.subplots(figsize = (14,6), dpi = 80)
plt.plot(x_line,y_line,color = 'purple',lw = 3, label = 'I = U/R')
plt.scatter(x_line,y_dot,color = 'red', label = 'Dejanski rezultati')
plt.xlabel('I', size = 16)
plt.ylabel('U', size = 16)
plt.legend(prop = {'size': 14})
plt.show()
02. Potreba po pretvorbah v enačbi linearne regresije
Poglejmo še en primer. Predstavljajmo si, da delamo v banki in imamo nalogo določiti verjetnost vračila kredita s strani posojilojemalca, odvisno od nekaterih dejavnikov. Za poenostavitev problema bomo obravnavali le dve dejavniki: mesečno plačo posojilojemalca in mesečni znesek odplačila kredita.
Naloga je zelo hipotetična, vendar bomo na tem primeru lahko razumeli, zakaj samo uporaba funkcije linearne regresije, ni dovolj, ter ugotovili, katere pretvorbe funkcije je potrebno izvesti.
Vrnilimo se k primeru. Jasno je, da višja je plača, več lahko kreditojemalec mesečno nameni za odplačilo posojila. Pri tem je za določen razpon plač ta odvisnost povsem linearna. Recimo, da vzamemo razpon plač od 60.000 R do 200.000 R in domnevamo, da je odvisnost mesečnega plačila od višine plače v tem razponu linearna. Predpostavimo, da je bilo za ta določen razpon plač ugotovljeno, da razmerje med plačo in plačilom ne sme pasti pod 3, poleg tega pa mora imeti kreditojemalec še 5.000 R na voljo. Le v tem primeru bomo menili, da bo kreditojemalec vrnil posojilo banki. Tako bo enačba linearne regresije imela naslednjo obliko:

kjer  ,
 ,
 ,
 — plača
 -ega kreditojemalca,
 — plačilo za posojilo
 -ega kreditojemalca.
Če v enačbo vstavimo plačo in plačilo za posojilo s fiksnimi parametri,  lahko sprejmemo odločitev o odobritvi ali zavrnitvi posojila.
Pogledamo vnaprej in opazimo, da bo pri danih parametrih  funkcija linearne regresije, uporabljena v logistični funkciji odgovora, dala visoke vrednosti, ki bodo otežile izračune glede verjetnosti odplačila posojila. Zato predlagamo, da naše koeficiente zmanjšamo, recimo, za 25.000-krat. Od te pretvorbe v koeficientih se odločitev o odobritvi posojila ne bo spremenila. Zapomnimo si ta trenutek za naprej, zdaj pa, da bo še bolj jasno, o čem govorimo, poglejmo situacijo s tremi potencialnimi kreditojemalci.
Tabela 1 »Potencialni kreditojemalci«
Koda za oblikovanje tabele
import pandas as pd

r = 25000.0
w_0 = -5000.0/r
w_1 = 1.0/r
w_2 = -3.0/r

data = {'Kreditojemalec':np.array(['Vasya', 'Fedya', 'Lesha']),
        'Plača':np.array([120000,180000,210000]),
       'Plačilo':np.array([3000,50000,70000])}

df = pd.DataFrame(data)

df['f(w,x)'] = w_0 + df['Plača']*w_1 + df['Plačilo']*w_2

decision = []
for i in df['f(w,x)']:
    if i > 0:
        dec = 'Odobreno'
        decision.append(dec)
    else:
        dec = 'Zavrnitev'
        decision.append(dec)

df['Odločitev'] = decision

df[['Kreditojemalec', 'Plača', 'Plačilo', 'f(w,x)', 'Odločitev']]
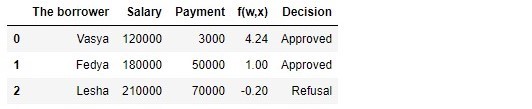
Na podlagi podatkov iz tabele Vasya, ki ima plačo 120.000 R, želi pridobiti posojilo, da bi ga mesečno odplačeval s 3.000 R. Določili smo, da mora biti plača Vasye trikrat večja od višine plačila, da bi bilo posojilo odobreno, in da mu mora ostati še 5.000 R. Ta zahtevek Vasya izpolnjuje:  . Ostaja se celo 106.000R. Kljub temu da smo pri izračunu
 zmanjšali koeficiente
 za 25.000-krat, je rezultat enak — kredit je lahko odobren. Fedor bo prav tako prejel kredit, medtem ko bo Aleksej, kljub temu da zasluži največ, moral umiriti svoje apetite.
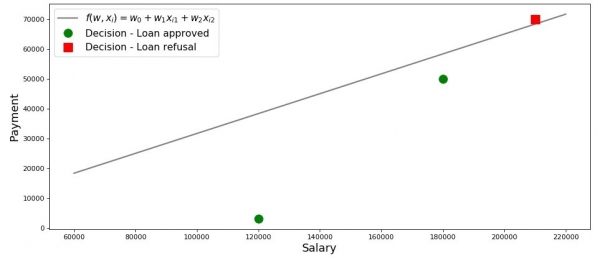
Narisi graf za tak primer.
Graf 2 „Klasiifikacija posojilojemalcev“
Koda za risanje grafa
salary = np.arange(60000,240000,20000)
payment = (-w_0-w_1*salary)/w_2


fig, axes = plt.subplots(figsize = (14,6), dpi = 80)
plt.plot(salary, payment, color = 'grey', lw = 2, label = '$f(w,x_i)=w_0 + w_1x_{i1} + w_2x_{i2}$')
plt.plot(df[df['Decision'] == 'Approved']['Salary'], df[df['Decision'] == 'Approved']['Payment'],
         'o', color ='green', markersize = 12, label = 'Odločitev - Kredit odobren')
plt.plot(df[df['Decision'] == 'Refusal']['Salary'], df[df['Decision'] == 'Refusal']['Payment'],
         's', color = 'red', markersize = 12, label = 'Odločitev - Kredit zavrnjen')
plt.xlabel('Plača', size = 16)
plt.ylabel('Plačilo', size = 16)
plt.legend(prop = {'size': 14})
plt.show()
Torej, naša črta, zgrajena v skladu s funkcijo  , ločuje 'slabe' posojilojemalce od 'dobrih'. Tisti posojilojemalci, katerih želje se ne ujemajo z zmožnostmi, so nad črto (Aleksej), tisti, ki so sposobni vrniti kredit, pa so pod črto (Vasja in Fedor). Drugače rečeno — naša črta deli posojilojemalce na dve plasti. Oznacimo jih na naslednji način: v razred
 uvrstimo tiste posojilojemalce, ki bodo verjetno vrnili kredit, v razred
 ili
 uvrstimo tiste posojilojemalce, ki verjetno ne bodo mogli vrniti kredita.
Povzamemo zaključke iz tega preprostega primera. Vzemimo točko  in, nadomeščajoč koordinate točke v ustrezno enačbo črte
 , obravnavamo tri možnosti:
- Če je točka pod črto in jo uvrstimo v razred , bo vrednost funkcije pozitivna od do . To pomeni, da lahko rečemo, da se verjetnost poplačila kredita giblje v okviru . Večja kot je vrednost funkcije, višja je verjetnost.
- Če je točka nad črto in jo uvrstimo v razred ili , bo vrednost funkcije negativna od do . Takrat bomo menili, da se verjetnost poplačila dolga giblje v okviru in, večja kot je absolutna vrednost funkcije, večje je naše zaupanje.
- Točka se nahaja na črti, na meji med dvema razredoma. V tem primeru bo vrednost funkcije enaka in verjetnost poplačila kredita je enaka .
 , bo vrednost funkcije
 pozitivna od
 do
 . To pomeni, da lahko rečemo, da se verjetnost poplačila kredita giblje v okviru
 . Večja kot je vrednost funkcije, višja je verjetnost.
 ili
 , bo vrednost funkcije negativna od
 do
 . Takrat bomo menili, da se verjetnost poplačila dolga giblje v okviru
 in, večja kot je absolutna vrednost funkcije, večje je naše zaupanje.
 enaka
 in verjetnost poplačila kredita je enaka
 .
Zdaj pa si predstavljamo, da nimamo dveh dejavnikov, ampak desetine, posojilojemalcev ne tri, temveč tisoče. Takrat namesto črte ne bo. m-мерная плоскость и коэффициенты  не будут взяты с потолка, а будут выведены по всем правилам, на основе накопленных данных о заемщиках, вернувших или не вернувших кредит. И действительно, заметьте, мы сейчас отбираем заемщиков при уже известных коэффициентах
 . На самом деле, задача модели логистической регрессии как раз и состоит в том, чтобы определить параметры
 , при которых значение функции потерь Logistic Loss будет стремиться к минимальному. Но о том, как рассчитывается вектор
 , мы еще узнаем в 5-м разделе статьи. А пока вернемся на землю обетованную — к нашему банкиру и трем его клиентам.
Zahvaljujoč funkciji  мы знаем, кому можно дать кредит, а кому нужно отказать. Но с такой информацией к директору идти нельзя, ведь от нас хотели получить вероятность возврата кредита каждым заемщиком. Что делать? Ответ простой — нам нужно как-то преобразовать функцию
 , значения которой лежат в диапазоне
 на функцию, значения которой будут лежать в диапазоне
 . И такая функция существует, ее называют функцией логистического отклика или обратного логит-преобразования. Знакомьтесь:

Посмотрим по шагам, как получается функция логистического отклика. Отметим, что шагать мы будем в обратную сторону, т.е. мы предположим, что нам известно значение вероятности, которое лежит в пределах от  do
 и далее мы будем «раскручивать» это значение на всю область чисел от
 do
 .
03. Выводим функцию логистического отклика
Шаг 1. Переведем значения вероятности в диапазон

На время трансформации функции  u funkcije logistične reakcije
 мы оставим в покое нашего кредитного аналитика, а вместо этого пройдемся по букмекерским конторам. Нет, конечно, ставки делать мы не будем, все что нас там интересует, это смысл выражения, например, шанс 4 к 1. Шансы, знакомые всем делающим ставки игрокам, являются соотношением «успехов» к «неуспехам». С точки зрения вероятностей, шансы — это вероятность наступления события, деленная на вероятность того, что событие не произойдет. Запишем формулу шанса наступления события
 :

, gde  — вероятность наступления события,
 — вероятность НЕ наступления события
Например, если вероятность того, что молодой, сильный и резвый конь по прозвищу «Ветерок» обойдет на скачках старую и дряблую старушку по кличке «Матильда», равняется  , to so bodo možnosti uspeha „Veterka“
 k

 in obratno, poznamo možnosti, zato ne bo težko izračunati verjetnosti
 :

Tako smo se naučili „prevajati“ verjetnost v možnosti, ki lahko dobijo vrednosti od  do
 . Storimo še en korak in se naučimo „prevajati“ verjetnost na celo številsko premico od
 do
 .
Korak 2. Pretvorimo vrednosti verjetnosti v razpon

Ta korak je zelo preprost — logaritmiramo možnosti na osnovo števila Eulerja  in dobimo:

Zdaj vemo, da če  , potem bo vrednost
 zelo lahka za izračunati in, kar je pomembno, mora biti pozitivna:
 . Tako je.
Iz radovednosti preverimo, da če  , potem pričakujemo, da bomo videli negativno vrednost
 . Preverimo:
 . Vse drži.
Zdaj vemo, kako pretvoriti vrednost verjetnosti od  do
 na celo številsko premico od
 do
 . V naslednjem koraku bomo naredili vse obratno.
Za zdaj pa opazimo, da v skladu s pravili logaritimiranja, poznajoč vrednost funkcije  , lahko izračunamo možnosti:

Ta način določanja možnosti nam bo v pomoč v naslednjem koraku.
Korak 3. Izpeljimo formulo za določitev

Torej, naučili smo se, da poznamo  , najdemo vrednosti funkcije
 . Vendar pa v resnici potrebujemo vse natančno obratno — poznajoč vrednost
 najdemo
 . Za to se obrnimo na pojem obratne funkcije možnosti, po kateri:

V članku ne bomo izpeljali zgoraj omenjene formule, a preverili bomo s številkami iz zgornjega primera. Vemo, da pri možnostih 4 proti 1 ( ), verjetnost dogodka znaša 0.8 (
 ). Naredimo zamenjavo:
 . To se ujema z našimi izračuni, ki smo jih izvedli prej. Nadaljujemo.
V prejšnjem koraku smo izpeljali, da  , zato lahko naredimo zamenjavo v obratni funkciji možnosti. Dobimo:

Razdelimo tako števec kot imenovalec na  , torej:

Za vsak slučaj, da se prepričamo, da nismo nikjer naredili napake, bomo izvedli še en majhen test. V koraku 2 smo za  določili, da
 . Potem, če vrednost
 vstavimo v funkcijo logistične odzivnosti, pričakujemo, da bomo dobili
 . Vstavljamo in dobimo:

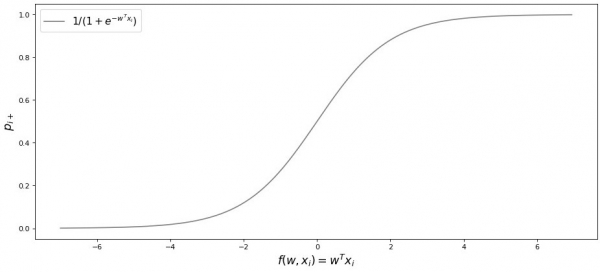
Čestitam, spoštovani bralec, pravkar smo izpeljali in testirali funkcijo logistične odzivnosti. Poglejmo graf funkcije.
Graf 3 „Funkcija logistične odzivnosti“
Koda za risanje grafa
import math

def logit (f):
    return 1/(1+math.exp(-f))

f = np.arange(-7,7,0.05)
p = []

for i in f:
    p.append(logit(i))

fig, axes = plt.subplots(figsize = (14,6), dpi = 80)
plt.plot(f, p, color = 'grey', label = '$ 1 / (1+e^{-w^Tx_i})$')
plt.xlabel('$f(w,x_i) = w^Tx_i$', size = 16)
plt.ylabel('$p_{i+}$', size = 16)
plt.legend(prop = {'size': 14})
plt.show()
V literaturi se lahko srečamo tudi z imenom te funkcije kot sigmoidna funkcija. Na grafu je dobro opaziti, da se večina sprememb verjetnosti pripadnosti objekta razredu zgodi v relativno majhnem obsegu  , nekje od
 do
 .
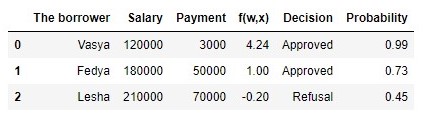
Predlagam, da se vrnemo k našemu analitiku kreditov in mu pomagamo pri izračunu verjetnosti vračila kreditov, sicer tvega, da bo ostal brez bonusa 🙂
Tabela 2 «Potencialni posojilojemniki»
Koda za oblikovanje tabele
proba = []
for i in df['f(w,x)']:
    proba.append(round(logit(i),2))

df['Verjetnost'] = proba

df[['Posojilojemalec', 'Plača', 'Plačilo', 'f(w,x)', 'Odločitev', 'Verjetnost']]
Torej, verjetnost vračila kredita smo določili. Na splošno se to zdi resnično.
Dejansko je verjetnost, da bo Vašek s plačo 120.000R lahko mesečno vrnil 3.000R banki, blizu 100%. Mimogrede, moramo razumeti, da lahko banka Odrejku odobri kredit, če je politika banke, na primer, odobriti kredite strankam z verjetnostjo vračila kredita večjo od, recimo, 0.3. Samo v tem primeru bo banka oblikovala večji rezervat za morebitne izgube.
Prav tako je potrebno omeniti, da je razmerje med plačo in plačilom vsaj 3 in z rezervo 5.000R vzeto iz zraka. Zato niso mogli uporabiti v prvotni obliki vektor tež.  . Potrebno je bilo močno zmanjšati koeficiente in v takem primeru smo vsak koeficient delili s 25.000, torej v bistvu smo prilagodili rezultat. Toda to je bilo storjeno namerno, da bi poenostavili razumevanje gradiva v začetni fazi. V resničnem življenju ne bo potrebno izmišljati in prilagajati koeficientov, ampak jih iskanje. Ravno v naslednjih odstavkih članka bomo izpeljali enačbe, s pomočjo katerih se določijo parametri.
 .
04. Metoda najmanjših kvadratov pri določitvi vektorja tež. v funkciji logistične odzivnosti.
 v funkciji logistične odzivnosti.
Takšna metoda iskanja vektorja tež nam je že znana.  , in sicer metoda najmanjših kvadratov (MNK) in zakaj je potem ne bi uporabili pri nalogah binarne klasifikacije? Resnično, nič ne ovira uporabe. MNK, le da ta način v nalogah klasifikacije daje manj natančne rezultate, kot Logistic LossZa tem stoji teoretično utemeljitev. Poglejmo najprej en preprost primer.
Recimo, da naše modele (ki uporabljajo MSE in Logistic Loss) že začenjajo iskanje vektorja teže  in smo prenehali s izračunom na neki točki. Nič hudega, ali je sredi, na koncu ali na začetku, glavna stvar je, da imamo že neke vrednosti vektorja teže in recimo, da v tej točki vektorja teže
 za oba modela nimata razlik. Potem vzamemo dobljene teže in jih vstavimo v funkcije logistične reakcije (
 ) za nek objekt, ki spada v razred
 . Preučimo dva primera, ko na podlagi izbranega vektorja teže naš model močno zgreši in obratno — model je zelo prepričan, da objekt spada v razred
 . Poglejmo, kakšne kazni bodo "dodeljene" pri uporabi MNK in Logistic Loss.
Koda za izračun kazni glede na uporabljeno funkcijo izgube
# класс объекта
y = 1
# вероятность отнесения объекта к классу в соответствии с параметрами w
proba_1 = 0.01

MSE_1 = (y - proba_1)**2
print 'Штраф MSE при грубой ошибке =', MSE_1

# напишем функцию для вычисления f(w,x) при известной вероятности отнесения объекта к классу +1 (f(w,x)=ln(odds+))
def f_w_x(proba):
    return math.log(proba/(1-proba))

LogLoss_1 = math.log(1+math.exp(-y*f_w_x(proba_1)))
print 'Штраф Log Loss при грубой ошибке =', LogLoss_1

proba_2 = 0.99

MSE_2 = (y - proba_2)**2
LogLoss_2 = math.log(1+math.exp(-y*f_w_x(proba_2)))

print '**************************************************************'
print 'Штраф MSE при сильной уверенности =', MSE_2
print 'Штраф Log Loss при сильной уверенности =', LogLoss_2
Primer z grobo napako — model uvršča objekt v razred  s verjetnostjo 0,01
Kazni pri uporabi MNK bodo znašale:

Kazni pri uporabi Logistic Loss bodo znašale:

Primer z močno prepričanjem — model uvršča objekt v razred  s verjetnostjo 0,99
Kazni pri uporabi MNK bodo znašale:

Kazni pri uporabi Logistic Loss bodo znašale:

Ta primer dobro ilustrira, da pri grobi napaki funkcija izgube Log Loss kaznuje model znatno močneje kot MSE. Zdaj poglejmo, kakšne so teoretične predpostavke za uporabo funkcije izgube Log Loss v nalogah klasifikacije.
05. Metoda maksimuma verjetnosti in logistična regresija
Kot je bilo obljubljeno na začetku, članek obiluje s preprostimi primeri. V studiu je nov primer in stari gostje — posojilojemalci banke: Vaša, Fedor in Aleksej.
Za vsak slučaj, pred nadaljevanjem primera, opominjam, da v življenju delamo z učnimi vzorci tisočih ali milijonov objektov z desetimi ali stotimi značilnostmi. Tukaj pa so številke izbrane, da jih lahko enostavno dojame začetnik v podatkovni znanosti.
Vrnem se nazaj k primeru. Predstavljajmo si, da je direktor banke sklenil odobriti kredit vsem, ki ga potrebujejo, kljub temu da je algoritem svetoval, naj ga ne izda Leši. In tako je minilo dovolj časa in razbrali smo, kdo od treh junakov je vrnil kredit in kdo ne. Kot smo tudi pričakovali: Vaša in Fedya sta vrnila kredit, Leša pa ne. Zdaj si zamišljamo, da bo ta rezultat za nas nova učna skupina in da hkrati nimamo podatkov o dejavnikih, ki vplivajo na verjetnost odplačila kredita (plača posojilojemalca, znesek mesečnega obroka). Potem lahko intuitivno domnevamo, da vsak tretji posojilojemalec ne vrne kredita banki, oziroma je verjetnost vračila kredita naslednjemu posojilojemalcu  . To intuitivno domnevanje ima teoretično potrditev in temelji na metodi največje verjetnosti, ki jo pogosto imenujemo princip največje verjetnosti.
Najprej se seznanimo s pojmi.
Verjetnost vzorca je verjetnost, da dobimo natančno tak vzorec, natančno take opazovanja / rezultate, tj. produkt verjetnosti pridobitve vsakega izmed rezultatov vzorca (na primer, odplačan ali neodplačan kredit Vasya, Fedya in Leše hkrati).
Funkcija verjetnosti povezuje verjetnost vzorca s vrednostmi parametrov porazdelitve.
V našem primeru učni vzorec predstavlja generalizirano Bernoullijevo shemo, v kateri naključna spremenljivka sprejme le dve vrednosti:  ili
 . Zato lahko verjetnost vzorca zapišemo kot funkcijo verjetnosti parametra
 takole:


Zgornji zapis lahko interpretiramo tako: skupna verjetnost, da bosta Vaša in Fedya odplačala kredit, je  , verjetnost, da Leša NE odplača kredita, pa je
 (saj je šlo prav za NE odplačilo kredita), zato je skupna verjetnost vseh treh dogodkov enaka
 .
Metod maksimalne verovatnoće - to je metoda ocenjevanja neznanega parametra z maksimizacijo funkcije verovatnoće. V našem primeru je potrebno najti tako vrednost  , pri kateri
 doseže maksimum.
Od kod se je vlastně vzala myšlenka hledat hodnotu neznámého parametru, při které dosahuje funkce věrohodnosti maxima? Příčiny této myšlenky vycházejí z představy, že vzorek je jediným zdrojem znalostí o populaci. Vše, co víme o populaci, je obsaženo ve vzorku. Proto můžeme říci, že vzorek je nejpřesnějším odrazem populace, který máme k dispozici. Následně potřebujeme najít takový parametr, při kterém je stávající vzorek nejpravděpodobnější.
Zřejmé je, že se jedná o optimalizační úlohu, ve které je potřeba najít bod extrému funkce. Pro nalezení bodu extrému je nutné zvážit podmínku prvního řádu, tedy položit derivaci funkce rovnu nule a vyřešit rovnici vůči hledanému parametru. Nicméně hledání derivace součinu velkého množství faktorů může být zdlouhavé, a aby se tomu předešlo, existuje speciální technika — přechod k logaritmu. funkcije verovatnoće. Proč je takový přechod možný? Všimněme si, že hledáme nikoli samotný extrém funkce , ale bod extrému, tedy to, jaká hodnota neznámého parametru
 , pri kateri
 dosahuje maxima. Při přechodu k logaritmu se bod extrému nemění (i když samotný extrém bude jiný), neboť logaritmus je monotónní funkce.
Pojďme tedy v souladu s výše uvedeným pokračovat v našem příkladu s úvěry od Vaši, Fedi a Leši. Nejprve přejdeme k logaritmu funkce věrohodnosti:

Nyní můžeme snadno diferenciovat výraz podle  :

A nakonec zvážíme podmínku prvního řádu — položíme derivaci funkce rovnu nule:

Takže naše intuitivní hodnocení pravděpodobnosti splácení úvěru  bylo teoreticky zdůvodněno.
Skvěle, ale co teď dělat s takovými informacemi? Pokud budeme předpokládat, že každý třetí dlužník nevrátí bance peníze, tak ta by nevyhnutelně zkrachovala. To je sice pravda, ale při hodnocení pravděpodobnosti splácení úvěru rovné  nismo upoštevali dejavnike, ki vplivajo na vračilo posojila: plačo posojilojemalca in znesek mesečnega plačila. Spomnimo se, da smo prej izračunali verjetnost vračila posojila za vsakega od strank ob upoštevanju teh dejavnikov. Logično je, da so verjetnosti drugačne od konstante, ki znaša
 .
Določimo verjetnost vzorcev:
Koda za izračun verjetnosti vzorcev
from functools import reduce

def likelihood(y,p):
    line_true_proba = []
    for i in range(len(y)):
        ltp_i = p[i]**y[i]*(1-p[i])**(1-y[i])
        line_true_proba.append(ltp_i)
    likelihood = []
    return reduce(lambda a, b: a*b, line_true_proba)


y = [1.0,1.0,0.0]
p_log_response = df['Probability']
const = 2.0/3.0
p_const = [const, const, const]


print 'Verjetnost vzorca pri konstantni vrednosti p=2/3:', round(likelihood(y,p_const),3)

print '****************************************************************************************************'

print 'Verjetnost vzorca pri izračunani vrednosti p:', round(likelihood(y,p_log_response),3)
Verjetnost vzorca pri konstantni vrednosti  :

Verjetnost vzorca pri izračunu verjetnosti vračila posojila ob upoštevanju dejavnikov  :


Verjetnost vzorca s verjetnostjo, izračunano glede na dejavnike, se je izkazala za višjo od verjetnosti pri konstantni vrednosti. Kaj to pomeni? To pomeni, da so znanja o dejavnikih omogočila natančnejše prilagajanje verjetnosti vračila posojila za vsakega od strank. Zato bo ob odobritvi novega posojila pravilneje uporabiti model ocenjevanja verjetnosti vračila dolga, ki je predlagan na koncu 3. poglavja članka.
Ampak takrat, če želimo maksimalizirati funkcijo verjetnosti vzorca, zakaj ne uporabiti kakšnega algoritma, ki bi za Vasjo, Fedi in Lešo na primer izdal verjetnosti 0.99, 0.99 in 0.01. Morda se bo tak algoritem dobro obnesel na učni vzorcu, saj bo približal vrednost verjetnosti vzorca k  , ampak, najprej, tak algoritem bo verjetno imel težave z generalizacijo, poleg tega pa algoritem zagotovo ne bo linearen. In če metode za boj proti prekomernemu učenju (prav tako slaba sposobnost generalizacije) očitno niso del načrta tega članka, se pod drugega točko podrobneje sprehodimo. Za to je dovolj odgovoriti na preprosto vprašanje. Lahko imata možnost odplačila posojila Vasja in Fedja enako, ob upoštevanju znanih dejstev? Z vidika zdrave pameti seveda ne, ne moreta. Tako bo Vasja za odplačilo posojila odnašal 2,5 % svoje plače na mesec, Fedja pa skoraj 27,8 %. Na grafu 2 'Klasifikacija strank' prav tako vidimo, da je Vasja precej dlje od črte, ki deli razrede, kot Fedja. In nazadnje, vemo, da funkcija
 za Vasjo in Fedjo prevzema različne vrednosti: 4,24 za Vasjo in 1,0 za Fedjo. Če bi Fedja na primer zaslužil bistveno več ali bi prosil za manjše posojilo, bi bile verjetnosti odplačila posojila pri Vasji in Fedji podobne. Z drugimi besedami, linearne odvisnosti ne moremo prevarati. In če bi dejansko preračunali koeficiente
 , ne pa jih vzeli s stropa, bi lahko mirno trdili, da naše vrednosti
 najbolje ocenjujejo verjetnost odplačila posojila za vsakega posojilojemalca, toda ker smo se dogovorili, da je določitev koeficientov
 potekalo v skladu z vsemi pravili, bomo to tudi upoštevali — naši koeficienti omogočajo dajanje najboljše ocene verjetnosti 🙂
Vendar smo se odmaknili od teme. V tem poglavju moramo razumeti, kako se določi vektor teže  , ki je potreben za oceno verjetnosti vračila posojila za vsakega posojilojemalca.
Na kratko povzamemo, s kakšnim arzenalom nastopamo pri iskanju koeficientov  :
1. Predpostavljamo, da je odvisnost med ciljno spremenljivko (napovedno vrednostjo) in faktorjem, ki vpliva na rezultat — linearna. Iz tega razloga se uporablja funkcija linearne regresije oblik  , katere črta deli objekte (stranke) na razrede
 in
 ili
 (stranke, ki lahko odplačajo posojilo, in tiste, ki ne morejo). V našem primeru ima enačba obliko
 .
2. Uporabljamo funkcijo obratne logit-transformacije oblik  za določitev verjetnosti pripadnosti objekta razredu
 .
3. Našo učno izbiro obravnavamo kot uresničitev generalizirane Bernoulli schemes, meaning that for each object a random variable is generated that with a probability  (its own for each object) takes the value 1 and with a probability
 – 0.
4. We know that we need to maximize funkcijo verjetnosti vzorca considering the accepted factors so that the existing sample becomes most plausible. In other words, we need to find parameters such that the sample is most plausible. In our case, the parameter we are looking for is the probability of loan repayment  , which in turn depends on unknown coefficients
 . Therefore, we need to find such a weight vector
 , for which the sample likelihood will be maximum.
5. We know how to maximize the likelihood function of the sample možete koristiti metod maksimalne verovatnoće. And we know all the clever tricks for working with this method.
This is how the intricate scheme turns out 🙂
Now, let's remember that at the very beginning of the article we wanted to derive two types of loss functions Logistic Loss depending on how the object classes are designated. It has become customary that in classification tasks with two classes, the classes are denoted as  in
 ili
 . Depending on the designation, the resulting loss function will correspond.
Case 1. Classification of objects into in
 in

Earlier, when determining the sample likelihood, where the probability of debt repayment by the borrower was calculated based on factors and given coefficients  , we applied the formula:

In fact,  — this is the value of the logistic response function
 given a specified weight vector

Then nothing prevents us from writing the likelihood function of the sample as follows:

Sometimes, it happens that some novice analysts find it difficult to quickly understand how this function works. Let's consider 4 short examples that will clarify everything:
1. Если  (i.e., according to the training sample, an object belongs to class +1), and our algorithm
 determines the probability of the object belonging to class
 equal to 0.9, so this piece of the sample likelihood will be calculated as follows:

2. Если  , a
 , thus the calculation will be as follows:

3. Если  , a
 , thus the calculation will be as follows:

4. Если  , a
 , thus the calculation will be as follows:

It is obvious that the likelihood function will be maximized in cases 1 and 3 or in general—in cases of correctly guessed probability values for the object belonging to the class  .
Due to the fact that when determining the probability of an object's class affiliation  mi niso znani samo koeficienti
 , jih bomo iskali. Kot je bilo omenjena zgoraj, je to optimizacijska naloga, pri kateri moramo najprej poiskati derivat funkcije verjetnosti po vektorju teže
 . Vendar ima smisel predhodno poenostaviti nalogo: derivat bomo iskali od logaritma funkcije verovatnoće.

Zakaj po logaritmiranju, v funkciji logistične napake, smo spremenili znak na  na
 . Vse je preprosto, saj v nalogah ocenjevanja kakovosti modela običajno minimiziramo vrednost funkcije, zato smo desno stran izraza pomnožili z
 in tako namesto maksimizacije zdaj minimiziramo funkcijo.
Dejansko, trenutno, pred vašimi očmi je bila težko izvedena funkcija izgube — Logistic Loss za učni sklop z dvema razredoma:  in
 .
Zdaj, da bi našli koeficiente, moramo samo poiskati derivat funkciji logistične napake in nadalje, z uporabo numeričnih metod optimizacije, kot sta gradientni spust ali stohastični gradientni spust, poiskati najbolj optimalne koeficiente  . Vendar, ob upoštevanju že zmernega obsega članka, se predlaga, da izvedete diferenciranje sami ali pa morda to postane tema za naslednji članek z več aritmike brez tako podrobnih primerov.
Primer 2. Klassifikacija objektov na in
 in

Pristop bo enak kot pri razredih  in
 , vendar bo sama pot do izhoda funkcije izgube Logistic Loss, bolj vijugava. Začnimo. Za funkcijo verjetnosti bomo uporabili operator »če…, potem…«. To pomeni, če
 -i objekt pripada razredu
 , potem za izračun verjetnosti vzorca uporabimo verjetnost
 , če objekt pripada razredu
 , potem v verjetnost vstavimo
 . Tako izgleda funkcija verjetnosti:

Na prste bomo opisali, kako to deluje. Razmislimo o 4 primerih:
1. Если  in
 , potem bo v verjetnost vzorca «šlo»

2. Если  in
 , potem bo v verjetnost vzorca «šlo»

3. Если  in
 , potem bo v verjetnost vzorca «šlo»

4. Если  in
 , potem bo v verjetnost vzorca «šlo»

Očitno je, da v 1. in 3. primeru, ko so bile verjetnosti pravilno določene z algoritmom, funkcija verjetnosti bo maksimizirana, torej točno to smo želeli doseči. Vendar je tak pristop dokaj obsežen in nadalje bomo obravnavali bolj kompakten zapis. Najprej pa bomo logaritmizirali funkcijo verjetnosti z zamenjavo znaka, saj jo bomo zdaj minimizirali.

Vstavimo namesto  izraze
 :

Poenostavimo desni del logaritma z uporabo preprostih aritmetičnih tehnik in dobimo:

Zdaj pa je čas, da se znebimo operatorja »če…, potem…«. Opazimo, da ko objekt  pripada razredu
 , potem je v izrazu pod logaritmom v imenovalcu
 dvignjen na potenco
 , če objekt pripada razredu
 , potem se $e$ dvigne na potenco
 . Zato lahko zapis potenc preprosto poenostavimo - združimo oba primera v enega:
 . Takrat funcija logistične napake imela obliko:

V skladu s pravili logaritmizacije obrnemo ulomek in znak " " (minus) damo pred logaritem, dobimo:

Pred vami je funkcija izgub logistic Loss, ki se uporablja pri učni množici z objekti, ki pripadajo razredom:  in
 .
No, na tej točki se poslavljam in zaključujemo članek.
Prejšnje delo avtorja — „Pretvarjanje enačbe linearne regresije v matrico“
Dodatni materiali
1. Literatura
1) Praktična regresijska analiza / N. Draper, G. Smith – 2. izd. – Moskva: Finance in statistika, 1986 (prevod iz angleščine)
2) Teorija verjetnosti in matematična statistika / V.E. Gmurman — 9. izd. — Moskva: Višja šola, 2003
3) Teorija verjetnosti / N.I. Černova — Novosibirsk: Novosibirjska državna univerza, 2007
4) Poslovna analiza: od podatkov do znanja / Paklin N.B., Oreškov V.I. — 2. izd. — Sankt Peterburg: Piter, 2013
5) Data Science Znanost o podatkih od začetka / Joel Grass — Sankt Peterburg: BХВ Peterburg, 2017
6) Praktična statistika za strokovnjake Data Science / P. Bruce, E. Bruce — Sankt Peterburg: BХВ Peterburg, 2018
2. Predavanja, tečaji (video)
1)
2)
3)
4)
5)
3. Internetni viri
1)
2)
3)
4)
5)
6)
7)
8)
Izvor: habr.com

 Russian
 Italian
 German
 Polish
 Estonian
 Albanian
 Bulgarian
 Croatian
 Czech
 Danish
 Dutch
 English
 Finnish
 French
 Hungarian
 Latvian
 Lithuanian
 Norwegian
 Portuguese
 Romanian
 Slovak
 Slovenian
 Spanish
 Swedish