

Hello, Habr!
Prejšnjo jesen je na Kaggle potekalo tekmovanje v klasifikaciji ročno narisanih slik Quick Draw Doodle Recognition, v katerem je med drugim sodelovala ekipa R-jevcev v sestavi , in . Podrobneje ne bomo opisovali tekmovanja, to je že bilo storjeno v .
Tokrat nam ni uspelo priti do medalj, prejeli pa smo veliko dragocenih izkušenj, zato bi radi delili nekaj najbolj zanimivih in uporabnih tem na Kaggleu in v vsakodnevnem delu s skupnostjo. Med obravnavanimi temami: težko življenje brez OpenCV, parsenje JSON-ov (v teh primerih obravnavamo integracije kode v C++ v skripte ali pakete v R preko Rcpp), parametrizacija skript in dockerizacija končne rešitve. Vsa koda iz sporočila je na voljo v uporabni obliki za izvajanje v .
Vsebina:
1. Učinkovito nalaganje podatkov iz CSV v bazo MonetDB
Podatki v tem tekmovanju niso dostopni kot že pripravljene slike, temveč v obliki 340 CSV-datotek (ena datoteka za vsak razred), ki vsebujejo JSON-e s koordinatami točk. Ko te točke povežemo s črtami, dobimo končno sliko velikosti 256x256 slikovnih pik. Prav tako za vsak vnos navaja oznako, ali je bila slika pravilno prepoznana s strani klasifikatorja, ki je bil uporabljen ob zbiranju podatkov, dvobrko države bivanja avtorja risbe, edinstven identificator, oznako časa in ime razreda, ki se ujema z imenom datoteke. Poenostavljena različica izvornih podatkov tehta 7,4 GB v arhivu in približno 20 GB po razpakiranju, celotni podatki po razpakiranju zasedejo 240 GB. Organizatorji so zagotovili, da obe različici reproducirata iste risbe, kar pomeni, da je polna različica odvečna. V vsakem primeru je bilo shranjevanje 50 milijonov slik v grafičnih datotekah ali v obliki matrik takoj prepoznano kot nerentabilno, in odločili smo se združiti vse CSV-datoteke iz arhiva train_simplified.zip v bazo podatkov s kasnejšo generacijo slik potrebne velikosti «na let» za vsak serijo.
Kot SODB je bila izbrana dobro uveljavljena MonetDB, in particolare l'implementazione per R sotto forma di pacchetto . Il pacchetto include una versione embedded del server di database e consente di avviare il server direttamente dalla sessione R e lavorare con esso. La creazione del database e la connessione vengono eseguite con un solo comando:
con <- DBI::dbConnect(drv = MonetDBLite::MonetDBLite(), Sys.getenv("DBDIR"))Dovremo creare due tabelle: una per tutti i dati e un'altra per le informazioni di servizio sui file caricati (utile se qualcosa va storto e il processo deve essere ripreso dopo il caricamento di alcuni file):
Создание таблиц
if (!DBI::dbExistsTable(con, "doodles")) {
  DBI::dbCreateTable(
    con = con,
    name = "doodles",
    fields = c(
      "countrycode" = "char(2)",
      "drawing" = "text",
      "key_id" = "bigint",
      "recognized" = "bool",
      "timestamp" = "timestamp",
      "word" = "text"
    )
  )
}

if (!DBI::dbExistsTable(con, "upload_log")) {
  DBI::dbCreateTable(
    con = con,
    name = "upload_log",
    fields = c(
      "id" = "serial",
      "file_name" = "text UNIQUE",
      "uploaded" = "bool DEFAULT false"
    )
  )
}
Il modo più veloce per caricare i dati nel database è stato il copia diretta dei file CSV utilizzando SQL — il comando COPY OFFSET 2 INTO tablename FROM path USING DELIMITERS ',','n','"' NULL AS '' BEST EFFORT, gde v definiciji pogleda. — il nome della tabella e path — il percorso del file. Lavorando con l'archivio, è stato scoperto che l'implementazione integrata unzip in R non funziona correttamente con alcuni file dell'archivio, quindi abbiamo utilizzato il sistema unzip (utilizzando il parametro getOption("unzip")).
La funzione per scrivere nel database
#' @title Извлечение и загрузка файлов
#'
#' @description
#' Извлечение CSV-файлов из ZIP-архива и загрузка их в базу данных
#'
#' @param con Объект подключения к базе данных (класс `MonetDBEmbeddedConnection`).
#' @param tablename Название таблицы в базе данных.
#' @oaram zipfile Путь к ZIP-архиву.
#' @oaram filename Имя файла внури ZIP-архива.
#' @param preprocess Функция предобработки, которая будет применена извлечённому файлу.
#'   Должна принимать один аргумент `data` (объект `data.table`).
#'
#' @return `TRUE`.
#'
upload_file <- function(con, tablename, zipfile, filename, preprocess = NULL) {
  # Проверка аргументов
  checkmate::assert_class(con, "MonetDBEmbeddedConnection")
  checkmate::assert_string(tablename)
  checkmate::assert_string(filename)
  checkmate::assert_true(DBI::dbExistsTable(con, tablename))
  checkmate::assert_file_exists(zipfile, access = "r", extension = "zip")
  checkmate::assert_function(preprocess, args = c("data"), null.ok = TRUE)

  # Извлечение файла
  path <- file.path(tempdir(), filename)
  unzip(zipfile, files = filename, exdir = tempdir(),
        junkpaths = TRUE, unzip = getOption("unzip"))
  on.exit(unlink(file.path(path)))

  # Применяем функция предобработки
  if (!is.null(preprocess)) {
    .data <- data.table::fread(file = path)
    .data <- preprocess(data = .data)
    data.table::fwrite(x = .data, file = path, append = FALSE)
    rm(.data)
  }

  # Запрос к БД на импорт CSV
  sql <- sprintf(
    "COPY OFFSET 2 INTO %s FROM '%s' USING DELIMITERS ',','n','"' NULL AS '' BEST EFFORT",
    tablename, path
  )
  # Выполнение запроса к БД
  DBI::dbExecute(con, sql)

  # Добавление записи об успешной загрузке в служебную таблицу
  DBI::dbExecute(con, sprintf("INSERT INTO upload_log(file_name, uploaded) VALUES('%s', true)",
                              filename))

  return(invisible(TRUE))
}
Nel caso in cui sia necessario trasformare la tabella prima di scriverla nel database, è sufficiente passare come argomento preprocess una funzione che trasformerà i dati.
Codice per il caricamento sequenziale dei dati nel database:
Scrivere i dati nel database
# Список файлов для записи
files <- unzip(zipfile, list = TRUE)$Name

# Список исключений, если часть файлов уже была загружена
to_skip <- DBI::dbGetQuery(con, "SELECT file_name FROM upload_log")[[1L]]
files <- setdiff(files, to_skip)

if (length(files) > 0L) {
  # Запускаем таймер
  tictoc::tic()
  # Прогресс бар
  pb <- txtProgressBar(min = 0L, max = length(files), style = 3)
  for (i in seq_along(files)) {
    upload_file(con = con, tablename = "doodles",
                zipfile = zipfile, filename = files[i])
    setTxtProgressBar(pb, i)
  }
  close(pb)
  # Останавливаем таймер
  tictoc::toc()
}

# 526.141 sec elapsed - копирование SSD->SSD
# 558.879 sec elapsed - копирование USB->SSD
Il tempo di caricamento dei dati può variare a seconda delle caratteristiche di velocità del supporto utilizzato. Nel nostro caso, la lettura e la scrittura all'interno di un SSD o da una chiavetta USB (file sorgente) a SSD (DB) richiede meno di 10 minuti.
Altri pochi secondi sono necessari per creare una colonna con l'etichetta della classe intera e una colonna indice (ORDERED INDEX) con i numeri di riga, che sarà utilizzata per la selezione delle osservazioni durante la creazione dei batch:
Creazione di colonne aggiuntive e indice
message("Generare etichette")
invisible(DBI::dbExecute(con, "ALTER TABLE doodles ADD label_int int"))
invisible(DBI::dbExecute(con, "UPDATE doodles SET label_int = dense_rank() OVER (ORDER BY word) - 1"))

message("Generare numeri di riga")
invisible(DBI::dbExecute(con, "ALTER TABLE doodles ADD id serial"))
invisible(DBI::dbExecute(con, "CREATE ORDERED INDEX doodles_id_ord_idx ON doodles(id)"))
Za reševanje naloge oblikovanja serij "v živo" smo morali doseči maksimalno hitrost pridobivanja naključnih vrstic iz tabele. doodles. Za to smo uporabili 3 trike. Prvi je bil zmanjšati dimenzionalnost tipa, v katerem se shranjuje ID opazovanja. V izvorni podatkovni zbirki je za shranjevanje ID potreben tip bigint, vendar število opazovanj omogoča, da se njihovi identifikatorji, ki so enaki zaporedni številki, spravijo v tip int. Iskanje se pri tem precej izboljša. Drugi trik je bila uporaba ORDERED INDEX — do tega rešenja smo prišli empirično, tako da smo preizkusili vse razpoložljive . Tretji je bil uporaba parametrizeanih poizvedb. Osnovna ideja metode je enkratno izvajanje ukaza PREPARE s kasnejšo uporabo pripravljenega izraza pri ustvarjanju serije enotnih poizvedb, vendar se je v praksi dobiček v primerjavi s preprostim SELECT izkazal za statistično napako.
Proces nalaganja podatkov porabi največ 450 MB RAM-a. To pomeni, da omogoča opisani pristop obvladovati podatkovne nize s težo več deset gigabajtov praktično na katerikoli proračunski strojni opremi, vključno z nekaterimi enoslojnimi računalniki, kar je precej kul.
Ostaja še izvesti meritve hitrosti pridobivanja (naključnih) podatkov in oceniti širitev pri izbiri serij različne velikosti:
Benchmark baze podatkov
library(ggplot2)

set.seed(0)
# Povezovanje na bazo podatkov
con <- DBI::dbConnect(MonetDBLite::MonetDBLite(), Sys.getenv("DBDIR"))

# Funkcija za pripravo poizvedbe na strani strežnika
prep_sql <- function(batch_size) {
  sql <- sprintf("PREPARE SELECT id FROM doodles WHERE id IN (%s)",
                 paste(rep("?", batch_size), collapse = ","))
  res <- DBI::dbSendQuery(con, sql)
  return(res)
}

# Funkcija za izčrpavanje podatkov
fetch_data <- function(rs, batch_size) {
  ids <- sample(seq_len(n), batch_size)
  res <- DBI::dbFetch(DBI::dbBind(rs, as.list(ids)))
  return(res)
}

# Izvedba meritev
res_bench <- bench::press(
  batch_size = 2^(4:10),
  {
    rs <- prep_sql(batch_size)
    bench::mark(
      fetch_data(rs, batch_size),
      min_iterations = 50L
    )
  }
)
# Parametri benchmarka
cols <- c("batch_size", "min", "median", "max", "itr/sec", "total_time", "n_itr")
res_bench[, cols]

#   batch_size      min   median      max `itr/sec` total_time n_itr
#
# 1         16   23.6ms  54.02ms  93.43ms     18.8        2.6s    49
# 2         32     38ms  84.83ms 151.55ms     11.4       4.29s    49
# 3         64   63.3ms 175.54ms 248.94ms     5.85       8.54s    50
# 4        128   83.2ms 341.52ms 496.24ms     3.00      16.69s    50
# 5        256  232.8ms 653.21ms 847.44ms     1.58      31.66s    50
# 6        512  784.6ms    1.41s    1.98s     0.740       1.1m    49
# 7       1024  681.7ms    2.72s    4.06s     0.377      2.16m    49

ggplot(res_bench, aes(x = factor(batch_size), y = median, group = 1)) +
  geom_point() +
  geom_line() +
  ylab("median time, s") +
  theme_minimal()

DBI::dbDisconnect(con, shutdown = TRUE) 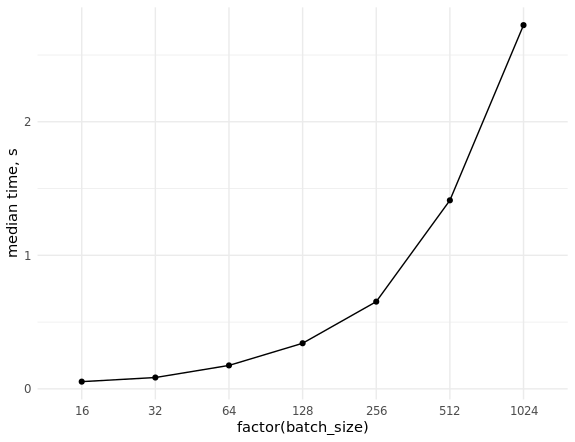
2. Priprava serij
Celoten proces priprave serij obsega naslednje faze:
- Parsanje več JSON-ov, ki vsebujejo vektorje nizov s koordinatami točk.
- Narisi barvne črte po koordinatah točk na sliki potrebne velikosti (na primer, 256×256 ali 128×128).
- Pretvorba pridobljenih slik v tenzor.
V okviru tekmovanja med kernel-i v Pythonu je bila naloga reševana predvsem z orodji OpenCV. Eden najbolj preprostih in očitnih analogov v R bi izgledal takole:
Izvedba pretvorbe JSON v tenzor v R
r_process_json_str <- function(json, line.width = 3,
                               color = TRUE, scale = 1) {
  # Parsing JSON
  coords <- jsonlite::fromJSON(json, simplifyMatrix = FALSE)
  tmp <- tempfile()
  # Deleting the temporary file after function completion
  on.exit(unlink(tmp))
  png(filename = tmp, width = 256 * scale, height = 256 * scale, pointsize = 1)
  # Empty plot
  plot.new()
  # Plot window size
  plot.window(xlim = c(256 * scale, 0), ylim = c(256 * scale, 0))
  # Line colors
  cols <- if (color) rainbow(length(coords)) else "#000000"
  for (i in seq_along(coords)) {
    lines(x = coords[[i]][[1]] * scale, y = coords[[i]][[2]] * scale,
          col = cols[i], lwd = line.width)
  }
  dev.off()
  # Convert image to a 3D array
  res <- png::readPNG(tmp)
  return(res)
}

r_process_json_vector <- function(x, ...) {
  res <- lapply(x, r_process_json_str, ...)
  # Merging 3D image arrays into a 4D tensor
  res <- do.call(abind::abind, c(res, along = 0))
  return(res)
}
Drawing is performed using standard R tools, saving to a temporary PNG stored in RAM (in Linux, R's temporary directories are located in a directory /tmp, mounted in RAM). Then this file is read as a 3D array with values ranging from 0 to 1. This is important, as a more commonly used BMP would be read as a raw array with hex color codes.
Let's test the result:
zip_file <- file.path("data", "train_simplified.zip")
csv_file <- "cat.csv"
unzip(zip_file, files = csv_file, exdir = tempdir(),
      junkpaths = TRUE, unzip = getOption("unzip"))
tmp_data <- data.table::fread(file.path(tempdir(), csv_file), sep = ",",
                              select = "drawing", nrows = 10000)
arr <- r_process_json_str(tmp_data[4, drawing])
dim(arr)
# [1] 256 256   3
plot(magick::image_read(arr)) 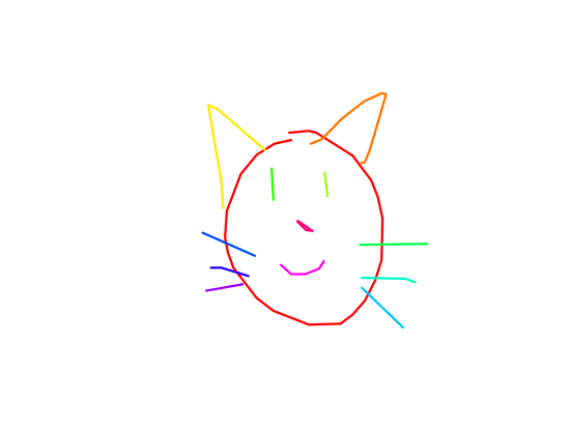
The batch will be formed as follows:
res <- r_process_json_vector(tmp_data[1:4, drawing], scale = 0.5)
str(res)
 # num [1:4, 1:128, 1:128, 1:3] 1 1 1 1 1 1 1 1 1 1 ...
 # - attr(*, "dimnames")=List of 4
 #  ..$ : NULL
 #  ..$ : NULL
 #  ..$ : NULL
 #  ..$ : NULL
This implementation seemed suboptimal to us, as forming large batches takes an unacceptably long time, and we decided to draw on the experience of our colleagues, using a powerful library OpenCV. At that time, there was no ready-to-use package for R (and there isn't one now), so a minimal implementation of the required functionality was written in C++ with integration into the R code using Rcpp.
The following packages and libraries were used to solve the task:
OpenCV for working with images and drawing lines. We used pre-installed system libraries and header files, as well as dynamic linking.
xtensor za delo z večdimenzionalnimi poli in tenzorji. Uporabili smo glave, vključene v istoimenski R-paket. Knjižnica omogoča delo z večdimenzionalnimi poli tako v vrstnem redu vrstic (row major) kot v vrstnem redu stolpcev (column major).
ndjson za razčlenjevanje JSON-a. Ta knjižnica se uporablja v xtensor samodejno, če je prisotna v projektu.
RcppThread za organizacijo večnitnega obdelovanja vektorja iz JSON-ov. Uporabili smo glave, ki jih ponuja ta paket. Od bolj priljubljenega RcppParallel paket med drugim odlikuje vgrajeni mehanizem za prekinitev zanke (interrupt).
Je třeba poznamenat, že xtensor se je izkazal kot pravi zaklad: poleg tega, da ima široko funkcionalnost in visoko učinkovitost, so se njegovi razvijalci izkazali za zelo odzivne in hitro ter podrobno odgovarjali na vprašanja. Z njihovo pomočjo je bilo mogoče izvesti pretvorbe matric OpenCV v tenzorje xtensor ter način združevanja 3-dimenzionalnih tenzorjev slik v 4-dimenzionalni tenzor pravilne velikosti (dejansko paket).
Gradiva za študij Rcpp, xtensor in RcppThread
Za kompilacijo datotek, ki uporabljajo sistemske datoteke in dinamično povezovanje z nameščenimi knjižnicami v sistemu, smo uporabili mehanizem vtičnikov, realiziran v paketu Rcpp. Za samodejno iskanje poti in zastavic smo uporabili priljubljeno linux orodje pkg-config.
Izvedba Rcpp vtičnika za uporabo knjižnice OpenCV
Rcpp::registerPlugin("opencv", function() {
  # Možna imena paketa
  pkg_config_name <- c("opencv", "opencv4")
  # Izvršna datoteka orodja pkg-config
  pkg_config_bin <- Sys.which("pkg-config")
  # Preverjanje prisotnosti orodja v sistemu
  checkmate::assert_file_exists(pkg_config_bin, access = "x")
  # Preverjanje prisotnosti konfiguracijske datoteke OpenCV za pkg-config
  check <- sapply(pkg_config_name,
                  function(pkg) system(paste(pkg_config_bin, pkg)))
  if (all(check != 0)) {
    stop("OpenCV config for the pkg-config not found", call. = FALSE)
  }

  pkg_config_name <- pkg_config_name[check == 0]
  list(env = list(
    PKG_CXXFLAGS = system(paste(pkg_config_bin, "--cflags", pkg_config_name),
                          intern = TRUE),
    PKG_LIBS = system(paste(pkg_config_bin, "--libs", pkg_config_name),
                      intern = TRUE)
  ))
})
Kot rezultat dela vtičnika bodo v procesu kompilacije vnešene naslednje vrednosti:
Rcpp:::.plugins$opencv()$env

# $PKG_CXXFLAGS
# [1] "-I/usr/include/opencv"
#
# $PKG_LIBS
# [1] "-lopencv_shape -lopencv_stitching -lopencv_superres -lopencv_videostab -lopencv_aruco -lopencv_bgsegm -lopencv_bioinspired -lopencv_ccalib -lopencv_datasets -lopencv_dpm -lopencv_face -lopencv_freetype -lopencv_fuzzy -lopencv_hdf -lopencv_line_descriptor -lopencv_optflow -lopencv_video -lopencv_plot -lopencv_reg -lopencv_saliency -lopencv_stereo -lopencv_structured_light -lopencv_phase_unwrapping -lopencv_rgbd -lopencv_viz -lopencv_surface_matching -lopencv_text -lopencv_ximgproc -lopencv_calib3d -lopencv_features2d -lopencv_flann -lopencv_xobjdetect -lopencv_objdetect -lopencv_ml -lopencv_xphoto -lopencv_highgui -lopencv_videoio -lopencv_imgcodecs -lopencv_photo -lopencv_imgproc -lopencv_core"
Кód для реализации парсинга JSON и формирования батча для передачи в модель приведён под спойлером. Предварительно добавляем локальную директорию проекта для поиска заголовочных файлов (это необходимо для ndjson):
Sys.setenv("PKG_CXXFLAGS" = paste0("-I", normalizePath(file.path("src"))))Реализация преобразования JSON в тензор на С++
// [[Rcpp::plugins(cpp14)]]
// [[Rcpp::plugins(opencv)]]
// [[Rcpp::depends(xtensor)]]
// [[Rcpp::depends(RcppThread)]]

#include <xtensor/xjson.hpp>
#include <xtensor/xadapt.hpp>
#include <xtensor/xview.hpp>
#include <xtensor-r/rtensor.hpp>
#include <opencv2/core/core.hpp>
#include <opencv2/highgui/highgui.hpp>
#include <opencv2/imgproc/imgproc.hpp>
#include <Rcpp.h>
#include <RcppThread.h>

// Синонимы для типов
using RcppThread::parallelFor;
using json = nlohmann::json;
using points = xt::xtensor<double,2>;     // Извлечённые из JSON координаты точек
using strokes = std::vector<points>;      // Извлечённые из JSON координаты точек
using xtensor3d = xt::xtensor<double, 3>; // Тензор для хранения матрицы изоображения
using xtensor4d = xt::xtensor<double, 4>; // Тензор для хранения множества изображений
using rtensor3d = xt::rtensor<double, 3>; // Обёртка для экспорта в R
using rtensor4d = xt::rtensor<double, 4>; // Обёртка для экспорта в R

// Статические константы
// Размер изображения в пикселях
const static int SIZE = 256;
// Тип линии
// См. https://en.wikipedia.org/wiki/Pixel_connectivity#2-dimensional
const static int LINE_TYPE = cv::LINE_4;
// Толщина линии в пикселях
const static int LINE_WIDTH = 3;
// Алгоритм ресайза
// https://docs.opencv.org/3.1.0/da/d54/group__imgproc__transform.html#ga5bb5a1fea74ea38e1a5445ca803ff121
const static int RESIZE_TYPE = cv::INTER_LINEAR;

// Шаблон для конвертирования OpenCV-матрицы в тензор
template <typename T, int NCH, typename XT=xt::xtensor<T,3,xt::layout_type::column_major>>
XT to_xt(const cv::Mat_<cv::Vec<T, NCH>>& src) {
  // Размерность целевого тензора
  std::vector<int> shape = {src.rows, src.cols, NCH};
  // Общее количество элементов в массиве
  size_t size = src.total() * NCH;
  // Преобразование cv::Mat в xt::xtensor
  XT res = xt::adapt((T*) src.data, size, xt::no_ownership(), shape);
  return res;
}

// Преобразование JSON в список координат точек
strokes parse_json(const std::string& x) {
  auto j = json::parse(x);
  // Результат парсинга должен быть массивом
  if (!j.is_array()) {
    throw std::runtime_error("'x' must be JSON array.");
  }
  strokes res;
  res.reserve(j.size());
  for (const auto& a: j) {
    // Каждый элемент массива должен быть 2-мерным массивом
    if (!a.is_array() || a.size() != 2) {
      throw std::runtime_error("'x' must include only 2d arrays.");
    }
    // Извлечение вектора точек
    auto p = a.get<points>();
    res.push_back(p);
  }
  return res;
}

// Отрисовка линий
// Цвета HSV
cv::Mat ocv_draw_lines(const strokes& x, bool color = true) {
  // Исходный тип матрицы
  auto stype = color ? CV_8UC3 : CV_8UC1;
  // Итоговый тип матрицы
  auto dtype = color ? CV_32FC3 : CV_32FC1;
  auto bg = color ? cv::Scalar(0, 0, 255) : cv::Scalar(255);
  auto col = color ? cv::Scalar(0, 255, 220) : cv::Scalar(0);
  cv::Mat img = cv::Mat(SIZE, SIZE, stype, bg);
  // Количество линий
  size_t n = x.size();
  for (const auto& s: x) {
    // Количество точек в линии
    size_t n_points = s.shape()[1];
    for (size_t i = 0; i < n_points - 1; ++i) {
      // Точка начала штриха
      cv::Point from(s(0, i), s(1, i));
      // Точка окончания штриха
      cv::Point to(s(0, i + 1), s(1, i + 1));
      // Отрисовка линии
      cv::line(img, from, to, col, LINE_WIDTH, LINE_TYPE);
    }
    if (color) {
      // Меняем цвет линии
      col[0] += 180 / n;
    }
  }
  if (color) {
    // Меняем цветовое представление на RGB
    cv::cvtColor(img, img, cv::COLOR_HSV2RGB);
  }
  // Меняем формат представления на float32 с диапазоном [0, 1]
  img.convertTo(img, dtype, 1 / 255.0);
  return img;
}

// Обработка JSON и получение тензора с данными изображения
xtensor3d process(const std::string& x, double scale = 1.0, bool color = true) {
  auto p = parse_json(x);
  auto img = ocv_draw_lines(p, color);
  if (scale != 1) {
    cv::Mat out;
    cv::resize(img, out, cv::Size(), scale, scale, RESIZE_TYPE);
    cv::swap(img, out);
    out.release();
  }
  xtensor3d arr = color ? to_xt<double,3>(img) : to_xt<double,1>(img);
  return arr;
}

// [[Rcpp::export]]
rtensor3d cpp_process_json_str(const std::string& x,
                               double scale = 1.0,
                               bool color = true) {
  xtensor3d res = process(x, scale, color);
  return res;
}

// [[Rcpp::export]]
rtensor4d cpp_process_json_vector(const std::vector<std::string>& x,
                                  double scale = 1.0,
                                  bool color = false) {
  size_t n = x.size();
  size_t dim = floor(SIZE * scale);
  size_t channels = color ? 3 : 1;
  xtensor4d res({n, dim, dim, channels});
  parallelFor(0, n, [&x, &res, scale, color](int i) {
    xtensor3d tmp = process(x[i], scale, color);
    auto view = xt::view(res, i, xt::all(), xt::all(), xt::all());
    view = tmp;
  });
  return res;
}
Этот код следует поместить в файл src/cv_xt.cpp и скомпилировать командой Rcpp::sourceCpp(file = "src/cv_xt.cpp", env = .GlobalEnv); также для работы потребуется nlohmann/json.hpp iz . Код разделён на несколько функций:
to_xt— шаблонизированная функция для преобразования матрицы изображения (cv::Mat) в тензорxt::xtensor;parse_json— функция парсит JSON-строку, извлекает координаты точек, упаковывая их в вектор;ocv_draw_lines— из полученного вектора точек отрисовывает разноцветные линии;proces— объединяет вышеописанные функции, а также добавляет возможность шкалирования полученного изображения;cpp_process_json_str— обёртка над функциейproces, которая экспортирует результат в R-объект (многомерный массив);cpp_process_json_vector— обёртка над функциейcpp_process_json_str, которая позволяет обрабатывать строковый вектор в многопоточном режиме.
Для отрисовки разноцветных линий использовалась цветовая модель HSV с последующей конвертацией в RGB. Протестируем результат:
arr <- cpp_process_json_str(tmp_data[4, drawing])
dim(arr)
# [1] 256 256   3
plot(magick::image_read(arr)) 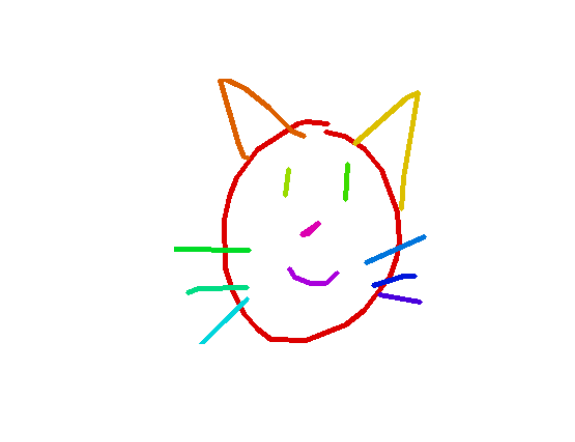
Сравнение скорости работы реализаций на R и С++
res_bench <- bench::mark(
  r_process_json_str(tmp_data[4, drawing], scale = 0.5),
  cpp_process_json_str(tmp_data[4, drawing], scale = 0.5),
  check = FALSE,
  min_iterations = 100
)
# Параметры бенчмарка
cols <- c("expression", "min", "median", "max", "itr/sec", "total_time", "n_itr")
res_bench[, cols]

#   expression                min     median       max `itr/sec` total_time  n_itr
#
# 1 r_process_json_str     3.49ms     3.55ms    4.47ms      273.      490ms    134
# 2 cpp_process_json_str   1.94ms     2.02ms    5.32ms      489.      497ms    243

library(ggplot2)
# Проведение замера
res_bench <- bench::press(
  batch_size = 2^(4:10),
  {
    .data <- tmp_data[sample(seq_len(.N), batch_size), drawing]
    bench::mark(
      r_process_json_vector(.data, scale = 0.5),
      cpp_process_json_vector(.data,  scale = 0.5),
      min_iterations = 50,
      check = FALSE
    )
  }
)

res_bench[, cols]

#    expression   batch_size      min   median      max `itr/sec` total_time n_itr
#                  <bch:tm> <bch:tm> <bch:tm>     <dbl>   <bch:tm> <int>
#  1 r                   16   50.61ms  53.34ms  54.82ms    19.1     471.13ms     9
#  2 cpp                 16    4.46ms   5.39ms   7.78ms   192.      474.09ms    91
#  3 r                   32   105.7ms 109.74ms 212.26ms     7.69        6.5s    50
#  4 cpp                 32    7.76ms  10.97ms  15.23ms    95.6     522.78ms    50
#  5 r                   64  211.41ms 226.18ms 332.65ms     3.85      12.99s    50
#  6 cpp                 64   25.09ms  27.34ms  32.04ms    36.0        1.39s    50
#  7 r                  128   534.5ms 627.92ms 659.08ms     1.61      31.03s    50
#  8 cpp                128   56.37ms  58.46ms  66.03ms    16.9        2.95s    50
#  9 r                  256     1.15s    1.18s    1.29s     0.851     58.78s    50
# 10 cpp                256  114.97ms 117.39ms 130.09ms     8.45       5.92s    50
# 11 r                  512     2.09s    2.15s    2.32s     0.463       1.8m    50
# 12 cpp                512  230.81ms  235.6ms 261.99ms     4.18      11.97s    50
# 13 r                 1024        4s    4.22s     4.4s     0.238       3.5m    50
# 14 cpp               1024  410.48ms 431.43ms 462.44ms     2.33      21.45s    50

ggplot(res_bench, aes(x = factor(batch_size), y = median,
                      group =  expression, color = expression)) +
  geom_point() +
  geom_line() +
  ylab("median time, s") +
  theme_minimal() +
  scale_color_discrete(name = "", labels = c("cpp", "r")) +
theme(legend.position = "bottom") 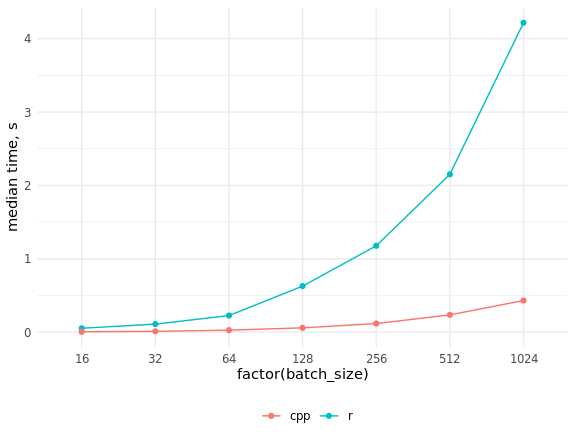
Kot vidimo, izboljšanje hitrosti je bilo zelo pomembno, in ne moremo dohiteti kode C++ s paralelizacijo kode R.
3. Iteratorji za izvoz paketov iz Baze podatkov
R ima zasluženu reputaciju jezika za obradu podataka koji se nalaze u RAM-u, dok Python karakteriše iterativna obrada podataka, koja omogućava lako i bez napora sprovođenje out-of-core izračunavanja (izračunavanja koristeći spoljašnju memoriju). Klasičan i relevantan primer takvih izračunavanja, u kontekstu opisane zadatke, su duboke neuronske mreže, obučene metodom gradijentnog spuštanja sa aproksimacijom gradijenta na svakom koraku koristeći mali deo opažanja ili mini-batch.
Okviri za duboko učenje napisani na Python-u imaju posebne klase koje implementiraju iteratore po podacima: tabelama, slikama u fasciklama, binarnim formatima itd. Možete koristiti gotove opcije ili pisati sopstvene za specifične zadatke. U R-u možemo iskoristiti sve mogućnosti Pythonske biblioteke keras sa njegovim raznim backend-ovima pomoću istoimenog paketa, koji opet radi preko paketa reticulatePoslednji zaslužuje posebno veliko poglavlje; ne samo da omogućava pokretanje koda na Python-u iz R-a, već i prenosi objekte između R- i Python sesija, automatski izvršavajući sve potrebne promene tipova.
Oslobodili smo se potrebe da sve podatke čuvamo u RAM-u koristeći MonetDBLite, sav 'neuronski' rad će obavljati originalni kod na Python-u, a nama preostaje samo da napišemo iterator po podacima, pošto ne postoji gotov za ovu situaciju ni u R-u ni u Python-u. Zahtevi za njega su u suštini samo dva: treba da vraća batch-ove u beskonačnoj petlji i da čuva svoje stanje između iteracija (to se u R-u jednostavno ostvaruje pomoću zatvaranja). Ranije je bilo potrebno unutar iteratora eksplicitno pretvarati R-ove nizove u numpy nizove, ali aktuelna verzija paketa keras to radi sama.
Iterator za obučavajuće i validacione podatke ispao je sledeći:
Iterator za obučavajuće i validacione podatke
train_generator <- function(db_connection = con,
                            samples_index,
                            num_classes = 340,
                            batch_size = 32,
                            scale = 1,
                            color = FALSE,
                            imagenet_preproc = FALSE) {
  # Проверка аргументов
  checkmate::assert_class(con, "DBIConnection")
  checkmate::assert_integerish(samples_index)
  checkmate::assert_count(num_classes)
  checkmate::assert_count(batch_size)
  checkmate::assert_number(scale, lower = 0.001, upper = 5)
  checkmate::assert_flag(color)
  checkmate::assert_flag(imagenet_preproc)

  # Перемешиваем, чтобы брать и удалять использованные индексы батчей по порядку
  dt <- data.table::data.table(id = sample(samples_index))
  # Проставляем номера батчей
  dt[, batch := (.I - 1L) %/% batch_size + 1L]
  # Оставляем только полные батчи и индексируем
  dt <- dt[, if (.N == batch_size) .SD, keyby = batch]
  # Устанавливаем счётчик
  i <- 1
  # Количество батчей
  max_i <- dt[, max(batch)]

  # Подготовка выражения для выгрузки
  sql <- sprintf(
    "PREPARE SELECT drawing, label_int FROM doodles WHERE id IN (%s)",
    paste(rep("?", batch_size), collapse = ",")
  )
  res <- DBI::dbSendQuery(con, sql)

  # Аналог keras::to_categorical
  to_categorical <- function(x, num) {
    n <- length(x)
    m <- numeric(n * num)
    m[x * n + seq_len(n)] <- 1
    dim(m) <- c(n, num)
    return(m)
  }

  # Замыкание
  function() {
    # Начинаем новую эпоху
    if (i > max_i) {
      dt[, id := sample(id)]
      data.table::setkey(dt, batch)
      # Сбрасываем счётчик
      i <<- 1
      max_i <<- dt[, max(batch)]
    }

    # ID для выгрузки данных
    batch_ind <- dt[batch == i, id]
    # Выгрузка данных
    batch <- DBI::dbFetch(DBI::dbBind(res, as.list(batch_ind)), n = -1)

    # Увеличиваем счётчик
    i <<- i + 1

    # Парсинг JSON и подготовка массива
    batch_x <- cpp_process_json_vector(batch$drawing, scale = scale, color = color)
    if (imagenet_preproc) {
      # Шкалирование c интервала [0, 1] на интервал [-1, 1]
      batch_x <- (batch_x - 0.5) * 2
    }

    batch_y <- to_categorical(batch$label_int, num_classes)
    result <- list(batch_x, batch_y)
    return(result)
  }
}
Funkcija prima na ulazu varijablu sa vezom na Bazu podataka, brojeve koji se koriste redovima, broj klasa, veličinu batch-a, skalu (scale = 1 odgovara crtanju slika 256x256 piksela, scale = 0.5 — 128x128 piksela), indikator koloracije (color = FALSE postavlja crtanje u nijansama sive, prilikom korišćenja barva = TRUE vsaka poteza se nariše z novo barvo) in indikator predobdelave za omrežja, predhodno usposobljena na imagenet. Ta je potrebna za preoblikovanje vrednosti pikslov z intervala [0, 1] na interval [-1, 1], ki se je uporabljal med usposabljanjem dobavljenih modelov. keras modelov.
Zunanja funkcija vsebuje preverjanje tipov argumentov, tabelo data.table z naključno premešanimi številkami vrstic iz samples_index in številke serij, števec in največje število serij ter SQL izraz za izvoz podatkov iz baze podatkov. Dodatno smo določili znotraj hitrih analogov funkcije keras::to_categorical(). Za usposabljanje smo uporabili skoraj vse podatke in pustili pol odstotka za validacijo, zato je bila velikost epohe omejena s parametrom steps_per_epoch pri klicu keras::fit_generator(), in pogoj if (i > max_i) je veljal le za validacijski iterator.
V notranji funkciji se izvede izbira indeksov vrstic za naslednjo serijo, izvoz zapisov iz baze podatkov z povečanjem števca serij, analiziranje JSON-ov (funkcija cpp_process_json_vector(), napisana v C++) in ustvarjanje tabel, ki ustrezajo slikam. Nato se ustvarijo one-hot vektorji z oznakami razredov, tabelami z vrednostmi pikslov in oznakami se združijo v seznam, ki je vrnjena vrednost. Za pospešitev delovanja je bilo uporabljeno ustvarjanje indeksov v tabelah data.table in modificiranje po referenci - brez teh 'trikov' paketa data.table je precej težko predstavljati učinkovito delo z večjimi količinami podatkov v R.
Rezultati meritev hitrosti delovanja na prenosniku Core i5 so videti takole:
Benchmark iteratorja
library(Rcpp)
library(keras)
library(ggplot2)

source("utils/rcpp.R")
source("utils/keras_iterator.R")

con <- DBI::dbConnect(drv = MonetDBLite::MonetDBLite(), Sys.getenv("DBDIR"))

ind <- seq_len(DBI::dbGetQuery(con, "SELECT count(*) FROM doodles")[[1L]])
num_classes <- DBI::dbGetQuery(con, "SELECT max(label_int) + 1 FROM doodles")[[1L]]

# Индексы для обучающей выборки
train_ind <- sample(ind, floor(length(ind) * 0.995))
# Индексы для проверочной выборки
val_ind <- ind[-train_ind]
rm(ind)
# Коэффициент масштаба
scale <- 0.5

# Проведение замера
res_bench <- bench::press(
  batch_size = 2^(4:10),
  {
    it1 <- train_generator(
      db_connection = con,
      samples_index = train_ind,
      num_classes = num_classes,
      batch_size = batch_size,
      scale = scale
    )
    bench::mark(
      it1(),
      min_iterations = 50L
    )
  }
)
# Параметры бенчмарка
cols <- c("batch_size", "min", "median", "max", "itr/sec", "total_time", "n_itr")
res_bench[, cols]

#   batch_size      min   median      max `itr/sec` total_time n_itr
#
# 1         16     25ms  64.36ms   92.2ms     15.9       3.09s    49
# 2         32   48.4ms 118.13ms 197.24ms     8.17       5.88s    48
# 3         64   69.3ms 117.93ms 181.14ms     8.57       5.83s    50
# 4        128  157.2ms 240.74ms 503.87ms     3.85      12.71s    49
# 5        256  359.3ms 613.52ms 988.73ms     1.54       30.5s    47
# 6        512  884.7ms    1.53s    2.07s     0.674      1.11m    45
# 7       1024     2.7s    3.83s    5.47s     0.261      2.81m    44

ggplot(res_bench, aes(x = factor(batch_size), y = median, group = 1)) +
    geom_point() +
    geom_line() +
    ylab("median time, s") +
    theme_minimal()

DBI::dbDisconnect(con, shutdown = TRUE) 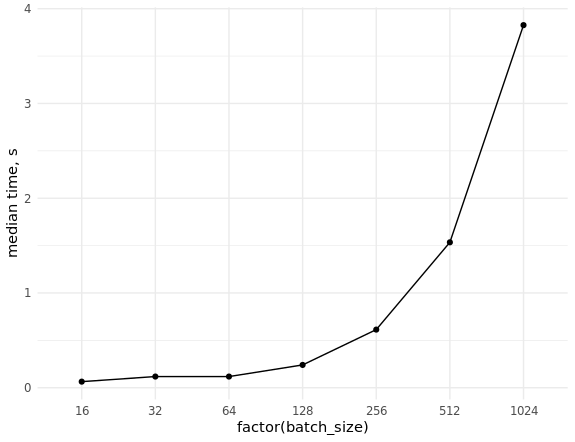
Če je dovolj RAM-a, je mogoče znatno pospešiti delovanje baze podatkov s prenosom vanj (za našo nalogo zadostuje 32 GB). V Linuxu se privzeto montira particija /dev/shm, ki zavzema do polovice prostornine RAM-a. Lahko pa dodelite tudi več, tako da uredite /etc/fstab, tako da dobite zapis v obliki tmpfs /dev/shm tmpfs defaults,size=25g 0 0. Obvezno se znova zaženite in preverite rezultat z ukazom df -h.
Iterator za testne podatke izgleda veliko preprosto, saj se celoten testni nabor podatkov shrani v RAM:
Iterator za testne podatke
test_generator <- function(dt,
                           batch_size = 32,
                           scale = 1,
                           color = FALSE,
                           imagenet_preproc = FALSE) {

  # Проверка аргументов
  checkmate::assert_data_table(dt)
  checkmate::assert_count(batch_size)
  checkmate::assert_number(scale, lower = 0.001, upper = 5)
  checkmate::assert_flag(color)
  checkmate::assert_flag(imagenet_preproc)

  # Проставляем номера батчей
  dt[, batch := (.I - 1L) %/% batch_size + 1L]
  data.table::setkey(dt, batch)
  i <- 1
  max_i <- dt[, max(batch)]

  # Замыкание
  function() {
    batch_x <- cpp_process_json_vector(dt[batch == i, drawing],
                                       scale = scale, color = color)
    if (imagenet_preproc) {
      # Шкалирование c интервала [0, 1] на интервал [-1, 1]
      batch_x <- (batch_x - 0.5) * 2
    }
    result <- list(batch_x)
    i <<- i + 1
    return(result)
  }
}
4. Izbira arhitekture modela
Prva iz uporabljenih arhitektur je bila , za katero so značilnosti opisane v sporočilu. Na voljo je v standardni dostavi, keras in torej dostopna v istoimenskem paketu za R. Vendar se je ob poskusu uporabe z enokanálnimi slikami pojavila čudna težava: vhodni tenzor mora vedno imeti dimenzije (batch, height, width, 3), to je pomeni, da število kanalov ni mogoče spremeniti. V Pythonu ni tovrstnih omejitev, zato smo se hitro lotili in napisali svojo implementacijo te arhitekture, ki sledi izvirnemu članku (brez dropout-a, ki je v različici keras):
Arhitektura mobilenet v1
library(keras)

top_3_categorical_accuracy <- custom_metric(
    name = "top_3_categorical_accuracy",
    metric_fn = function(y_true, y_pred) {
         metric_top_k_categorical_accuracy(y_true, y_pred, k = 3)
    }
)

layer_sep_conv_bn %
  layer_batch_normalization() %>%
  layer_activation_relu() %>%
  layer_conv_2d(
    filters = filters * alpha,
    kernel_size = c(1, 1),
    strides = c(1, 1)
  ) %>%
  layer_batch_normalization() %>%
  layer_activation_relu()
}

get_mobilenet_v1 <- function(input_shape = c(224, 224, 1),
                             num_classes = 340,
                             alpha = 1,
                             depth_multiplier = 1,
                             optimizer = optimizer_adam(lr = 0.002),
                             loss = "categorical_crossentropy",
                             metrics = c("categorical_crossentropy",
                                         top_3_categorical_accuracy)) {

  inputs <- layer_input(shape = input_shape)

  outputs %
    layer_conv_2d(filters = 32, kernel_size = c(3, 3), strides = c(2, 2), padding = "same") %>%
    layer_batch_normalization() %>%
    layer_activation_relu() %>%
    layer_sep_conv_bn(filters = 64, strides = c(1, 1)) %>%
    layer_sep_conv_bn(filters = 128, strides = c(2, 2)) %>%
    layer_sep_conv_bn(filters = 128, strides = c(1, 1)) %>%
    layer_sep_conv_bn(filters = 256, strides = c(2, 2)) %>%
    layer_sep_conv_bn(filters = 256, strides = c(1, 1)) %>%
    layer_sep_conv_bn(filters = 512, strides = c(2, 2)) %>%
    layer_sep_conv_bn(filters = 512, strides = c(1, 1)) %>%
    layer_sep_conv_bn(filters = 512, strides = c(1, 1)) %>%
    layer_sep_conv_bn(filters = 512, strides = c(1, 1)) %>%
    layer_sep_conv_bn(filters = 512, strides = c(1, 1)) %>%
    layer_sep_conv_bn(filters = 512, strides = c(1, 1)) %>%
    layer_sep_conv_bn(filters = 1024, strides = c(2, 2)) %>%
    layer_sep_conv_bn(filters = 1024, strides = c(1, 1)) %>%
    layer_global_average_pooling_2d() %>%
    layer_dense(units = num_classes) %>%
    layer_activation_softmax()

    model % compile(
      optimizer = optimizer,
      loss = loss,
      metrics = metrics
    )

    return(model)
}
Pomanjkljivosti takšnega pristopa so očitne. Veliko modelov bi želeli preveriti, prepisovanje vsake arhitekture ročno pa ni privlačno. Prav tako smo bili prikrajšani za priložnost uporabe teže modelov, predhodno usposobljenih na imagenetu. Kot običajno je pomagalo študiranje dokumentacije. Funkcija get_config() omogoča pridobitev opisa modela v obliki, primerni za ureditev (base_model_conf$layers — обычный R-овский список), а функция from_config() выполняет обратное преобразование в модельный объект:
base_model_conf <- get_config(base_model)
base_model_conf$layers[[1]]$config$batch_input_shape[[4]] <- 1L
base_model <- from_config(base_model_conf)
Теперь не составляет труда написать универсальную функцию для получения любой из поставляемых в составе keras моделей с обученными на imagenet-е весами или без них:
Функция для загрузки готовых архитектур
get_model <- function(name = "mobilenet_v2",
                      input_shape = NULL,
                      weights = "imagenet",
                      pooling = "avg",
                      num_classes = NULL,
                      optimizer = keras::optimizer_adam(lr = 0.002),
                      loss = "categorical_crossentropy",
                      metrics = NULL,
                      color = TRUE,
                      compile = FALSE) {
  # Проверка аргументов
  checkmate::assert_string(name)
  checkmate::assert_integerish(input_shape, lower = 1, upper = 256, len = 3)
  checkmate::assert_count(num_classes)
  checkmate::assert_flag(color)
  checkmate::assert_flag(compile)

  # Получаем объект из пакета keras
  model_fun <- get0(paste0("application_", name), envir = asNamespace("keras"))
  # Проверка наличия объекта в пакете
  if (is.null(model_fun)) {
    stop("Model ", shQuote(name), " not found.", call. = FALSE)
  }

  base_model <- model_fun(
    input_shape = input_shape,
    include_top = FALSE,
    weights = weights,
    pooling = pooling
  )

  # Если изображение не цветное, меняем размерность входа
  if (!color) {
    base_model_conf <- keras::get_config(base_model)
    base_model_conf$layers[[1]]$config$batch_input_shape[[4]] <- 1L
    base_model <- keras::from_config(base_model_conf)
  }

  predictions <- keras::get_layer(base_model, "global_average_pooling2d_1")$output
  predictions <- keras::layer_dense(predictions, units = num_classes, activation = "softmax")
  model <- keras::keras_model(
    inputs = base_model$input,
    outputs = predictions
  )

  if (compile) {
    keras::compile(
      object = model,
      optimizer = optimizer,
      loss = loss,
      metrics = metrics
    )
  }

  return(model)
}
При использовании одноканальных изображений предобученные веса не используются. Это можно было бы исправить: при помощи функции get_weights() получить веса модели в виде списка из R-овских массивов, изменить размерность первого элемента этого списка (взяв какой-то один цветовой канал или усреднив все три), а затем загрузить веса обратно в модель функцией set_weights(). Мы этот функционал так и не добавили, поскольку на этом этапе уже было понятно, что продуктивнее работать с цветными картинками.
Večino poskusov smo izvedli z uporabo mobilenet različic 1 in 2 ter resnet34. V tem tekmovanju so se dobro izkazale sodobnejše arhitekture, kot je SE-ResNeXt. Na žalost nimamo pripravljenih implementacij, naše pa še nismo napisali (ampak jih bomo zagotovo).
5. Parametrizacija skriptov
Za lažjo uporabo je bil celoten koda za zagon usposabljanja oblikovana kot en sam skript, parametriziran z uporabo takole:
doc <- '
Uporaba:
  train_nn.R --help
  train_nn.R --list-models
  train_nn.R [možnosti]

Možnosti:
  -h --help                   Prikaže to sporočilo.
  -l --list-models            Seznam razpoložljivih modelov.
  -m --model=          Ime modela nevralne mreže [privzeto: mobilenet_v2].
  -b --batch-size=      Velikost paketa [privzeto: 32].
  -s --scale-factor=   Faktor skale [privzeto: 0.5].
  -c --color                  Uporabi barvne črte [privzeto: FALSE].
  -d --db-dir=          Pot do imenika baze podatkov [privzeto: Sys.getenv("db_dir")].
  -r --validate-ratio= Razmer vzorca za validacijo [privzeto: 0.995].
  -n --n-gpu=         Število GPU-jev [privzeto: 1].
'
args <- docopt::docopt(doc)
Package docopt predstavlja izvedbo za R. S pomočjo tega se skripti zaženejo s preprostimi ukazi, kot je Rscript bin/train_nn.R -m resnet50 -c -d /home/andrey/doodle_db ili ./bin/train_nn.R -m resnet50 -c -d /home/andrey/doodle_db, če je datoteka train_nn.R izvedljiva (ta ukaz bo zagnal učenje modela resnet50 na barvnih slikah velikosti 128x128 pikslov, baza podatkov mora biti v mapi /home/andrey/doodle_db). Na seznam lahko dodate hitrost učenja, tip optimizatorja in druge prilagodljive parametre. Med pripravo objave se je izkazalo, da arhitekturo mobilenet_v2 iz aktualne različice keras v R uporabljati zaradi neupoštevanih sprememb v R-paketih — čakamo, da to popravijo.
Ta pristop je omogočil znatno pospešitev eksperimentov z različnimi modeli v primerjavi s tradicionalnejšim zagonjem skriptov v RStudiju (kot možno alternativno omenjamo paket ). Glavna prednost pa je možnost enostavnega upravljanja z zagonom skriptov v Dockerju ali preprosto na strežniku, brez namestitve RStudia.
6. Dockerizacija skriptov
Uporabljali smo Docker z namenom zagotavljanja prenosljivosti okolja za usposabljanje modelov med člani ekipe in za hitro uvajanje v oblak. Začne se spoznavanje s tem razmeroma nenavadnim orodjem za R-programerje z serije objav ali z .
Docker omogoča tako ustvarjanje lastnih slik "od nule" kot tudi uporabo drugih slik kot osnovo za ustvarjanje lastnih. Po analizi razpoložljivih možnosti smo ugotovili, da je namestitev gonilnikov NVIDIA, CUDA+cuDNN in Pythonovih knjižnic precej obsežen del slike, zato smo se odločili, da vzamemo za osnovo uradno sliko tensorflow/tensorflow:1.12.0-gpu, dodali pa smo tudi potrebne R-paket.
Končni Docker datoteka je izgledala tako:
Dockerfile
FROM tensorflow/tensorflow:1.12.0-gpu

MAINTAINER Artem Klevtsov

SHELL ["/bin/bash", "-c"]

ARG LOCALE="en_US.UTF-8"
ARG APT_PKG="libopencv-dev r-base r-base-dev littler"
ARG R_BIN_PKG="futile.logger checkmate data.table rcpp rapidjsonr dbi keras jsonlite curl digest remotes"
ARG R_SRC_PKG="xtensor RcppThread docopt MonetDBLite"
ARG PY_PIP_PKG="keras"
ARG DIRS="/db /app /app/data /app/models /app/logs"

RUN source /etc/os-release &&
    echo "deb https://cloud.r-project.org/bin/linux/ubuntu ${UBUNTU_CODENAME}-cran35/" > /etc/apt/sources.list.d/cran35.list &&
    apt-key adv --keyserver keyserver.ubuntu.com --recv-keys E084DAB9 &&
    add-apt-repository -y ppa:marutter/c2d4u3.5 &&
    add-apt-repository -y ppa:timsc/opencv-3.4 &&
    apt-get update &&
    apt-get install -y locales &&
    locale-gen ${LOCALE} &&
    apt-get install -y --no-install-recommends ${APT_PKG} &&
    ln -s /usr/lib/R/site-library/littler/examples/install.r /usr/local/bin/install.r &&
    ln -s /usr/lib/R/site-library/littler/examples/install2.r /usr/local/bin/install2.r &&
    ln -s /usr/lib/R/site-library/littler/examples/installGithub.r /usr/local/bin/installGithub.r &&
    echo 'options(Ncpus = parallel::detectCores())' >> /etc/R/Rprofile.site &&
    echo 'options(repos = c(CRAN = "https://cloud.r-project.org"))' >> /etc/R/Rprofile.site &&
    apt-get install -y $(printf "r-cran-%s " ${R_BIN_PKG}) &&
    install.r ${R_SRC_PKG} &&
    pip install ${PY_PIP_PKG} &&
    mkdir -p ${DIRS} &&
    chmod 777 ${DIRS} &&
    rm -rf /tmp/downloaded_packages/ /tmp/*.rds &&
    rm -rf /var/lib/apt/lists/*

COPY utils /app/utils
COPY src /app/src
COPY tests /app/tests
COPY bin/*.R /app/

ENV DBDIR="/db"
ENV CUDA_HOME="/usr/local/cuda"
ENV PATH="/app:${PATH}"

WORKDIR /app

VOLUME /db
VOLUME /app

CMD bash
Za enostavnost so bile uporabljene pakete shranjene v spremenljivke; večina napisanih skriptov se med gradnjo kopiira v kontejnerje. Prav tako smo spremenili ukazno lupino na /bin/bash za lažjo uporabo vsebine /etc/os-release. To je omogočilo, da ni bilo treba v kodi navesti različice operacijskega sistema.
Dodatno je bil napisan majhen bash skript, ki omogoča zagon kontejnerja z različnimi ukazi. Na primer, to so lahko skripti za učenje nevronetov, ki so bili prej vključeni v kontejner, ali ukazna lupina za odpravljanje napak in spremljanje delovanja kontejnerja:
Skript za zagon kontejnerja
#!/bin/sh

DBDIR=${PWD}/db
LOGSDIR=${PWD}/logs
MODELDIR=${PWD}/models
DATADIR=${PWD}/data
ARGS="--runtime=nvidia --rm -v ${DBDIR}:/db -v ${LOGSDIR}:/app/logs -v ${MODELDIR}:/app/models -v ${DATADIR}:/app/data"

if [ -z "$1" ]; then
    CMD="Rscript /app/train_nn.R"
elif [ "$1" = "bash" ]; then
    ARGS="${ARGS} -ti"
else
    CMD="Rscript /app/train_nn.R $@"
fi

docker run ${ARGS} doodles-tf ${CMD}
Če ta bash skript zaženete brez parametrov, se v znotraj kontejnerja izvede skript train_nn.R s privzetimi vrednostmi; če je prvi pozicijski argument "bash", se bo kontejner zagnal v interaktivnem načinu s ukazno lupino. V vseh drugih primerih pride do nadomestitve vrednosti pozicijskih argumentov: CMD="Rscript /app/train_nn.R $@".
Opozoriti je treba, da se imeniki z izvorni podatki in bazo podatkov, prav tako imenik za shranjevanje naučenih modelov, montirajo v kontejner iz gostiteljske sistem, kar omogoča dostop do rezultatov delovanja skriptov brez dodatnih manipulacij.
7. Uporaba več GPU-jev v oblaku Google Cloud
Ena od lastnosti tekmovanja so bili zelo hrupni podatki (glejte naslovno sliko, ki jo je prispeval @Leigh.plt iz ODS Slacka). S tem se lahko borite s pomočjo velikih serij, in po eksperimentih na osebnem računalniku z enim GPU-jem smo se odločili za usposabljanje modelov na več GPU-jih v oblaku. Uporabili smo GoogleCloud () zaradi velike izbire razpoložljivih konfiguracij, sprejemljivih cen in bonusnih $300. Iz pohlepa je bil naročen primerek z 4xV100 s SSD in nekaj RAM-a, kar se je izkazalo za veliko napako. Takšna naprava hitro poje denar; pri eksperimentih brez uspelih delovnih tokov se lahko na hitro bankrotira. Za učne namene je bolje vzeti K80. Velika količina RAM-a pa je prišla prav — oblačni SSD me ni impresioniral s hitrostjo, zato smo bazo podatkov pri vsakem zagonu primerka premestili na dev/shm.
Največjo zanimivost predstavlja del kode, ki je odgovoren za uporabo več GPU-jev. Model se najprej ustvari na CPU-ju z uporabo upravljalnika konteksta, prav tako kot v Pythonu:
with(tensorflow::tf$device("/cpu:0"), {
  model_cpu <- get_model(
    name = model_name,
    input_shape = input_shape,
    weights = weights,
    metrics =(top_3_categorical_accuracy,
    compile = FALSE
  )
})
Nato se nekompajliran (to je pomembno) model kopira na določeno število razpoložljivih GPU-jev, in šele po tem se kompilira:
model <- keras::multi_gpu_model(model_cpu, gpus = n_gpu)
keras::compile(
  object = model,
  optimizer = keras::optimizer_adam(lr = 0.0004),
  loss = "categorical_crossentropy",
  metrics = c(top_3_categorical_accuracy)
)
Klasične tehnike z zamrzovanjem vseh plasti, razen zadnje, usposabljanjem zadnje plasti, odmrzovanjem in nadaljnjim usposabljanjem modela v celoti za več GPU-jev ni bilo mogoče uresničiti.
Nadzorovali smo usposabljanje brez uporabe tensorboard, omejuje se na beleženje logov in shranjevanje modelov z informativnimi imeni po vsaki epohi:
Povratni klici
# Шаблон имени файла лога
log_file_tmpl <- file.path("logs", sprintf(
  "%s_%d_%dch_%s.csv",
  model_name,
  dim_size,
  channels,
  format(Sys.time(), "%Y%m%d%H%M%OS")
))
# Шаблон имени файла модели
model_file_tmpl <- file.path("models", sprintf(
  "%s_%d_%dch_{epoch:02d}_{val_loss:.2f}.h5",
  model_name,
  dim_size,
  channels
))

callbacks_list <- list(
  keras::callback_csv_logger(
    filename = log_file_tmpl
  ),
  keras::callback_early_stopping(
    monitor = "val_loss",
    min_delta = 1e-4,
    patience = 8,
    verbose = 1,
    mode = "min"
  ),
  keras::callback_reduce_lr_on_plateau(
    monitor = "val_loss",
    factor = 0.5, # уменьшаем lr в 2 раза
    patience = 4,
    verbose = 1,
    min_delta = 1e-4,
    mode = "min"
  ),
  keras::callback_model_checkpoint(
    filepath = model_file_tmpl,
    monitor = "val_loss",
    save_best_only = FALSE,
    save_weights_only = FALSE,
    mode = "min"
  )
)
8. Namesto sklepa
Vrsta težav, s katerimi smo se soočili, še nismo uspeli premagati:
- u keras ni pripravne funkcije za samodejno iskanje optimalne hitrosti učenja (analoga
lr_finderv knjižnici fast.ai); z določenim trudom je mogoče prenesti na R zunanje implementacije, na primer, ; - kot posledica prejšnje točke, nismo uspeli najti prave hitrosti učenja pri uporabi več GPU-jev;
- primanjkuje sodobnih arhitektur nevronskih mrež, zlasti tistih, ki so bile vnaprej usposobljene na imagenet-u;
- manjka one cycle policy in diskriminativne hitrosti učenja (cosine annealing na našo prošnjo je bil , hvala ).
Kaj koristnega smo uspeli pridobiti iz tega tekmovanja:
- Na relativno nenapredni strojni opremi je mogoče brez težav delati s precejšnjimi (večstokrat večjimi od velikosti RAM-a) količinami podatkov. Paket data.table varčuje s pomnilnikom z in-place modificiranjem tabel, kar omogoča izogibanje njihovemu kopiranju, in pri pravilni uporabi njegovih možnosti skoraj vedno pokaže največjo hitrost med vsemi znanimi orodji za skriptne jezike. Shranjevanje podatkov v BDP omogoča v mnogih primerih sploh ne razmišljati o potrebi po vsem podatkovnem naboru v RAM.
- Počasne funkcije v R je mogoče zamenjati z hitrimi v C++ z uporabo paketa Rcpp. Če poleg tega uporabimo RcppThread ili RcppParallel, dobimo večplatformske večnitedeljske implementacije, zato ni potrebno paralelizirati kode na ravni R.
- Paket Rcpp se lahko uporablja brez resnega znanja C++, potrebne osnove so opisane . Header datoteke za nekatere napredne C knjižnice, kot so xtensor so na voljo na CRAN, kar pomeni, da se oblikuje infrastruktura za izvajanje projektov, ki integrirajo v R pripravljeno visoko zmogljivo kodo v C++. Dodatna prednost je poudarjanje sintakse in statični analizator kode v C++ v RStudiu.
- docopt omogoča zagon samostojnih skriptov s parametri. To je priročno za uporabo na oddaljenem strežniku, vključno z Dockerjem. V RStudiu je neprijetno izvajati dolgotrajne eksperimente z usposabljanjem nevronskih mrež, prav tako pa namestitev IDE na strežniku ni vedno upravičena.
- Docker omogoča prenosljivost kode in ponovljivost rezultatov med razvijalci z razdifferentimi različicami operacijskih sistemov in knjižnic, hkrati pa poenostavlja zagon na strežnikih. Celoten pipeline za učenje lahko zagnate z le eno ukazno vrstico.
- Google Cloud je cenovno ugoden način za eksperimentiranje na dragi strojni opremi, vendar je treba premišljeno izbrati konfiguracije.
- Merjenje hitrosti delovanja posameznih delov kode je zelo koristno, zlasti v kombinaciji R in C++, z paketom bench je to še posebej enostavno.
Na splošno je bilo to izkušnja zelo uporabna in še naprej delamo na reševanju nekaterih od izpostavljenih težav.
Izvor: habr.com
