

Published a detailed guide on tuning the Linux environment for maximum HTTP request processing performance. The proposed methods allowed increasing the performance of the JSON handler based on the libreactor library in the Amazon EC2 environment (4 vCPU) from 224 thousand API requests per second with the standard settings of Amazon Linux 2 with a 4.14 kernel to 1.2 million requests per second after optimization (an increase of 436%), and also led to a 79% reduction in request processing latency. The proposed methods are not specific to libreactor and work when using other HTTP servers, including nginx, Actix, Netty, and Node.js (libreactor was used in the tests because the solution based on it showed the best performance).
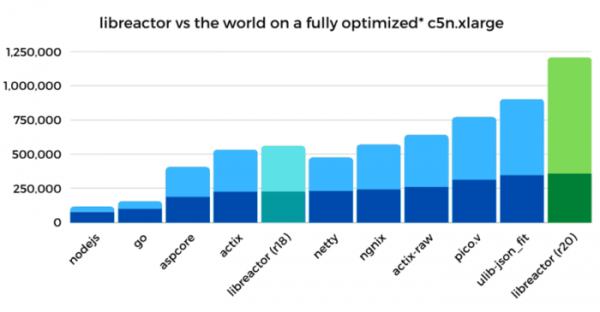
Optimizations principale:
- Optimizimi i kodit libreactor. Si bazë u përdor varianti R18 nga grupe Techempower, i cili u përmirësua përmes eliminimit të kodit për të kufizuar numrin e bërjes përdoruesve të CPU (optimizimi lehtësoi punën me 25-27%), ndërtimit në GCC me opsionet "-O3" (rritje 5-10%) dhe "-march-native" (5-10%), zëvendësimit të thirrjeve read/write me recv/send (5-10%) dhe uljes së kostove operuese kur përdoren pthreads (2-3%). Rritja totale e performancës pas optimizimit të kodit ishte 55%, ndërsa kapaciteti u rrit nga 224k req/s në 347k req/s.
- Çaktivizimi i mbrojtjes nga cenueshmëritë të shkaktuar nga ekzekutimi spekulator i instrukcioneve. Përdorimi i parametrave gjatë ngarkimit të kernelit "nospectre_v1 nospectre_v2 pti=off mds=off tsx_async_abort=off" lehtësoi performancën me 28%, ndërsa kapaciteti u rrit nga 347k req/s në 446k req/s. Veçmas, rritja nga parametri "nospectre_v1" (mbrojtja nga Spectre v1 + SWAPGS) ishte 1-2%, "nospectre_v2" (mbrojtja nga Spectre v2) - 15-20%, "pti=off" (Spectre v3/Meltdown) - 6%, "mds=off tsx_async_abort=off" (MDS/Zombieload dhe TSX Asynchronous Abort) - 6%. Parametrat për mbrojtjen nga sulmet L1TF/Foreshadow (l1tf=flush), iTLB multihit, Speculative Store Bypass dhe SRBDS mbetën pa ndryshime, pasi nuk kishin ndikim në performancë, duke mos u ndërthurrur me konfigurimin e testuar (për shembull, specifik për KVM, virtualizimin e ndodhur dhe modelet e tjera të CPU).
- Çaktivizimi i mekanizmave të auditi dhe bllokimit të thirrjeve sistemike me komandën «auditctl -a never,task» dhe caktimin e opsionit «—security-opt seccomp=unconfined» gjatë nisjes së kontejnerit docker. Rritja totale e performancës ishte 11%, dhe kapaciteti i kalimit u rrit nga 446k req/s në 495k req/s.
- Çaktivizimi i iptables/netfilter përmes shkarkimit të modulave të lidhura me ta nga bërthama. Ideja për të çaktivizuar firewalla, i cili nuk u përdor në zgjidhjen specifike të serverit, u nxit nga rezultatet e profilizimit, sipas të cilave fuksioni nf_hook_slow merrte 18% të kohës. Vihet në dukje se nftables funksionon më efikashem se iptables, por në Amazon Linux vazhdon të përdoret iptables. Pas çaktivizimit të iptables, rritja e performancës ishte 22%, dhe kapaciteti i kalimit u rrit nga 495k req/s në 603k req/s.
- Përmirësimi i migrimit të përpunuesve mes bërthamave të ndryshme CPU për të rritur efikasitetin e përdorimit të caches të procesorëve. Optimizimi u realizua si në nivelin e lidhjes së proceseve libreactor me bërthama CPU (CPU Pinning), ashtu edhe përmes ngjitjes së përpunuesve të rrjetit të bërthamës (Receive Side Scaling). Për shembull, u çaktivizua irqbalance dhe u vendosën qartë lidhjet e radhëve me CPU në /proc/irq/$IRQ/smp_affinity_list. Për të përdorur të njëjtën bërthamë CPU për përpunimin e procesit libreactor dhe rendin e paketave hyrëse, u angazhua një përpunues BPF i personalizuar, i lidhur përmes vendosjes së flamurit SO_ATTACH_REUSEPORT_CBPF gjatë krijimit të soketit. Për lidhjen me CPU të radhëve të paketave dalëse, u ndryshuan parametrat në /sys/class/net/eth0/queues/tx-<n>/xps_cpus. Rritja totale e performancës ishte 38%, dhe kapaciteti i kalimit u rrit nga 603k req/s në 834k req/s.
- Optimizimi i përpunimit të ndërprerjeve dhe përdorimi i polingut (polling). Aktivizimi i modit adaptive-rx në drivere ENA dhe manipulimet me sysctl net.core.busy_read lejojnë një rritje të performancës prej 28% (kapaciteti i kalimit u rrit nga 834k req/s në 1.06M req/s, ndërsa vonesat u ulën nga 361μs në 292μs).
- Çaktivizimi i shërbimeve sistemike që çojnë në bllokime shtesë në stakun e rrjetit. Çaktivizimi i dhclient dhe vendosja Adresa IP duke e bërë atë manualisht çoi në një rritje të performancës prej 6%, dhe kapaciteti i kalimit u rrit nga 1.06M req/s në 1.12M req/s. Arsyeja e ndikimit të dhclient në performancë në analizën e trafikut duke përdorur raw-soketin.
- Luftimi mbi Spin Lock. Kalimi i stakës rrjetore në modalitetin "noqueue" përmes sysctl "net.core.default_qdisc=noqueue" dhe "tc qdisc replace dev eth0 root mq" rezultoi në një rritje të performancës prej 2%, ndërsa kapaciteti kaloi nga 1.12M req/s në 1.15M req/s.
- Optimizimet përfundimtare, siç është çaktivizimi i GRO (Generic Receive Offload) me komandën "ethtool -K eth0 gro off" dhe zëvendësimi i algoritmit të kontrollit të ngarkesës cubic me reno përmes sysctl "net.ipv4.tcp_congestion_control=reno". Rritja totale e performancës arriti 4%. Kapaciteti kaloi nga 1.15M req/s në 1.2M req/s.
Përveç optimizimeve që funksionuan, në artikull shqyrtohen gjithashtu metoda që nuk çuan në rritjen e pritur të performancës. Për shembull, këto u dëshmuan si të paefektshme:
- Ekzekutimi i veçantë i libreactor nuk e ndryshoi performancën nga ekzekutimi në kontejner. Zëvendësimi i writev me send, rritja e maxevents në epoll_wait, eksperimentet me versionet dhe flagjet e GCC (efekti u vu re vetëm për flagjet "-O3" dhe "-march-native").
- Përmirësimi në performancë nuk u ndikua nga përditësimi i bërthamës Linux në versionet 4.19 dhe 5.4, përdorimi i planifikuesve SCHED_FIFO dhe SCHED_RR, manipulimet me sysctl kernel.sched_min_granularity_ns, kernel.sched_wakeup_granularity_ns, transparent_hugepages=never, skew_tick=1 dhe clocksource=tsc.
- Në drivërin ENA, aktivizimi i mënyrave Offload (segmentation, scatter-gather, rx/tx checksum), ndërtimi me flagun "-O3" dhe aplikimi i parametrave ena.rx_queue_size dhe ena.force_large_llq_header nuk kishin ndikim mbi performancën.
- Ndryshimet në stakën rrjetore nuk çuan në një rritje të performancës:
- Çaktivizimi i IPv6: ipv6.disable=1
- Çaktivizimi i VLAN: modprobe -rv 8021q
- Çaktivizimi i verifikimit të burimit të paketës
- net.ipv4.conf.all.rp_filter=0
- net.ipv4.conf.eth0.rp_filter=0
- net.ipv4.conf.all.accept_local=1 (efekti negativ)
- net.ipv4.tcp_sack=0
- net.ipv4.tcp_dsack=0
- net.ipv4.tcp_mem/tcp_wmem/tcp_rmem
- net.core.netdev_budget
- net.core.dev_weight
- net.core.netdev_max_backlog
- net.ipv4.tcp_slow_start_after_idle=0
- net.ipv4.tcp_moderate_rcvbuf=0
- net.ipv4.tcp_timestamps=0
- net.ipv4.tcp_low_latency=1
- SO_PRIORITY
- TCP_NODELAY
Burimi: opennet.ru
