

Projekti OpenAI, i angazhuar në zhvillimin e projekteve të hapura në fushën e inteligjencës artificiale, publikoi zhvillimet e lidhura me sistemin e njohjes së të folurit Whisper. Pretendohet se për të folur në anglisht, sistemi siguron nivele të besueshmërisë dhe saktësisë të njohjes automatike që janë afër atyre të njohjes nga njeriu. Kodi i implementimit referues është i hapur dhe bazohet në kornizën PyTorch, dhe një grup i modeleve të trajnuara tashmë është i gatshëm për përdorim. Kodi është i hapur nën licencën MIT.
Për të trajnuar modelin janë përdorur 680 mijë orë të dhënash të të folurit, të mbledhura nga disa koleksione që mbulojnë gjuhë dhe tema të ndryshme. Rreth 1/3 e të dhënave të folura që u përdorën për trajnimin vijnë nga gjuhë të ndryshme nga anglishtja. Sistemi i ofruar përpunon saktësisht situata të tilla si shqiptimi me theks, prania e zhurmave sfondi dhe përdorimi i zhargonit teknik. Përveç transkriptimit të të folurit në tekst, sistemi gjithashtu mund të përkthejë të folurin nga çdo gjuhë në anglisht dhe të identifikojë shfaqjen e të folurit në një rrjedhë audiosh.
Modelet janë formuar në dy përfaqësime: një model për gjuhën angleze dhe një model shumëgjuhësh që mbështet, përfshirë, gjuhët ruse, ukrainase dhe bjelloruse. Në anën tjetër, çdo përfaqësim ndahet në 5 variante që ndryshojnë në madhësi dhe numrin e parametrave të mbuluar nga modeli. Sa më i madh të jetë madhësia, aq më e lartë është saktësia dhe cilësia e njohjes, por gjithashtu rriten kërkesat për madhësinë e memorjes video GPU dhe ulet performanca. Për shembull, varianti minimal përfshin 39 milion parametra dhe kërkon 1 GB memorie video, ndërsa maksimi përfshin 1550 milion parametra dhe kërkon 10 GB memorie video. Varianti minimal është 32 herë më i shpejtë se maksimi.
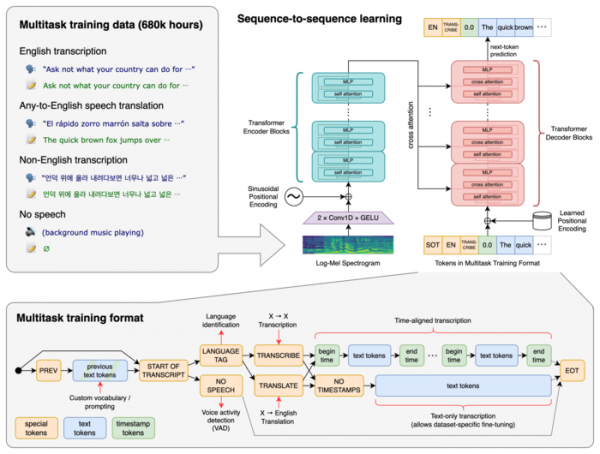
Sistemi përdor një arkitekturë të rrjetit nervor "Transformer", e cila përfshin një kodues dhe një dekodues që ndërveprojnë me njëri-tjetrin. Zëri ndahet në pjesë 30-sekondëshe, të cilat konvertohen në log-Mel-spektrogram dhe i dërgohen koduesit. Rezultati i punës së koduesit i drejtohet dekoduesit, i cili parashikon një përfaqësim tekstual, të përzier me tokene speciale që lejojnë zgjidhjen e detyrave si përcaktimi i gjuhës, mbajtja në llogari e kronologjisë së shqiptimit të frazave, transkriptimi i fjalës në gjuhë të ndryshme dhe përkthimi në anglisht.
Burimi: opennet.ru
