

Lëshimi 0.9.0 i bibliotekës për gjuhën C++ (standard C++20) libunicode. Projekti po zhvillohet nga ekipi i zhvilluesve të emulatorit të terminalit Contour dhe shell-it Endo (në zhvillim aktiv), dhe shpërndahet nën licencën Apache 2.0.
- mbështetje për standartet Unicode 17.0:
- API për marrjen e pronave të Unicode;
- optimizimi SIMD i disa funksioneve (duke përdorur std::simd ose std::experimental::simd nëse janë të disponueshme);
- konvertim të optimizuar UTF-8 UTF-16/UTF-32;
- ekvivalent i funksionit wcwidth (int unicode::width(char32_t));
- segmentimi i tekstit sipas grafemave, simboleve, emoji dhe skripteve;
- shndërrimi i rasteve dhe krahasimi i rreshtave;
- API me nivel të lartë për segmentimin e tekstit, i përshtatshëm për implementim shaping të tekstit.
- mbulimi me teste i shumicës së funkcionaliteteve të bibliotekës (gjerësia e simbolit dhe segmentimi).
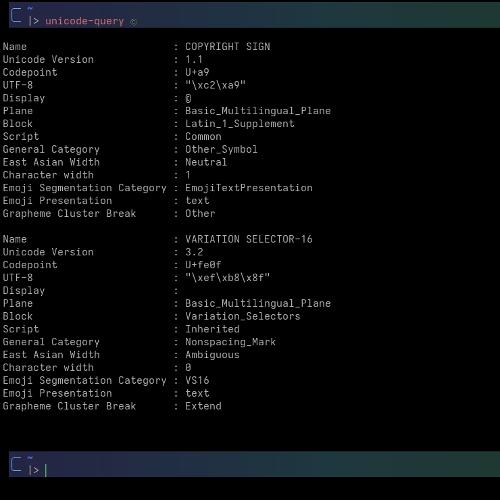
Në paketë përfshihet gjithashtu utilitari konsolë unicode-query për të marrë informacion të detajuar mbi rreshtat.
Ndryshimet:
- shtuar API për grapheme_cluster_width;
- përmirësime në funksionimin me versionet e Unicode ('Age');
- mbështetje e plotë UAX #15 Formulat e Normalizimit Unicode me mbështetje për procesin e vazhdueshëm:
normalizer norm(Normalization_Form::NFC); // Jep e dekompozuar e + akuzë të përbashkët, pastaj një starter të ri për të nxitur emisjon auto result = norm.feed(U’e’); CHECK(result.empty()); // ende në buffer result = norm.feed(U’u0301′); CHECK(result.empty()); // ende në buffer (shenja e bashkimit) result = norm.feed(U’x’); // starter nxit emisjonin e segmentit të mëparshëm REQUIRE_FALSE(result.empty()); CHECK(result == U"u00E9"); // e + akuzë e përbërë në e-akuze result = norm.flush(); CHECK(result == U"x"); // segmenti përfundimtar
- funksioni script_extensions tani kthen std::optional<std::span>;
- implementuar rregullin GB9c për ndarjen e grupeve të grafemave për kombinime simbolesh në gjuhët e grupit Indic;
- në grapheme_segmenter janë korrigjuar rregullat për GB11 dhe GB4/GB5; është fshirë API i mbetur në kohë;
- implementuar konvertimin e optimizuar SIMD nga UTF-8 në UTF-16/UTF-32;
- gjerësia e simboleve lidhëse Hangul V/T tani është e barabartë me zero;
- implementuar segmentimin sipas kufijve të fjalëve;
- korrigjime në C API;
- refaktorizimi i sistemit të ndërtimit dhe gjeneratorit të tabelave ndihmëse C++;
- shtuar teste komplekse për konvertimin e UTF-16/UTF-32;
- në CI është shtuar ndërtimi statik i utilitarit unicode-query.
Burimi: linux.org.ru
