

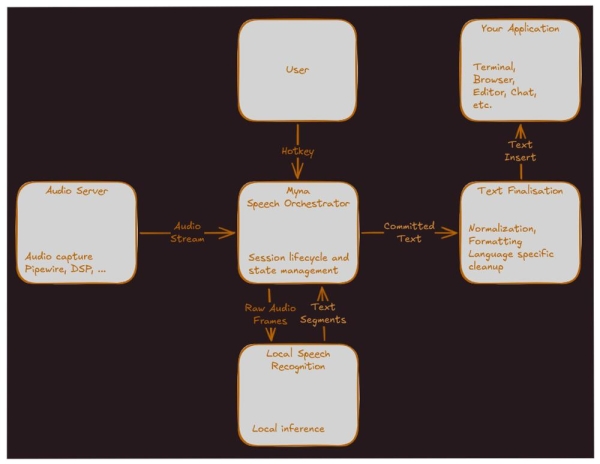
Canonical prezantoi projektin Myna — një sistem të ri të konvertimit të zërit në tekst për Ubuntu Desktop. Projekti synon thjeshtësinë e diktimeve: përdoruesi shtyp një kombinim çelësish, flet dhe teksti i njohur shfaqet në aplikacionin aktiv. Në njoftimin e saj nënvizohet se Myna duhet të ndjehet si një pjesë natyrale e desktopit të Ubuntu dhe të funksionojë duke respektuar privatësinë e përdoruesit. Lista e gjuhëve të mbështetura për hyrje në momentin e publikimit të lajmit nuk është bërë e njohur.
Qëllimi i parë i projektit është Ubuntu 26.10. Në këtë fazë, Canonical nuk përpiqet të krijojë një asistënt të plotë të zërit ose një sistem menaxhimi të desktopit me zë. Zhvilluesit me qëllim e kanë kufizuar fushën e versionit të parë në një diktim bazik dhe të besueshëm: të shtypësh një kombinim çelësish, të thuash tekstin dhe të marrësh rezultatin në fushën e aktuale të hyrjes. Mjedisi i parë i verifikueshëm është Ubuntu Desktop mbi Wayland me GNOME, por arkitektura pritet të mbetet mjaft e hapur për mbështetje të ardhshme për ambientet e tjera.
Myna është e destinuar për njohjen lokale të zërit. Pas instalimit të modeleve të nevojshme, lidhja me internetin për funksionimin e diktimeve nuk kërkohet, mikrofonin duhet ta përdorë vetëm pas aktivizimit të qartë nga përdoruesi, audio përpunohen në memorie dhe pastaj hidhen, dhe regjistrimet nuk dërgohen në shërbime të jashtme. Në specifikimin e projektit gjithashtu është e theksuar se zgjidhja duhet t'i shmangë ruajtjes së audios si parazgjedhje dhe nuk duhet të kalojë fshehurazi në një shërbim cloud.
Kodi dhe dokumentacioni i Myna janë publikuar në depozitën Canonical në GitHub. Projekti përshkruhet si një aplikacion i lehtë për shndërrimin e zërit në tekst për Ubuntu Desktop dhe shpërndahet nën licencën GPL-3.0. Megjithatë, projekti është në një fazë të hershme: në depo nuk ka ende lëshime të publikuara, dhe specifikimi arkitekturor ka statusin e Propozuar.
Funksionet dhe karakteristikat kryesore të Myna
Diktimi Push-to-talk. Përdoruesi mba një çelës të personalizueshëm, flet dhe sistemi e ngjitesh tekstin e njohur në fushën e zgjedhur të hyrjes. Diktimi përfundon sapo të lëshosh çelësin.
Njohja lokale e zërit. Njohja bëhet në makinën e përdoruesit përmes një staku lokal të inference. Kjo redukton varësinë nga cloud-i dhe lejon funksionimin pa rrjet pas instalimit të modeleve.
Përpunimi privat i audios. Mikrofoni aktivizohet vetëm gjatë sesionit të përdoruesit për diktimin. Audioja nuk duhet të regjistrohet në disk siç është, përdoret një tampon i kufizuar në memorie, i cili pastron pas përfundimit të sesionit.
Tregues vizual aktiviteti. Gjatë regjistrimit dhe transkriptimit, përdoruesi duhet të shohë një tregues të qartë të gjendjes. Specifikimi përmend gjendje si Regjistrimi, Transkriptimi, Përfundimi dhe Gabimi.
Futja vetëm e tekstit të qëndrueshëm. Në realizimin e parë, hipotezat përkatëse të njohjes nuk duhet të futen direkt në aplikacion. Në fushën e destinacionit dërgohet vetëm teksti përfundimtar i konfirmuar.
Pasprocesimi i tekstit. Transkriptimi i papërpunuar mund të kalojë normalizimin, vendosjen e pikësimit, kapitalizimin, formatimin dhe konvertimin e formave gojore në forma shkruese, p.sh. "twenty two" → "22".
Zgjedhja e gjuhës së diktimit. Sistema duhet të mbështesë gjuhën e diktimit të personalizueshme, duke u mbështetur në mënyrë të paracaktuar në gjuhën e ndërfaqes së përdoruesit, nëse një model i përshtatshëm është në dispozicion.
Profili i cilësisë së modelit. Specifikimi parashikon profile të ndryshme të modeleve: një variant të lehtë me konsum më të ulët të burimeve, një profil të ekuilibruar si default dhe një variant më cilësor, por më të rëndë.
Puna e sigurt me fokusin e hyrjes. Qëllimi për të futur tekstin zgjidhet në fillim të sesionit. Nëse fokusi i dritares ndryshon gjatë diktimit, sistemi nuk duhet të dërgojë heshtazi tekstin në një aplikacion tjetër.
Blo këimi në fushat e mbrojtura. Diktimi duhet të bllokohet në fushat e fjalëkalimit, dritaret e autentifikimit dhe vende të tjera të mbrojtura, nëse aplikacioni ose toolkit-i e lejojnë këtë të përcaktohet.
Integrimi me Wayland/GNOME. Versioni i parë është i orientuar ndaj Wayland dhe GNOME. Për futjen fillestare të tekstit shqyrtohet IBus, dhe në të ardhmen planifikohet një qasje më natyrale përmes protokolleve input-method/text-input.
Cilësimet e përdoruesit. Në ndërfaqen e planifikuar të cilësimeve duhet të përfshihen aktivizimi/çaktivizimi i STT, zgjedhja e çelësit të nxehtë, gjuhës së diktimit, mikrofoni, profili i modelit, parametrat e pasprocesimit dhe treguesi i aktivitetit.
Në iteracionin e parë, jashtë projektit mbeten zgjerimi i frazës kyçe, dëgjimi i vazhdueshëm në sfond, njohja në re, ndihmësi vokal, komandat vokale, menaxhimi i desktopit, përkthimi i fjalëve, identifikimi i folësit, përcaktimi automatik i gjuhës dhe historia e diktimit. Në terma të tjerë, Canonical nuk fillon me "ndihmësin AI", por me një funksion më të thjeshtë: vendosja lokale e hyrjes vokale në aplikacione të zakonshme Ubuntu.
Burimi: linux.org.ru
