

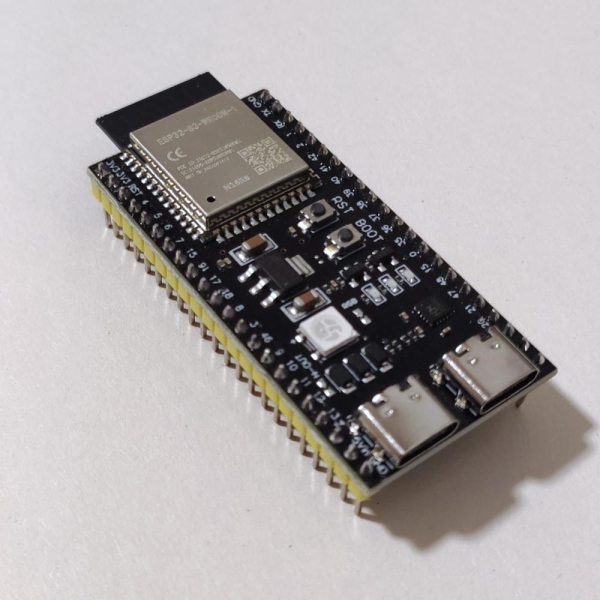
Zhvilluesi Viaçeslav Serbov, i njohur me emrin e tij të përzgjedhur slvDev, demonstronte ka krijuar një gjenerim plotësisht lokal të tekstit në mikroprocesorin ESP32-S3. Modeli i gjuhës i krijuar prej tij përmban 28.9 milion parametra dhe jep rreth 9.9 token në sekondë, pa ndihmën e serverëve apo burimeve të tjera jashtme të llogaritjes. Histori të shkurtra të gjeneruara shfaqen në ekranin OLED të lidhur.
Projekti esp32-ai është testuar në modulin ESP32-S3 N16R8, që ka 512 KB SRAM të integruar, 8 MB PSRAM dhe 16 MB memorie flash. Modeli i kvantizuar deri në katër bit zë 14.9 MB. Në depo janë publikuar kodet burimore të ambientit të ekzekutimit në C, mjetet për trajnim dhe kvantizimin e modelit, firmware, teste dhe skenare për ngarkimin e tij në bord.
Numri i deklaruar prej 28.9 milion parametra nuk duhet të krahasohet drejtpërdrejt me numrin e parametrave të LLM-ve të zakonshme desktop. Sipas raportit të Detajuar të Zhvilluesit, modeli përbëhet nga një bërthamë të dendur llogaritëse me rreth 559 mijë parametra, një kat i daljes me 3.1 milion parametra dhe një tabelë përfaqësuese vektoriale sipas katërit me rreth 25 milion parametra. Kjo e fundit siguron pjesën kryesore të madhësisë formale të modelit, por nuk përpunohen tërësisht gjatë gjenerimit të çdo tokeni.
Për vendosjen e modelit janë angazhuar tri nivele memorie. Të dhënat më shpesh të përdorura ndodhen në SRAM-in e brendshëm, kat i daljes, KV-cache dhe buffer-et e përkohshëm banojnë në PSRAM, ndërsa tabela prej 25 milionësh mbetet në memorie flash dhe është e aksesueshme përmes mapimit në hapësirën e adresës. Për secilin token, nga ajo lexohen vetëm rreth gjashtë rreshta me një vëllim total prej rreth 450 byte.
Një pajisje e tillë bazohet në teknologjinë Per-Layer Embeddings, e cila është aplikuar nga Google në Gemma 3n. Sipas dokumentacionit të Google, parametrat PLE mund të ruhen jashtë memorie së punës së modelit dhe të shtohet në procesin e daljes ndërsa përpunohen katet e veçanta. Në esp32-ai ky qasje është transferuar në hierarkinë e memories së mikroprocesorit, ku SRAM-i i shpejtë është veçanërisht i kufizuar.
Versioni e parë korrekte e shkruar në C të mjedisit të ekzekutimit jepte vetëm 0.57 tokena në sekondë. Pas vendosjes së shtresës dalëse në PSRAM, kalimit në aktivizime 8-bitëshe, shpërndarjes së llogaritjeve midis dy bërthamave Xtensa LX7 dhe optimizimeve të tjera, vonesa u ul në 94.9 ms për hapin e modelit. Shpejtësia përfundimtare e matur arriti në 9.88 tokena në sekondë duke marrë parasysh procesin e plotë të gjenerimit. Kufizimi kryesor tani ishte kapaciteti i leximit të PSRAM-it në lidhje me shtresën dalëse.
Modeli është stërvitur mbi një set të dhënash sintetik TinyStories, që përmban tregime të thjeshta në anglisht me një fjalor të kufizuar. Prandaj, ajo është në gjendje të vazhdojë fraza dhe të përbëjë histori të vogla të lidhura, por nuk është e destinuar për të përgjigjur pyetjeve, për të përmbushur udhëzime, për programim ose për të riprodhuar njohuri faktike. Zhvilluesi e shikon punën kryesisht si një demonstrim të vendosjes efikase të modelit në memorien e mikro-kontrollerit dhe jo si një chatbot autonom të gatshëm.
Në dokumentacionin aktual, autori veçon qartë se esp32-ai është një zhvillim i pavarur. Projektet llama2.c të Andrei Karpathy dhe nisja më e hershme e modelit 260,000-parameter në ESP32-S3 përmenden vetëm si pikë referimi dhe shembuj të punëve paraprake: kodi, pikat e kontrollit dhe metodologjia përkatëse nuk janë marrë drejtpërdrejt prej tyre. Kodi burimor i esp32-ai distribuohet nën licencën MIT.
Burimi: linux.org.ru
