

Përshëndetje, Habr!
Në vjeshtën e vitit të kaluar, në Kaggle u zhvillua një garë për klasifikimin e vizatimeve të tërhequra me dorë Quick Draw Doodle Recognition, në të cilin, mes të tjerëve, mori pjesë ekipi i R-shkencëtarëve përbërë nga , dhe . Nuk do ta përshkruajmë gara në detaje, kjo është bërë në .
Përfarë të arritjeve me medalje, këtë herë nuk arritëm, por morëm shumë përvojë të vlefshme, prandaj do doja t'i tregoja komunitetit disa nga temat më interesante dhe të dobishme në Kaggle dhe në punën e përditshme. Ndër temat e shqyrtuara: jeta e vështirë pa OpenCV, analizimin e JSON-ëve (në këto shembuj shqyrtohet integrimi i kodit në C++ në skriptet ose paketat në R përmes Rcpp), parametrizimi i skriptit dhe dockerizimi i zgjidhjes përfundimtare. Të gjithë kodin e mesazhit në një format të gatshëm për t'u ekzekutuar e gjeni në .
Përmbajtja:
1. Ngarkimi efikas i të dhënave nga CSV në bazën MonetDB
Të dhënat në këtë garë nuk ofrohen në formën e imazheve të gatshme, por në formën e 340 CSV-fajllave (një për çdo klasë), që përmbajnë JSON me koordinatat e pikave. Duke lidhur këto pika me linja, marrim imazhin përfundimtar me dimensione 256x256 piksel. Po ashtu, për çdo regjistrim jepet nje etiketë, nëse imazhi është identifikuar saktësisht nga klasifikuesi i përdorur në momentin e mbledhjes së të dhënave, kodi dypjesësh i vendit të banimit të autorit të vizatimit, një identifikues unik, etiketë kohe dhe emri i klasës, i cili përputhet me emrin e fajllit. Një version i thjeshtuar i të dhënave peshon 7.4 GB në arkiv dhe rreth 20 GB pas shpërbërjes, të dhënat e plota pas shpërbërjes zënë 240 GB. Organizatorët garantuan se të dy versionet riprodhojnë të njëjtat vizatime, që do të thotë se versioni i plotë është i tepërt. Megjithatë, ruajtja e 50 milion vizatimeve në skedarë grafikë ose në formën e matrizave është njohur menjëherë si e papërshtatshme, dhe ne vendosëm të bashkojmë të gjithë CSV-fajllat nga arkivi train_simplified.zip në një bazë të dhënash me gjenerimin e mëpasëm të imazheve me dimensionet e nevojshme "në flakë" për çdo grup.
Si DBMS u zgjodh MonetDB, i njohur për performancën e tij të mirë. MonetDB, në veçanti realizimi për R si një paketë . Paketa përfshin një version të integruar të serverit të bazës së të dhënave dhe lejon ngritjen e serverit drejtpërdrejt nga sesioni R dhe punën aty. Krijimi i bazës së të dhënave dhe lidhja me të bëhen me një komandë:
con <- DBI::dbConnect(drv = MonetDBLite::MonetDBLite(), Sys.getenv("DBDIR"))Na nevojitet të krijojmë dy tabela: një për të gjitha të dhënat, një tjetër për informacionin ndihmës rreth skedarëve të ngarkuar (do të jetë e nevojshme nëse diçka shkon keq dhe procesi duhet të riniset pas ngarkimit të disa skedarëve):
Krijimi i tabelave
if (!DBI::dbExistsTable(con, "doodles")) {
  DBI::dbCreateTable(
    con = con,
    name = "doodles",
    fields = c(
      "countrycode" = "char(2)",
      "drawing" = "text",
      "key_id" = "bigint",
      "recognized" = "bool",
      "timestamp" = "timestamp",
      "word" = "text"
    )
  )
}

if (!DBI::dbExistsTable(con, "upload_log")) {
  DBI::dbCreateTable(
    con = con,
    name = "upload_log",
    fields = c(
      "id" = "serial",
      "file_name" = "text UNIQUE",
      "uploaded" = "bool DEFAULT false"
    )
  )
}
Metoda më e shpejtë për ngarkimin e të dhënave në DB u tregua të ishte kopjimi i drejtpërdrejtë i skedarëve CSV nëpërmjet SQL — komanda COPY OFFSET 2 INTO tablename FROM path USING DELIMITERS ',','n','"' NULL AS '' BEST EFFORTindex emri_tabelës — emri i tabelës dhe path — rruga te skedari. Gjatë punës me arkivin u zbulua se implementimi i integruar unzip në R nuk funksionon siç duhet me disa skedarë nga arkivi, prandaj ne përdorëm sistemin unzip (nëpërmjet parametrës getOption("unzip")).
Funksioni për të shkruar në bazë
#' @title Извлечение и загрузка файлов
#'
#' @description
#' Извлечение CSV-файлов из ZIP-архива и загрузка их в базу данных
#'
#' @param con Объект подключения к базе данных (класс `MonetDBEmbeddedConnection`).
#' @param tablename Название таблицы в базе данных.
#' @oaram zipfile Путь к ZIP-архиву.
#' @oaram filename Имя файла внури ZIP-архива.
#' @param preprocess Функция предобработки, которая будет применена извлечённому файлу.
#'   Должна принимать один аргумент `data` (объект `data.table`).
#'
#' @return `TRUE`.
#'
upload_file <- function(con, tablename, zipfile, filename, preprocess = NULL) {
  # Проверка аргументов
  checkmate::assert_class(con, "MonetDBEmbeddedConnection")
  checkmate::assert_string(tablename)
  checkmate::assert_string(filename)
  checkmate::assert_true(DBI::dbExistsTable(con, tablename))
  checkmate::assert_file_exists(zipfile, access = "r", extension = "zip")
  checkmate::assert_function(preprocess, args = c("data"), null.ok = TRUE)

  # Извлечение файла
  path <- file.path(tempdir(), filename)
  unzip(zipfile, files = filename, exdir = tempdir(),
        junkpaths = TRUE, unzip = getOption("unzip"))
  on.exit(unlink(file.path(path)))

  # Применяем функция предобработки
  if (!is.null(preprocess)) {
    .data <- data.table::fread(file = path)
    .data <- preprocess(data = .data)
    data.table::fwrite(x = .data, file = path, append = FALSE)
    rm(.data)
  }

  # Запрос к БД на импорт CSV
  sql <- sprintf(
    "COPY OFFSET 2 INTO %s FROM '%s' USING DELIMITERS ',','n','"' NULL AS '' BEST EFFORT",
    tablename, path
  )
  # Выполнение запроса к БД
  DBI::dbExecute(con, sql)

  # Добавление записи об успешной загрузке в служебную таблицу
  DBI::dbExecute(con, sprintf("INSERT INTO upload_log(file_name, uploaded) VALUES('%s', true)",
                              filename))

  return(invisible(TRUE))
}
Në rast se është e nevojshme të transformoni tabelën para se ta shkruani në DB, mjafton të kaloni në argumentin preprocess një funksion që do të transformojë të dhënat.
Kodi për ngarkimin e të dhënave në bazë:
Shkrimi i të dhënave në bazë
# Список файлов для записи
files <- unzip(zipfile, list = TRUE)$Name

# Список исключений, если часть файлов уже была загружена
to_skip <- DBI::dbGetQuery(con, "SELECT file_name FROM upload_log")[[1L]]
files <- setdiff(files, to_skip)

if (length(files) > 0L) {
  # Запускаем таймер
  tictoc::tic()
  # Прогресс бар
  pb <- txtProgressBar(min = 0L, max = length(files), style = 3)
  for (i in seq_along(files)) {
    upload_file(con = con, tablename = "doodles",
                zipfile = zipfile, filename = files[i])
    setTxtProgressBar(pb, i)
  }
  close(pb)
  # Останавливаем таймер
  tictoc::toc()
}

# 526.141 sec elapsed - копирование SSD->SSD
# 558.879 sec elapsed - копирование USB->SSD
Koha e ngarkimit të të dhënave mund të ndryshojë në varësi të karakteristikave të shpejtësisë së mediumit të përdorur. Në rastin tonë, leximi dhe shkrimi brenda një SSD-i të vetëm ose nga një flash disk (skedari burim) në SSD (DB) zgjat më pak se 10 minuta.
Disa sekonda të tjera nevojiten për krijimin e një kolonne me etiketat integer të klasës dhe një kolonne-indeksi (ORDERED INDEX) me numrat e rreshtave, sipas të cilëve do të bëhet përzgjedhja e të dhënave gjatë krijimit të grupeve:
Krijimi i koloneve të tjera dhe indeksit
message("Generate lables")
invisible(DBI::dbExecute(con, "ALTER TABLE doodles ADD label_int int"))
invisible(DBI::dbExecute(con, "UPDATE doodles SET label_int = dense_rank() OVER (ORDER BY word) - 1"))

message("Generate row numbers")
invisible(DBI::dbExecute(con, "ALTER TABLE doodles ADD id serial"))
invisible(DBI::dbExecute(con, "CREATE ORDERED INDEX doodles_id_ord_idx ON doodles(id)"))
Për të përmbushur detyrën e formimit të grupeve "në flukso", na nevojitej të arrinim shpejtësinë maksimale të nxjerrjes së rreshtave të rastësishëm nga tabela. doodles. Për këtë, ne përdorëm 3 truka. E para ishte të reduktojmë dimensionin e tipit, në të cilin ruhet ID e vëzhgimit. Në datasetin fillestar, për të ruajtur ID kërkohet tipi bigint, por numri i vëzhgimeve lejon që identifikuesit e tyre, të barabartë me numrin rendor, të vendosen në tipin int. Kërkimi në këtë rast ndodh shumë më shpejt. Truku i dytë ishte përdorimi i ORDERED INDEX — këtë zgjidhje e arritëm empiricisht, duke provuar të gjitha . Truku i tretë ishte përdorimi i kërkesave parametrike. Qëllimi i metodës është ekzekutimi i një komande PREPARE në një herë dhe më pas përdorimi i shprehjes të përgatitur gjatë krijimit të një grupe kërkesash njëlloj, por në fakt përfitimi në krahasim me thjeshtin SELECT ishte në një gamë të gabimit statistik.
Procesi i ngarkesës së të dhënave konsumon jo më shumë se 450 MB RAM. Pra, qasja e përshkruar lejon menaxhimin e dataset-eve me peshë në dhjetëra gigabajt në pothuajse çdo harduer buxhetor, duke përfshirë disa njësi të vetme, e cila është mjaft e jashtëzakonshme.
Mbetej të kryenim matjet e shpejtësisë së nxjerrjes së të dhënave (të rastësishme) dhe të vlerësonim shtrirjen gjatë përzgjedhjes së grupeve të ndryshme në madhësi:
Benchmark i bazës së të dhënave
library(ggplot2)

set.seed(0)
# Lidhu lidhjes me databazën
con <- DBI::dbConnect(MonetDBLite::MonetDBLite(), Sys.getenv("DBDIR"))

# Funksioni për përgatitjen e kërkesës nga serveri
prep_sql <- function(batch_size) {
  sql <- sprintf("PREPARE SELECT id FROM doodles WHERE id IN (%s)",
                 paste(rep("?", batch_size), collapse = ","))
  res <- DBI::dbSendQuery(con, sql)
  return(res)
}

# Funksioni për nxjerrjen e të dhënave
fetch_data <- function(rs, batch_size) {
  ids <- sample(seq_len(n), batch_size)
  res <- DBI::dbFetch(DBI::dbBind(rs, as.list(ids)))
  return(res)
}

# Kryerja e matjeve
res_bench <- bench::press(
  batch_size = 2^(4:10),
  {
    rs <- prep_sql(batch_size)
    bench::mark(
      fetch_data(rs, batch_size),
      min_iterations = 50L
    )
  }
)
# Parametrat e bencmark-ut
cols <- c("batch_size", "min", "median", "max", "itr/sec", "total_time", "n_itr")
res_bench[, cols]

#   batch_size      min   median      max `itr/sec` total_time n_itr
#
# 1         16   23.6ms  54.02ms  93.43ms     18.8        2.6s    49
# 2         32     38ms  84.83ms 151.55ms     11.4       4.29s    49
# 3         64   63.3ms 175.54ms 248.94ms     5.85       8.54s    50
# 4        128   83.2ms 341.52ms 496.24ms     3.00      16.69s    50
# 5        256  232.8ms 653.21ms 847.44ms     1.58      31.66s    50
# 6        512  784.6ms    1.41s    1.98s     0.740       1.1m    49
# 7       1024  681.7ms    2.72s    4.06s     0.377      2.16m    49

ggplot(res_bench, aes(x = factor(batch_size), y = median, group = 1)) +
  geom_point() +
  geom_line() +
  ylab("koha e mesatare, s") +
  theme_minimal()

DBI::dbDisconnect(con, shutdown = TRUE) 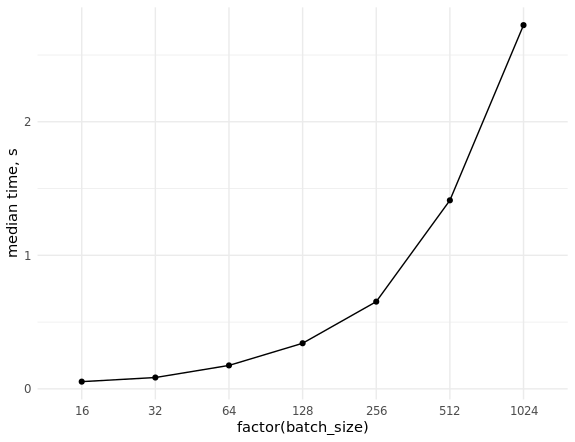
2. Përgatitja e grupeve
Të gjithë procesi i përgatitjes së grupeve përbëhet nga këto etapa:
- Analiza e disa JSON-eve, që përmbajnë vektorë rreshtash me koordinatat e pikave.
- vizatimi i linjave me ngjyra sipas koordinatave të pikave në një imazh me përmasat e nevojshme (p.sh., 256×256 ose 128×128).
- Transformimi i imazheve të marra në tensor.
Në kuadër të garës mes kernel-ëve në Python, problemi u zgjidh kryesisht me mjetet OpenCV. Një nga alternativat më të thjeshta dhe më të dukshme në R do të dukej si më poshtë:
Implementimi i transformimit nga JSON në tensor në R
r_process_json_str <- function(json, line.width = 3,
                               color = TRUE, scale = 1) {
  # Parsing JSON
  coords <- jsonlite::fromJSON(json, simplifyMatrix = FALSE)
  tmp <- tempfile()
  # Removing temporary file upon function completion
  on.exit(unlink(tmp))
  png(filename = tmp, width = 256 * scale, height = 256 * scale, pointsize = 1)
  # Empty plot
  plot.new()
  # Size of the plot window
  plot.window(xlim = c(256 * scale, 0), ylim = c(256 * scale, 0))
  # Line colors
  cols <- if (color) rainbow(length(coords)) else "#000000"
  for (i in seq_along(coords)) {
    lines(x = coords[[i]][[1]] * scale, y = coords[[i]][[2]] * scale,
          col = cols[i], lwd = line.width)
  }
  dev.off()
  # Converting image to a 3D array
  res <- png::readPNG(tmp)
  return(res)
}

r_process_json_vector <- function(x, ...) {
  res <- lapply(x, r_process_json_str, ...)
  # Merging 3D image arrays into a 4D tensor
  res <- do.call(abind::abind, c(res, along = 0))
  return(res)
}
Drawing is performed using standard R tools, saving to a temporary PNG stored in RAM (in Linux, R's temporary directories are located in a directory /tmp, mounted in RAM). This file is then read as a three-dimensional array with numbers ranging from 0 to 1. This is important, as the more commonly accepted BMP would be read into a raw array with hex color codes.
Let's test the result:
zip_file <- file.path("data", "train_simplified.zip")
csv_file <- "cat.csv"
unzip(zip_file, files = csv_file, exdir = tempdir(),
      junkpaths = TRUE, unzip = getOption("unzip"))
tmp_data <- data.table::fread(file.path(tempdir(), csv_file), sep = ",",
                              select = "drawing", nrows = 10000)
arr <- r_process_json_str(tmp_data[4, drawing])
dim(arr)
# [1] 256 256   3
plot(magick::image_read(arr)) 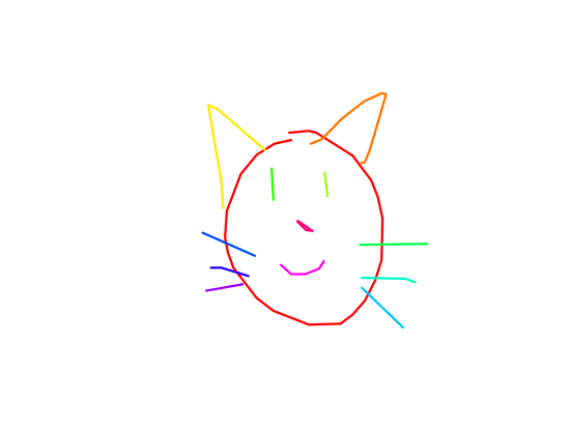
The batch will be formed as follows:
res <- r_process_json_vector(tmp_data[1:4, drawing], scale = 0.5)
str(res)
 # num [1:4, 1:128, 1:128, 1:3] 1 1 1 1 1 1 1 1 1 1 ...
 # - attr(*, "dimnames")=List of 4
 #  ..$ : NULL
 #  ..$ : NULL
 #  ..$ : NULL
 #  ..$ : NULL
This implementation seemed suboptimal to us, as forming large batches takes an indecent amount of time, and we decided to leverage the experience of colleagues, utilizing a powerful library OpenCV. At that time, there was no ready-made package for R (and there isn't one now), so a minimal implementation of the required functionality was written in C++ with integration into the R code using Rcpp.
To solve the problem, the following packages and libraries were used:
OpenCV to work with images and draw lines. We used pre-installed system libraries and header files, as well as dynamic linking.
xtensor për të punuar me matrica dhe tensorë shumë-dimensionale. Përdorëm skedarë titulli të përfshirë në paketën R me të njëjtin emër. Biblioteca lejon punën me matrica shumë-dimensionale, si në rend të rreshtit ashtu edhe në rend të kolonës.
ndjson për përpunimin e JSON. Kjo bibliotekë përdoret në xtensor automatikisht kur është e pranishme në projekt.
RcppThread për të organizuar përpunimin multi-thread të vektorëve nga JSON. Përdorëm skedarë titulli të ofruar nga kjo paketë. Nga më të njohurat RcppParallel paketa, ndër të tjera, karakterizohet nga një mekanizëm të integruar për ndërprerjen e ciklit (interrupt).
Duhet theksuar se xtensor u tregua një zbulim: përveç faktit se ajo ka funksionalitet të gjerë dhe performancë të lartë, zhvilluesit e saj ishin mjaft të përgjegjshëm dhe përgjigjeshin shpejt dhe në detaje në pyetje që lindnin. Me ndihmën e tyre arrijtëm të realizojmë transformime të matricave OpenCV në tensorë xtensor, si dhe një mënyrë të bashkimit të tensorëve të imazheve 3-dimensionale në një tensor 4-dimensionale me dimensione të sakta (në fakt, grupi).
Materiale për të studiuar Rcpp, xtensor dhe RcppThread
Për kompjilimin e skedarëve që përdorin skedarë sistemikë dhe lidhje dinamike me bibliotekat e instaluara në sistem, ne përdorëm mekanizmin e shtojcave të implementuar në paketë Rcpp. Për të gjetur automatikisht rrugët dhe flamujt, përdorëm utilitarin popullor në linux pkg-config.
Implementimi i një shtojce Rcpp për përdorimin e bibliotekës OpenCV
Rcpp::registerPlugin("opencv", function() {
  # Emrat e mundshëm të paketës
  pkg_config_name <- c("opencv", "opencv4")
  # Skedari binar i utilitarit pkg-config
  pkg_config_bin <- Sys.which("pkg-config")
  # Kontrolli i pranishmërisë së utilitarit në sistem
  checkmate::assert_file_exists(pkg_config_bin, access = "x")
  # Kontrolli i pranishmërisë së skedarit të konfigurimit OpenCV për pkg-config
  check <- sapply(pkg_config_name,
                  function(pkg) system(paste(pkg_config_bin, pkg)))
  if (all(check != 0)) {
    stop("Konfigurimi OpenCV për pkg-config nuk u gjet", call. = FALSE)
  }

  pkg_config_name <- pkg_config_name[check == 0]
  list(env = list(
    PKG_CXXFLAGS = system(paste(pkg_config_bin, "--cflags", pkg_config_name),
                          intern = TRUE),
    PKG_LIBS = system(paste(pkg_config_bin, "--libs", pkg_config_name),
                      intern = TRUE)
  ))
})
Si rezultat i punës së shtojcës gjatë procesit të kompjilimit, do të vendosen këto vlera:
Rcpp:::.plugins$opencv()$env

# $PKG_CXXFLAGS
# [1] "-I/usr/include/opencv"
#
# $PKG_LIBS
# [1] "-lopencv_shape -lopencv_stitching -lopencv_superres -lopencv_videostab -lopencv_aruco -lopencv_bgsegm -lopencv_bioinspired -lopencv_ccalib -lopencv_datasets -lopencv_dpm -lopencv_face -lopencv_freetype -lopencv_fuzzy -lopencv_hdf -lopencv_line_descriptor -lopencv_optflow -lopencv_video -lopencv_plot -lopencv_reg -lopencv_saliency -lopencv_stereo -lopencv_structured_light -lopencv_phase_unwrapping -lopencv_rgbd -lopencv_viz -lopencv_surface_matching -lopencv_text -lopencv_ximgproc -lopencv_calib3d -lopencv_features2d -lopencv_flann -lopencv_xobjdetect -lopencv_objdetect -lopencv_ml -lopencv_xphoto -lopencv_highgui -lopencv_videoio -lopencv_imgcodecs -lopencv_photo -lopencv_imgproc -lopencv_core"
Kodi i implementimit të analizës së JSON dhe formimit të një batch-i për ta kaluar në model është paraqitur poshtë në spojler. Së pari, shtojmë direktorinë lokale të projektit për gjetjen e skedarëve të titujve (e nevojshme për ndjson):
Sys.setenv("PKG_CXXFLAGS" = paste0("-I", normalizePath(file.path("src"))))Implementimi i transformimit të JSON në tensor në C++
// [[Rcpp::plugins(cpp14)]]
// [[Rcpp::plugins(opencv)]]
// [[Rcpp::depends(xtensor)]]
// [[Rcpp::depends(RcppThread)]]

#include <xtensor/xjson.hpp>
#include <xtensor/xadapt.hpp>
#include <xtensor/xview.hpp>
#include <xtensor-r/rtensor.hpp>
#include <opencv2/core/core.hpp>
#include <opencv2/highgui/highgui.hpp>
#include <opencv2/imgproc/imgproc.hpp>
#include <Rcpp.h>
#include <RcppThread.h>

// Синонимы для типов
using RcppThread::parallelFor;
using json = nlohmann::json;
using points = xt::xtensor<double,2>;     // Извлечённые из JSON координаты точек
using strokes = std::vector<points>;      // Извлечённые из JSON координаты точек
using xtensor3d = xt::xtensor<double, 3>; // Тензор для хранения матрицы изоображения
using xtensor4d = xt::xtensor<double, 4>; // Тензор для хранения множества изображений
using rtensor3d = xt::rtensor<double, 3>; // Обёртка для экспорта в R
using rtensor4d = xt::rtensor<double, 4>; // Обёртка для экспорта в R

// Статические константы
// Размер изображения в пикселях
const static int SIZE = 256;
// Тип линии
// См. https://en.wikipedia.org/wiki/Pixel_connectivity#2-dimensional
const static int LINE_TYPE = cv::LINE_4;
// Толщина линии в пикселях
const static int LINE_WIDTH = 3;
// Алгоритм ресайза
// https://docs.opencv.org/3.1.0/da/d54/group__imgproc__transform.html#ga5bb5a1fea74ea38e1a5445ca803ff121
const static int RESIZE_TYPE = cv::INTER_LINEAR;

// Шаблон для конвертирования OpenCV-матрицы в тензор
template <typename T, int NCH, typename XT=xt::xtensor<T,3,xt::layout_type::column_major>>
XT to_xt(const cv::Mat_<cv::Vec<T, NCH>>& src) {
  // Размерность целевого тензора
  std::vector<int> shape = {src.rows, src.cols, NCH};
  // Общее количество элементов в массиве
  size_t size = src.total() * NCH;
  // Преобразование cv::Mat в xt::xtensor
  XT res = xt::adapt((T*) src.data, size, xt::no_ownership(), shape);
  return res;
}

// Преобразование JSON в список координат точек
strokes parse_json(const std::string& x) {
  auto j = json::parse(x);
  // Результат парсинга должен быть массивом
  if (!j.is_array()) {
    throw std::runtime_error("'x' must be JSON array.");
  }
  strokes res;
  res.reserve(j.size());
  for (const auto& a: j) {
    // Каждый элемент массива должен быть 2-мерным массивом
    if (!a.is_array() || a.size() != 2) {
      throw std::runtime_error("'x' must include only 2d arrays.");
    }
    // Извлечение вектора точек
    auto p = a.get<points>();
    res.push_back(p);
  }
  return res;
}

// Отрисовка линий
// Цвета HSV
cv::Mat ocv_draw_lines(const strokes& x, bool color = true) {
  // Исходный тип матрицы
  auto stype = color ? CV_8UC3 : CV_8UC1;
  // Итоговый тип матрицы
  auto dtype = color ? CV_32FC3 : CV_32FC1;
  auto bg = color ? cv::Scalar(0, 0, 255) : cv::Scalar(255);
  auto col = color ? cv::Scalar(0, 255, 220) : cv::Scalar(0);
  cv::Mat img = cv::Mat(SIZE, SIZE, stype, bg);
  // Количество линий
  size_t n = x.size();
  for (const auto& s: x) {
    // Количество точек в линии
    size_t n_points = s.shape()[1];
    for (size_t i = 0; i < n_points - 1; ++i) {
      // Точка начала штриха
      cv::Point from(s(0, i), s(1, i));
      // Точка окончания штриха
      cv::Point to(s(0, i + 1), s(1, i + 1));
      // Отрисовка линии
      cv::line(img, from, to, col, LINE_WIDTH, LINE_TYPE);
    }
    if (color) {
      // Меняем цвет линии
      col[0] += 180 / n;
    }
  }
  if (color) {
    // Меняем цветовое представление на RGB
    cv::cvtColor(img, img, cv::COLOR_HSV2RGB);
  }
  // Меняем формат представления на float32 с диапазоном [0, 1]
  img.convertTo(img, dtype, 1 / 255.0);
  return img;
}

// Обработка JSON и получение тензора с данными изображения
xtensor3d process(const std::string& x, double scale = 1.0, bool color = true) {
  auto p = parse_json(x);
  auto img = ocv_draw_lines(p, color);
  if (scale != 1) {
    cv::Mat out;
    cv::resize(img, out, cv::Size(), scale, scale, RESIZE_TYPE);
    cv::swap(img, out);
    out.release();
  }
  xtensor3d arr = color ? to_xt<double,3>(img) : to_xt<double,1>(img);
  return arr;
}

// [[Rcpp::export]]
rtensor3d cpp_process_json_str(const std::string& x,
                               double scale = 1.0,
                               bool color = true) {
  xtensor3d res = process(x, scale, color);
  return res;
}

// [[Rcpp::export]]
rtensor4d cpp_process_json_vector(const std::vector<std::string>& x,
                                  double scale = 1.0,
                                  bool color = false) {
  size_t n = x.size();
  size_t dim = floor(SIZE * scale);
  size_t channels = color ? 3 : 1;
  xtensor4d res({n, dim, dim, channels});
  parallelFor(0, n, [&x, &res, scale, color](int i) {
    xtensor3d tmp = process(x[i], scale, color);
    auto view = xt::view(res, i, xt::all(), xt::all(), xt::all());
    view = tmp;
  });
  return res;
}
Ky kod duhet të vendoset në skedarin src/cv_xt.cpp dhe të kompilohet me komandën Rcpp::sourceCpp(file = "src/cv_xt.cpp", env = .GlobalEnv); gjithashtu, do të nevojitet nlohmann/json.hpp nga . Kodi është i ndarë në disa funksione:
to_xt— funksioni i templatuar për transformimin e matricës së imazhit (cv::Mat) në tensorxt::xtensor;parse_json— funksioni analizon të dhënat JSON, nxjerr koordinatat e pikave, duke i paketuar ato në një vektor;ocv_draw_lines— nga vektori i pikave të marra tërheq linja me ngjyra të ndryshme;process— kombinon funksionet e mësipërme, plus shton mundësinë e shkallëzimit të imazhit të marrë;cpp_process_json_str— mbështjellëse mbi funksioninprocess, e cila eksporton rezultatin në objektin R (në një array të shumëdimensionale);cpp_process_json_vector— mbështjellëse mbi funksionincpp_process_json_str, që lejon përpunimin e një vektori string në mënyrë shumëprocesore.
Për vizatimin e linjave me ngjyra, është përdorur modeli i ngjyrave HSV me konvertim të mëvonshëm në RGB. Le ta testojmë rezultatin:
arr <- cpp_process_json_str(tmp_data[4, drawing])
dim(arr)
# [1] 256 256   3
plot(magick::image_read(arr)) 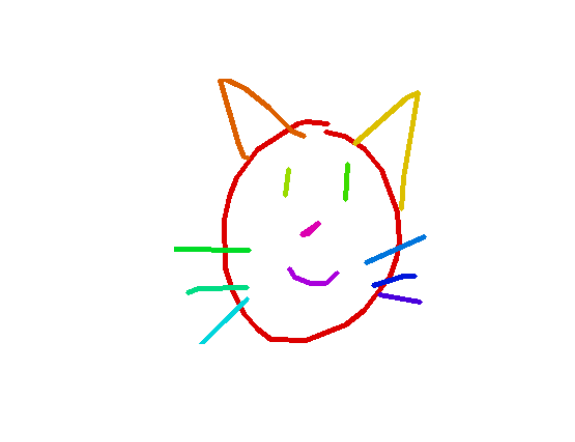
Krahasoni shpejtësinë e implementimeve në R dhe C++
res_bench <- bench::mark(
  r_process_json_str(tmp_data[4, drawing], scale = 0.5),
  cpp_process_json_str(tmp_data[4, drawing], scale = 0.5),
  check = FALSE,
  min_iterations = 100
)
# Parametrat e benchmark-ut
cols <- c("expression", "min", "median", "max", "itr/sec", "total_time", "n_itr")
res_bench[, cols]

#   shprehje                min     median       max `itr/sec` total_time  n_itr
#
# 1 r_process_json_str     3.49ms     3.55ms    4.47ms      273.      490ms    134
# 2 cpp_process_json_str   1.94ms     2.02ms    5.32ms      489.      497ms    243

library(ggplot2)
# Kryerja e matjes
res_bench <- bench::press(
  batch_size = 2^(4:10),
  {
    .data <- tmp_data[sample(seq_len(.N), batch_size), drawing]
    bench::mark(
      r_process_json_vector(.data, scale = 0.5),
      cpp_process_json_vector(.data,  scale = 0.5),
      min_iterations = 50,
      check = FALSE
    )
  }
)

res_bench[, cols]

#    shprehje   batch_size      min   median      max `itr/sec` total_time n_itr
#                  <bch:tm> <bch:tm> <bch:tm>     <dbl>   <bch:tm> <int>
#  1 r                   16   50.61ms  53.34ms  54.82ms    19.1     471.13ms     9
#  2 cpp                 16    4.46ms   5.39ms   7.78ms   192.      474.09ms    91
#  3 r                   32   105.7ms 109.74ms 212.26ms     7.69        6.5s    50
#  4 cpp                 32    7.76ms  10.97ms  15.23ms    95.6     522.78ms    50
#  5 r                   64  211.41ms 226.18ms 332.65ms     3.85      12.99s    50
#  6 cpp                 64   25.09ms  27.34ms  32.04ms    36.0        1.39s    50
#  7 r                  128   534.5ms 627.92ms 659.08ms     1.61      31.03s    50
#  8 cpp                128   56.37ms  58.46ms  66.03ms    16.9        2.95s    50
#  9 r                  256     1.15s    1.18s    1.29s     0.851     58.78s    50
# 10 cpp                256  114.97ms 117.39ms 130.09ms     8.45       5.92s    50
# 11 r                  512     2.09s    2.15s    2.32s     0.463       1.8m    50
# 12 cpp                512  230.81ms  235.6ms 261.99ms     4.18      11.97s    50
# 13 r                 1024        4s    4.22s     4.4s     0.238       3.5m    50
# 14 cpp               1024  410.48ms 431.43ms 462.44ms     2.33      21.45s    50

ggplot(res_bench, aes(x = factor(batch_size), y = median,
                      group =  expression, color = expression)) +
  geom_point() +
  geom_line() +
  ylab("koha mesatare, s") +
  theme_minimal() +
  scale_color_discrete(name = "", labels = c("cpp", "r")) +
theme(legend.position = "bottom") 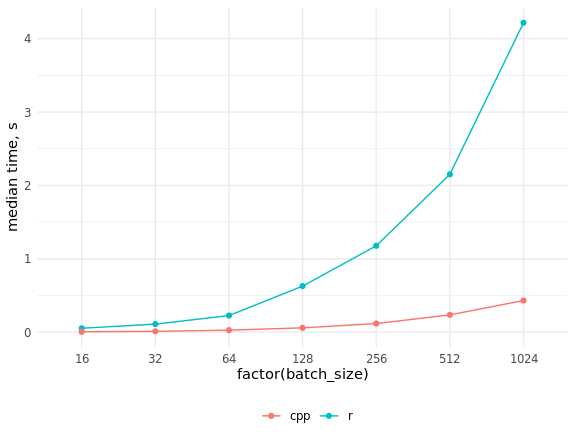
Siç e shohim, rritja e shpejtësisë ka qenë mjaft e konsiderueshme, dhe është e pamundur të arrihet kodi në C++ përmes paralelizimit të kodit në R.
3. Iteratoret për eksportimin e grupeve nga BD
R ka një reputacion të merituar si një gjuhë për përpunimin e të dhënave që ruhen në RAM, ndërsa Python ka tende të përpunimit iterativ të të dhënave, duke lejuar implementimin e lehtë dhe të shpejtë të llogaritjeve out-of-core (llogaritjeve duke përdorur kujtesën e jashtme). Një shembull klasik dhe aktual në kontekstin e detyrës që po përshkruajmë janë rrjetet e thella nervore, të trajnuara me metodën e zbritjes gradientike me një aproximim të gradientit në çdo hap përmes një grupi të vogël vëzhgimesh, ose mini-batch.
Kornizat për mësimin e thellë, të shkruara në Python, kanë klasa speciale që implementojnë iteraatorë për të dhënat: tabela, imazhe në dosje, formate binare etj. Mund të përdorim variante të gatshme ose të shkruajmë të nostra për detyra specifike. Në R, mund të përfitojmë nga të gjitha mundësitë e bibliotekës Python keras me të gjitha backend-et e tij përmes paketës me të njëjtin emër, e cila funksionon gjithashtu mbi paketën reticulate. E fundit meriton një artikull të madh të veçantë; ajo jo vetëm që lejon ekzekutimin e kodit Python nga R, por gjithashtu siguron transmetimin e objekteve midis sesioneve R dhe Python, duke kryer automatikisht të gjitha konvertimet e nevojshme të tipit.
Ne u shpëtuam nga nevoja për të ruajtur të dhënat të gjitha në RAM përmes përdorimit të MonetDBLite, të gjithë "punën e rrjetit nervor" do ta kryejë kod origjinal në Python, ne duhet vetëm të shkruajmë një iteraator për të dhënat, pasi nuk ka të gatshëm për këtë situatë as në R dhe as në Python. Kërkesat ndaj tij janë në thelb dy: ai duhet të kthejë grupe në një cikël të pafund dhe të ruajë gjendjen e tij midis iteracioneve (kjo e fundit në R realizohet në mënyrë të thjeshtë me ndihmën e closures). Më herët, ne duhej të konvertonim në mënyrë eksplicite array-t R në array numpy brenda iteraatorit, por versioni aktual i paketës keras e bën këtë vetë.
Iteraatori për të dhënat e trajnim dhe validim doli të ishte si më poshtë:
Iteraatori për të dhënat e trajnim dhe validim
train_generator <- function(db_connection = con,
                            samples_index,
                            num_classes = 340,
                            batch_size = 32,
                            scale = 1,
                            color = FALSE,
                            imagenet_preproc = FALSE) {
  # Проверка аргументов
  checkmate::assert_class(con, "DBIConnection")
  checkmate::assert_integerish(samples_index)
  checkmate::assert_count(num_classes)
  checkmate::assert_count(batch_size)
  checkmate::assert_number(scale, lower = 0.001, upper = 5)
  checkmate::assert_flag(color)
  checkmate::assert_flag(imagenet_preproc)

  # Перемешиваем, чтобы брать и удалять использованные индексы батчей по порядку
  dt <- data.table::data.table(id = sample(samples_index))
  # Проставляем номера батчей
  dt[, batch := (.I - 1L) %/% batch_size + 1L]
  # Оставляем только полные батчи и индексируем
  dt <- dt[, if (.N == batch_size) .SD, keyby = batch]
  # Устанавливаем счётчик
  i <- 1
  # Количество батчей
  max_i <- dt[, max(batch)]

  # Подготовка выражения для выгрузки
  sql <- sprintf(
    "PREPARE SELECT drawing, label_int FROM doodles WHERE id IN (%s)",
    paste(rep("?", batch_size), collapse = ",")
  )
  res <- DBI::dbSendQuery(con, sql)

  # Аналог keras::to_categorical
  to_categorical <- function(x, num) {
    n <- length(x)
    m <- numeric(n * num)
    m[x * n + seq_len(n)] <- 1
    dim(m) <- c(n, num)
    return(m)
  }

  # Замыкание
  function() {
    # Начинаем новую эпоху
    if (i > max_i) {
      dt[, id := sample(id)]
      data.table::setkey(dt, batch)
      # Сбрасываем счётчик
      i <<- 1
      max_i <<- dt[, max(batch)]
    }

    # ID для выгрузки данных
    batch_ind <- dt[batch == i, id]
    # Выгрузка данных
    batch <- DBI::dbFetch(DBI::dbBind(res, as.list(batch_ind)), n = -1)

    # Увеличиваем счётчик
    i <<- i + 1

    # Парсинг JSON и подготовка массива
    batch_x <- cpp_process_json_vector(batch$drawing, scale = scale, color = color)
    if (imagenet_preproc) {
      # Шкалирование c интервала [0, 1] на интервал [-1, 1]
      batch_x <- (batch_x - 0.5) * 2
    }

    batch_y <- to_categorical(batch$label_int, num_classes)
    result <- list(batch_x, batch_y)
    return(result)
  }
}
Funksioni merr si input një variabël me lidhjen me DB, numrat e rreshtave të përdorur, numrin e klasave, madhësinë e grupit, shkallën (scale = 1 përgjigjet vizatimit të imazheve 256x256 piksel, scale = 0.5 — 128x128 piksel), indikatorin e ngjyrave (color = FALSE caktimi i vizatimit në nuanca gri, kur përdoret ngjyra = E VERTETË çdo vizatim tërhiqet me një ngjyrë të re) dhe një indikator përprocesimi për rrjetet e trajnuara paraprakisht në imagenet. I fundit është i nevojshëm për të normalizuar vlerat e pikselëve nga intervali [0, 1] në intervalin [-1, 1], i cili është përdorur gjatë trajnimit që shoqëron keras modelet.
Funksioni i jashtëm përmban një kontroll të tipeve të argumenteve, një tabelë data.table me numra të linjave të përzier rastësisht nga samples_index dhe numra batch, një numër dhe numrin maksimal të batch-esh, si dhe një shprehje SQL për nxjerrjen e të dhënave nga DB. Shtesë, ne kemi përcaktuar brenda një analog të shpejtë të funksionit keras::to_categorical(). Ne përdorëm pothuajse të gjitha të dhënat për trajnimin, duke lënë gjysmën e përqindit për validim, prandaj madhësia e epokës ishte e kufizuar nga parametri steps_per_epoch në thirrje keras::fit_generator(), dhe kushti nëse (i > max_i) u aktivizua vetëm për iteratorin e validimit.
Në funksionin e brendshëm ndodhi përzgjedhja e indekseve të linjave për batch-in e ardhshëm, nxjerrja e regjistrimeve nga DB me rritjen e numrit të batch-eve, analizimi i JSON-ve (funksioni cpp_process_json_vector(), shkruar në C++) dhe krijimi i masivave që përputhen me imazhet. Pastaj krijohen vektorë one-hot me etiketat e klasave, masivët me vlerat e pikselëve dhe etiketat bashkohen në një listë, që është vlera e rikthyer. Për të përshpejtuar punën, u përdor krijimi i indekseve në tabela data.table dhe modifikimi me referencë - pa këto "truket" e paketës data.table është mjaft e vështirë të imagjinohet puna efektive me ndonjë volum të konsiderueshëm të të dhënave në R.
Rezultatet e matjeve të shpejtësisë së punës në një Core i5 laptop duken si më poshtë:
Benchmark i iteratorit
library(Rcpp)
library(keras)
library(ggplot2)

source("utils/rcpp.R")
source("utils/keras_iterator.R")

con <- DBI::dbConnect(drv = MonetDBLite::MonetDBLite(), Sys.getenv("DBDIR"))

ind <- seq_len(DBI::dbGetQuery(con, "SELECT count(*) FROM doodles")[[1L]])
num_classes <- DBI::dbGetQuery(con, "SELECT max(label_int) + 1 FROM doodles")[[1L]]

# Indices for the training set
train_ind <- sample(ind, floor(length(ind) * 0.995))
# Indices for the validation set
val_ind <- ind[-train_ind]
rm(ind)
# Scaling factor
scale <- 0.5

# Benchmark measurement
res_bench <- bench::press(
  batch_size = 2^(4:10),
  {
    it1 <- train_generator(
      db_connection = con,
      samples_index = train_ind,
      num_classes = num_classes,
      batch_size = batch_size,
      scale = scale
    )
    bench::mark(
      it1(),
      min_iterations = 50L
    )
  }
)
# Benchmark parameters
cols <- c("batch_size", "min", "median", "max", "itr/sec", "total_time", "n_itr")
res_bench[, cols]

#   batch_size      min   median      max `itr/sec` total_time n_itr
#
# 1         16     25ms  64.36ms   92.2ms     15.9       3.09s    49
# 2         32   48.4ms 118.13ms 197.24ms     8.17       5.88s    48
# 3         64   69.3ms 117.93ms 181.14ms     8.57       5.83s    50
# 4        128  157.2ms 240.74ms 503.87ms     3.85      12.71s    49
# 5        256  359.3ms 613.52ms 988.73ms     1.54       30.5s    47
# 6        512  884.7ms    1.53s    2.07s     0.674      1.11m    45
# 7       1024     2.7s    3.83s    5.47s     0.261      2.81m    44

ggplot(res_bench, aes(x = factor(batch_size), y = median, group = 1)) +
    geom_point() +
    geom_line() +
    ylab("median time, s") +
    theme_minimal()

DBI::dbDisconnect(con, shutdown = TRUE) 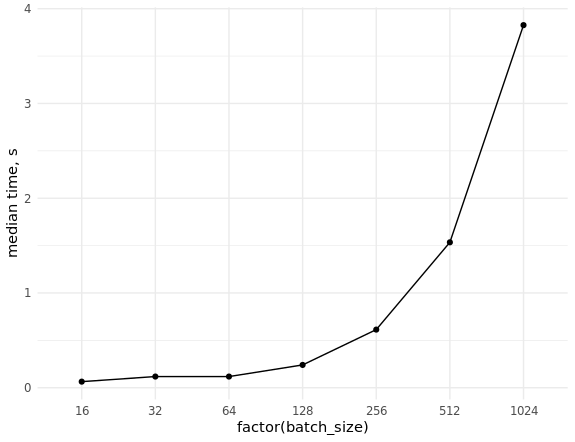
Nëse keni një sasi të mjaftueshme RAM-i, mund të përshpejtoni ndjeshëm punën e bazës së dhënave duke e transferuar atë në këtë RAM (për detyrën tonë janë të mjaftueshme 32 GB). Në Linux, sipas të parës normë, montohen ndarjet /dev/shm, që zë deri në gjysmën e kapacitetit të RAM-it. Mund të përkushtoni edhe më shumë, duke redaktuar /etc/fstab, për të formuar një shënim si tmpfs /dev/shm tmpfs defaults,size=25g 0 0. Sigurisht që duhet të rindezni dhe të kontrolloni rezultatin, duke ekzekutuar komandën df -h.
Iteratori për të dhënat testuese duket shumë më i thjeshtë, pasi seti testues i të dhënave vendoset tërësisht në RAM:
Iteratori për të dhënat testuese
test_generator <- function(dt,
                           batch_size = 32,
                           scale = 1,
                           color = FALSE,
                           imagenet_preproc = FALSE) {

  # Проверка аргументов
  checkmate::assert_data_table(dt)
  checkmate::assert_count(batch_size)
  checkmate::assert_number(scale, lower = 0.001, upper = 5)
  checkmate::assert_flag(color)
  checkmate::assert_flag(imagenet_preproc)

  # Проставляем номера батчей
  dt[, batch := (.I - 1L) %/% batch_size + 1L]
  data.table::setkey(dt, batch)
  i <- 1
  max_i <- dt[, max(batch)]

  # Замыкание
  function() {
    batch_x <- cpp_process_json_vector(dt[batch == i, drawing],
                                       scale = scale, color = color)
    if (imagenet_preproc) {
      # Шкалирование c интервала [0, 1] на интервал [-1, 1]
      batch_x <- (batch_x - 0.5) * 2
    }
    result <- list(batch_x)
    i <<- i + 1
    return(result)
  }
}
4. Zgjedhja e arkitekturës së modelit
E para nga arkitekturat e përdorura ishte , karakteristikat e së cilës janë trajtuar në mesazhin. Ajo është pjesë e paketës standarde keras dhe, për rrjedhojë, është e aksesueshme në pakon me të njëjtin emër për R. Por kur u përpoqëm ta përdorim atë me imazhe njëkanale, u zbulua një gjë e çuditshme: tensori hyrës duhet gjithnjë të ketë dimensionin (batch, height, width, 3), pra të thënë, numri i kanaleve nuk mund të ndryshohet. Në Python nuk ka një kufizim të tillë, ndaj ne u nxituam dhe krijuam implementimin tonë të kësaj arkitekture, duke ndjekur artikullin origjinal (pa dropout-in që ekziston në variantin e keras-it):
Arkitektura mobilenet v1
library(keras)

top_3_categorical_accuracy <- custom_metric(
    name = "top_3_categorical_accuracy",
    metric_fn = function(y_true, y_pred) {
         metric_top_k_categorical_accuracy(y_true, y_pred, k = 3)
    }
)

layer_sep_conv_bn %
  layer_batch_normalization() %>%
  layer_activation_relu() %>%
  layer_conv_2d(
    filters = filters * alpha,
    kernel_size = c(1, 1),
    strides = c(1, 1)
  ) %>%
  layer_batch_normalization() %>%
  layer_activation_relu()
}

get_mobilenet_v1 <- function(input_shape = c(224, 224, 1),
                             num_classes = 340,
                             alpha = 1,
                             depth_multiplier = 1,
                             optimizer = optimizer_adam(lr = 0.002),
                             loss = "categorical_crossentropy",
                             metrics = c("categorical_crossentropy",
                                         top_3_categorical_accuracy)) {

  inputs <- layer_input(shape = input_shape)

  outputs %
    layer_conv_2d(filters = 32, kernel_size = c(3, 3), strides = c(2, 2), padding = "same") %>%
    layer_batch_normalization() %>%
    layer_activation_relu() %>%
    layer_sep_conv_bn(filters = 64, strides = c(1, 1)) %>%
    layer_sep_conv_bn(filters = 128, strides = c(2, 2)) %>%
    layer_sep_conv_bn(filters = 128, strides = c(1, 1)) %>%
    layer_sep_conv_bn(filters = 256, strides = c(2, 2)) %>%
    layer_sep_conv_bn(filters = 256, strides = c(1, 1)) %>%
    layer_sep_conv_bn(filters = 512, strides = c(2, 2)) %>%
    layer_sep_conv_bn(filters = 512, strides = c(1, 1)) %>%
    layer_sep_conv_bn(filters = 512, strides = c(1, 1)) %>%
    layer_sep_conv_bn(filters = 512, strides = c(1, 1)) %>%
    layer_sep_conv_bn(filters = 512, strides = c(1, 1)) %>%
    layer_sep_conv_bn(filters = 512, strides = c(1, 1)) %>%
    layer_sep_conv_bn(filters = 1024, strides = c(2, 2)) %>%
    layer_sep_conv_bn(filters = 1024, strides = c(1, 1)) %>%
    layer_global_average_pooling_2d() %>%
    layer_dense(units = num_classes) %>%
    layer_activation_softmax()

    model % compile(
      optimizer = optimizer,
      loss = loss,
      metrics = metrics
    )

    return(model)
}
Disavantazhet e këtij qasje janë të dukshme. Dëshirojmë të kontrollojmë shumë modele, por nuk duam të shkruajmë çdo arkitekturë nga e para. Gjithashtu, ne ishim të privuar nga mundësia për të përdorur peshat e modeleve të para-përshtatura në imagenet. Si zakonisht, studimi i dokumentacionit ndihmoi. Funksioni get_config() lejon të marrësh një përshkrim të modelit në një format të modifikueshëm (base_model_conf$layers — një listë e zakonshme R-ove), dhe funksioni from_config() bën transformimin e kthyer në objektin model:
base_model_conf <- get_config(base_model)
base_model_conf$layers[[1]]$config$batch_input_shape[[4]] <- 1L
base_model <- from_config(base_model_conf)
Tani nuk është e vështirë të shkruash një funksion universale për të marrë çdo një nga modelet e ofruara me pesha të stërvitur në imagenet ose pa to: keras Funksioni për ngarkimin e arkitekturave të gatshme
get_model <- function(name = "mobilenet_v2", input_shape = NULL, weights = "imagenet", pooling = "avg", num_classes = NULL, optimizer = keras::optimizer_adam(lr = 0.002), loss = "categorical_crossentropy", metrics = NULL, color = TRUE, compile = FALSE) { # Kontrollimi i argumenteve checkmate::assert_string(name) checkmate::assert_integerish(input_shape, lower = 1, upper = 256, len = 3) checkmate::assert_count(num_classes) checkmate::assert_flag(color) checkmate::assert_flag(compile)# Marrim objektin nga paketa keras model_fun <- get0(paste0("application_", name), envir = asNamespace("keras")) # Kontrolli i ekzistencës së objektit në paketë if (is.null(model_fun)) { stop("Modeli ", shQuote(name), " nuk u gjet.", call. = FALSE) }base_model <- model_fun( input_shape = input_shape, include_top = FALSE, weights = weights, pooling = pooling )# Nëse imazhi nuk është me ngjyra, ndryshojmë dimensionalitetin e hyrjes if (!color) { base_model_conf <- keras::get_config(base_model) base_model_conf$layers[[1]]$config$batch_input_shape[[4]] <- 1L base_model <- keras::from_config(base_model_conf) }predictions <- keras::get_layer(base_model, "global_average_pooling2d_1")$output predictions <- keras::layer_dense(predictions, units = num_classes, activation = "softmax") model <- keras::keras_model( inputs = base_model$input, outputs = predictions )if (compile) { keras::compile( object = model, optimizer = optimizer, loss = loss, metrics = metrics ) }return(model) }
Kur përdoren imazhe me një kanal, pesha të stërvitura nuk përdoren. Kjo do të ishte mundur të rregullohej: me funksioninget_weights() për të marrë peshat e modelit si një listë nga masat R, të ndryshohet dimensionaliteti i elementit të parë të kësaj liste (duke marrë ndonjë kanal ngjyre ose duke i mesatarizuar të tre), dhe pastaj të ngarkohen përsëri peshat në model me funksionin set_weights() . Ne këtë funksionalitet nuk e shtuam, sepse në këtë fazë tashmë ishte e qartë se ishte më produktive të punonim me imazhe me ngjyra.. Ne e kemi shtuar këtë funksionalitet, pasi në këtë fazë ishte e qartë se ishte më produktive të punonim me imazhe me ngjyra.
Ne kemi realizuar shumicën e eksperimentve duke përdorur versionet 1 dhe 2 të mobilenet, si dhe resnet34. Në këtë garë, arkitektura më moderne si SE-ResNeXt ka shfaqur rezultate të mira. Fatkeqësisht, nuk kishim implementime të gatshme, ndërsa ato tona nuk i kemi shkruar (por do t'i shkruajmë patjetër).
5. Parametrizimi i skenarëve
Për lehtësi, tërë kodi për nisjen e trajnimit është organizuar si një skenar i vetëm, i parametrizuar me në mënyrë të tillë:
doc <- '
Përdorimi:
  train_nn.R --help
  train_nn.R --list-models
  train_nn.R [opsione]

Opsionet:
  -h --help                   Shfaq këtë mesazh.
  -l --list-models            Liste modelet në dispozicion.
  -m --model=          Emri i modelit të rrjetit neural [default: mobilenet_v2].
  -b --batch-size=      Madhësia e grupit [default: 32].
  -s --scale-factor=   Faktori i shkallës [default: 0.5].
  -c --color                  Përdor linja me ngjyra [default: FALSE].
  -d --db-dir=          Rruga deri në drejtorinë e bazës së të dhënave [default: Sys.getenv("db_dir")].
  -r --validate-ratio= Raporti i mostrave për verifikim [default: 0.995].
  -n --n-gpu=         Numri i GPU-ve [default: 1].
'
args <- docopt::docopt(doc)
Paketa docopt paraqet një realizim për R. Me ndihmën e tij, skenarët nisin me urdhra të thjeshtë si Rscript bin/train_nn.R -m resnet50 -c -d /home/andrey/doodle_db ose ./bin/train_nn.R -m resnet50 -c -d /home/andrey/doodle_db, nëse skedari train_nn.R është ekzekutues (ky urdhër do të nisë trajnimin e modelit resnet50 në imazhe me ngjyra prej 128x128 piksel, baza e të dhënave duhet të jetë në dosjen /home/andrey/doodle_db). Në listën mund të shtoni shpejtësinë e mësimit, llojin e optimizuesit dhe çdo parametër tjetër që mund të konfigurohet. Gjatë përgatitjes për publikim, u zbulua që arkitektura mobilenet_v2 nga versioni aktual keras në R nuk mund të përdoret Ky qasje lejojti që të nxiten eksperimentet me modele të ndryshme më shpejt sesa nisja tradicionale e skenarëve në RStudio (si një mundësi alternative, përmendim paketën
tfruns 6. Dockerizimi i skenarëve
Ne përdorëm docker për të siguruar portabilitetin e ambientit për trajnimin e modeleve midis anëtarëve të ekipit dhe për shpërndarjen e shpejtë në cloud. Të fillosh të njohësh këtë mjet relativisht të pazakontë për programuesin R mund të fillosh me
seritë e publikimeve ose me kursin video .
Docker lejon lejon krijon imazhe të veta "nga e para", ashtu si dhe përdor imazhe të tjera si bazë për krijimin e të vetëve. Në analizimin e mundësive të disponueshme, ne arritëm në përfundimin se instalimi i driverëve NVIDIA, CUDA+cuDNN dhe bibliotekave Python është një pjesë mjaft voluminoze e imazhit, dhe vendosëm të përdorim imazhin zyrtar si bazë tensorflow/tensorflow:1.12.0-gpu, duke shtuar aty paketat e nevojshme R.
Skeda përfundimtare e Docker doli kështu:
Dockerfile
FROM tensorflow/tensorflow:1.12.0-gpu

MAINTAINER Artem Klevtsov

SHELL ["/bin/bash", "-c"]

ARG LOCALE="en_US.UTF-8"
ARG APT_PKG="libopencv-dev r-base r-base-dev littler"
ARG R_BIN_PKG="futile.logger checkmate data.table rcpp rapidjsonr dbi keras jsonlite curl digest remotes"
ARG R_SRC_PKG="xtensor RcppThread docopt MonetDBLite"
ARG PY_PIP_PKG="keras"
ARG DIRS="/db /app /app/data /app/models /app/logs"

RUN source /etc/os-release &&
    echo "deb https://cloud.r-project.org/bin/linux/ubuntu ${UBUNTU_CODENAME}-cran35/" > /etc/apt/sources.list.d/cran35.list &&
    apt-key adv --keyserver keyserver.ubuntu.com --recv-keys E084DAB9 &&
    add-apt-repository -y ppa:marutter/c2d4u3.5 &&
    add-apt-repository -y ppa:timsc/opencv-3.4 &&
    apt-get update &&
    apt-get install -y locales &&
    locale-gen ${LOCALE} &&
    apt-get install -y --no-install-recommends ${APT_PKG} &&
    ln -s /usr/lib/R/site-library/littler/examples/install.r /usr/local/bin/install.r &&
    ln -s /usr/lib/R/site-library/littler/examples/install2.r /usr/local/bin/install2.r &&
    ln -s /usr/lib/R/site-library/littler/examples/installGithub.r /usr/local/bin/installGithub.r &&
    echo 'options(Ncpus = parallel::detectCores())' >> /etc/R/Rprofile.site &&
    echo 'options(repos = c(CRAN = "https://cloud.r-project.org"))' >> /etc/R/Rprofile.site &&
    apt-get install -y $(printf "r-cran-%s " ${R_BIN_PKG}) &&
    install.r ${R_SRC_PKG} &&
    pip install ${PY_PIP_PKG} &&
    mkdir -p ${DIRS} &&
    chmod 777 ${DIRS} &&
    rm -rf /tmp/downloaded_packages/ /tmp/*.rds &&
    rm -rf /var/lib/apt/lists/*

COPY utils /app/utils
COPY src /app/src
COPY tests /app/tests
COPY bin/*.R /app/

ENV DBDIR="/db"
ENV CUDA_HOME="/usr/local/cuda"
ENV PATH="/app:${PATH}"

WORKDIR /app

VOLUME /db
VOLUME /app

CMD bash
Për lehtësinë e përdorimit, paketat e përdorura janë nxjerrë në variabla; pjesa kryesore e skripteve të shkruara kopjohet brenda konteinerëve gjatë ndërtimit. Gjithashtu, ne ndryshuam shell-in në /bin/bash për lehtësinë e përdorimit të përmbajtjes /etc/os-release. Kjo eviton nevojën për të specifikuar versionin e OS në kod.
Për më tepër, u shkrua një skript i vogël bash, i cili lejon nisjen e konteinerit me komanda të ndryshme. Për shembull, këto mund të jenë skripta për trajnim të rrjeteve neuronale, të vendosura më parë brenda konteinerit, ose edhe një shell për debuggim dhe monitorim të funksionimit të konteinerit:
Skripta për nisjen e konteinerit
#!/bin/sh

DBDIR=${PWD}/db
LOGSDIR=${PWD}/logs
MODELDIR=${PWD}/models
DATADIR=${PWD}/data
ARGS="--runtime=nvidia --rm -v ${DBDIR}:/db -v ${LOGSDIR}:/app/logs -v ${MODELDIR}:/app/models -v ${DATADIR}:/app/data"

if [ -z "$1" ]; then
    CMD="Rscript /app/train_nn.R"
elif [ "$1" = "bash" ]; then
    ARGS="${ARGS} -ti"
else
    CMD="Rscript /app/train_nn.R $@"
fi

docker run ${ARGS} doodles-tf ${CMD}
Nëse ky bash-skript ekzekutohet pa parametra, brenda kontejnerit do të thirret skripti train_nn.R me vlerat e paracaktuar; nëse argumenti i parë pozicional është "bash", atëherë kontejneri do të nisë në modin interaktiv me shell-in e komandave. Në të gjitha rastet e tjera, ndodhin zëvendësimet e vlerave të argumenteve pozicionalë: CMD="Rscript /app/train_nn.R $@".
Duhet të theksohet se direktoritë me të dhëna burimore dhe bazën e të dhënave, si dhe direktoria për ruajtjen e modeleve të stërvitura montohen brenda kontejnerit nga sistemi host, që lejon qasje në rezultatet e punës së skripteve pa ndonjë manipulim të panevojshëm.
7. Përdorimi i disa GPU-ve në Google Cloud
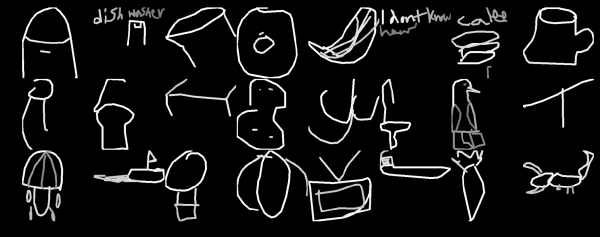
Një nga karakteristikat e garës ishin të dhënat shumë të zhurmshme (shihni imazhin kryesor, të marrë nga @Leigh.plt në ODS-slack). Të përballesh me këtë ndihmojnë grupet e mëdha, dhe ne pas eksperimenteve në PC me 1 GPU vendosëm të mësojmë trajnimin e modeleve me disa GPU në cloud. Përdorëm GoogleCloud () për shkak të zgjedhjes së madhe të konfiguracioneve të disponueshme, çmimeve të arsyeshme dhe bonusit prej $300. Nga lakmia porosita një instancë me 4xV100 me SSD dhe shumë RAM, dhe kjo ishte një gabim i madh. Paratë një makinë e tillë i konsumon shpejt, në eksperimente pa një pipeline të provuar mund të shkatërrohesh. Për qëllime mësimore është më mirë të merret K80. Ndërsa një sasi e madhe RAM-i doli e dobishme - SSD-ja e cloud-it nuk e impresionoi me shpejtësinë, prandaj baza e të dhënave për çdo nisje të instancës e transferonim në dev/shm.
Fragmenti më interesant i kodit është ai që merret me përdorimin e disa GPU-ve. Fillimisht modeli krijohet në CPU duke përdorur menaxherin e kontekstit, krejt si në Python:
with(tensorflow::tf$device("/cpu:0"), {
  model_cpu <- get_model(
    name = model_name,
    input_shape = input_shape,
    weights = weights,
    metrics =(top_3_categorical_accuracy,
    compile = FALSE
  )
})
Më pas modeli i pa kompiluar (kjo është e rëndësishme) kopjohet në numrin e caktuar të GPU-ve të disponueshëm, dhe vetëm pas kësaj kompiluar:
model <- keras::multi_gpu_model(model_cpu, gpus = n_gpu)
keras::compile(
  object = model,
  optimizer = keras::optimizer_adam(lr = 0.0004),
  loss = "categorical_crossentropy",
  metrics = c(top_3_categorical_accuracy)
)
Përdorimi klasik i ngrirjes së të gjitha niveleve, përveç atij të fundit, stërvitjes së nivelit të fundit, ngrirjes dhe stërvitjes së modelit si një tërësi për disa GPU nuk arriti të realizohet.
U ndoq stërvitja pa përdorimin e tensorboard, duke vetëm regjistrimin e logeve dhe ruajtjen e modeleve me emra informues pas çdo epoke:
Callbacks
# Шаблон имени файла лога
log_file_tmpl <- file.path("logs", sprintf(
  "%s_%d_%dch_%s.csv",
  model_name,
  dim_size,
  channels,
  format(Sys.time(), "%Y%m%d%H%M%OS")
))
# Шаблон имени файла модели
model_file_tmpl <- file.path("models", sprintf(
  "%s_%d_%dch_{epoch:02d}_{val_loss:.2f}.h5",
  model_name,
  dim_size,
  channels
))

callbacks_list <- list(
  keras::callback_csv_logger(
    filename = log_file_tmpl
  ),
  keras::callback_early_stopping(
    monitor = "val_loss",
    min_delta = 1e-4,
    patience = 8,
    verbose = 1,
    mode = "min"
  ),
  keras::callback_reduce_lr_on_plateau(
    monitor = "val_loss",
    factor = 0.5, # уменьшаем lr в 2 раза
    patience = 4,
    verbose = 1,
    min_delta = 1e-4,
    mode = "min"
  ),
  keras::callback_model_checkpoint(
    filepath = model_file_tmpl,
    monitor = "val_loss",
    save_best_only = FALSE,
    save_weights_only = FALSE,
    mode = "min"
  )
)
8. Në vend të përfundimit
Rëndësia e disa problemeve që kemi hasur, ende nuk është zgjidhur:
- në keras nuk ka një funksion të gatshëm për gjetjen automatike të shpejtësisë optimale të mësimit (analog me
lr_findernë bibliotekën fast.ai); duke bërë disa përpjekje, mund të portoni implementime të treta në R, për shembull, ; - si pasojë e pikës së mëparshme, nuk arritëm të përcaktonim shpejtësinë e duhur të mësimit kur përdorim disa GPU;
- mungojnë arkitekturat moderne të rrjeteve nervore, veçanërisht ato të paratëruara në imagenet;
- nuk ka një politikë cikli të vetëm dhe norma diskriminuese të mësimit (cosine annealing sipas kërkesës sonë ishte , faleminderit ).
Çfarë të dobishme arritëm të nxjerrim nga kjo garë:
- Me harduer relativisht të dobët, mund të punojmë pa dhimbje me të dhëna të konsiderueshme (duke tejkaluar përmasat e RAM-it). Paketa data.table kursen kujtesën përmes modifikimit in-place të tabelave, duke shmangur kopjimin e tyre, dhe me përdorimin e duhur të funksioneve të saj, pothuajse gjithmonë tregon shpejtësinë më të madhe midis të gjithë mjeteve të njohura për gjuhët skkript të njohura. Ruajtja e të dhënave në DB në shumë raste lejon që të mos mendojmë aspak për nevojën për të ngjeshur të gjithë datasetin në RAM.
- Funksionet e ngadalta në R mund të zëvendësohen me ato të shpejta në C++ përmes pakos Rcpp. Nëse përveç kësaj përdorim RcppThread ose RcppParallel, marrim implementime shumëplatformëshe me shumë threads, kështu që kodi në nivelin e R nuk ka nevojë të jetë paralel.
- Pakoja Rcpp mund të përdoret pa njohuri serioze në C++, minimumi i nevojshëm është shpjeguar . Skedarët e titujve për disa biblioteka të njohura C si xtensor janë të disponueshme në CRAN, që do të thotë se formohet një infrastrukturë për realizimin e projekteve që integrojnë në R kodin e lartë performant në C++. Një lehtësi shtesë është sintaksisja dhe analizatori statik i kodit në C++ në RStudio.
- docopt lejon ekzekutimin e skripteve të vetë-mjaftueshme me parameter. Kjo është e dobishme për përdorim në një server të largët, përfshirë nën docker. Është e papreferueshme të zhvilloni eksperimente shumë orëshe me trajnimin e rrjeteve nervore në RStudio, dhe instalimi i vetë IDE në server nuk është gjithmonë i justifikuar.
- Docker siguron portabilitetin e kodit dhe riprodhueshmërinë e rezultateve midis zhvilluesve me versione të ndryshme të OS-së dhe librarive, si dhe lehtësinë e nisjes në servera. Mund të nisni të gjithë pipeline për trajnim me vetëm një komandë.
- Google Cloud është një mënyrë e përballueshme për të eksperimentuar me harduer të shtrenjtë, por duhet të zgjidhni me kujdes konfigurimet.
- Të maturi shpejtësinë e funksioneve të veçanta të kodit është shumë e dobishme, veçanërisht kur përfshihen R dhe C++, dhe me paketën bench është gjithashtu shumë e lehtë.
Përgjithësisht, kjo përvojë ishte shumë e dobishme dhe ne vazhdojmë të punojmë për zgjidhjen e disa nga probleme të përmendura.
Burimi: habr.com
