

Preludë
Ky artikull i kushtohet pemëve binarë të kërkimit. Së fundmi kam shkruar një artikull mbi Aty nuk u përqendrova shumë te pemët binarë, sepse metodat e kërkimit, injektimit, dhe fshirjes nuk ishin të rëndësishme. Tani vendosa të shkruaj një artikull pikërisht mbi pemët. Le të fillojmë.
Një pemë është një strukturë të dhënash, e përbërë nga nyje të lidhura me mola. Mund të thuhet se një pemë është një rast special i grafit. Ja një shembull i një peme:
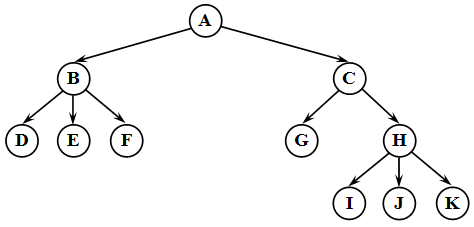
Kjo nuk është një pemë binare e kërkimit! Të gjitha në kat!
Terminologjia
Rrënja
Rrënja e pemës është nyja e saj më e lartë. Në shembullin e dhënë, kjo është nyja A. Në pemë, nga rrënja në çdo nyjë tjetër mund të çojë vetëm një rrugë! Në të vërtetë, çdo nyjë mund të konsiderohet si rrënja e nënpemës që i përket asaj nyje.
Prindërit/çfarëdo
Të gjitha nyjat, përveç atij rrënjë, kanë saktësisht një mola që çon lart te një nyjë tjetër. Nyja e vendosur lart se aktualja quhet prindi i kësaj nyje. Nyja e vendosur poshtë aktuales dhe e lidhur me të quhet çfarëdo i kësaj nyje. Le të shohim me një shembull. Të marrim nyjën B, atëherë prindi i saj do të jetë nyja A, dhe çfarëdo do të jenë nyjat D, E, dhe F.
Fletë
Një nyjë që nuk ka çfarëdo do të quhet gjethe e pemës. Në shembullin e dhënë, gjethet do të jenë nyjat D, E, F, G, I, J, K.
Kjo është terminologjia kryesore. Konceptet e tjera do të shqyrtohen më tej. Pra, një pemë binar është një pemë në të cilën çdo nyjë ka jo më shumë se dy pasardhës. Siç e keni kuptuar, pema nga shembulli nuk do të jetë binare, pasi nyjat B dhe H kanë më shumë se dy pasardhës. Ja një shembull i një peme binare:
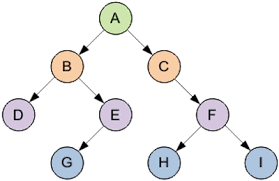
Në nyzat e pemës mund të ketë çdo informacion. Një pemë binare e kërkimit është një pemë binare, për të cilën karakterizohen këto prona:
- Të dy nënpemët — të majtë dhe të djathtë — janë pemë binarë kërkimesh.
- Të gjitha nyjat e nënpemës së majtë të ndonjë nyje X kanë vlera të çelësit më të vogla se vlera e çelësit të nyjës vetë X.
- Të gjitha nyjat e nënpemës së djathtë të ndonjë nyje X kanë vlera të çelësit më të madhe ose të barabartë me vlerën e çelësit të nyjës vetë X.
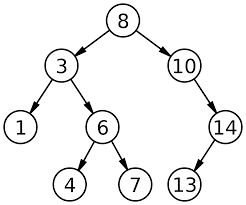
Çelësi — ndonjë karakteristikë e nyjës (p.sh., numri). Çelësi është i nevojshëm për t'i dhënë mundësinë të gjeni elementin në pemë që i përket atij çelësi. Ja një shembull i një peme binare kërkimi:
Paraqitja e pemës
Në vazhdim, do të jap disa (ndoshta, të pjesshme) copa kodi për të përmirësuar kuptimin tuaj. Kodi i plotë do të jetë në fund të artikullit.
Pema përbëhet nga nodet. Struktura e nodit:
public class Node<T> {
    private T data;
    private int key;
    private Node<T> leftChild;
    private Node<T> rightChild;

    public Node(T data, int key) {
        this.data = data;
        this.key = key;
    }
    public Node<T> getLeftChild() {
        return leftChild;
    }

    public Node<T> getRightChild() {
        return rightChild;
    }
//...metodat e tjera të nodit
}
Çdo nod ka dy pasardhës (është e mundur, që pasardhësit leftChild dhe/ose rightChild do të përmbajnë vlerën null). Ju, ndoshta, keni kuptuar se në këtë rast numri data — janë të dhënat e ruajtura në nod; key — është çelësi i nodit.
Tani që e kuptuam nodin, le të flasim për problemet aktuale me pemët. Këtu dhe më tej, me fjalën "pemë" do të kuptoj konceptin e pemës binare të kërkimit. Struktura e pemës binare:
public class BinaryTree<T> {
     private Node<T> root;

    //metodat e pemës
}
Si fushë klase, do të na nevojitet vetëm rrënja e pemës, pasi nga rrënja me ndihmën e metodave getLeftChild() dhe getRightChild() mund të arrijmë në çdo nod të pemës.
Algoritmet në pemë
Kërkimi
Supozoni se keni një pemë të ndërtuar. Si të gjeni elementin me çelësin key? Duhet të lëvizni gradualisht nga rrënja poshtë nëpër pemë dhe të krahasoni vlerën e key me çelësin e nodit të radhës: nëse key është më i vogël se çelësi i nodit të radhës, atëherë kaloni tek pasardhësi i majtë i nodit, nëse më i madh — tek i djathti, nëse çelësat janë të barabartë — nodi i kërkuar është gjetur! Kodi përkatës:
public Node<T> find(int key) {
    Node<T> current = root;
    while (current.getKey() != key) {
        if (key < current.getKey())
            current = current.getLeftChild();
        else
            current = current.getRightChild();
        if (current == null)
            return null;
    }
    return current;
}
Nëse current bëhet null, atëherë përfundimi arriti fundit të pemës (në nivelin konceptual, ndodheni në një vend joekzistues të pemës — pasardhësi i një gjethe).
Le të shqyrtojmë efikasitetin e algoritmit të kërkimit në një pemë të balancuar (pemë në të cilën nodet janë shpërndarë më shumë ose më pak në mënyrë të barabartë). Atëherë efikasiteti i kërkimit do të jetë O(log(n)), ku logaritet me bazën 2. Shikoni: nëse në një pemë të balancuar ka n elemente, atëherë kjo do të thotë se do të ketë log(n) me bazën 2 nivele të pemës. Dhe në kërkim, për një hap të ciklit, zbrisni një nivel.
Inserting
Nëse e keni kuptuar thelbin e kërkimit, atëherë nuk do t'ju duket e vështirë të kuptoni futjen. Thjesht duhet të zhyteni në fletën e pemës (sipas rregullave të zbritjes, përshkruara në kërkim) dhe të bëheni pasardhësi i saj — të majtë ose të djathtë, në varësi të çelësit. Realizimi:
   public void insert(T insertData, int key) {
        Node current = root;
        Node parent;
        Node newNode = new Node(insertData, key);
        if (root == null)
            root = newNode;
        else {
            while (true) {
                parent = current;
                if (key < current.getKey()) {
                    current = current.getLeftChild();
                    if (current == null) {
                         parent.setLeftChild(newNode);
                         return;
                    }
                }
                else {
                    current = current.getRightChild();
                    if (current == null) {
                        parent.setRightChild(newNode);
                        return;
                    }
                }
            }
        }
    }
Në këtë rast, gjithashtu duhet të ruajmë informacionin për prindin e nodit aktual. Kur current të bëhet null, në variablën parent do të jetë fletë e nevojshme.
Krahasimi i efikasitetit të futjes, sigurisht, do të jetë i njëjtë si ai i kërkimit — O(log(n)).
Çinstalim
Fshirja — operacioni më i komplikuar që do të duhet të kryhet me pemën. Është e qartë se së pari duhet të gjejmë elementin që do të fshijmë. Por çfarë pastaj? Nëse thjesht i japim referencës vlerën null, atëherë do të humbasim informacionin mbi nënpemën, rrënja e së cilës është ky nod. Metodat e fshirjes të pemës ndahen në tre raste.
Rasti i parë. Nodi i fshirë nuk ka pasardhës.
Nëse nodi i fshirë nuk ka pasardhës, atëherë kjo do të thotë se ai është një fletë. Prandaj, thjesht mund t'i japim fushave leftChild ose rightChild të prindit të tij vlerën null.
Rasti i dytë. Nodi i fshirë ka një pasardhës.
Ky rast gjithashtu nuk është shumë i komplikuar. Le të kthehemi në shembullin tonë. Supozoni se duhet të fshini elementin me çelës 14. Pajtohuni se qoftë se ai është pasardhësi i djathtë i nodit me çelës 10, çdo pasardhës i tij (në këtë rast i djathtë) do të ketë një çelës më të madh se 10, prandaj mund ta "prerë" lehtësisht nga pema, dhe prindin ta lidhim direkt me pasardhësin e nodit të fshirë, dmth, nodi me çelës 10 ta lidhim me nodin 13. Situata do të ishte e ngjashme nëse do të duhej të fshinim një nod që është pasardhës i majtë i prindit të tij. Mendoni për këtë vetë — është një analogji e saktë.
Rasti i tretë. Nodi ka dy pasardhës.
Rasti më kompleks. Do ta shqyrtojmë në një shembull të ri.
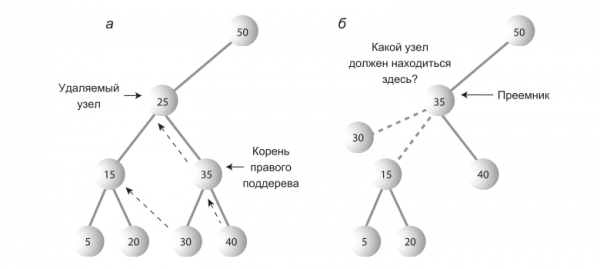
Kërkimi i pasardhësit.
Supozoni se duhet të fshihet një nod me çelës 25. Kush do ta zëvendësojë atë? Disa nga pasuesit e tij (pasardhësit ose pasardhësit e pasardhësve) duhet të bëhen pasardhës(ai që do të marrë vendin e nodit të fshirë).
Si të kuptojmë, kush duhet të bëhet pasardhës? Në mënyrë intuitore, është e qartë se ky nod në pemë, çelësi i të cilit është i pari më i madh se nodi i fshirë. Algoritmi përfshin të kaluar te pasardhësi i tij të djathtë (gjithmonë te i djathti, sepse u tha më parë se çelësi i pasardhësit është më i madh se çelësi i nodit të fshirë), dhe pastaj të kalojmë përmes zinxhirit të pasardhësve të majtë të këtij pasardhësi të djathtë. Në shembullin tonë, ne duhet të kalojmë te nodi me çelës 35, dhe pastaj të zbresim në mënyrë të vijueshme përmes zinxhirit të pasardhësve të majtë - në këtë rast, ky zinxhir përbëhet vetëm nga nodi me çelës 30. Teknikisht, ne po kërkojmë nodin më të vogël në grupin e nodave që janë më të mëdhenj se nodi që po kërkojmë.
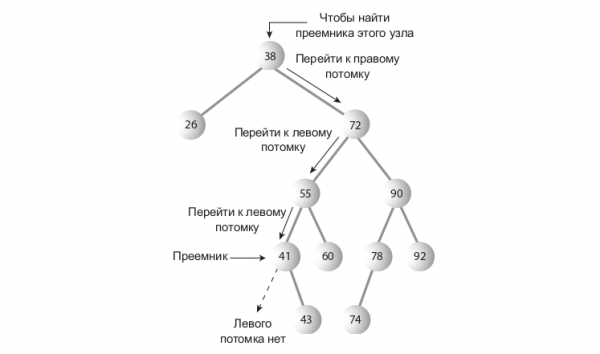
Kodi i metodës për gjetjen e pasardhësit:
    public Node<T> getSuccessor(Node<T> deleteNode) {
        Node<T> parentSuccessor = deleteNode; // prindi i pasardhësit
        Node<T> successor = deleteNode; // pasardhësi
        Node<T> current = successor.getRightChild(); // thjesht një nod "i kalueshëm"
        while (current != null) {
            parentSuccessor = successor;
            successor = current;
            current = current.getLeftChild();
        }
        // në daljen nga cikli kemi pasardhësin dhe prindin e pasardhësit
        if (successor != deleteNode.getRightChild()) { // nëse pasardhësi nuk përputhet me pasardhësin e djathtë të nodit të fshirë
            parentSuccessor.setLeftChild(successor.getRightChild()); // atëherë prindi i tij merr pasardhësin për të mos e humbur atë
            successor.setRightChild(deleteNode.getRightChild()); // lidhim pasardhësin me pasardhësin e djathtë të nodit të fshirë
        }
        return successor;
    }
Kodi i plotë i metodës fshi:
public boolean delete(int deleteKey) {
        Node current = root;
        Node parent = current;
        boolean isLeftChild = false; // Në varësi të asaj nëse nodi i fshirë është fëmija i majtë apo i djathtë i prindit të tij, variabli boolean isLeftChild do të marrë vlerën true ose false përkatësisht.
        while (current.getKey() != deleteKey) {
            parent = current;
            if (deleteKey < current.getKey()) {
                current = current.getLeftChild();
                isLeftChild = true;
            } else {
                isLeftChild = false;
                current = current.getRightChild();
            }
            if (current == null)
                return false;
        }

        if (current.getLeftChild() == null && current.getRightChild() == null) { // rast i parë
            if (current == root)
                current = null;
            else if (isLeftChild)
                parent.setLeftChild(null);
            else
                parent.setRightChild(null);
        }
        else if (current.getRightChild() == null) { // rast i dytë
            if (current == root)
                root = current.getLeftChild();
            else if (isLeftChild)
                parent.setLeftChild(current.getLeftChild());
            else
                current.setRightChild(current.getLeftChild());
        } else if (current.getLeftChild() == null) {
            if (current == root)
                root = current.getRightChild();
            else if (isLeftChild)
                parent.setLeftChild(current.getRightChild());
            else
                parent.setRightChild(current.getRightChild());
        }
        else { // rast i tretë
            Node successor = getSuccessor(current);
            if (current == root)
                root = successor;
            else if (isLeftChild)
                parent.setLeftChild(successor);
            else
                parent.setRightChild(successor);
        }
        return true;
    }
Kompleksiteti mund të aproksimohet me O(log(n)).
Kërkimi i maksimumit/minimumit në pemë
E qartë se si të gjeni vlerën minimale/maksimale në pemë — duhet të kaloni në mënyrë të renditur përmes zinxhirit të elemntëve të majtë/djathtë të pemës përkatësisht; kur të arrini në gjethe, ajo do të jetë elementi minimal/maksimal.
    public Node getMinimum(Node startPoint) {
        Node current = startPoint;
        Node parent = current;
        while (current != null) {
            parent = current;
            current = current.getLeftChild();
        }
        return parent;
    }

    public Node getMaximum(Node startPoint) {
        Node current = startPoint;
        Node parent = current;
        while (current != null) {
            parent = current;
            current = current.getRightChild();
        }
        return parent;
    }
Kompleksiteti — O(log(n))
Përshkimi simetrik
Përshkimi — vizitimi i çdo nodi të pemës me qëllim për të bërë një veprim me të.
Algoritmi i përshkimit simetrik recursiv:
- Bëni veprimin me fëmijën e majtë
- Bëni veprimin me vetë
- Bëni veprimin me fëmijën e djathtë
Kodi:
    public void inOrder(Node current) {
        if (current != null) {
            inOrder(current.getLeftChild());
            System.out.println(current.getData() + " ");//Here can be anything you want
            inOrder(current.getRightChild());
        }
    }
Përfundim
Finally! If I missed something or you have any comments, I look forward to them in the comments. As promised, here is the full code.
Node.java:
public class Node {
    private T data;
    private int key;
    private Node leftChild;
    private Node rightChild;

    public Node(T data, int key) {
        this.data = data;
        this.key = key;
    }

    public void setLeftChild(Node newNode) {
        leftChild = newNode;
    }

    public void setRightChild(Node newNode) {
        rightChild = newNode;
    }

    public Node getLeftChild() {
        return leftChild;
    }

    public Node getRightChild() {
        return rightChild;
    }

    public T getData() {
        return data;
    }

    public int getKey() {
        return key;
    }
}
BinaryTree.java:
publik klasa BinaryTree<T> {
    private Node<T> root;

    publik Node<T> find(int kyç) {
        Node<T> current = root;
        while (current.getKey() != kyç) {
            if (kyç < current.getKey())
                current = current.getLeftChild();
            else
                current = current.getRightChild();
            if (current == null)
                return null;
        }
        return current;
    }

    publik void insert(T insertData, int kyç) {
        Node<T> current = root;
        Node<T> parent;
        Node<T> newNode = new Node<>(insertData, kyç);
        if (root == null)
            root = newNode;
        else {
            while (true) {
                parent = current;
                if (kyç < current.getKey()) {
                    current = current.getLeftChild();
                    if (current == null) {
                         parent.setLeftChild(newNode);
                         return;
                    }
                }
                else {
                    current = current.getRightChild();
                    if (current == null) {
                        parent.setRightChild(newNode);
                        return;
                    }
                }
            }
        }
    }

    publik Node<T> getMinimum(Node<T> startPoint) {
        Node<T> current = startPoint;
        Node<T> parent = current;
        while (current != null) {
            parent = current;
            current = current.getLeftChild();
        }
        return parent;
    }

    publik Node<T> getMaximum(Node<T> startPoint) {
        Node<T> current = startPoint;
        Node<T> parent = current;
        while (current != null) {
            parent = current;
            current = current.getRightChild();
        }
        return parent;
    }

    publik Node<T> getSuccessor(Node<T> deleteNode) {
        Node<T> parentSuccessor = deleteNode;
        Node<T> successor = deleteNode;
        Node<T> current = successor.getRightChild();
        while (current != null) {
            parentSuccessor = successor;
            successor = current;
            current = current.getLeftChild();
        }

        if (successor != deleteNode.getRightChild()) {
            parentSuccessor.setLeftChild(successor.getRightChild());
            successor.setRightChild(deleteNode.getRightChild());
        }
        return successor;
    }

    publik boolean delete(int deleteKey) {
        Node<T> current = root;
        Node<T> parent = current;
        boolean isLeftChild = false;
        while (current.getKey() != deleteKey) {
            parent = current;
            if (deleteKey < current.getKey()) {
                current = current.getLeftChild();
                isLeftChild = true;
            } else {
                isLeftChild = false;
                current = current.getRightChild();
            }
            if (current == null)
                return false;
        }

        if (current.getLeftChild() == null && current.getRightChild() == null) {
            if (current == root)
                current = null;
            else if (isLeftChild)
                parent.setLeftChild(null);
            else
                parent.setRightChild(null);
        }
        else if (current.getRightChild() == null) {
            if (current == root)
                root = current.getLeftChild();
            else if (isLeftChild)
                parent.setLeftChild(current.getLeftChild());
            else
                current.setRightChild(current.getLeftChild());
        } else if (current.getLeftChild() == null) {
            if (current == root)
                root = current.getRightChild();
            else if (isLeftChild)
                parent.setLeftChild(current.getRightChild());
            else
                parent.setRightChild(current.getRightChild());
        }
        else {
            Node<T> successor = getSuccessor(current);
            if (current == root)
                root = successor;
            else if (isLeftChild)
                parent.setLeftChild(successor);
            else
                parent.setRightChild(successor);
        }
        return true;
    }

    publik void inOrder(Node<T> current) {
        if (current != null) {
            inOrder(current.getLeftChild());
            System.out.println(current.getData() + " ");
            inOrder(current.getRightChild());
        }
    }
}
P.S.
Degenerimi në O(n)
Shumica e jush mund të ketë vënë re: çfarë ndodh nëse e bëjmë pemën të paekuilibruar? Për shembull, nëse vendosim në pemë nodet me çelësa në rritje: 1,2,3,4,5,6... Atëherë, pema do të ngjajë më shumë si një listë e lidhur. Dhe po, pema do të humbasë strukturën e saj si pemë, duke humbur kështu edhe efikasitetin e qasjes në të dhëna. Kompleksiteti i operacioneve të kërkimit, shtimit, fshirjes do të bëhet si ai i një liste të lidhur: O(n). Kjo tregon një nga disavantazhet më të rëndësishme, sipas mendimit tim, të pemëve binarë.
Vetëm përdoruesit e regjistruar mund të marrin pjesë në anketë. , ju lutem.
Nuk kam qenë shumë kohë në Habr, dhe do të doja të dija, për cilat tema do të dëshironit të shihni më shumë artikuj?
Struktura të dhënash
Algoritmet (DP, rikthim, kompresim të dhënash etj.)
Zbatimi i strukturave të dhënash dhe algoritmeve në jetën reale
Programimi i aplikacioneve Android në Java
Programimi i aplikacioneve web në Java
Kanë votuar 2 përdorues. 1 përdorues abstenoi.
Burimi: habr.com
