

Sot tani shumica e produkteve softuerike zhvillohen në ekipe. Kushtet e suksesit të zhvillimit në grup mund të paraqiten si një skemë e thjeshtë.
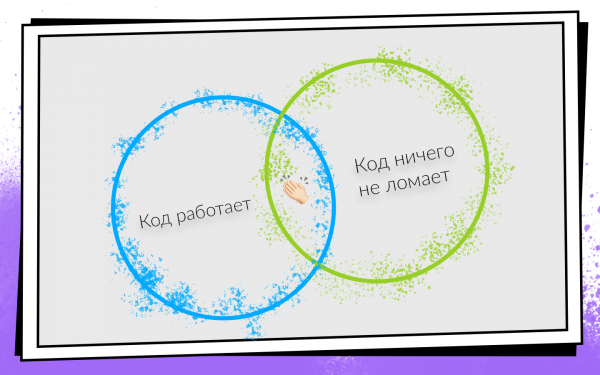
Pasi të keni shkruar kodin, duhet të siguroheni që ai:
- Funksionon.
- Nuk prish asgjë, duke përfshirë kodin që kanë shkruar kolegët tuaj.
Nëse të dy kushtet janë plotësuar, atëherë jeni në rrugën drejt suksesit. Për të kontrolluar lehtësisht këto kushte dhe për të mos dalë nga rruga e favorshme, u shpik Continuous Integration.
CI është një proces pune ku ju integroheni sa më shpesh që të jetë e mundur me kodin tuaj në kodin e përgjithshëm të produktit. Dhe jo vetëm që integroni, por gjithashtu kontrolloni vazhdimisht që gjithçka funksionon. Duke pasur parasysh se duhet të kontrolloni shumë dhe shpesh, ia vlen të mendoni për automatizimin. Mund ta kontrolloni gjithçka manualisht, por nuk ja vlen, dhe ja pse.
- Njerëzit janë të shtrenjtë. Një orë pune e çdo programuesi kushton më shumë se një orë pune e çdo serveri.
- Njerëzit gabojnë. Prandaj mund të ndodhin situata kur testet janë ekzekutuar në degën e gabuar ose është grumbulluar komiti i gabuar për testuesit.
- Njerëzit janë të përtacë. Herë pas here, kur përfundoj një detyrë, kam mendimin: "Çfarë të kontrolloj këtu? Kam shkruar dy tregues — me siguri gjithçka funksionon!" Mendoj se disa nga ju ndoshta ndiheni kështu herë pas here. Por kontrolli duhet të bëhet gjithmonë.
Si u implementua dhe u zhvillua Continuous Integration në ekipin e zhvillimit të telefonit celular të Avito, si kaluan nga 0 në 450 ndërtime në ditë, dhe çfarë ndërtojnë makinat e ndërtimit që realizojnë 200 orë në ditë, tregon Nikolai Nesterov () — pjesëmarrës në të gjitha ndryshimet evolucionare CI/CD të aplikacionit Android.
Rrëfimi është ndërtuar mbi shembujt e ekipit Android, por shumica e qasjeve janë të aplikueshme gjithashtu në iOS.
Dikur, në ekipin Android të Avito punonte një person. Po ashtu, ai sipas definicionit nuk kishte nevojë për asgjë nga Continuous Integration: nuk kishte me kë të integrohej.
Por aplikacioni po rritej, duke u shtuar gjithnjë e më shumë detyra, për pasojë, ekipi po rritej. Në një moment erdhi koha për të organizuar më formalisht procesin e integrimit të kodit. U vendos të përdoret Git flow.
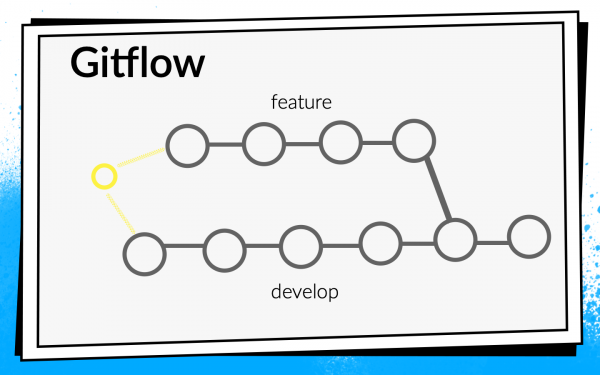
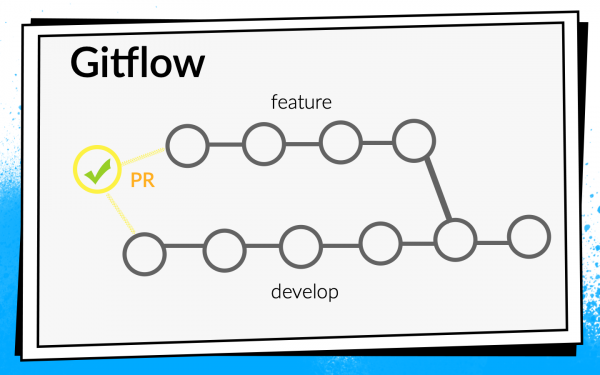
Koncepcioni Git flow është i njohur: në projekt ekziston një degë e përbashkët develop, dhe për çdo karakteristikë të re, zhvilluesit krijojnë një degë të veçantë, angazhojnë në të, e dërgojnë, dhe, kur dëshirojnë të integrojnë kodin e tyre në degën develop, hapin një pull request. Për të ndarë njohuri dhe për të diskutuar qasjet, ne kemi futur rishikimin e kodit, që do të thotë se kolegët duhet të verifikojnë dhe të konfirmojnë kodin e njëri-tjetrit.
Kontrollet
Të shohësh kodin me sytë e tua është e shkëlqyer, por nuk është e mjaftueshme. Prandaj, futen kontrollime automatike.
- Së pari kontrollojmë ndërtimin e ARC.
- Shumë teste Junit.
- Llogarisim mbulimin e kodit, përderisa ne jemi duke ekzekutuar testet.
Për të kuptuar se si duhet të ekzekuton këto kontrolle, do të shohim procesin e zhvillimit në Avito.
Në mënyrë skematike mund ta paraqesim kështu:
- Zhvilluesi shkruan kodin në laptopin e tij. Mund të ekzekutojë kontrollime integrimi pikërisht këtu — ose me një hook komit, ose thjesht duke drejtuar kontrollet në sfond.
- Pas që zhvilluesi ka dërguar kodin, ai hap një pull request. Që kodi i tij të kalojë në degën develop, është e domosdoshme të kalojë rishikimin e kodit dhe të mbledhë numrin e nevojshëm të konfirmimeve. Mund të përfshijmë kontroll dhe ndërtime këtu: derisa të gjitha ndërtimet të mos jenë të suksesshme, pull request nuk mund të integrohet.
- Pas që pull request është integruar dhe kodi ka shkuar në develop, mund të zgjedhim një kohë të përshtatshme: për shembull, natën, kur të gjitha serverat janë të lirë, dhe të ekzekutojmë kontrollet sa më shumë që të mundemi.
Askush nuk e pëlqeu të ekzekutonte kontrollet në laptopin e tij. Kur zhvilluesi përfundoi karakteristikën, ai dëshiron ta dërgojë sa më shpejt dhe të hapë pull request-in. Nëse në atë moment janë duke u ekzekutuar kontrolle të gjata, kjo jo vetëm që nuk është e këndshme, por gjithashtu ngadalëson zhvillimin: derisa laptopi të kryejë diçka, është e pamundur të punosh normalisht.
Na pëlqeu shumë të ekzekutojmë kontrollet natën, sepse ka shumë kohë dhe serverë, mund të kemi hapësirë. Por, fatkeqësisht, kur kodi i karakteristikës kalon në develop, zhvilluesi tashmë ka shumë më pak motivim për të rregulluar gabimet që CI ka gjetur. Herë pas here, gjeja se shihja në raportin e mëngjesit për të gjitha gabimet e gjetura, se do t'i rregulloja ndonjëherë më vonë, sepse tani në Jira ka një detyrë të re të shkëlqyer, të cilën e dëshiroj shumë ta filloj.
Nëse kontrollet bllokojnë pull request-in, atëherë motivimi është mjaftueshëm, sepse derisa ndërtimet të mos bëhen të gjelbra, kodi nuk do të kalojë në develop, dhe kështu, detyra nuk do të përfundojë.
Në fund, ne zgjodhëm një strategji të tillë: natën ekzekutojmë numrin maksimal të kontrollove të mundshme, ndërsa më kritikët dhe, më e rëndësishmja, më të shpejtët, i nisem në pull request. Por nuk ndalemi këtu — paralelisht optimizojmë sh brendësinë e kontrollove për t’i kaluar nga mënyra natër në kontrollime në pull request.
Në atë kohë, të gjitha build-ët tona kalonin mjaft shpejt, prandaj thjesht ne aktivizuam si bllokues për pull request build-in ARK, testet Junit dhe llogaritjen e mbulimit të kodit. Aktivizuam, menduam — dhe u ndalëm nga mbulimi i kodit, sepse e konsideruam se nuk na nevojitej.
Për të konfiguruar CI-në bazike na duhej dy ditë (këtu dhe më pas vlerësimi temporal është përafërsisht, e nevojshme për shkak të përmasës).
Pas kësaj, filluam të mendojmë më tej — a e kontrollojmë saktësisht? A i nisëm build-ët në pull request?
Ne i nisëm build-in në commit-in më të fundit të degës, nga e cila u hap pull request. Por kontrollimet e këtij commit-i mund të tregojnë vetëm atë që kodi, që ka shkruar zhvilluesi, funksionon. Por ato nuk provojnë se ai nuk ka prishur asgjë. Në të vërtetë, duhet të kontrollojmë gjendjen e degës develop pasi të jetë integruar karakteristika.
Për këtë shkruam një skenar të thjeshtë bash premerge.sh:
#!/usr/bin/env bash

set -e

git fetch origin develop

git merge origin/develop
Këtu thjesht tërheqim të gjitha ndryshimet më të freskëta nga develop dhe i inkuadrojmë në degën aktuale. E shtuam skenarin premerge.sh si hapin e parë të të gjithë build-ëve dhe filluam të kontrollojmë atë që dëshirojmë, pra integrimin.
Për lokalizimin e problemeve, gjetjen e zgjidhjes dhe shkruajten e këtij skenari na duhej tri ditë.
Aplikacioni po zhvillohej, detyrat po rriteshin gjithnjë e më shumë, ekipi po zgjerohej, dhe premerge.sh ndonjëherë filloi të na dështojë. Ndryshime konfliktuale po depërtonin në develop, të cilat prisnin build-in.
Një shembull se si ndodh kjo:
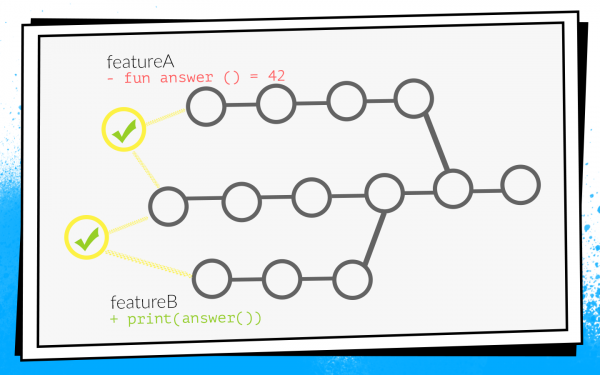
Dy zhvillues njëkohësisht fillojnë të zhvillojnë karakteristikat A dhe B. Zhvilluesi i karakteristikës A zbulohet në projekt një funksion të pa përdorur answer() dhe, si një skaut i mirë, e fshin atë. Ndërkohë, zhvilluesi i karakteristikës B në degën e tij shton një thirrje të re për këtë funksion.
Zhvilluesit përfundojnë punën dhe në të njëjtën kohë hapin pull request. Nisin build-et, premerge.sh kontrollon të dy pull request-i në lidhje me gjendjen e freskët të develop — të gjitha kontrollimet janë të gjelbra. Pas kësaj, bëhet bashkimi i pull request-it të karakteristikës A, dhe bashkimi i pull request-it të karakteristikës B… Bum! Develop prishet, sepse në kodin e develop ka një thirrje për një funksion që nuk ekziston.
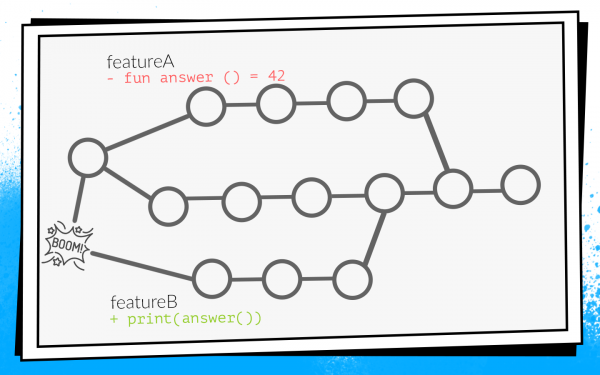
Kur develop nuk grumbullohet, kjo katastrofë lokale. E gjithë ekipi nuk mund të mbledhë asgjë dhe ta dërgojë për testim.
Ka ndodhur që unë shpesh merresha me detyra infrastrukturore: analitika, rrjeti, bazat e të dhënave. Që do të thotë, unë shkrova ato funksione dhe klasa që përdorin zhvillues të tjerë. Shkaku i kësaj, unë shpesh përballesha me situata të tilla. Madje, një kohë të gjatë kisha një fotografi të tillë të varur.
Pasi ky nuk na kënaqte, ne filluam të shqyrtonim mundësi për ta parandaluar këtë.
Si të mos e dëmtojmë develop
Mundësia e parë: të ripaketojmë të gjitha pull request pas përditësimit të develop. Në shembullin tonë, nëse pull request me veçorinë A i pari futet në develop, atëherë pull request i veçorisë B do të ripaketohet, dhe, për rrjedhojë, kontrollimet nuk do të kalojnë për shkak të gabimit të kompilimit.
Për të kuptuar se sa kohë do të duhej për këtë, le të shqyrtojmë një shembull me dy PR. Hidhni një sy dy PR: dy ndërtime, dy nisje kontrollesh. Pasi PR i parë është i integruar në develop, duhet të ripaketohet i dyti. Pra, në total, për dy PR ne kemi tre nisma kontrollesh: 2 + 1 = 3.
Në përgjithësi, është në rregull. Por ne e shqyrtuam statistikën dhe situata tipike në ekipin tonë ishte 10 PR të hapura, dhe atëherë numri i kontrolleve është shumimi i progresionit: 10 + 9 +… + 1 = 55. Pra, për të pranuar 10 PR, duhet të ripaketohet 55 herë. Dhe kjo është në situatën ideale, kur të gjitha kontrollimet kalojnë me herën e parë, kur askush nuk hap një pull request shtesë, ndërsa po përpunohen ato dhjetë.
Imagjinoni veten si një zhvillues që duhet të arrijë të klikohet në butonin "merge" i pari, sepse nëse e bën fqinja, do të presë derisa të kalojnë të gjitha ndërtimet nga e para… Jo, kështu nuk do të shkojë, do ta ngadalësojë seriozisht zhvillimin.
Mënyra e dytë e mundshme: të ndërtojmë pull request pas rishikimit të kodit. Pra, hapni një pull request, mbledhni numrin e nevojshëm të miratimeve nga kolegët, rregulloni çfarë është e nevojshme, pas kësaj filloni ndërtimet. Nëse ato janë të suksesshme, pull request e integruar me develop. Në këtë rast nuk ka ripaketime të tjera, por feedback-u ngadalësohet ndjeshëm. Unë, si zhvillues, kur hap pull request, menjëherë dua të shoh a po ndërtohet. Për shembull, nëse ndonjë test ka dështuar, duhet ta rregullojë shpejt. Në rastin e ndërtimit të vonuar, feedback-u ngadalësohet, dhe kështu e gjithë zhvillimi. Kjo gjithashtu nuk na kënaqte.
Së fundi, mbeti vetëm mundësia e tretë - të krijohet një vetë.. Të gjithë kodi ynë, të gjithë burimet tona ruhen në depo në serverin Bitbucket. Si rezultat, na duhej të zhvillonim një plugin për Bitbucket.
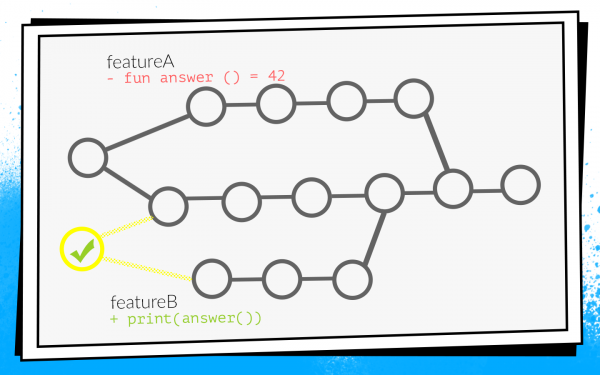
Ky plugin tejkalon mekanizmin e bashkimit të kërkesave të tërheqjes (pull requests). Fillimi është standard: hapet një PR, aktivizohen të gjitha ndërtimet, kalon shqyrtimin e kodit. Por pas kalimit të shqyrtimit të kodit, dhe zhvilluesi vendos të klikojë "bashko", plugin kontrollon që në cilin gjendje të zhvillimit ishin kryer testet. Nëse pas ndërtimeve zhvillimi është përditësuar, plugin nuk do të lejojë që një kërkesë të tillë të tërheqjes të fusionohet në degën kryesore. Ajo thjesht do të rinisë ndërtimet në lidhje me zhvillimin më të freskët.
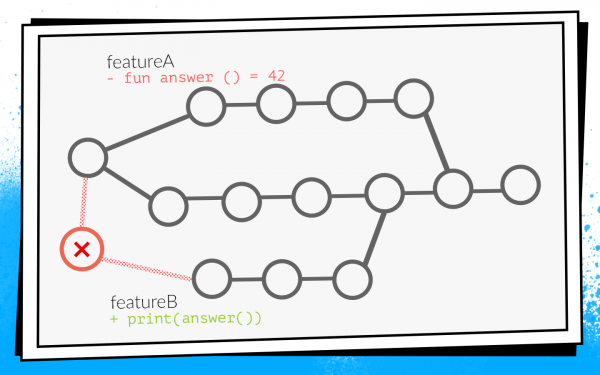
Në shembullin tonë me ndryshime konfliktuese, këto ndërtime nuk do të kalonin për shkak të një gabimi kompilimi. Si rezultat, zhvilluesi i karakteristikës B do të duhet të rregullojë kodin, të rinisë testet, atëherë plugin do të aplikojë automatikisht kërkesën për tërheqje.
Para zbatimit të këtij plugin, kishim mesatarisht 2.7 aktivizime të testeve për një kërkesë të tërheqjes. Me pluginin, bëhet 3.6 aktivizime. Kjo na kënaq.
Vlen të theksohet se ky plugin ka një mangësi: ai rinis ndërtimin vetëm një herë. Kështu që gjithsesi mbetet një hapësirë e vogël, përmes së cilës mund të kalojnë ndryshime konfliktuese në zhvillim. Por probabiliteti i kësaj është i ulët, dhe ne u vendosëm për këtë kompromis mes numrit të aktivizimeve dhe probabilitetit të dështimit. Në dy vitet e fundit ndodhi vetëm një herë, kështu që ndoshta nuk ishte kot.
Krijimi i versionit të parë të plugin për Bitbucket na mori dy javë.
Kontrollime të reja
Ndërkohë, ekipi ynë vijonte të rritej. U shtuan kontrolle të reja.
Menduam: pse të riparojmë gabimet, kur mund t'i parandalojmë ato? Dhe për këtë implementuam analizën statike të kodit. Filluam me lint, i cili është pjesë e Android SDK. Por në atë kohë ai nuk dinte aspak të punonte me kodin Kotlin, dhe ne tashmë kishim 75% të aplikacionit të shkruar në Kotlin. Prandaj lint-i u plotësua me kontrollet e Android Studio.
Për këtë na duhej të bënim disa manovra drastike: të merrnim Android Studio, ta paketojmë atë në Docker dhe ta aktivizonim në CI me një monitor virtual, që ajo të mendonte se ishte aktivizuar në një laptop të vërtetë. Por kjo funksiononte.
Po ashtu, në këtë kohë filluam të shkruajmë shumë teste instrumental dhe implementuam testimin e shkrepjesKy është kur gjenerohet një skrinshot referencë për një pamje të vogël të veçantë, dhe testi përfshin marrjen e një skrinshoti nga pamja dhe krahasimin me referencën pikë për pikë. Nëse ka ndonjë ndryshim, do të thotë që ndonjëherë formati është keq ose diçka nuk është në rregull me stilin.
Por testet instrumentation dhe testet e skrinshot-it duhet të ekzekutohen në pajisje: në emulatorë ose në pajisje reale. Duke marrë parasysh se ka shumë teste dhe ato gjenerohen shpesh, na nevojitet një fermë e tërë. Të krijosh fermën tënde është shumë punë, prandaj gjetëm një opsion të gatshëm — Firebase Test Lab.
Firebase Test Lab
I zgjodhëm sepse Firebase është një produkt i Google, pra duhet të jetë i besueshëm dhe me siguri nuk do të vdesë kurrë. Çmimet janë të arsyeshme: 5$ për orë në pajisje reale, 1$ për orë në emulator.
Deri në implementimin e Firebase Test Lab në CI-në tonë, kaluan përafërsisht tri javë.
Por ekipi vazhdonte të rritej, dhe Firebase, fatkeqësisht, filloi të na lërë pas. Në atë kohë nuk kishte asnjë SLA. Ndonjëherë Firebase na detyronte të prisnim për të lëshuar numrin e nevojshëm të pajisjeve për testet, dhe nuk i fillonte menjëherë siç do të donim. Pritja në radhë zgjaste deri në gjysmë ore, dhe kjo ishte shumë e gjatë. Testet instrumentation ekzekutoheshin në çdo PR, dhe vonesat e ngadalësonin zhvillimin, pastaj erdhi edhe hesap për muajin me një shumë të madhe. Në përgjithësi, u vendos të largohemi nga Firebase dhe të zhvillojmë in-house, pasi ekipi ishte mjaft i rritur.
Docker + Python + bash
Marrëm docker, e vendosëm brenda emulatorët, shkruam një program të thjeshtë në Python që, në momentin e duhur, ngre numrin e nevojshëm të emulatorëve në versionin e duhur dhe kur është e nevojshme, i ndalon ata. Dhe, natyrisht, disa skenarë bash — ku tjetër mund të shkojmë pa to?
Për krijimin e ambientit tonë të testimit kaluan pesë javë.
Si rezultat, për çdo pull request kishte një listë të gjerë, bllokuese për bashkimin, të kontrollimeve:
- Ndërtimi i ARK;
- Testet Junit;
- Lint;
- Kontrollet e Android Studio;
- Testet e Instrumentacionit;
- Testet e Skreenit.
Kjo parandalonte shumë mundësi defektesh. Teknikisht gjithçka funksiononte, por zhvilluesit ankonin se prisnin rezultatet shumë gjatë.
Çfarë do të thotë shumë gjatë? Ne analizuam të dhënat nga Bitbucket dhe TeamCity në sistemin e analizës dhe kuptuam se koha mesatare e pritjes është 45 minuta. Kështu, një zhvillues, duke hapur kujtesat e tërheqjes, mesatarisht pret rezultatet e ndërrimeve për 45 minuta. Sipas mendimit tim, kjo është shumë, dhe nuk mund të punojmë kështu.
Sigurisht, vendosëm të përshpejtojmë të gjitha ndërtimet tona.
Po përshpejtohemi
Duke parë se shpesh ndërtimet ishin në pritje, ne filluam të blinim paisje të reja — zhvillimi ekstensiv është më i lehtë. Ndërtimet nuk qëndrojnë më në pritje, por koha e pritjes u ul vetëm pak, sepse disa kontrolle veten e tyre kanë marrë shumë kohë.
Hiqni kontrollet shumë të gjata
Continuous Integration ynë mund të kapë këto lloje gabimesh dhe problemesh.
- Nuk ndërtohet. CI mund të kapë një gabim përmbledhjeje kur për shkak të ndryshimeve konfliktuese diçka nuk ndërtohet. Siç e thashë, atëherë askush nuk mund të ndërtojë asgjë, zhvillimi ndalet dhe të gjithë nervozohen.
- Gabimi në sjellje. Për shembull, kur aplikacioni ndërtohet, por bie kur shtypni butonin, ose butoni nuk funksionon fare. Kjo është e keqe, sepse një gabim i tillë mund të arrijë te përdoruesi.
- Gabimi në dizajn. Për shembull, butoni funksionon, por është zhvendosur 10 piksel nga e majta.
- Rritja e borxhit teknik.
Duke e parë këtë listë, ne kuptuam se kritike ishin vetëm dy pika të para. Këto probleme ne duam t'i kapim në radhë të parë. Gabimet në dizajn zbulohen në fazën e kontrollit të dizajnit dhe atëherë janë lehtë të rregullohen. Puna me borxhin teknik kërkon një proces dhe planifikim të veçantë, kështu që vendosëm të mos e kontrollojmë atë në pull request.
Duke u bazuar në këtë klasifikim, ne rishikuam të gjithë listën e kontrolleve. Fshimë Lint dhe e transferuam në natë: thjesht për të kuptuar se sa probleme ka në projekt. Me borxhin teknik vendosëm të punojmë veçmas, dhe në kontrollet e Android Studio ne u larguam fare. Android Studio në Docker për të ekzekutuar inspektimet duket interesante, por sjell shumë probleme në mbështetje. Çdo azhurnim versionesh të Android Studio — është një luftë me gabime të paqartë. Po ashtu e ndërlikuar ishte mbajtja e testeve të screenshot, sepse biblioteka nuk funksiononte shumë stabilisht, kishte rastet e gabimeve false. Ne hoqëm testet e screenshot nga lista e kontrolleve.
Në përfundim, na mbetën:
- Ndërtimi i ARK;
- Testet Junit;
- Testet e Instrumentimit.
Gradle remote cache
Pa kontrolle të rënda, gjithçka u përmirësua. Por nuk ka kufi për përsosmëri!
Aplikacioni ynë tashmë ishte ndarë në rreth 150 module gradle. Zakonisht në një rast të tillë funksionon mirë Gradle remote cache, dhe vendosëm ta provonim atë.
Gradle remote cache — është një shërbim që mund të ruajë artefaktet e ndërtimit për detyra të caktuara në module të veçanta. Gradle, në vend që të kompilohet realisht kodin, i drejtohet remote cache përmes HTTP dhe pyet nëse dikush e ka ekzekutuar tashmë këtë detyrë. Nëse po, thjesht shkarkon rezultatin.
Të nisësh Gradle remote cache është e lehtë, sepse Gradle ofron një imazh Docker. Ne arrijmë ta bëjmë këtë brenda tre orëve.
Thjesht duhej të niste Docker dhe të shkruante një rresht në projekt. Por ndonëse mund të niset shpejt, për të punuar siç duhet do të kërkohet një kohë e konsiderueshme.
Më poshtë është grafiku i humbjeve të caches.
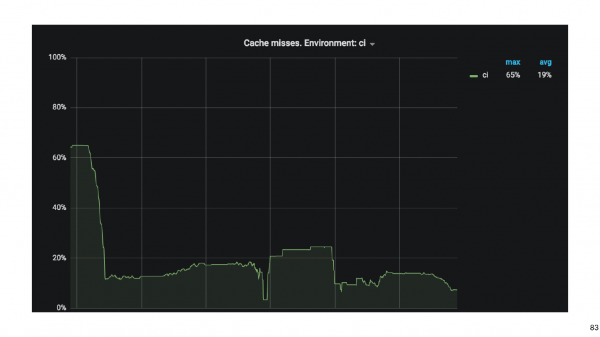
Fillimisht, përqindja e humbjeve nga cache ishte rreth 65. Pasi kaluan tri javë, arritëm ta ulinim këtë vlerë në 20%. U duk se detyrat që ndërtone aplikacionin Android kanë varësitë tranzitive të çuditshme që e bënë Gradle të humbasë nga cache.
Duke e aktivizuar cache, ne e përshpejtuam ndërtimin ndjeshëm. Por përveç ndërtimit, gjithashtu ekzekutohen testet e instrumentalizmit, dhe ato zgjatin shumë. Ndoshta, nuk është e nevojshme të ekzekutohen të gjitha testet për çdo pull request. Për ta zbuluar këtë, përdorim analizën e ndikimit.
Analiza e ndikimit
Në pull request ne mbledhim git diff dhe gjejmë modulo të ndryshuara Gradle.
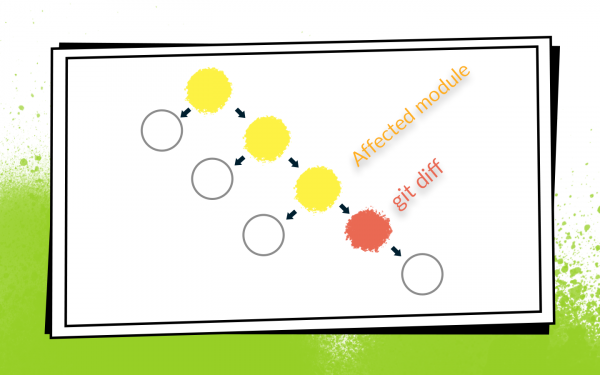
Ka kuptim të ekzekutohen vetëm ato teste të instrumentalizmit që kontrollojnë modulet e ndryshuara dhe të gjitha modulet që varen prej tyre. Testet për modulet fqinj nuk ka kuptim të ekzekutohen: atje nuk është ndryshuar kod, prandaj nuk mund të ketë ndonjë dështim.
Me testet e instrumentalizmit nuk është kaq e thjeshtë, sepse ato duhet të ndodhen në modulin më të lartë të aplikacionit. Ne aplikuam një heuristikë me analizën e bytecode për të kuptuar se cilit modul i përket çdo test.
Modernizimi i funksionimit të testeve të instrumentalizmit për të kontrolluar vetëm modulet e angazhuara, zgjati rreth tetë javë.
Masat për përshpejtimin e verifikimeve dhanë rezultat. Nga 45 minuta arritëm në rreth 15. Një çerek ore për të pritur ndërtimin tani është normale.
Por tani zhvilluesit kanë filluar të ankohen se nuk e kuptojnë se cilat ndërtime janë duke u ekzekutuar, ku mund të shohin log-un, pse ndërtimi është i kuq, cili test ka dështuar, etj.
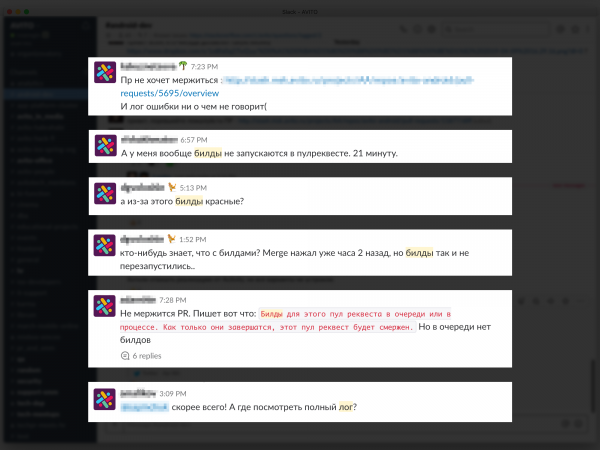
Problemet me feedback-in ngadalësojnë zhvillimin, prandaj kemi bërë përpjekje për të siguruar informacion sa më të qartë dhe të detajuar për çdo PR dhe ndërtim. Filluam me komentet në Bitbucket për PR duke shënuar se cili ndërtim dështon dhe pse, shkruam mesazhe të drejtpërdrejta në Slack. Në fund, krijuam një dashboard për faqen e PR me një listë të të gjitha ndërtimeve që aktualisht janë duke u ekzekutuar dhe statusit të tyre: në radhë, duke u ekzekutuar, dështuar ose përfunduar. Mund të klikoni në ndërtim dhe të hyni në logun e tij.
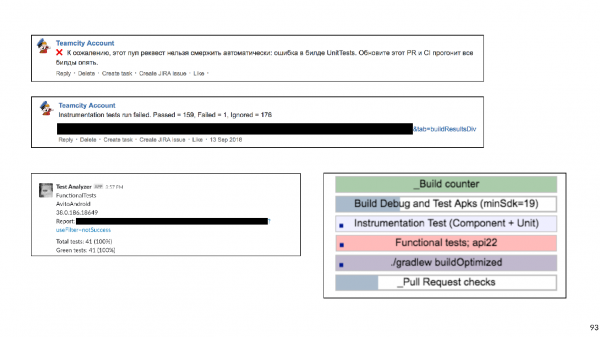
I janë kushtuar gjashtë javë feedback-ut të detajuar.
Planet
Të kalojmë në historinë më të re. Duke zgjidhur çështjen e feedback-ut, arritëm në një nivel të ri — vendosëm të ndërtojmë fermën tonë të emulatorëve. Kur ka shumë teste dhe emulatorë, është e vështirë të menaxhohen. Në fund, të gjithë emulatorët tanë u transferuan në një klasër k8s me menaxhim të fleksibilizuar të burimeve.
Për më tepër, ka planifikime të tjera.
- Të kthejmë Lint (dhe analizimin tjetër statik). Ne tashmë jemi duke punuar në këtë drejtim.
- Të ekzekutojmë si bllokues për PR të gjitha testet end-to-end në të gjitha versionet e SDK.
Dhe kështu, kemi ndjekur historinë e zhvillimit të Continuous Integration në Avito. Tani dua të jap disa këshilla nga pikëpamja e një personi me përvojë.
Këshillat
Nëse do të mund të jepja vetëm një këshillë, do të ishte kjo:
Ju lutem, tregoni kujdes me skenaret shell!
Bash — është një mjet shumë fleksibël dhe i fuqishëm, është shumë i lehtë dhe i shpejtë për të shkruar skenare. Por mund të bini në kurth, dhe fatkeqësisht ne kemi rënë në të.
Ofrimi filloi me skenare të thjeshta, të cilat ekzekutoheshin në mjetet tona të ndërtimit:
#!/usr/bin/env bash
./gradlew assembleDebug
Por, siç dihet, gjithçka zhvillohet dhe komplikohet me kohën — le të ekzekutojmë një skenar nga një tjetër, le t'i kalojmë disa parametra aty — në fund, na duhej të shkruanim një funksion që përcakton se në cilin nivel të thellësisë bash jemi tani për të vendosur citatet e duhura, në mënyrë që të gjithë të niseshin.
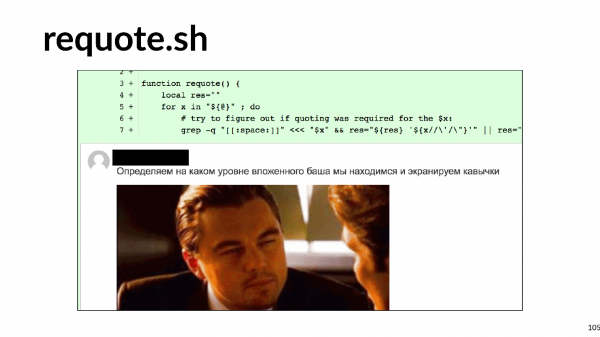
Mund ta imagjinoni sa punë kërkoi zhvillimi i tillë i skenarëve. Ju rekomandoj të mos binni në këtë kurth.
Çfarë mund të zëvendësojë?
- Çdo gjuhë skenari. Të shkruash në Python ose Kotlin Script është më e lehtë, sepse është programim dhe jo skenare.
- Ose të përshkruani të gjithë logjikën e ndërtimit në formën e detyrave të personalizuara gradle për projektin tuaj.
Ne vendosëm të zgjedhim opsionin e dytë, dhe tani po hiqim gradualisht të gjitha skenaret bash dhe po shkruajmë shumë detyra gradle të personalizuara.
Këshilla Nr. 2: të mbani infrastrukturën në kod.
Eshtë e përshtatshme kur konfigurimi i Continuous Integration nuk ruhet në ndërfaqen e përdoruesit të Jenkins ose TeamCity etj., por si skedarë të tekstit direkt në repozitorinë e projektit. Kjo ofron versionim. Nuk do të jetë e vështirë të rikthehesh ose të ndërtohesh kodin në një degë tjetër.
Skripti mund të ruhet në projekt. Por çfarë të bëjmë me mjedisin?
Këshilla Nr. 3: Docker mund të ndihmojë me mjedisin.
Sigurisht që do të ndihmojë zhvilluesit Android, ndoshta për iOS ndonjëherë jo, fatkeqësisht.
Ky është një shembull i një docker-file të thjeshtë, i cili përmban jdk dhe android-sdk:
FROM openjdk:8

ENV SDK_URL="https://dl.google.com/android/repository/sdk-tools-linux-3859397.zip"
    ANDROID_HOME="/usr/local/android-sdk"
    ANDROID_VERSION=26
    ANDROID_BUILD_TOOLS_VERSION=26.0.2

# Shkarko Android SDK
RUN mkdir "$ANDROID_HOME" .android
    && cd "$ANDROID_HOME"
    && curl -o sdk.zip $SDK_URL
    && unzip sdk.zip
    && rm sdk.zip
    && yes | $ANDROID_HOME/tools/bin/sdkmanager --licenses

# Instaloni Android Build Tool dhe Bibliotekat
RUN $ANDROID_HOME/tools/bin/sdkmanager --update
RUN $ANDROID_HOME/tools/bin/sdkmanager "build-tools;${ANDROID_BUILD_TOOLS_VERSION}"
    "platforms;android-${ANDROID_VERSION}"
    "platform-tools"

RUN mkdir /application
WORKDIR /application
Këtu shkrova këtë docker-file (do t'ju them në sekret, mund ta anashkaloni dhe ta shkarkoni një të gatshme nga GitHub) dhe duke ndërtuar imazhin, merrni një makinë virtuale, në të cilën mund të ndërtoni aplikacionin dhe të ekzekutoni testet Junit.
Dy argumentet kryesore pse kjo ka kuptim: shkallëzueshmëria dhe përsëritshmëria. Me përdorimin e docker, mund të ngrini shpejt një duzinë agjentësh të ndërtimit, të cilët do të kenë të njëjtin mjedis si më parë. Kjo e lehtëson shumë jetën e inxhinierëve CI. Të futësh android-sdk në docker është shumë e thjeshtë, me emulatorët është pak më e komplikuar: do t'ju duhet të punoni pak (ose përsëri të shkarkoni një të gatshme nga GitHub).
Këshilla Nr. 4: mos harroni se kontrollet nuk bëhen për kontrolle, por për njerëzit.
Për zhvilluesit, një feedback i shpejtë dhe, më e rëndësishmja, i kuptueshëm është shumë i rëndësishëm: çfarë ka dështuar, cila test ka rënë, ku të shikoni build-logun.
Këshilla Nr. 5: jini pragmatikë në zhvillimin e Continuous Integration.
Kuptoni qartë se cilat lloje gabimesh dëshironi të parandaloni, sa burime, kohë dhe kohë makinerie jeni të gatshëm të investoni. Kontrollimet shumë të gjata mund të zgjidhen, për shembull, gjatë natës. Ndërsa për ato që kapin gabime jo shumë të rëndësishme, mund të hiqen krejtësisht.
Këshilla Nr. 6: përdorni mjete të gatshme.
Aktualisht ka shumë kompani që ofrojnë CI në cloud.
Për ekipet e vogla, kjo është një zgjidhje e mirë. Nuk nevojitet mbështetje, thjesht paguani pak para, grumbulloni aplikacionin tuaj dhe madje drejtoni teste instrumentimi.
Këshilla Nr. 7: në një ekip të madh, është më e leverdishme të keni zgjidhje in-house.
Por herët apo vonë, me rritjen e ekipit, do të bëhen më të leverdishme zgjidhjet in-house. Me këto zgjidhje ka një moment. Në ekonomi ka ligjin e kthimeve në rënie: në çdo projekt, çdo përmirësim më i vogël bëhet gjithnjë e më i vështirë dhe kërkon gjithnjë e më shumë investime.
Ekonomia përshkruan gjithë jetën tonë, përfshirë Integrimin e Vazhdur. Kam ndërtuar një grafik të shpenzimeve të punës për çdo fazë të zhvillimit të Integrimit tonë të Vazhdur.
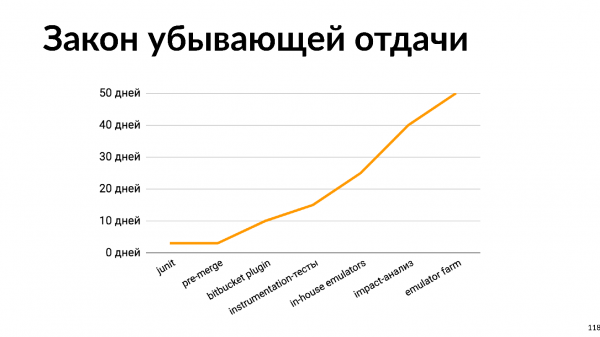
Dhe është e qartë se çdo përmirësim bëhet gjithnjë e më i vështirë. Duke parë këtë grafik, mund të kuptohet se zhvillimi i Integrimit të Vazhdur duhet të jetë në përputhje me rritjen e madhësisë së ekipit. Për një ekip prej dy personash, shpenzimi i 50 ditëve për zhvillimin e një ferme të brendshme të emulatorëve është një ide e keqe. Por gjithashtu, për një ekip të madh, të mos merresh me Integrimin e Vazhdur është gjithashtu një ide e keqe, sepse do të shpenzohet më shumë kohë për të zgjidhur problemet e integrimit, riparimin e komunikimeve, etj.
Filluam duke thënë se automatizimi është i nevojshëm, sepse njerëzit janë të shtrenjtë, ata gabojnë dhe janë të lenë. Por automatizuesit janë gjithashtu njerëz. Prandaj, të gjitha këto probleme i përkasin edhe automatizimit.
- Të automatizosh është e kushtueshme. Kujtojeni grafikën e shpenzimeve të punës.
- Gjatë automatizimit, njerëzit gabojnë.
- Ndonjëherë është shumë dembel për të automatizuar, sepse gjithçka funksionon. Pse të përmirësosh diçka tjetër, pse të bësh të gjithë këtë Integrim të Vazhdur?
Por kam një statistikë: në 20% të ndërtimeve kapen gabime. Dhe kjo ndodh jo sepse zhvilluesit tanë shkruajnë keq kodin. Kjo ndodh sepse zhvilluesit janë të sigurt se, nëse ata bëjnë ndonjë gabim, ai nuk do të shkojë në develop, por do të kapet nga kontrollet automatizuar. Kështu që, zhvilluesit mund të shpenzojnë më shumë kohë duke shkruar kod dhe duke u angazhuar me gjëra interesante, e jo duke e bërë ndonjë gjë në mënyrë lokale dhe duke kontrolluar.
Meruni me Integrimin e Vazhdur. Por në mënyrë të arsyeshme.
Për më tepër, Nikolaj Nesterov jo vetëm që bën prezantime fantastike, por gjithashtu është anëtar i komitetit programor dhe ndihmon të tjerët të përgatisin për ju prezantime domethënëse. Pluralitetin dhe dobishmërinë e programit të konferencës së ardhshme mund ta vlerësoni nga temat në . Dhe për më shumë detaje, erdhni më 22-23 prill në Infopranës.
Burimi: habr.com
