

Kompania jonë ka qenë duke u marrë kryesisht me menaxhimin e infrastrukturave dhe mbështetje teknike 24/7 për projekte web që nga viti 2008: kemi më shumë se 400 klientë, që përbën rreth 15% të tregtisë elektronike në Rusi. Për këtë arsye, mbështetja përfshin një arkitekturë shumë të larmishme. Nëse ndodhin probleme, ne jemi të detyruar ta rregullojmë brenda 15 minutash. Por për të kuptuar që një aksident ka ndodhur, duhet të monitorojmë projektin dhe të reagojmë ndaj incidenteve. Por si ta bëjmë këtë?
Mendoj se në organizimin e një sistemi të duhur monitorimi ka ndodhur një katastrofë. Po të mos kishte ndodhur një katastrofë, fjalimi im do të përbëhej nga një tezë: "Ju lutem, instaloni Prometheus + Grafana dhe plugins 1, 2, 3". Fatkeqësisht, tani ashtu nuk funksionon. Dhe problemi kryesor është se të gjithë vazhdojnë të besojnë në diçka të tillë që ekzistonte në vitin 2008, në aspektin e komponentëve të softuerit.
Sa i përket organizimit të sistemit të monitorimit, do të rrezikoja të thosha se... nuk ekzistojnë projekte me monitorim të mirëfilltë. Dhe situata është aq e keqe, nëse ndodhi një rënien, ka rrezik që ajo të mbetet e padukur — të gjithë janë të bindur se "çdo gjë monitorohet".
Mund të jetë se gjithçka monitorohet. Por si?
Të gjithë ne kemi hasur në histori të ngjashme: punon një devops, një admin, ekipi i zhvilluesve vjen dhe thotë - "ne u lansuam, tani monitoro". Çfarë të monitorosh? Si funksionon kjo?
Mirë. Monitorojmë në mënyrë tradicionale. Por tashmë po ndryshon, dhe zbulohet se ti ke monitoruar shërbimin A, i cili ka kaluar në shërbimin B, i cili bashkëpunon me shërbimin C. Por ekipi i zhvilluesve të thotë: "Instalo softin, ai duhet të monitorojë gjithçka!"
Çfarë ka ndryshuar? — E gjithë gjë ka ndryshuar!
Viti 2008. Gjithçka është të shkëlqyer.
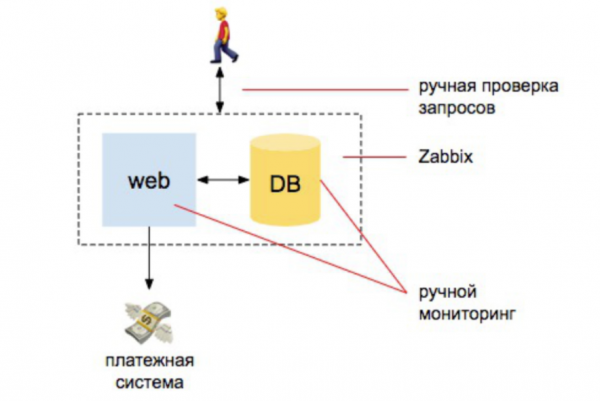
Ka disa zhvillues, një server, një server DB. Këtu fillon gjithçka. Ne kemi disa informacione, instalojmë zabbix, Nagios, cacti. Dhe më pas vendosim alarme të qarta për CPU, për funksionimin e disqeve, për hapësirën në disqe. Po ashtu, kryejmë disa kontrolle manuale, që faqja është aktive, që porositë vijnë në bazë të të dhënave. Dhe kjo është – jemi më shumë se sa të mbrojtur.
Nëse e krahasojmë sasinë e punës që admini bënte për të siguruar monitorimin, 98% ishte automatike: njeriu që merret me monitorimin duhet të kuptojë si të vendosë Zabbix, si ta konfigurojë dhe të vendosë alerte. Dhe 2% — për verifikime të jashtme: nëse siti përgjigjet dhe bën kërkesa në bazë, nëse janë bërë porosi të reja.
Viti 2010. Rritet ngarkesa
Fillojmë të skaluam uebet, shtojmë motorin e kërkimit. Duam të jemi të sigurt se katalogu i produkteve përmban të gjitha produktet. Dhe se kërkimi i produkteve funksionon. Se baza funksionon, se porositë bëhen, se siti përgjigjet jashtë dhe përgjigjet me dy serverësh dhe përdoruesi nuk hidhet jashtë nga siti, derisa ai të ribalancohet në një server tjetër, etj. Entitetet po bëhen më shumë.
Për më tepër, entiteti i lidhur me infrastrukturën mbetet ende më i madhi në mendjen e menaxherit. Ideja se njeriu që merret me monitorimin është ai që do të vendosë zabbix dhe do ta konfigurojë ende ekziston në mendje.
Por në të njëjtën kohë po shfaqen punë për kryerjen e verifikimeve të jashtme, për krijimin e një grupi skriptesh për kërkuesin e indeksimit, të një grupi skriptesh për të verifikuar se kërkimi po ndryshon gjatë procesit të indeksimit, një grupi skriptesh që kontrollojnë se shërbimi i dërgesës po merr produktet, etj. dhe më tej.
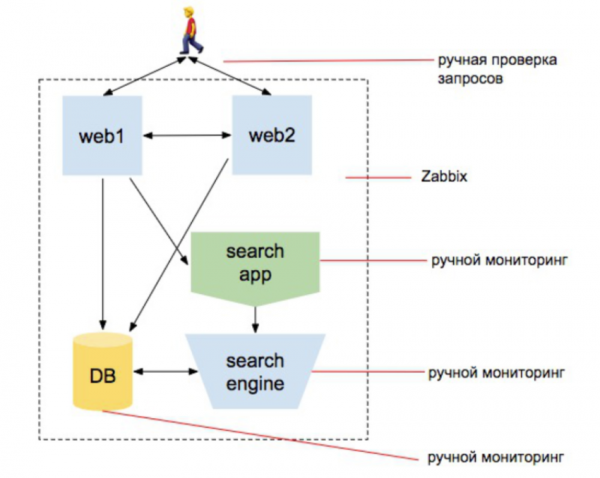
Vini re: shkruajta 3 herë «grup skriptesh». Kështu që përgjegjësi për monitorimin — nuk është më ai që thjesht instalon zabbix. Ky është një person që fillon të kode. Por në mendjet e ekipit nuk ka asnjë ndryshim ende.
Ndërkohë, bota po ndryshon, duke u komplikuar gjithnjë e më shumë. Shtohet një shtresë virtualizimi, disa sisteme të reja. Ato fillojnë të ndërveprojnë me njëra-tjetrën. Kush tha «ngjason me mikroshërbimet?» Por çdo shërbim ende duket si një site i veçantë. Ne mund ta qasnim atë dhe të kuptojmë se ai jep informacionin e nevojshëm dhe funksionon vetë. Dhe nëse je admin që merret vazhdimisht me një projekt që zhvillohet për 5-7-10 vjet, këto njohuri grumbullohen: një nivel i ri shfaqet — e ke kuptuar, shfaqet një tjetër nivel — e ke kuptuar...
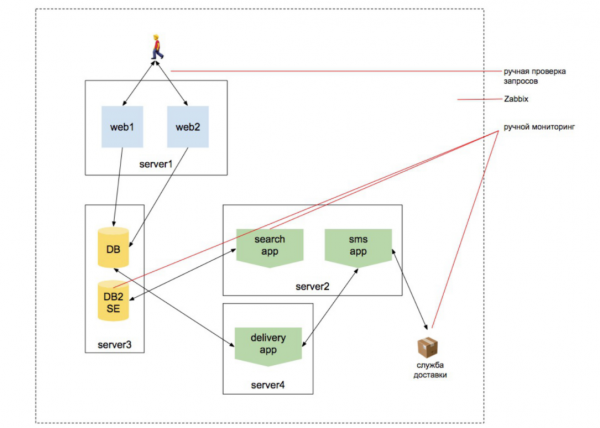
Por rrallë ndokush e mbështet një projekt për 10 vjet.
Përmbledhje e monitorimit
Supozoni se që keni hyrë në një fillim të ri, i cili menjëherë ka grumbulluar 20 zhvillues, ka shkruar 15 mikrosërvish, dhe ju jeni administrator i cili i thonë: "Ndërto CI/CD. Të lutem." Ju e ndërtuat CI/CD dhe papritur dëgjoni: "Na është vështirë të punojmë me prodhimin në 'kub', pa kuptuar si do të funksionojë aplikacioni aty. Na bëj një sandbox në këtë 'kub'."
Ju po krijoni një sandbox në këtë kub. Menjëherë ju thonë: "Duam një bazë të dhënash stage, e cila përditësohet nga prodhimi, për të kuptuar që kjo funksionon me bazën e dhënash, por pa prishur bazën e dhënash të prodhimit."
Ju jetoni në gjithë këtë situatë. Ka mbetur 2 javë deri në lansim, ju thonë: "Tani do të ishte mirë të monitorohej gjithçka..." Pra, të monitorohet infrastruktura klasterike, të monitorohet arkitektura mikrosërvish, të monitorohet puna me shërbime të jashtme...
Dhe kolegët nxjerrin nga mendja skemën e zakonshme dhe thonë: "Këtu është krejt e qartë! Vendosni një program që do të monitorojë gjithçka." Po, po: Prometheus + Grafana + plugins.
Dhe shtojnë: "Ke dy javë, bëj që gjithçka të jetë e besueshme."
Në shumicën e projekteve që shohim, një person i dedikohet monitorimit. Paraqitini që duam të punësojmë një person për 2 javë, që do të merret me monitorimin, dhe ne përgatitim një CV për të. Çfarë aftësish duhet të ketë ky person — nëse marrim parasysh gjithçka që thamë më parë?
- Ai duhet të kuptojë monitorimin dhe specifikën e funksionimit të infrastrukturës harduerike.
- Ai duhet të kuptojë specifikën e monitorimit të Kubernetes (të gjithë duan në 'kub', sepse mund të abstretohen nga gjithçka, të fshihen, pasi administratorët do ta zgjidhin pjesën tjetër) — vetë Kubernetes, infrastrukturën e tij, dhe të dijë se si të monitorojë aplikacionet brenda.
- Ai duhet të kuptojë se shërbimet komunikojnë me njëra-tjetrën në mënyra të veçanta, dhe të njohë specifikat e bashkëveprimit mes shërbimeve. Është krejt e mundur të shihni një projekt ku disa shërbime komunikojnë në mënyrë sinkrone, sepse përndryshe nuk ka asnjë mundësi tjetër. Për shembull, backend-i shkon nëpërmjet REST, nëpërmjet gRPC te shërbimi i katalogut, merr listën e produkteve dhe e kthen prapa. Këtu nuk mund të presësh. Ndërsa me shërbime të tjera ai punon në mënyrë asinkrone. Dërgo një porosi në shërbimin e dërgimit, dërgo një email etj.
Tani, ndoshta, e keni humbur gjithë këtë? Ndërsa administratorit, i cili duhet ta monitorojë këtë, i është bërë edhe më e vështirë. - Ai duhet të jetë në gjendje të planifikojë dhe të planifikojë siç duhet — pasi punët po bëhen gjithnjë e më shumë.
- Ai duhet, pra, të krijojë një strategji nga shërbimi i krijuar për të kuptuar se si ta monitorojë atë saktësisht. Aji ka nevojë për njohuri mbi arkitekturën e projektit dhe zhvillimin e tij + kuptimin e teknologjive që përdoren në zhvillim.
Le të kujtojmë një rast krejt normal: disa shërbime në PHP, disa shërbime në Go, disa shërbime në JS. Ato punojnë ndonjëherë midis tyre. Këtu ka dalë termi "mikroshërbim": sistemet e ndara u bënë kaq shumë saqë zhvilluesit nuk mund ta kuptojnë projektin në tërësi. Një pjesë e ekipit shkruan shërbime në JS, të cilat punojnë vetëm dhe nuk dinë si punon pjesa tjetër e sistemit. Një pjesë tjetër shkruan shërbime në Python dhe nuk përzihet në atë se si punojnë shërbimet e tjera, ato janë të izoluar në fushën e tyre. Të tjera shkruajnë shërbime në PHP ose diçka tjetër.
Të gjithë këta 20 persona janë të ndarë në 15 shërbime, dhe ka vetëm një administrator, i cili duhet ta kuptojë të gjithë këtë. Stop! Ne sapo ndamë sistemin në 15 mikroshërbime, sepse 20 persona nuk mund ta kuptojnë të gjithë sistemin.
Por ajo duhet ndonjëherë të monitorohet...
Çfarë ndodhi në fund? Në fund ka një person, i cili di gjithçka që një ekip i tërë zhvilluesish nuk mund ta kuptojë, dhe për më tepër ai duhet të dijë dhe të jetë në gjendje të bëjë atë që kemi theksuar më sipër — infrastrukturën harduerike, infrastrukturën Kubernetes etj.
Çfarë të themi... Hjuston, kemi probleme.
Monitorimi i një projekti modern software është një projekt software vetë.
Nga besimi i gabuar se monitorimi është softuer, ne fitojmë besimin në mrekulli. Dhe për fat të keq, nuk ka mrekulli. Nuk mund të vendosësh Zabbix dhe të presesh që gjithçka të funksionojë. Nuk ka sens të vendosësh Grafana dhe të shpresosh se gjithçka do të jetë në rregull. Një pjesë e madhe e kohës do të shpenzohet për organizimin e kontrollit të punës së shërbimeve dhe ndërveprimin e tyre me njëri-tjetrin, kontrollimeve si funksionojnë sistemet e jashtme. Faktikisht, 90% e kohës do të shpenzohet jo për të shkruar skripta, por për të zhvilluar softuerin. Dhe kjo duhet ta bëjë një ekip që e kupton punën e projektit.
Nëse në këtë situatë një person është kthyer në monitorim, do të ndodhin probleme. Çfarë ndodh kudo.
Për shembull, ka disa shërbime që komunikojnë midis tyre përmes Kafka. Ka ardhur një porosi, ne e dërguam mesazhin e porosisë në Kafka. Ka një shërbim që dëgjon informacionin për porosinë dhe realizon dorëzimin e mallrave. Ka një shërbim tjetër që dëgjon informacionin për porosinë dhe i dërgon një email përdoruesit. Dhe pastaj shfaqen edhe disa shërbime të tjera, dhe ne fillojmë të ngatërrohemi.
Por nëse ju e jepni këtë gjithashtu administratorit dhe zhvilluesve në një fazë kur ka mbetur pak kohë deri në lansim, dikush do të duhet të kuptojë të gjithë këtë protokoll. Domethënë, një projekt i këtij shkalle kërkon një kohë të konsiderueshme dhe në zhvillimin e sistemit duhet të parashikohet kjo.
Por shumë shpesh, veçanërisht gjatë fazës së fillimit, në startup-e, ne shohim se monitorimi shtyhet për më vonë. "Tani do të bëjmë një Proof of Concept, do të startojmë me të, le të bjerë – ne jemi të gatshëm të sakrifikojmë. Dhe më pas do ta monitorojmë të gjithë këtë". Kur (ose nëse) projekti fillon të sjellë para, biznesi dëshiron të zhvillojë edhe më shumë karakteristika — sepse është filluar të funksionojë, pra duhet të shtojmë më shumë! Dhe ju jeni në një pikë ku në fillim duhet të monitoroni gjithçka që ka ndodhur më parë, që zë jo 1% të kohës, por shumë më tepër. Dhe, për më tepër, për monitorimin do të nevojiten zhvillues, dhe është më e lehtë t'i dërgoni ata në karakteristika të reja. Në fund, shkruhen karakteristika të reja, gjithçka ndërlikohet, dhe ju jeni në një bllokim të pafund.
Si duhet ta monitoroni një projekt duke filluar nga e para, dhe çfarë duhet të bëni nëse ju ka rënë një projekt që duhen monitoruar, por nuk e dini nga të filloni?
Së pari, duhet të planifikoni.
Një shkëputje lirik: shpesh e fillojnë me monitorimin e infrastrukturës. Për shembull, kemi Kubernetes. Do të fillojmë duke vendosur Prometheus me Grafana, do të vendosim plugins për monitorimin e "kubikut". Jo vetëm zhvilluesit, por edhe administratorët kanë një praktikë të ngushëllueshme: "Do të vendosim këtë plugin, dhe plugin ndoshta e di si ta bëjë këtë". Njerëzit e pëlqejnë të fillojnë me gjëra të thjeshta dhe të kuptueshme, dhe jo me veprime të rëndësishme. Dhe monitorimi i infrastrukturës është thjesht i tillë.
Për të filluar, vendosni se çfarë dhe si dëshironi të monitoroni, dhe pastaj zgjidhni mjetin, sepse njerëzit e tjerë nuk mund t'ju mendojnë ju. Dhe a duhet të mendojnë? Njerëzit e tjerë menduan për veten e tyre, për një sistem univerzal — apo madje nuk menduan fare, kur e shkruanin këtë plugin. Dhe fakti që ky plugin ka 5 mijë përdorues, nuk do të thotë se ai sjell ndonjë dobi. Mundësisht, ju do të bëheni përdoruesi i 5001-të thjesht për faktin se deri më tani kishim 5000 njerëz.
Nëse keni filluar të monitoroni infrastrukturën dhe backendi i aplikacionit tuaj ka pushuar së përgjiguri, të gjithë përdoruesit do të humbasin lidhjen me aplikacionin mobil. Do të paraqitet një gabim. Do të vini dhe do të thoni 'Aplikacioni nuk funksionon, çfarë po bëni këtu?' - 'Ne po monitorojmë'. - 'Si po monitoroni, nëse nuk shihni që aplikacioni nuk funksionon?!'
- Mendoj se duhet të filloni të monitoroni pikërisht nga pika e hyrjes së përdoruesit. Nëse përdoruesi nuk sheh që aplikacioni funksionon — kjo është veçanërisht një dështim. Dhe sistemi i monitorimit duhet të paralajmërojë për këtë në radhë të parë.
- Dhe vetëm pastaj mund të monitorojmë infrastrukturën. Ose ta bëjmë këtë paralelisht. Me infrastrukturën është më e lehtë — këtu mund të vendosim thjesht zabbix.
- Dhe tani duhet të shkojmë në rrënjët e aplikacionit për të kuptuar se çfarë nuk funksionon.
Ideja ime kryesore është – monitorimi duhet të shkojë paralelisht me procesin e zhvillimit. Nëse e shkëputni ekipin e monitorimit në detyra të tjera (krijimi i CI/CD, sandbox, reorganizimi i infrastrukturës), monitorimi do të fillojë të mbetet prapa dhe ndoshta, ju kurrë nuk do të arrini më zhvillimin (ose herët a vonë do të detyroheni ta ndaloni atë).
Të gjitha në nivele
Kështu e shoh organizimin e sistemit të monitorimit.
1) Niveli i aplikacionit:
- monitorimi i logjikës biznesore të aplikacionit;
- monitorimi i përmasave të shëndetit të shërbimeve;
- monitorimi i integrimeve.
2) Niveli i infrastrukturës:
- monitorimi i nivelit të orkestrimit;
- monitorimi i softuerit sistemor;
- monitorimi i nivelit të ‘harduerit’.
3) Sërish niveli i aplikacionit — por tashmë si një produkt inxhinierik:
- mbledhja dhe vëzhgimi i regjistrimeve të aplikacionit;
- APM;
- tracing.
4) Alarmimi:
- organizimi i sistemit të njoftimeve;
- organizimi i sistemit të kujdestarisë;
- organizimi i ‘bazës së njohurive’ dhe punës fluks të trajtimit të incidenteve.
Ëhtë e rëndësishme: ne arrijmë te alarmin jo pasi, por menjëherë! Nuk keni nevojë të filloni monitorimin dhe të mendoni se si do t'i dërgoni alarmin pas një kohe. Sepse çfarë është qëllimi i monitorimit: të kuptoni ku diçka nuk funksionon në sistem dhe t'ua bëni të ditur personave të duhur. Nëse e lini për në fund, atëherë njerëzit e duhur do të mësojnë për problemet vetëm pas një telefonate "në nuk funksionon asgjë".
Niveli i aplikacionit — monitorimi i logjikës së biznesit
Këtu bëhet fjalë për kontrollin e faktit që aplikacioni po punon për përdoruesin.
Ky nivel duhet të realizohet në fazën e zhvillimit. Për shembull, ne kemi një Prometheus të supozuar: ai lidhet me serverin që kryen kontrollin, bën thirrje në endpoint, dhe endpoint-i shkon dhe kontrollon API-në.
Kur shpesh kërkohet të monitoroni faqen kryesore për të siguruar që website-i funksionon, programuesit ofrojnë një lidhje që mund të thirret çdo herë që duhet të sigurohen se API-ja po funksionon. Ndërkohë, programuesit janë duke shkruar /api/test/helloworld.
A është një mënyrë e vetme për të siguruar që gjithçka funksionon? — Jo!
- Krijimi i kontrollimeve të tilla është, në thelb, detyra e zhvilluesve. Testet unit duhet t'i shkruajnë programuesit që shkruajnë kodin. Sepse, nëse i jepni këtë një administratori "Djali, ja lista e protokolleve API të 25 funksioneve, të lutem, monitoro të gjithë!" — nuk do të ndodhë asgjë.
- Nëse bëni print "hello world", askush nuk do të mësojë ndonjëherë se API-ja duhet dhe vërtet po funksionon. Çdo ndryshim në API duhet të sjellë për pasojë ndryshimin e kontrollimeve.
- Nëse tashmë keni një problem të tillë – ndaloni funksionalitetet dhe caktoni zhvillues që do të shkruajnë këto kontrollime, ose pranoni humbjet, pranoni që nuk po kontrollohet asgjë dhe do të ketë dështime.
Këshilla teknike:
- Sigurohuni të organizoni një server të jashtëm për të kryer kontrollime — duhet të jeni të sigurt se projekti juaj është i aksesueshëm për botën e jashtme.
- Organizoni kontrollin për të gjitha protokollet API, jo vetëm për disa endpoint-e të veçanta.
- Krijoni një prometheus-endpoint me rezultatet e kontrollimeve.
Niveli i aplikacionit — monitorimi i metrikave të shëndetit
Tani bëhet fjalë për metrikat e shëndetit të jashtme të shërbimeve.
Ne kemi vendosur që të monitorojmë të gjitha "duart" e aplikacionit me ndihmën e kontrollimeve të jashtme, të cilat i thërrasim nga një sistem jashtmëonitorimi. Por këto janë pikërisht "duart" që "sheh" përdoruesi. Ne duam të jemi të sigurt se shërbimet tona funksionojnë. Këtu historia është më e mirë: në K8s ka kontrolle shëndetësore, që të paktën "kubiku" të sigurohet se shërbimi po funksionon. Por gjysma e kontrolleve që kam parë, janë të njëjta me printimin "hello world". Pra, ai thërret një herë pas vendosjes, dhe merr një përgjigje që gjithçka është mirë — dhe kaq. Ndërsa për një shërbim, nëse ai jep API-në e tij nëpërmjet REST, ka një numër të madh pikash hyrëse të atij API, që gjithashtu duhet të monitorohen, sepse ne duam të dimë që ai funksionon. Dhe ne e monitorojmë atë brenda.
Si të realizohet saktësisht nga ana teknike: çdo shërbim hap një endpoint për funksionimin e tij aktual dhe në grafikat e Grafana (apo çdo aplikacion tjetër) ne shohim statusin e të gjitha shërbimeve.
- Çdo ndryshim në API duhet të çojë pas vetes një ndryshim në kontroll.
- Krijoni shërbimin e ri menjëherë me metrika shëndeti.
- Admini mund të vijë tek zhvilluesit dhe t'i kërkojë "shtoni disa karakteristika për mua, që të kuptoj gjithçka dhe të shtoj informacionin për këtë në sistemin tim të monitorimit". Por zhvilluesit zakonisht përgjigjen "Nuk do të shtojmë asgjë dy javë para lansimit".
Le të dinë menaxherët e zhvillimit se do të ketë humbje të tilla, le të dijë drejtoria e menaxherëve të zhvillimit gjithashtu. Sepse, kur gjithçka të bjerë, dikush do të telefonojë dhe do të kërkojë që të monitorohet "shërbimi që bie vazhdimisht" (c) - Për më tepër, ndajnë zhvillues të shkruajnë plugina për Grafana — kjo do të jetë një ndihmë e mirë për adminët.
Niveli i aplikacionit — Monitorimi integrues
Monitorimi integrues fokusohet në monitorimin e komunikimit midis sistemeve kritike për biznesin.
Për shembull, ekzistojnë 15 shërbime që komunikojnë me njëra-tjetrën. Këto nuk janë më faqe të veçanta. Pra, ne nuk mund të thërrasim shërbimin në vetvete, të marrim /helloworld dhe të kuptojmë se shërbimi po funksionon. Sepse shërbimi i procesimit të porosive duhet të dërgojë informacionin e porosisë në autobusin — nga autobusi shërbimi për menaxhimin e inventarit duhet të marrë këtë mesazh dhe të punojë me të më tej. Dhe shërbimi i dërgimit të email-eve duhet ta përpunojë këtë ndryshe, etj.
Prandaj, ne mund të kuptojmë duke goditur çdo shërbim të veçantë, se si funksionon gjithçka. Sepse kemi një bus, përmes të cilit gjithçka komunikon dhe bashkëvepron.
Pra, kjo fazë duhet të përfaqësojë fazën e testimit të shërbimeve për ndërveprimin me shërbime të tjera. Nuk është e mundur të monitorosh komunikimin duke monitoruar brokerin e mesazheve. Nëse ka një shërbim që jep të dhëna dhe një shërbim që i merr ato, duke monitoruar brokerin do të shohim vetëm të dhënat që shkojnë nga njëra anë në tjetrën. Edhe nëse ndonjë siç arritëm të monitorojmë ndërveprimin e këtyre të dhënave brenda — që një prodhues poston të dhëna, dikush i lexon ato, ky rrjedh i vazhdon në Kafka — kjo përsëri nuk do të na japë informacion, nëse një shërbim dërgoi një mesazh në një version, ndërsa shërbimi tjetër nuk e priti këtë version dhe e humbi atë. Ne nuk do ta marrim vesh këtë, pasi shërbimet do të na thonë se gjithçka funksionon.
Si e rekomandoj të bëhet:
- Për komunikimin sinkron: endpoint-i kryen kërkesa ndaj shërbimeve të lidhura. Pra, ne marrim këtë endpoint, nxjerrim një skript brenda shërbimit që kalon përmes të gjitha pikave dhe thotë 'mund të godas atje, dhe atje, mund të godas...'
- Për komunikimin asinkron: mesazhet e ardhshme — endpoint-i kontrollon busin për mesazhe testuese dhe jep statusin e përpunimit.
- Për komunikimin asinkron: mesazhet që dalin — endpoint-i dërgon mesazhe testuese në bus.
Si ndodh zakonisht: kemi një shërbim që dërgon të dhëna në bus. Ne shkojmë në këtë shërbim dhe kërkojmë të flasim për shëndetin e tij integrues. Dhe nëse shërbimi duhet të prodhojë ndonjë mesazh diku tjetër (WebApp), atëherë ai e prodhon atë mesazh testues. Nëse ne po godasim shërbimin në anën e Përpunimit të Porosive, ai fillimisht poston atë që mund të postojë të pavarur, dhe nëse ka ndonjë gjë të varur — atëherë ai lexon nga busi një grup mesazhesh testuese, kupton se çfarë mund të përpunojë, informon për këtë dhe, nëse është e nevojshme, i poston më tutje, dhe për këtë ai thotë — gjithçka është në rregull, jam gjallë.
Shumë shpesh dëgjojmë pyetjen "si mund ta testojmë këtë me të dhëna reale?" Për shembull, kjo i referohet shërbimit të njëjtë të porosisë. Porosia dërgon njoftime në magazinë, ku produktet hiqen: ne nuk mund ta testojmë këtë me të dhëna reale, sepse "do të hiqen produktet!" Zgjidhja: në fazën fillestare, planifikoni të gjithë këtë test. Ju keni teste unitare që krijojnë mock. Kështu, bëni këtë në një nivel më të thellë, ku do të ketë një kanal komunikimi që nuk do të dëmtojë funksionimin e biznesit.
Niveli i infrastrukturës
Monitorimi i infrastrukturës - është diçka që konsiderohet prej kohësh si monitorimi i vërtetë.
- Monitorimi i infrastrukturës mund dhe duhet të fillojë si një proces i veçantë.
- Nuk është mirë të filloni me monitorimin e infrastrukturës në një projekt që funksionon, edhe nëse kjo ju tërheq. Kjo është një simptomë për të gjithë devops-at. "Së pari do të monitoroj klasterin, do të monitoroj infrastrukturën" - dmth. së pari do të monitorojë atë që është poshtë, dhe nuk do të merret me aplikacionin. Sepse aplikacioni është një gjë e paqartë për devops-in. I është dhënë, dhe ai nuk kupton si funksionon. Ai kupton infrastrukturën dhe fillon nga ajo. Por jo - gjithmonë së pari duhet të monitoroni aplikacionin.
- Mos e teproni me numrin e alarmeve. Duke pasur parasysh kompleksitetin e sistemeve moderne, alertet fluturojnë vazhdimisht, dhe duhet të jetoni me këtë mori alarmesh. Ndaj, njeriu on-call, duke parë njëqind alertet e reja, do të vendosë "nuk dua të mendoj për këtë". Alertet duhet të njoftojnë vetëm për gjërat kritike.
Niveli i aplikacionit si njësie biznesi
Pikat kyçe:
- ELK. Ky është standardi industrial. Nëse për ndonjë arsye nuk po agregoni log-et, filloni urgjentisht ta bëni këtë.
- APM. APM-të e jashtme si një mënyrë për të mbyllur shpejt monitorimin e aplikacionit (NewRelic, BlackFire, Datadog). Mund ta vendosni përkohësisht këtë gjë, në mënyrë që të kuptoni çfarë po ndodh.
- Tracing. Në dhjetëra mikroshërbime duhet të bëni ndjekje të gjithçkaje, sepse kërkesa nuk jeton më vetë. Të shtosh më vonë është shumë e vështirë, prandaj është më mirë ta planifikoni ndjekjen gjatë zhvillimit - kjo është punë dhe utilitare për zhvilluesit. Nëse ende nuk e keni zbatuar - zbatojeni! Shihni Jaeger/Zipkin
Alarmin
- Organizimi i sistemit të njoftimeve: në kushtet e monitorimit të një numri të madh gjërash duhet të ketë një sistem të unifikuar për shpërndarjen e njoftimeve. Mund ta bëni në Grafana. Në Perëndim, të gjithë përdorin PagerDuty. Njoftimet duhet të jenë të qarta (p.sh., nga kanë ardhur…). Është e preferueshme të kontrolloni nëse njoftimet arrijnë vërtet.
- Organizimi i sistemit të turneve: alertrat nuk duhet të vijnë për të gjithë (ndryshe të gjithë do të reagojnë si turmë, ose askush nuk do të reagojë). Oncall duhet të përfshijë edhe zhvilluesit: sigurohuni që të përcaktoni zonat e përgjegjësisë, bëni një udhëzim të qartë dhe shkruani në të se kujt saktësisht duhet të i telefononi të hënën dhe të mërkurën, dhe kujt — të martën dhe të premten (ndryshe askush nuk do të telefonojë madje as në rast katastrofash të mëdha — do të frikësohen të zgjojnë ose shqetësojnë: njerëzit në përgjithësi nuk i pëlqen të telefonojnë dhe të zgjojnë të tjerët, sidomos natën). Dhe shpjegoni se kërkimi për ndihmë nuk është tregues i paaftësisë (‘po kërkoj ndihmë — do të thotë se jam punonjës i keq’), inkurajoni kërkesat për ndihmë.
- Organizimi i ‘bazës së njohurive’ dhe procesit të trajtimit të incidenteve: për çdo incident të rëndë duhet të planifikohet një postmortem, si një masë përkohore, duhen regjistruar veprimet që do të zgjidhin incidentin. Dhe krijoni një praktikë që alertrat e përsëritura janë një mëkat; ato duhet të regjistrohen në kod ose në punët infrastrukturore.
Stoku teknologjik
Le të imagjinojmë se staku ynë është si më poshtë:
- mbledhja e të dhënave — Prometheus + Grafana;
- analiza e protokolleve — ELK;
- për APM ose gjurmim — Jaeger (Zipkin).

Zgjedhja e opsioneve nuk është kritike. Sepse, nëse e kuptoni në fillim se si të monitoroni sistemin dhe keni bërë një plan, atëherë filloni të zgjidhni mjetet sipas kërkesave tuaja. Pyetja është se çfarë vendosët të monitoroni fillimisht. Sepse, ndoshta, mjeti që zgjodhët fillimisht — thjesht nuk i përshtatet kërkesave tuaja.
Disa pika teknike që unë po shoh kudo kohët e fundit:
Prometheus po shtohet brenda Kubernetes — kush e përfundoi këtë?! Nëse klasteri juaj bie, çfarë do të bëni? Nëse keni një klaster të ndërlikuar brenda, duhet të funksionojë një sistem monitorimi brenda klasterit, dhe një tjetër — jashtë, që do të mbledhë të dhëna nga brenda klasterit.
Brenda klasterit ne mbledhim protokollet dhe gjithçka tjetër. Por sistemi i monitorimit duhet të jetë jashtë. Shumë shpesh në klaster, ku ka Promtheus të vendosur brenda, janë gjithashtu sisteme që bëjnë kontrolle të jashtme të funksionimit të faqes. E nëse lidhjet me botën e jashtme bien dhe aplikacioni nuk punon? Del se brenda gjithçka është mirë, por përdoruesit nuk e kanë më të lehtë.
Përfundimet
- Zhvillimi i monitorimit nuk është thjesht instalimi i utiliteteve, por zhvillimi i një produkti programor. 98% e monitorimit të sotëm është kodim. Kodim në shërbime, kodim i kontrolleve të jashtme, kontrolli i shërbimeve të jashtme, dhe të gjitha-të gjitha-të gjitha.
- Mos hidhni poshtë kohën e zhvilluesve për monitorimin: kjo mund të marrë deri në 30% të punës së tyre, por ia vlen.
- DevOps, mos u shqetësoni që nuk po arrini të monitoroni diçka, sepse disa gjëra janë në të vërtetë një mendësi krejt tjetër. Nuk ishit programues, dhe puna e monitorimit është pikërisht puna e tyre.
- Nëse projekti tashmë funksionon dhe nuk është monitoruar (dhe ju jeni menaxher) - caktoni burime për monitorim.
- Nëse produkti është tashmë në prodhim dhe ju jeni DevOps-i që u tha "të konfigurojë monitorimin" - përpiquni të shpjegoni drejtuesve atë që kam thënë këtu.
Kjo është një version i zgjeruar i një referati në konferencën Saint Highload++.
Nëse jeni të interesuar për idetë dhe mendimet e mia mbi IT dhe tema të ngjashme, ja ku mund të 🙂
Burimi: habr.com
