

Më quajnë Anton Baderin. Punoj në Qendrën e Teknologjive të Larta dhe merrem me administrimin e sistemeve. Një muaj më parë përfunduam konferencën tonë korporative, ku ndamë përvojën e akumuluar me komunitetin IT të qytetit tonë. Folëm për monitorimin e aplikacioneve web. Materiali ishte i destinuar për nivelin junior ose mesatar, ata që nuk e kishin ndërtuar këtë proces nga zero.
Guri i themelit, që qëndron në bazë të çdo sistemi monitorimi — zgjidhja e problemeve të biznesit. Monitorimi për monitorimin nuk i intereson askënd. Çfarë dëshiron biznesi? Që gjithçka të funksionojë shpejt dhe pa gabime. Biznesi dëshiron proaktivitet, që ne vetë të identifikojmë problemet në funksionimin e shërbimit dhe t'i zgjidhim ato sa më shpejt të jetë e mundur. Këto, në thelb, janë detyrat që kam zgjidhur gjatë gjithë vitit të kaluar në projektin e një nga klientëve tanë.
Për projektin
Projekti — një nga programet më të mëdha të besnikërisë në vend. Ndihmojmë rrjetet me pakicë të rrisin frekuencën e shitjeve përmes mjeteve të ndryshme marketingu si kartat bonus. Në total, projekti përfshin 14 aplikacione, të cilat funksionojnë në dhjetë servera.
Gjatë procesit të intervistave, kam vënë re se administratoret nuk e qasen gjithmonë si duhet monitorimin e aplikacioneve web: ende shumë ndalen te metriku i sistemit operativ, herë pas here monitorojnë shërbimet.
Në rastin tim, më parë, në bazën e sistemit të monitorimit të klientit ishte Icinga. Ajo nuk zbulonte ashtu siç duhej problemet e përmendura më parë. Shpesh, klienti vetë na informonte për problemet dhe jo më pak na mungonin të dhënat për të kuptuar shkakun.
Përveç kësaj, kishte një kuptim të qartë për pamundësinë e zhvillimit të saj të mëtejshëm. Mendoj, ata që janë të njohur me Icinga do të më kuptojnë. Kështu, vendosëm të riparojmë plotësisht sistemin e monitorimit të aplikacioneve web në projekt.
Prometheus
Zgjedhëm Prometheus, duke u bazuar në tri tregues të rëndësishëm:
- Një numër i madh metricash të disponueshme. Në rastin tonë, ato janë 60 mijë. Sigurisht, vlen të theksohet se shumica dërrmuese e tyre nuk përdoren (ndoshta rreth 95%). Në anën tjetër, të gjitha janë relativisht të lira. Kjo është një tjetër ekstrem për ne, krahasuar me Icinga, që kemi përdorur më parë. Atje, shtimi i metricave ishte veçanërisht i dhimbshëm: ato që kishim ishin të shtrenjta (mjafton të shikosh burimet e çdo plugin). Çdo plugin ishte një skritp në Bash ose Python, qasja e të cilit ishte e shtrenjtë në terma të burimeve të konsumuar.
- Ky sistem konsumon një sasi relativisht të vogël burimesh. Për të gjitha metricat tona, mjaftojnë 600 Mb RAM, 15% e një bërthame dhe disa dhjetëra IOPS. Sigurisht, duhet të aktivizojmë eksportuesit e metricave, por të gjithë janë shkruar në Go dhe gjithashtu nuk janë të uritur. Nuk mendoj se në realitetet moderne kjo është një problem.
- Ofron mundësinë e kalimit në Kubernetes. Duke marrë parasysh planet e klientit — zgjedhja është e qartë.
ELK
Më parë, ne nuk mbledhim dhe nuk përpunojmë logët. Disavantazhet janë të qarta për të gjithë. Ne zgjodhëm ELK, pasi kishim eksperiencë të mëparshme me këtë sistem. Atje ruajmë vetëm logët e aplikacioneve. Kriteret kryesore për përzgjedhjen ishin kërkimi në tekst të plotë dhe shpejtësia e tij.
Clickhouse
Fillimisht, zgjedhja ra mbi InfluxDB. Ne e dinim nevojën për mbledhjen e logëve Nginx, statistikat nga pg_stat_statements, ruajtjen e të dhënave historike të Prometheus. Influx nuk na pëlqeu, pasi nga koha në kohë filloi të konsumonte shumë memorje dhe rrëzohej. Për më tepër, ne do të doja të grumbulloja kërkesat sipas remote_addr, ndërsa grumbullimi në këtë DB është vetëm sipas etiketave. Etiketat janë të shtrenjta (memorie), numri i tyre është në mënyrë të kushtëzuar i kufizuar.
Ne filluam kërkimin nga fillimi. Na nevojitej një bazë analitike me konsum minimal burimesh, idealisht me kompresimin e të dhënave në disk.
Clickhouse plotëson të gjitha këto kritere, dhe në asnjë rast nuk kemi penduar për zgjedhjen. Ne nuk shkruajmë ndonjë volum të jashtëzakonshëm të dhënash (numri i futjeve është rreth pesë mijë në minutë).
NewRelic
NewRelic historikisht ka qenë me ne, pasi ishte zgjedhja e klientit. Ajo përdoret si APM.
Zabbix
Ne përdorim Zabbix ekskluzivisht për monitorimin e Black Box të API-ve të ndryshme.
Përcaktimi i qasjes ndaj monitorimit
Na pëlqente të dekompozonim detyrën dhe kështu të sistematizonim qasjen ndaj monitorimit.
Për këtë arsye, unë e kam ndarë sistemin tonë në nivele të ndryshme:
- ‘hardueri’ dhe VMS;
- sistemi operativ;
- shërbimet sistemore, staku i softuerit;
- aplikacioni;
- logjika e biznesit.
Pse është i dobishëm ky qasje:
- ne dimë kush është përgjegjës për funksionimin e secilit nivel dhe, duke u bazuar në këtë, mund të dërgojmë alarme;
- mund të përdorim strukturën për të shuar alarmet — do të ishte e çuditshme të dërgonim një alarm për mosfunksionimin e bazës së të dhënave, kur në përgjithësi makina virtuale nuk është në dispozicion.
Duke pasur parasysh se detyra jonë është të identifikojmë shkeljet në funksionimin e sistemit, duhet të evidentojmë një set metricash në çdo nivel, të cilat ia vlen të merren parasysh gjatë shkruarjes së rregullave të alarmin. Më poshtë do të kalojmë në nivelet ‘VMS’, ‘Sistemi Operativ’ dhe ‘Shërbimet Sistemore, Staku i Softuerit’.
Makinat virtuale
Hosting na ndan procesorin, disku, memorjen dhe rrjetin. Dhe për dy të parat patëm disa probleme. Pra, metricat:
Koha e vjedhur e CPU — kur blini një virtual si në Amazon (p.sh. t2.micro), duhet të kuptoni se ju jepet jo një bërthamë të plotë të procesorit, por vetëm një kuotë të kohës së tij. Dhe kur ta shpenzoni, procesori do të fillojë të merret nga ju.
Kjo metrikë lejon të monitoroni këto momente dhe të merrni vendime. Për shembull, a duhet të merrni një tarifë më të madhe apo të ndajmë përpunimin e detyrave pasive dhe kërkesat në API në të ndryshme serverë.
IOPS + Koha e pritjes së CPU iowait — për ndonjë arsyetim, shumë hoste në re shpesh dështojnë në dhënien e IOPS. Më shumë, një grafik me IOPS të ulët për ta nuk është një argument. Prandaj është e rëndësishme të grumbullojmë edhe CPU iowait. Me këtë çift grafikësh — me IOPS të ulët dhe pritje të lartë të hyrjeve-daljeve — mund të flasim me hostin dhe të zgjidhim problemin.
Sistemi operativ
Metricat e sistemit operativ:
- numri i memories së disponueshme në %;
- aktiviteti i përdorimit të swap: vmstat swapin, swapout;
- numri i inode-ve të disponueshëm dhe hapësira e lirë në sistemin e skedarëve në %
- ngarkesa mesatare;
- numri i lidhjeve në gjendje tw;
- mbushja e tabelës conntrack;
- cilësia e funksionimit të rrjetit mund të monitorohet me ndihmën e utilitetit ss, me paketën iproute2 — duke marrë nga dalja e saj treguesin e RTT-lidhjeve dhe grupuar sipas portit destinacion.
Po ashtu, në nivelin e sistemit operativ kemi një entitet të tillë, si proceset. Është e rëndësishme të evidentojmë një set procesesh në sistem që luajnë një rol të rëndësishëm në funksionimin e tij. Nëse, për shembull, keni disa pgpool, është e nevojshme të grumbulloni informacion për secilin prej tyre.
Seti i metricave është si më poshtë:
- CPU;
- memoria — në radhë të parë, rezidente;
- IO — idealisht në IOPS;
- FileFd — hapjet dhe kufiri;
- dështimet e rëndësishme të faqeve — kështu do të mund të kuptoni se cili proces është duke swap-uar.
E gjithë monitorimi ynë është e vendosur në Docker; për mbledhjen e të dhënave të metrikave përdorim Cadvisor. Në makinat e tjera përdorim process-exporter.
Shërbimet sistemor, staku i softuerit
Çdo aplikacion ka specifikën e vet, dhe është e vështirë të veçosh një grup të caktuar metrikash.
Grupi universale është:
- norma e kërkesave;
- numri i gabimeve;
- latenca;
- saturation.
Shembujt më të dukshëm të monitorimit në këtë nivel janë — Nginx dhe PostgreSQL.
Shërbimi më i ngarkuar në sistemin tonë është databaza. Më parë, ne kishim probleme mjaft shpesh për të zbuluar çfarë po bënte databaza.
Ne pamë një ngarkesë të lartë në disqe, por log-et e ngadalta nuk tregonin asgjë në të vërtetë. Këtë problem e zgjidhëm me ndihmën e pg_stat_statements, një paraqitje ku grumbullohet statistika mbi kërkesat.
Kjo është gjithçka që i nevojitet administratorit.
Ndërtojmë grafike aktiviteti të kërkesave për lexim dhe shkrim:
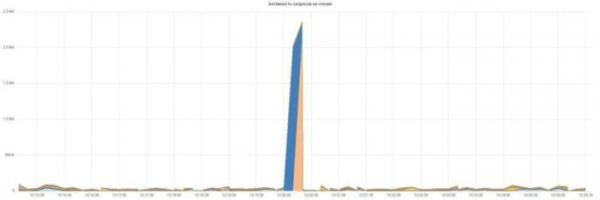
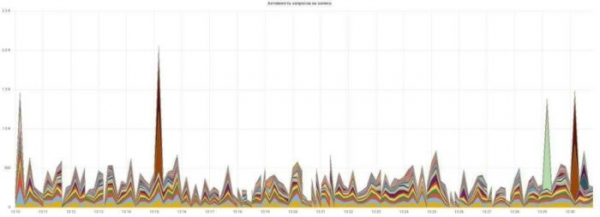
E gjithë kjo është e thjeshtë dhe e qartë, çdo kërkesë ka ngjyrën e saj.
Një shembull po ashtu i dukshëm — log-et e Nginx. Nuk është e habitshme që pak kush i përpunon ato ose i përmend në listën e detyrueshme. Formati standard nuk është shumë informues dhe është e nevojshme që të zgjerohet.
Personalizova aq, sa shtova request_time, upstream_response_time, body_bytes_sent, request_length, request_id. Ndërtojmë grafike të kohës së përgjigjes dhe numrit të gabimeve:
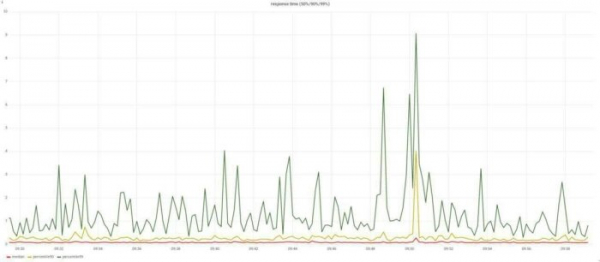
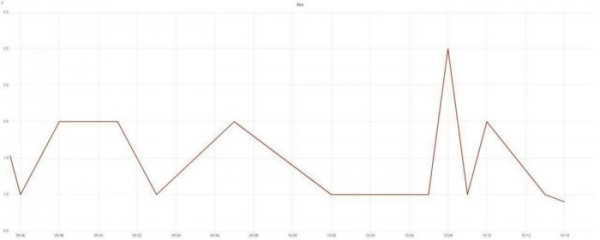
Ndërtojmë grafike të kohës së përgjigjes dhe numrit të gabimeve. A e mbani mend? Unë fola për detyrat e biznesit? Të gjitha shpejt dhe pa gabime? Ne tashmë i kemi mbyllur këto pyetje me dy grafikë. Dhe mbi ta, tani është e mundur të telefonosh administratorët e shërbimit.
Por ka mbetur një problem tjetër — të sigurojmë eliminimin e shpejtë të shkaqeve të incidentit.
Eliminimi i incidenteve
E gjithëProcedura nga identifikimi deri në zgjidhjen e problemit mund të ndahet në disa hapa:
- identifikimi i problemit;
- njoftimi i administratorit të shërbimit;
- reaksioni ndaj incidentit;
- eliminimi i shkaqeve.
Është e rëndësishme që ne të bëjmë këtë sa më shpejt të jetë e mundur. Dhe nëse në etapet e identifikimit të problemit dhe dërgimin e njoftimit nuk mund të fitojmë shumë kohë — dy minuta do të shkojnë në çdo rast, atëherë etapet e mëpasshme janë thjesht një fushë e paprekur për përmirësime.
Le të imagjinomë se telefoni i rojës së shërbimit ka rënë. Çfarë do të bëjë ai? Do të kërkojë përgjigje për pyetje — çfarë është prishur, ku është prishur, si të reagojë? Kështu përgjigjemi në këto pyetje:
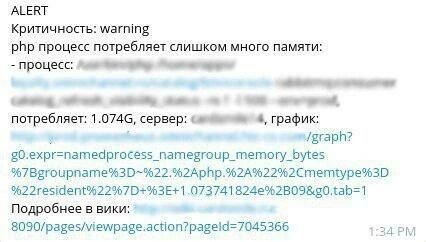
Ne thjesht përfshijmë të gjitha këto informacione në tekstin e njoftimit dhe i japim një lidhje për faqen në wiki, ku përshkruhet se si të reagoni për këtë problem, si ta zgjidhni dhe ta eskaloni atë.
Unë ende nuk kam thënë asgjë për nivelin e aplikacionit dhe logjikën e biznesit. Fatkeqësisht, në aplikacionet tona ende nuk është implementuar mbledhja e metrikave. Burimi i vetëm i jakëson ndonjë informacion nga këto nivele janë loget.
Disa pika.
Së pari, shkruani loge të strukturuara. Mos e përfshini kontekstin në tekstin e mesazhit. Kjo e vështirëson grupimin dhe analizën e tyre. Logstash kërkon shumë kohë për t'i normalizuar të gjitha këto.
Së dyti, përdorni saktësisht nivelet e rëndësisë. Çdo gjuhë ka standardin e saj. Personalisht, ndaj katër nivele:
- nuk ka gabim;
- gabim nga ana e klientit;
- gabim nga ana jonë, nuk humbasim para, nuk kemi rreziqe;
- gabim nga ana jonë, humbasim para.
Në përmbledhje. Duhet të përpiqemi të ndërtojmë monitorimin pikërisht nga logjika e biznesit. Të përpiqemi të monitorojmë vetë aplikacionin dhe të operojmë me metrika si numri i shitjeve, numri i regjistrimeve të reja të përdoruesve, numri i përdoruesve aktivë në këtë moment dhe kështu me radhë.
Nëse e gjithë biznesi juaj është një buton në shfletues, duhet të monitoroni nëse ai klikohet, nëse funksionon siç duhet. Gjithçka tjetër nuk ka rëndësi.
Nëse nuk e keni këtë, mund të përpiqeni ta rikuperoni këtë në loget e aplikacionit, loget Nginx dhe kështu me radhë, siç kemi bërë ne. Duhet të jeni sa më afër aplikacionit.
Metrit e sistemit operativ sigurisht që janë të rëndësishme, por biznesi nuk është i interesuar për to, ne nuk paguhet për to.
Burimi: habr.com
