

Përshëndetje, miq. Para se të shkojmë në pjesën e dytë të festimeve të majit, po ndajmë me ju një material, që e kemi përkthyer në prag të lançimit të një grupi të ri të kursit. .
Zhvilluesit e aplikacioneve shpenzojnë shumë kohë duke krahasuar disa baza të dhënash operuese për të zgjedhur atë që do t'i përshtatet më së miri ngarkesës së parashikuar të punës. Nevojat mund të përfshijnë modelimin e thjeshtuar të të dhënave, garantimin e transaksioneve, performancën e leximit/shkrimit, shkallëzimin horizontal dhe qëndrueshmërinë ndaj dështimeve. Tradicionalisht, zgjedhja fillon me kategorinë e bazës së të dhënave, SQL ose NoSQL, pasi secila kategori ofron një grup të qartë kompromisesh. Performanca e lartë në terma të vonesës së ulët dhe kapacitetit të lartë zakonisht konsiderohet si një kërkesë që nuk lejon kompromis, dhe prandaj është e nevojshme për çdo bazë të dhënash nga mostra.
Qëllimi i këtij artikulli është të ndihmojë zhvilluesit e aplikacioneve të bëjnë zgjedhjen e duhur mes SQL dhe NoSQL në kontekstin e modelimit të të dhënave të aplikacionit. Ne do të shqyrtojmë një bazë të dhënash SQL, konkretisht PostgreSQL dhe dy baza të dhënash NoSQL – Cassandra dhe MongoDB, për të folur rreth bazave të projektimit të bazave të të dhënave, siç janë krijimi i tabelave, mbushja e tyre, leximi i të dhënave nga tabela dhe fshirja e tyre. Në artikullin e ardhshëm, ne patjetër do të shqyrtojmë indekset, transaksionet, JOIN-et, direktivat TTL dhe projektimin e bazave të të dhënave mbi bazën e JSON.
Çfarë e diferencoi SQL nga NoSQL?
Baza të dhënash SQL rrisin fleksibilitetin e aplikacionit falë garantive të transaksioneve ACID, si dhe për shkak të aftësisë për të kërkuar të dhëna në mënyra të papritura mbi modelet e normalizuara ekzistuese të bazave të të dhënave relacionale.
Duke marrë parasysh arkitekturën e tyre monolite/ një-nodale dhe përdorimin e modelit të replikimit master-slave për disponueshmëri, databazat tradicionale SQL nuk kanë dy karakteristika të rëndësishme – shkallëzimin linear të shkruarjes (dmth ndarjen automatike në disa node) dhe humbjen automatike/zero të të dhënave. Kjo do të thotë se sasia e të dhënave që merret nuk mund të kalojë kapacitetin maksimal të shkruarjes të një nodi. Përveç kësaj, një humbje e përkohshme e të dhënave duhet të merret parasysh për qëllime qëndruese në rastin e një arkitekture pa ndarje të burimeve. Ktu është e rëndësishme të kemi parasysh se komitetet e fundit ende nuk janë reflektuar në kopjen e nënshtruar (slave). Përditësimet pa ndaluar gjithashtu janë të vështira për t'u arritur në databazat SQL.
Databazat NoSQL natyrisht janë shpërndarë, dmth të dhënat ndahen në seksione dhe shpërndahen në disa node. Ato kërkojnë denormalizim. Kjo do të thotë se të dhënat e futur gjithashtu duhet të kopjohen disa herë për të bërë përgjigje ndaj pyetjeve të caktuara që dërgoni. Qëllimi i përgjithshëm është të arrihet një performancë e lartë duke reduktuar numrin e shardëve të disponueshëm gjatë leximit. Nga kjo ndjek mëndimi se NoSQL kërkon që ju të modeloni pyetjet tuaja, ndërsa SQL kërkon që ju të modeloni të dhënat tuaja.
NoSQL fokusohet në arritjen e një performancë të lartë në një klaster të shpërndarë dhe kjo është arsyetimi kryesor që qëndron pas shumë kompromiseve të dizajnit të databazave, të cilat përfshijnë humbjen e garantive ACID të transaksioneve, JOIN-et dhe indekset globale të dytë të konsoliduar.
Ekziston një mendim se, megjithëse databazat NoSQL ofrojnë shkallëzim linear të shkruarjes dhe një qëndrueshmëri të lartë, humbja e garantive transaksionale i bën ato të papërshtatshme për të dhënat kritikisht të rëndësishme.
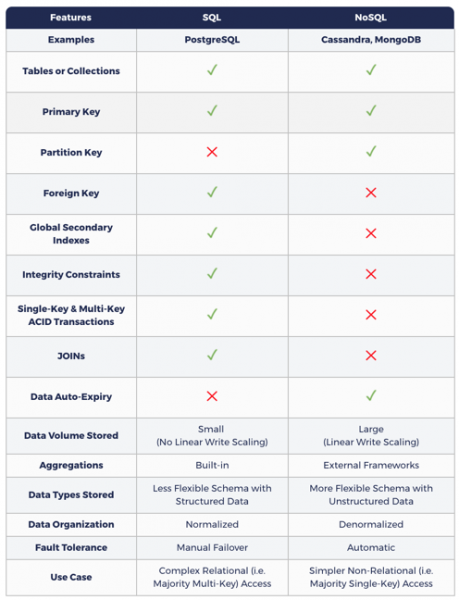
Tabela e mëposhtme tregon se si modelimi i të dhënave në NoSQL ndryshon nga SQL.
SQL dhe NoSQL: Pse nevojiten të dyja?
Në aplikacionet reale me një numër të madh përdoruesish, si Amazon.com, Netflix, Uber dhe Airbnb, përfshihet kryerja e detyrave komplekse të shumëllojshme. Për shembull, një aplikacion për tregtinë elektronike si Amazon.com ka nevojë për të ruajtur të dhëna të lehta, me rëndësi të madhe, si informacioni mbi përdoruesit, produktet, porositë, faturat, së bashku me të dhëna më të rënda, por më pak të ndjeshme, siç janë rishikimet e produkteve, mesazhet e shërbimit të mbështetjes, aktiviteti i përdoruesve, dëshmitë dhe rekomandimet e përdoruesve. Natyrisht, këto aplikacione mbështeten të paktën në një bazë të dhënash SQL, së bashku me të paktën një bazë të dhënash NoSQL. Në sistemet ndër-rajoni dhe globale, një bazë e dhënash NoSQL funksionon si një cache gjeo-distribuese për të dhënat që ruhen në një burim të besueshëm, një bazë të dhënash SQL që funksionon në një rajon të vetëm.
Si e bashkon YugaByte DB SQL dhe NoSQL?
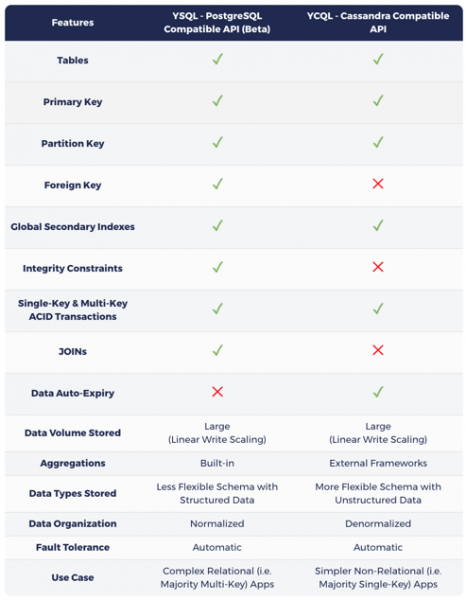
E ndërtuar në një engine të përzier log-orientuar për ruajtjen, auto-sharding, replikim konsensual të shpërndarë dhe transaksione ACID të shpërndara (të frymëzuara nga Google Spanner), YugaByte DB është baza e të dhënave e parë në botë me burim të hapur që është njëkohësisht e përshtatshme me NoSQL (Cassandra & Redis) dhe SQL (PostgreSQL). Siç tregohet në tabelën më poshtë, YCQL, API YugaByte DB që është i përshtatshëm me Cassandra, shton konceptet e transaksioneve ACID një- dhe shumë-çelëshe, si dhe indekse globale të dytë në API-në NoSQL, duke hapur kështu një epokë të bazave të të dhënave NoSQL transaksionale. Për më tepër, YCQL, API YugaByte DB që është i përshtatshëm me PostgreSQL, shton konceptet e shkallëzimit linear të shkrimit dhe automatizimin e dështimeve në API-në SQL, duke iu treguar botës bazat e të dhënave SQL të shpërndara. Duke qenë se baza e të dhënave YugaByte DB është në thelb transaksionale, API e NoSQL tani mund të përdoret në kontekstin e të dhënave kritike.
Siç u theksua më parë në artikullin , zgjedhja midis SQL ose NoSQL në YugaByte DB varet plotësisht nga karakteristikat e ngarkesës kryesore të punës:
- Nëse ngarkesa kryesore është operacione me shumë çelësa me JOIN, kur zgjidhni YSQL, kuptoni se çelësat tuaj mund të kenë shpërndarë në disa nyje, çka do të çojë në vonesa më të larta dhe/ose një reduktim të kapacitetit rendor krahasuar me NoSQL.
- Në të kundërt, zgjidhni ndonjë nga dy API-të NoSQL, duke mbajtur mend se do të merrni një performancë më të lartë nga pyetjet që shërbehen nga një nod njëherësh. YugaByte DB mund të shërbejë si një bazë e vetme operative për aplikacione komplekse në të vërtetë, të cilat kërkojnë menaxhimin e ngarkesave të shumta në të njëjtën kohë.
Në themel të laboratorit të modelimit të të dhënave (Data modeling lab) në seksionin e ardhshëm qëndron bazat e të dhënave YugaByte DB që janë të pajtueshme me PostgreSQL dhe Cassandra, ndryshe nga bazat e të dhënave burimore. Ky qasje thekson thjeshtësinë e ndërveprimit me dy API të ndryshme (në dy porte të ndryshme) të së njëjtës grumbull të të dhënave, ndryshe nga përdorimi i grumbujve të pavarur të dy bazave të ndryshme të të dhënave.
Në seksionet në vijim do të njihemi me laboratorin e modelimit të të dhënave, për të ilustruar dallimet dhe disa karakteristika të përbashkëta të bazave të të dhënave të shqyrtuara.
Laboratori i modelimit të të dhënave
Instalimi i bazave të të dhënave
Duke pasur parasysh fokusin në projektimin e modelit të të dhënave (dhe jo në arkitekturën komplekse të implementimit), ne do të instalojmë bazat e të dhënave në kontejnerë Docker në kompjuterin lokal dhe më pas do të ndërveprojmë me to duke përdorur shell-et e duhur të komandave.
Baza e të dhënave YugaByte DB e pajtueshme me PostgreSQL & Cassandra
mkdir ~/yugabyte && cd ~/yugabyte
wget https://downloads.yugabyte.com/yb-docker-ctl && chmod +x yb-docker-ctl
docker pull yugabytedb/yugabyte
./yb-docker-ctl create --enable_postgres
MongoDB
docker run --name my-mongo -d mongo:latestQasja përmes komandës së linjës
Le të lidhemi me bazat e të dhënave, duke përdorur shellin e komandës për API-të përkatëse.
PostgreSQL
— është shelli i komandës për ndërveprimin me PostgreSQL. Për lehtësi përdorimi, YugaByte DB vjen me psql përbrenda dosjes bin.
docker exec -it yb-postgres-n1 /home/yugabyte/postgres/bin/psql -p 5433 -U postgresCassandra
— është shelli i komandës për ndërveprimin me Cassandra dhe bazat e saj të dhënash që janë të pajtueshme përmes CQL (gjuha e pyetjeve Cassandra). Për lehtësi përdorimi, YugaByte DB vjen me cqlsh në katalogun bin.
Kujdes, CQL është frymëzuar nga SQL dhe ka koncepte të ngjashme si tabela, rreshta, kolona dhe indekse. Megjithatë, si një gjuhë NoSQL, ajo shton një grup të caktuar kufizimesh, shumica e të cilave do t'i shqyrtojmë gjithashtu në artikuj të tjerë.
docker exec -it yb-tserver-n1 /home/yugabyte/bin/cqlshMongoDB
– është një ndërfaqe komandash për të interaguar me MongoDB. Ajo mund të gjendet në katalogun bin të instalimit të MongoDB.
docker exec -it my-mongo bash
cd bin
mongo
Krijimi i tabelës
Tani mund të ndërveprojmë me bazën e të dhënave për të kryer operacione të ndryshme përmes komandës. Le të fillojmë me krijimin e një tabele që ruan informacion mbi këngët e shkruara nga artistë të ndryshëm. Këngët mund të jenë pjesë e një albumi. Po ashtu, atributet opsionale për këngën janë viti i publikimit, çmimi, zhanri dhe vlerësimi. Na nevojitet të merremi parasysh atributet shtesë që mund të nevojiten në të ardhmen, përmes fushës "tags". Ajo mund të ruajë të dhëna gjysmë-strukturore në formën e çifteve çelës-vlerë.
PostgreSQL
KRIJO TABELË Muzikë (
    Artist VARCHAR(20) NOT NULL,
    TitulliKëngës VARCHAR(30) NOT NULL,
    TitulliAlbumit VARCHAR(25),
    Viti INT,
    Çmimi FLOAT,
    Zhanri VARCHAR(10),
    VlerësimiKritik FLOAT,
    Tags TEXT,
    ÇELËSI PRIMAR(Artist, TitulliKëngës)
);
Cassandra
Krijimi i tabelës në Cassandra është shumë i ngjashëm me PostgreSQL. Një nga dallimet kryesore është mungesa e kufizimeve të integritetit (p.sh., NOT NULL), por kjo bie në përgjegjësinë e aplikacionit dhe jo të bazës së të dhënave NoSQL.. Çelësi primar përbëhet nga çelësi i pjesës (kolona Artist në shembullin më poshtë) dhe një grup kolonesh të klasifikimit (kolona TitulliKëngës në shembullin e mëposhtëm). Çelësi i pjesës përcakton në cilën pjesë/shard duhet vendosur rreshti, dhe kolona të klasifikimit tregojnë se si duhet të organizohen të dhënat brenda këtij shard.
KRIJO HAPËSIRË myapp;
PËRDOR myapp;
KRIJO TABELË Muzikë (
    Artist TEXT,
    TitulliKëngës TEXT,
    TitulliAlbumit TEXT,
    Viti INT,
    Çmimi FLOAT,
    Zhanri TEXT,
    VlerësimiKritik FLOAT,
    Tags TEXT,
    ÇELËSI PRIMAR(Artist, TitulliKëngës)
);
MongoDB
MongoDB organizon të dhënat në baza të dhënash (Database) (analogjisht me Keyspace në Cassandra), ku ka koleksione (Collections) (analogjisht me tabelat), në të cilat ndodhen dokumentet (Documents) (analogjisht me rreshtat në tabelë). Në MongoDB në thelb nuk kërkohet përcaktimi i një skeme fillestare. Komanda "përdor databazën", e paraqitur më poshtë, krijon një instancë të bazës së të dhënave me thirrjen e parë dhe ndryshon kontekstin për bazën e të dhënave të sapokrijuar. Edhe koleksionet nuk kanë nevojë të krijohen në mënyrë të qartë; ato krijohen automatikisht, thjesht duke shtuar dokumentin e parë në një koleksion të ri. Vëreni se MongoDB për default përdor bazën e të dhënave testuese; kështu, çdo operacion në nivelin e koleksioneve pa përcaktimin e një baze specifike do të ekzekutohet aty për default.
përdor myNewDatabase;Marrja e informacionit mbi tabelën
PostgreSQL
d Muzikës
Tabela "public.music"
    Kolona    |         Tipi          | Kolonizimi | Lejohet | Default
--------------+-----------------------+-----------+----------+--------
 artist       | karakter variues (20) |           | jo null |
 songtitle    | karakter variues (30) |           | jo null |
 albumtitle   | karakter variues (25) |           |          |
 year         | numërik               |           |          |
 price        | precizion dyfoldë     |           |          |
 genre        | karakter variues (10) |           |          |
 criticrating | precizion dyfoldë     |           |          |
 tags         | tekst                  |           |          |
Indekset:
    "music_pkey" ÇELSI PRIMAR, btree (artist, songtitle)
Cassandra
PËRSHKRUANI TABELËN MUSIC;
KRIJO TABELËN myapp.music (
    artist tekst,
    songtitle tekst,
    albumtitle tekst,
    year int,
    price float,
    genre tekst,
    tags tekst,
    ÇELSI PRIMAR (artist, songtitle)
) ME RENDITJEN E KLASIFIKIMIT NGA (songtitle ASC)
    DHE default_time_to_live = 0
    DHE transaksionet = {'enabled': 'false'};
MongoDB
përdor myNewDatabase;
shiko koleksionet;
Shtimi i të dhënave në tabelë
PostgreSQL
SHTO NË Muzikë
    (Artist, SongTitle, AlbumTitle,
    Vit, Çmimi, Zhanri, Vlerësimi i Kritikës,
    Etiketat)
VLERAT(
    'Asnjë Person që Njihni', 'Më Telefononi Sot', 'Disa Herë të Njohur',
    2015, 2.14, 'Country', 7.8,
    '{"Kompozitorë": ["Smith", "Jones", "Davis"],"GjatësiaNëSekonda": 214}'
);
SHTO NË Muzikë
    (Artist, SongTitle, AlbumTitle,
    Çmimi, Zhanri, Vlerësimi i Kritikës)
VLERAT(
    'Asnjë Person që Njihni', 'Qeni Im Spot', 'Hej Tani',
    1.98, 'Country', 8.4
);
SHTO NË Muzikë
    (Artist, SongTitle, AlbumTitle,
    Çmimi, Zhanri)
VLERAT(
    'Grupi Acme', 'Kujdes Bota', 'Këtu Fillon Buck',
    0.99, 'Rock'
);
SHTO NË Muzikë
    (Artist, SongTitle, AlbumTitle,
    Çmimi, Zhanri,
    Etiketat)
VLERAT(
    'Grupi Acme', 'Akoma në Dashuri', 'Këtu Fillon Buck',
    2.47, 'Rock',
    '{"stacionetRadio qëLuanë": ["KHCR", "KBQX", "WTNR", "WJJH"], "datatETurneve": { "Seattle": "20150625", "Cleveland": "20150630"}, "rotacioni": Heavy}'
);
Cassandra
Në përgjithësi, shprehja SHTO në Cassandra duket shumë e ngjashme me analogjinë në PostgreSQL. Megjithatë, ka një dallim të madh në semantikë. Në Cassandra SHTO përfaqëson në të vërtetë një operacion UPSERT, ku në rresht shtohen vlerat e fundit, nëse rreshti tashmë ekziston.
Hyrja e të dhënave ndodh në mënyrë të ngjashme me PostgreSQL
SHTOmë sipër
.
MongoDB
Pavarësisht se MongoDB është një bazë të dhënash NoSQL, ashtu si Cassandra, operacioni i saj për futjen e të dhënave nuk ka asgjë të përbashkët me sjelljen semantike në Cassandra. Në MongoDB nuk ka mundësi UPSERT, që e bën atë të ngjasojë me PostgreSQL. Shtimi i të dhënave pa default _idspecified do të ketë si pasojë shtimin e një dokumenti të ri në koleksion.
db.music.insert( {
 artist: "Askush Njeri",
 songTitle: "Më Telefon Today",
 albumTitle: "Pak Më I Famshëm",
 year: 2015,
 price: 2.14,
 genre: "Country",
 tags: {
 Composers: ["Smith", "Jones", "Davis"],
 LengthInSeconds: 214
 }
 }
 );
 db.music.insert( {
 artist: "Askush Njeri",
 songTitle: "Qeni Im Spot",
 albumTitle: "Hej Tani",
 price: 1.98,
 genre: "Country",
 criticRating: 8.4
 }
 );
 db.music.insert( {
 artist: "Bendi Acme",
 songTitle: "Kujdes, Botë",
 albumTitle:"Pika Fillon Këtu",
 price: 0.99,
 genre: "Rock"
 }
 );
 db.music.insert( {
 artist: "Bendi Acme",
 songTitle: "Ende Në Dashuri",
 albumTitle:"Pika Fillon Këtu",
 price: 2.47,
 genre: "Rock",
 tags: {
 radioStationsPlaying:["KHCR", "KBQX", "WTNR", "WJJH"],
 tourDates: {
 Seattle: "20150625",
 Cleveland: "20150630"
 },
 rotation: "Heavy"
 }
 }
 );
Kërkesa e tabelës
Mund të jetë dallimi më substancial midis SQL dhe NoSQL në lidhje me formimin e kërkesave qëndron në përdorimin e formulimeve FROM dhe KU. SQL lejon pas shprehjes FROM të përzgjidhni disa tabela, ndërsa shprehja me KU mund të jetë sa do komplekse (duke përfshirë operacionet JOIN në mes tabelave). Megjithatë, NoSQL ka tendencën të vendosë një kufizim të fortë mbi FROM, dhe të funksionojë vetëm me një tabelë të caktuar, dhe në KU, gjithmonë duhet të jepet çelësi primar. Kjo është për shkak të dëshirës për të rritur performancën e NoSQL, për të cilën kemi folur më parë. Kjo dëshirë çon në minimizimin e çdo ndërveprimi ndërmjet tabelave dhe çelësave. Ajo mund të sjellë vonesa të mëdha në lidhjet ndërnodyneshëm kur përgjigjet për një kërkesë dhe, për rrjedhojë, është më mirë të shmanget në parim. Për shembull, Cassandra kërkon që kërkesat të jenë të kufizuara në operatorë të caktuar (të lejuar vetëm =, IN, , =>, <=) në çelësat e pjesëve, përveç rasteve të kërkesës së indeksit të dytë (këtu është lejuar vetëm operatori =).
PostgreSQL
Më poshtë do të jepen tre shembuj kërkesash, të cilat mund të realizohen lehtësisht nga një bazë të dhënash SQL.
- Shfaq të gjitha këngët e artistit;
- Shfaq të gjitha këngët e artistit që përputhen me pjesën e parë të titullit;
- Shfaq të gjitha këngët e artistit që kanë një fjalë të caktuar në titull dhe kanë çmim më pak se 1.00.
SELECT * FROM Music
WHERE Artist='No One You Know';
SELECT * FROM Music
WHERE Artist='No One You Know' AND SongTitle LIKE 'Call%';
SELECT * FROM Music
WHERE Artist='No One You Know' AND SongTitle LIKE '%Today%'
AND Price > 1.00;
Cassandra
Nga kërkesat e mësipërme, vetëm e para do të funksionojë në Cassandra pa ndonjë ndryshim, pasi operatori LIKE nuk mund të aplikohet në kolonat e klasterizimit, siç janë SongTitle. Në këtë rast janë të lejuar vetëm operatorët = dhe IN.
SELECT * FROM Music
WHERE Artist='No One You Know';
SELECT * FROM Music
WHERE Artist='No One You Know' AND SongTitle IN ('Call Me Today', 'My Dog Spot')
AND Price > 1.00;
MongoDB
Siç tregohet në shembujt e mëparshëm, metoda kryesore e krijimit të kërkesave në MongoDB është . Kjo metodë përmban qartë emrin e koleksionit (music në shembullin më poshtë), prandaj kërkesa për disa koleksione është e ndaluar.
db.music.find( {
  artist: "No One You Know"
 }
);
db.music.find( {
  artist: "No One You Know",
  songTitle: /Call/
 }
);
Leximi i të gjitha rreshtave nga tabela
Leximi i të gjithë rreshtave është thjesht një rast i veçantë i asaj shkabllon kërkese që kemi shqyrtuar më parë.
PostgreSQL
SELECT *
FROM Music;
Cassandra
Po ashtu si në shembullin përkatës në PostgreSQL më sipër.
MongoDB
db.music.find( {} );Modifikimi i të dhënave në tabelë
PostgreSQL
PostgreSQL ofron urdhrin UPDATE për ndërrimin e të dhënave. Ai nuk ka mundësi UPSERT, prandaj realizimi i këtij urdhri do të përfundojë me një gabim, nëse rreshtat nuk ekzistojnë më në bazën e të dhënave.
UPDATE Music
SET Genre = 'Disco'
WHERE Artist = 'The Acme Band' AND SongTitle = 'Still In Love';
Cassandra
Në Cassandra ka UPDATE një strukturë të ngjashme me PostgreSQL. UPDATE ka të njëjtën semantikë UPSERT, ashtu si SHTO.
Po ashtu si në shembullin përkatës në PostgreSQL më sipër.
MongoDB
Operación Në MongoDB, mund të përditësoni plotësisht një dokument ekzistues ose të përditësoni vetëm disa fusha të caktuara. Me shfletimin si parazgjedhje, ajo përditëson vetëm një dokument pa semantikën e aktivizuar. UPSERT. Përditësimi i disa dokumenteve dhe sjellja është e ngjashme. UPSERT Mund të aplikohet duke vendosur flamuj të tjerë për operacionin. Siç shihni në shembullin më poshtë, ndodh përditësimi i zhanrit të një artisti të caktuar sipas këngës së tij.
db.music.update(
  {"artist": "The Acme Band"},
  {
    $set: {
      "genre": "Disco"
    }
  },
  {"multi": true, "upsert": true}
);
Fshirja e të dhënave nga tabela
PostgreSQL
DELETE FROM Music
WHERE Artist = 'The Acme Band' AND SongTitle = 'Look Out, World';
Cassandra
Po ashtu si në shembullin përkatës në PostgreSQL më sipër.
MongoDB
Në MongoDB, ka dy lloje operacionesh për fshirjen e dokumenteve — dhe . Të dy llojet fshijnë dokumente, por kthejnë rezultate të ndryshme.
db.music.deleteMany( {
        artist: "The Acme Band"
    }
);
Fshirja e tabelës
PostgreSQL
DROP TABLE Music;Cassandra
Po ashtu si në shembullin përkatës në PostgreSQL më sipër.
MongoDB
db.music.drop();Përfundim
Debatet mbi zgjedhjen midis SQL dhe NoSQL kanë ardhur duke u zhvilluar për më shumë se 10 vjet. Ka dy aspekte kryesore të këtij debati: arkitektura bërthamore e bazës së të dhënave (SQL monolitik, transaksionar përballë NoSQL të shpërndarë, jo-transaksionar) dhe qasja ndaj projektimit të të dhënave (modelimi i të dhënave në SQL përballë modelimit të pyetjeve tuaja në NoSQL).
Me një bazë të dhënash të distribuar transaksionale, si YugaByte DB, debatet në lidhje me arkitekturën e bazës së të dhënave mund të shpërndahen lehtësisht. Ndërsa volumet e të dhënave bëhen më të mëdha se ato që mund të shkruhen në një nyje, një arkitekturë plotësisht e shpërndarë që mbështet shkallëzimin linear të shkrimit me shpërndarje automatike/rialokim bëhet e domosdoshme.
Përveç asaj që është thënë në një nga artikujt , arkitekturat transaksionale, të rrepta tani aplikohen më gjerësisht për të siguruar fleksibilitet më të mirë në zhvillim sesa arkitekturat jo-transaksionale, në fund të ditës të rënda.
Duke u kthyer në diskutimin mbi projektimin e bazave të dhënash, është e drejtë të thuhet se të dyja qasjet e projektimit (SQL dhe NoSQL) janë të nevojshme për çdo aplikacion të komplikuar në botën reale. Qasja SQL "modelimi i të dhënave" lejon zhvilluesit të përmbushin më lehtë kërkesat e ndryshueshme të biznesit, ndërsa qasja NoSQL "modelimi i kërkesave" u lejon të njëjtëve zhvillues të operojnë me sasi të mëdha të dhënash me vonesë të vogël dhe kapacitet të lartë kalimtar. Pikërisht për këtë arsye YugaByte DB ofron API SQL dhe NoSQL në një bërthamë të përbashkët, në vend që të promovonte një nga qasjet. Për më tepër, duke siguruar përputhshmëri me gjuhët e njohura të bazave të dhënash, përfshirë PostgreSQL dhe Cassandra, YugaByte DB garanton që zhvilluesit nuk do të duhet të mësojnë një gjuhë tjetër për të punuar me bërthamën e shpërndarë dhe të kësaj lloj konsistence.
Në këtë artikull, ne hulumtuam se si bazat e projektimit të bazave të dhënash ndryshojnë në PostgreSQL, Cassandra dhe MongoDB. Në artikujt e ardhshëm, ne do të thellojmë konceptet e avancuara të projektimit, si indeksat, transaksionet, bashkimet, direktivave TTL dhe dokumentet JSON.
Ju urojmë një fundjavë të mrekullueshme dhe ju ftojmë në , i cili do të zhvillohet më 14 maj.
Burimi: habr.com
