

Përshëndetje, Habr! Sot do të ndërtojmë një sistem që do të përpunojë rrjedhat e mesazheve Apache Kafka me ndihmën e Spark Streaming dhe do të regjistrojë rezultatet e përpunimit në databazën në re AWS RDS.
Të imagjinojmë se një organizatë krediti na jep detyrën e përpunimit të transaksioneve hyrëse "në kohë reale" për të gjitha degët e saj. Kjo mund të bëhet me qëllim të llogaritjes së menjëhershme të pozitat e monedhës të hapura për thesarin, kufijtë ose rezultatet financiare nga transaksionet, etj.
Si ta realizojmë këtë rast pa përdorur magji dhe formula të çuditshme — lexoni më poshtë! Le të fillojmë!
Hyrje
Pa dyshim, përpunimi i një sërë të madhe të dhënash në kohë reale ofron mundësi të gjera për t’u përdorur në sistemet moderne. Një nga kombinimet më të njohura për këtë është tandemi Apache Kafka dhe Spark Streaming, ku Kafka krijon një lum fluksi mesazhesh të ardhura, ndërsa Spark Streaming i përpunon këto paketa përmes një intervali të caktuar të kohës.
Për të rritur qëndrueshmërinë e aplikacionit, do të përdorim pikë kontrolli — checkpoints. Me ndihmën e këtij mekanizmi, kur moduli Spark Streaming ka nevojë të rikuperojë të dhënat e humbura, i nevojitet vetëm të kthehet te pika e fundit e kontrollit dhe të vazhdojë llogaritjet nga ajo.
Arkitektura e sistemit në zhvillim
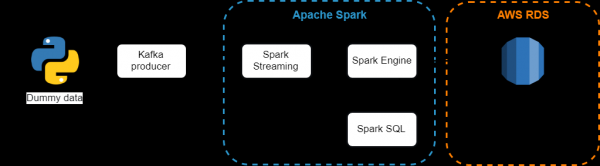
Komponentët e përdorur:
- — është një sistem i shpërndarë i dërgimit të mesazheve me publikim dhe abonim. Përshtatet si për konsum autonom ashtu edhe për konsum online të mesazheve. Për të parandaluar humbjen e të dhënave, mesazhet e Kafka ruhen në disk dhe replikohen brenda klasterit. Sistemi Kafka është ndërtuar mbi shërbimin e sinkronicitetit ZooKeeper;
- — komponenti Spark për përpunimin e të dhënave në kohë reale. Moduli Spark Streaming është ndërtuar me përdorimin e arkitekturës "mikropaketash" (micro-batch architecture), kur rrjedha e të dhënave interpretohet si një vazhdimësi e pandërprerë e paketimeve të vogla të dhënash. Spark Streaming merr të dhëna nga burime të ndryshme dhe i bashkon ato në paketa të vogla. Paketat e reja krijohen përmes intervaleve të rregullta të kohës. Në fillim të çdo intervali kohor krijohet një paketë e re, dhe çdo të dhënë e pranuar gjatë këtij intervali përfshihet në paketë. Në fund të intervalit, rritja e paketës ndalet. Madhësia e intervalit përcaktohet nga një parametër i quajtur intervali i paketimit (batch interval);
- — bashkon përpunimin relacional me programimin funksional në Spark. Të dhënat e strukturuara referojnë në të dhëna që kanë një skemë, domethënë një grup të vetëm fushash për të gjitha regjistrimet. Spark SQL mbështet hyrjen nga shumë burime të të dhënave të strukturuara, dhe falë informacionit mbi skemën, ai mund të nxjerrë në mënyrë efikase vetëm fushat e nevojshme të regjistrimeve, si dhe siguron interface API të DataFrame;
- — është një bazë të dhënash relacionalë cloud relativisht e lirë, një shërbim në internet që thjeshtëson konfigurimin, operimin dhe shkallëzimin, i menaxhuar drejtpërdrejt nga Amazon.
Instalimi dhe nisja e serverit Kafka
Para përdorimit të drejtpërdrejtë të Kafka, është e nevojshme të sigurohemi për praninë e Java, pasi është e nevojshme JVM:
sudo apt-get update
sudo apt-get install default-jre
java -version
Të krijojmë një përdorues të ri për punën me Kafka:
sudo useradd kafka -m
sudo passwd kafka
sudo adduser kafka sudo
Më pas shkarkojmë distributorin nga faqja zyrtare e Apache Kafka:
wget -P /YOUR_PATH "http://apache-mirror.rbc.ru/pub/apache/kafka/2.2.0/kafka_2.12-2.2.0.tgz"Zbërthejmë arkivën e shkarkuar:
tar -xvzf /YOUR_PATH/kafka_2.12-2.2.0.tgz
ln -s /YOUR_PATH/kafka_2.12-2.2.0 kafka
Hapi i ardhshëm është opsional. Kjo është për shkak se konfigurimet e parazgjedhura nuk lejojnë shfrytëzimin e plotë të të gjitha mundësive të Apache Kafka. Për shembull, fshirjen e një teme, kategorie, grupi, në të cilat mund të publikohen mesazhe. Për ta ndryshuar këtë, redaktoni skedarin e konfigurimit:
vim ~/kafka/config/server.propertiesShtoni në fund të skedarit sa vijon:
delete.topic.enable = truePara të nisni serverin Kafka, duhet të filloni serverin ZooKeeper, do të përdorim një skenar ndihmës që vjen me distribucionin e Kafka:
Cd ~/kafka
bin/zookeeper-server-start.sh config/zookeeper.properties
Pasi ZooKeeper të ketë filluar me sukses, në një terminal tjetër nisim serverin Kafka:
bin/kafka-server-start.sh config/server.propertiesDo të krijojmë një topic të ri me emrin Transaction:
bin/kafka-topics.sh --create --zookeeper localhost:2181 --replication-factor 1 --partitions 3 --topic transactionDo të sigurohemi që topic-i me numrin e duhur të pjesëve dhe replikimit të jetë krijuar:
bin/kafka-topics.sh --describe --zookeeper localhost:2181 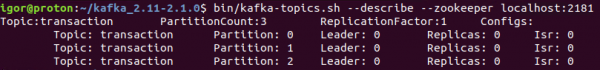
Do ta kalojmë momentin e testimit të produesit dhe konsumatorit për topic-in e sapokrijuar. Më shumë informacion mbi si të testoni dërgimin dhe pranimin e mesazheve mund të gjeni në dokumentacionin zyrtar — . Në të vërtetë, ne kalojmë te shkruarja e produesit në Python duke përdorur API-në KafkaProducer.
Shkrimi i produesit
Produesit do të gjenerojë të dhëna të rastit — 100 mesazhe çdo sekondë. Të dhënat e rastit do të nënkuptojnë një fjalor të përbërë nga tre fusha:
- Degë — emri i pikës së shitjes së organizatës kreditore;
- Currency — valuta e transaksionit;
- Amount — shuma e transaksionit. Shuma do të jetë një numër pozitiv nëse është një blerje valute nga Banka, dhe negativ nëse është shitje.
Kodi për produesin duket si më poshtë:
from numpy.random import choice, randint

def get_random_value():
    new_dict = {}

    branch_list = ['Kazan', 'SPB', 'Novosibirsk', 'Surgut']
    currency_list = ['RUB', 'USD', 'EUR', 'GBP']

    new_dict['branch'] = choice(branch_list)
    new_dict['currency'] = choice(currency_list)
    new_dict['amount'] = randint(-100, 100)

    return new_dict
Më pas, duke përdorur metodën send, dërgojmë mesazhin në server, në topic-in e nevojshëm, në formatin JSON:
from kafka import KafkaProducer

producer = KafkaProducer(bootstrap_servers=['localhost:9092'],
                             value_serializer=lambda x:dumps(x).encode('utf-8'),
                             compression_type='gzip')
my_topic = 'transaction'
data = get_random_value()

try:
    future = producer.send(topic = my_topic, value = data)
    record_metadata = future.get(timeout=10)

    print('--> Mesazhi është dërguar në një topic:
            {}, pjesa: {}, offset: {}'
            .format(record_metadata.topic,
                record_metadata.partition,
                record_metadata.offset ))

except Exception as e:
    print('--> Duket se ndodhi një gabim: {}'.format(e))

finally:
    producer.flush()
Kur ekzekutojmë skriptin, marrim në terminal këto mesazhe:
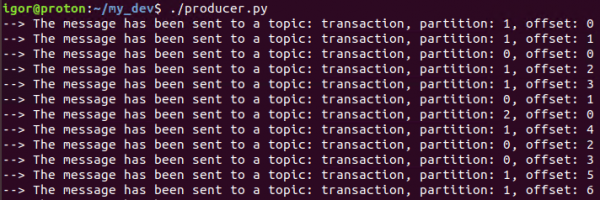
Kjo do të thotë që gjithçka funksionon siç doja — produesit gjeneron dhe dërgon mesazhe në topic-in e dëshiruar.
Hapi tjetër do të jetë instalimi i Spark dhe përpunimi i këtij fluksi mesazhesh.
Instalimi i Apache Spark
Apache Spark është një platformë universale dhe me performancë të lartë për llogaritjet në klaster.
Në performancë, Spark e kalon implementimet më të njohura të modelit MapReduce, duke ofruar gjithashtu mbështetje për një gamë më të gjerë llojesh llogaritjesh, duke përfshirë kërkesa interaktive dhe përpunim në kohë reale. Shpejtësia luan një rol të rëndësishëm në përpunimin e volumit të madh të të dhënave, pasi shpejtësia lejon të punosh në mënyrë interaktive, pa pritur minuta ose orë. Një nga përfitimet kryesore të Spark që garanton këtë shpejtësi të lartë është capabiliteti për të kryer llogaritjet në memorie.
Ky kornizë është shkruar në Scala, kështu që duhet të instalojmë atë së pari:
sudo apt-get install scalaShkarko nga faqja zyrtare shpërndarjen e Spark:
wget "http://mirror.linux-ia64.org/apache/spark/spark-2.4.2/spark-2.4.2-bin-hadoop2.7.tgz"Shkrijmë arkivin:
sudo tar xvf spark-2.4.2/spark-2.4.2-bin-hadoop2.7.tgz -C /usr/local/sparkShtojmë rrugën për në Spark në skedarin bash:
vim ~/ .bashrcShtojmë përmes editorit këto rreshta:
SPARK_HOME=/usr/local/spark
export PATH=$SPARK_HOME/bin:$PATH
Ekzekutojmë komandën më poshtë pas editimit të bashrc:
source ~/ .bashrcZhvillimi i AWS PostgreSQL
Kemi mbetur për të zhvilluar bazën e të dhënave, ku do të ngarkojmë informacionin e përpunuar nga rrjedhat. Për këtë, do të përdorim shërbimin AWS RDS.
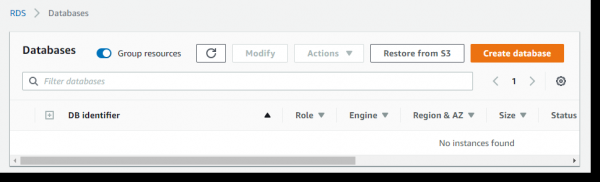
Hyr në konsolën AWS -> AWS RDS -> Databases -> Krijo bazën e të dhënave:
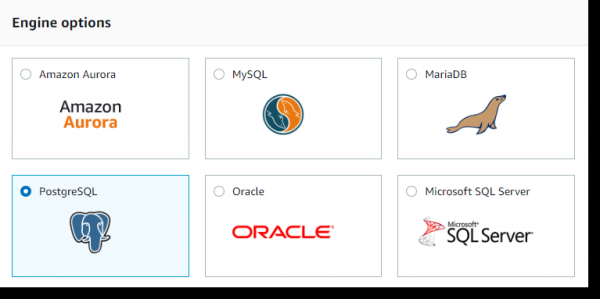
Zgjidh PostgreSQL dhe klikoni butonin Next:
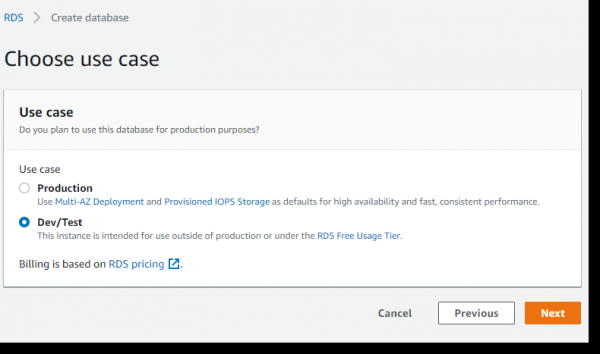
Duke marrë parasysh se ky shembull shqyrtohet ekskluzivisht për qëllime edukative, do të përdorim një server falas "në minimalet" (Free Tier):
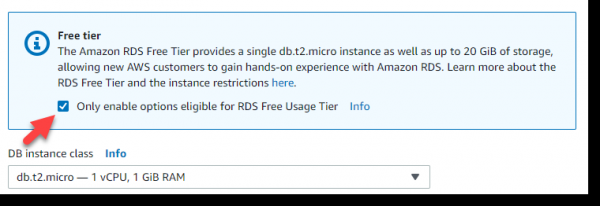
Më pas, vendosim një cek në bllokun Free Tier, dhe pas kësaj automatikisht do të na ofrohet një instancë e klasës t2.micro — edhe pse e dobët, është falas dhe përfundimisht do të përshtatet për nevojën tonë:
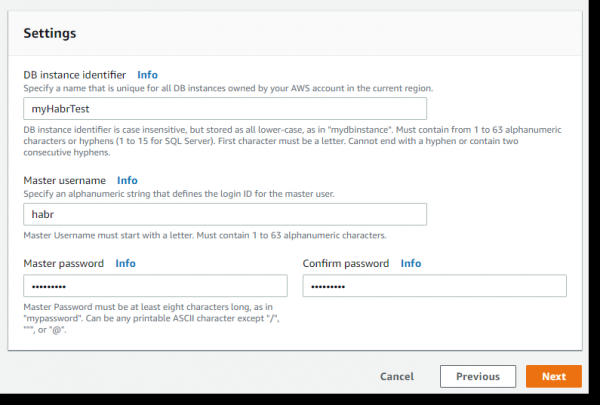
Pasojnë disa gjëra shumë të rëndësishme: emri i instancës së DB, emri i përdoruesit kryesor dhe fjalëkalimi i tij. Do ta quajmë instancën: myHabrTest, përdoruesit kryesor: habr, fjalëkalimi: habr12345 dhe klikojmë butonin Next:
Në faqen tjetër ndodhen parametrat që përgjigjen për aksesin e serverit tonë DB nga jashtë (Public accessibility) dhe aksesin e porteve:
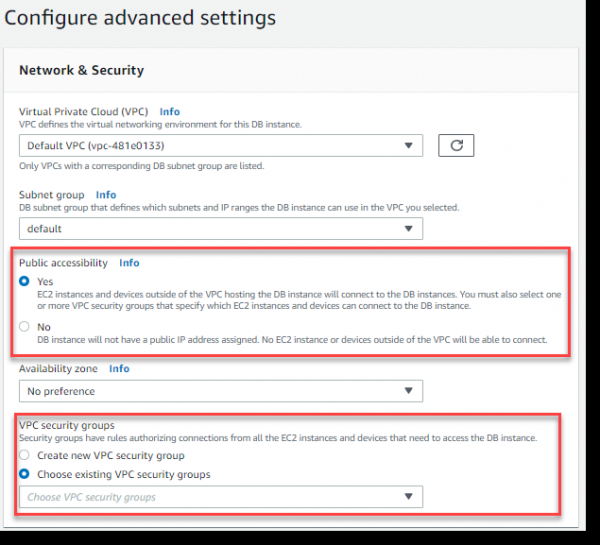
Le të krijojmë një konfigurim të ri për grupin e sigurisë VPC, që do të lejojë qasjen nga jashtë në serverin tonë DB përmes portit 5432 (PostgreSQL).
Të kalojmë në një dritare të veçantë të shfletuesit në konsolën AWS në seksionin VPC Dashboard -> Security Groups -> Krijo grupin e sigurisë:
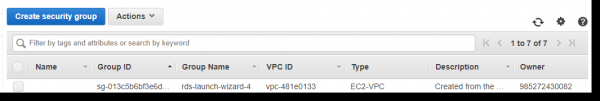
Caktojmë emrin për grupin e sigurisë - PostgreSQL, përshkrimin, tregojmë se në cilën VPC duhet të asociohet ky grup dhe klikojmë butonin Create:

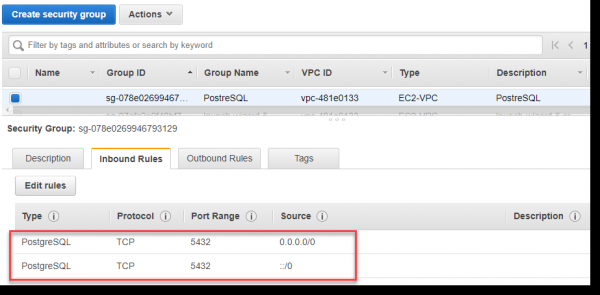
Plotsojmë për grupin e sapokrijuar rregullat hyrëse për portin 5432, siç tregohet në imazhin më poshtë. Portin mund ta lëmë bosh dhe të zgjedhim PostgreSQL nga lista e rënëse Type.
Rreptësisht, vlera ::/0 nënkupton disponueshmërinë e trafikut hyrës për serverin nga e gjithë bota, që nuk është krejtësisht e saktë, por për qëllim ilustrimi do të lejojmë një qasje të tillë:
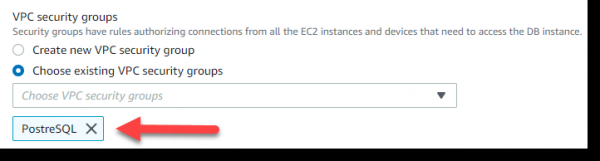
Kthehemi në faqen e shfletuesit, ku kemi hapur «Configure advanced settings» dhe zgjedhim në seksionin VPC security groups -> Choose existing VPC security groups -> PostgreSQL:
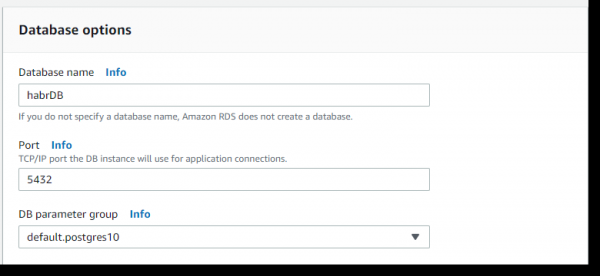
Më pas, në seksionin Database options -> Database name -> caktojmë emrin - habrDB.
Parametrat e tjerë, përveç ndoshta çaktivizimit të kopjes rezervë (backup retention period - 0 days), monitorimit dhe Performance Insights, mund t'i lëmë në parametrat e paracaktuar. Klikojmë butonin Create database:
Menaxheri i flukseve
Hapi përfundimtar do të jetë zhvillimi i një Spark-job, i cili çdo dy sekonda do të procesojë të dhëna të reja që vijnë nga Kafka dhe do të ruajë rezultatin në bazën e të dhënave.
Siç u përmend më parë, pikëmbështetjet (checkpoints) janë mekanizmi kryesor në SparkStreaming, i cili duhet të konfigurohet për të siguruar qëndrueshmëri. Ne do të përdorim pikëmbështetjet dhe, nëse ndodh një rënie e procedurës, moduli Spark Streaming për rikuperimin e të dhënave të humbura do të duhet vetëm të kthehet në pikën e fundit të mbështetjes dhe të rinisë llogaritjet prej saj.
Pika e mbështetjes mund të aktivizohet duke vendosur katalogun në një sistem skedarësh të qëndrueshëm dhe të besueshëm (p.sh., HDFS, S3 etj.), në të cilin do të ruhet informacioni i pikëmbështetjes. Kjo bëhet, për shembull:
streamingContext.checkpoint(checkpointDirectory)Në shembullin tonë do të përdorim qasjen e mëposhtme, dmth, nëse checkpointDirectory ekziston, konteksti do të rishpallet nga të dhënat e pikëmbështetjes. Nëse katalogu nuk ekziston (dmth po ekzekutohet për herë të parë), atëherë thirret funksioni functionToCreateContext për krijimin e një konteksti të ri dhe për konfigurimin e DStreams:
from pyspark.streaming import StreamingContext

context = StreamingContext.getOrCreate(checkpointDirectory, functionToCreateContext)
Krijojmë një objekt DirectStream me qëllim lidhjen me temën «transaction» nëpërmjet metodës createDirectStream të bibliotekës KafkaUtils:
nga pyspark.streaming.kafka import KafkaUtils

sc = SparkContext(conf=conf)
ssc = StreamingContext(sc, 2)

broker_list = 'localhost:9092'
topic = 'transaction'

directKafkaStream = KafkaUtils.createDirectStream(ssc,
                                [topic],
                                {"metadata.broker.list": broker_list})
Po kemi të dhënat hyrëse në formatin JSON:
rowRdd = rdd.map(lambda w: Row(branch=w['branch'],
                                       currency=w['currency'],
                                       amount=w['amount']))

testDataFrame = spark.createDataFrame(rowRdd)
testDataFrame.createOrReplaceTempView("treasury_stream")
Duke përdorur Spark SQL, bëjmë një grupim të thjeshtë dhe e nxjerrim rezultatin në konsolë:
select
    from_unixtime(unix_timestamp()) as curr_time,
    t.branch                        as branch_name,
    t.currency                      as currency_code,
    sum(amount)                     as batch_value
from treasury_stream t
group by
    t.branch,
    t.currency
Marrja e tekstit të kërkesës dhe ekzekutimi i saj përmes Spark SQL:
sql_query = get_sql_query()
testResultDataFrame = spark.sql(sql_query)
testResultDataFrame.show(n=5)
Dhe pastaj ruajmë të dhënat e agreguara në një tabelë në AWS RDS. Për të ruajtur rezultatet e agregatës në tabelën e bazës së të dhënave, do të përdorim metodën write të objektit DataFrame:
testResultDataFrame.write
    .format("jdbc")
    .mode("append")
    .option("driver", 'org.postgresql.Driver')
    .option("url","jdbc:postgresql://myhabrtest.ciny8bykwxeg.us-east-1.rds.amazonaws.com:5432/habrDB")
    .option("dbtable", "transaction_flow")
    .option("user", "habr")
    .option("password", "habr12345")
    .save()
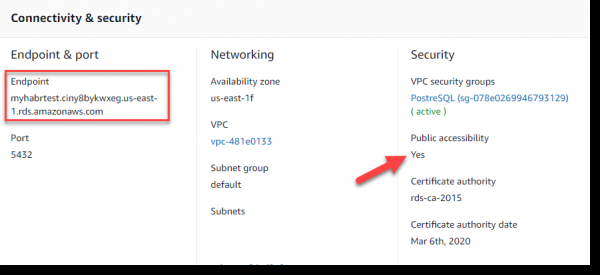
Disa fjalë për konfigurimin e lidhjes me AWS RDS. Përdoruesin dhe fjalëkalimin e tij i kemi krijuar në hapin "Zhvillimi i AWS PostgreSQL". Si url për serverin e bazës së të dhënave duhet të përdorim Endpoint, i cili shfaqet në seksionin Connectivity & security:
Për një lidhje të saktë mes Spark dhe Kafka, duhet të ekzekutojmë punën përmes spark-submit duke përdorur artefaktin spark-streaming-kafka-0-8_2.11. Për më tepër, do të përdorim gjithashtu artefaktin për ndërveprimin me bazën e të dhënave PostgreSQL, të cilat do t'i kalojmë përmes —packages.
Për fleksibilitetin e skriptit, do të nxjerrim si parametra hyrës gjithashtu emrin e serverit të mesazheve dhe temën nga e cila dëshirojmë të marrim të dhëna.
Kështu, erdhi koha të nisemi dhe të verifikojmë funksionimin e sistemit:
spark-submit
--packages org.apache.spark:spark-streaming-kafka-0-8_2.11:2.0.2,
org.postgresql:postgresql:9.4.1207
spark_job.py localhost:9092 transaction
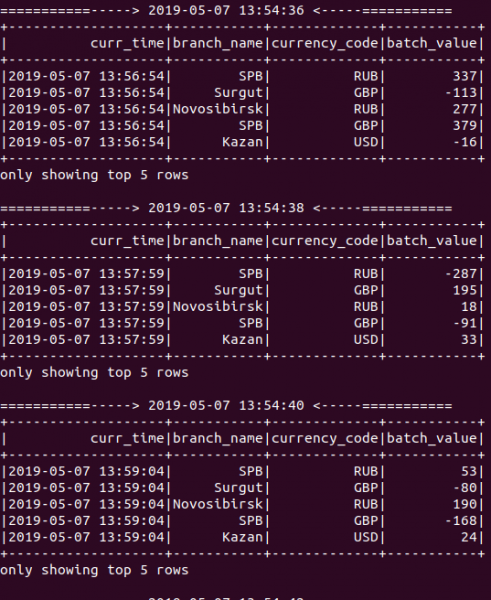
E gjithë ka shkuar mirë! Siç shihet në imazhin më poshtë — gjatë procesit të punës së aplikacionit rezultatet e reja të agregimit shfaqen çdo 2 sekonda, sepse vendosëm intervalin e paketimit të barabartë me 2 sekonda kur krijuam objektin StreamingContext:
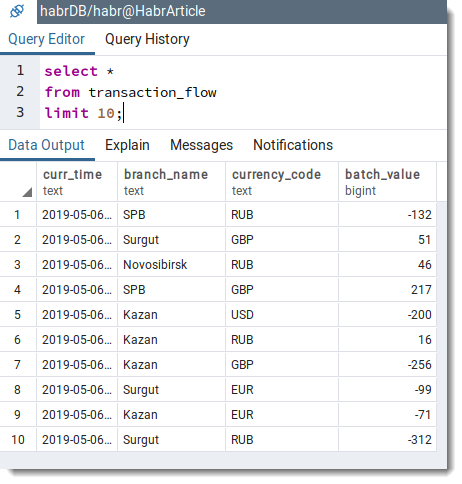
Më pas, bëjmë një kërkesë të thjeshtë në bazën e të dhënave për të kontrolluar praninë e regjistrimeve në tabelën transaction_flow:
Përfundim
Në këtë artikull u shqyrtua një shembull i përpunimit të informacionit në rrjedhë me përdorimin e Spark Streaming në lidhje me Apache Kafka dhe PostgreSQL. Me rritjen e volumit të të dhënave nga burime të ndryshme, vlera praktike e Spark Streaming për krijimin e aplikacioneve në rrjedhë dhe aplikacioneve që veprojnë në kohë reale është e vështirë të nënvizohet.
Kodi burimor i plotë mund ta gjeni në depot time në .
Me kënaqësi jam i gatshëm të diskutoj për këtë artikull, pres komentet tuaja, si dhe shpresoj për kritikë konstruktive nga të gjithë lexuesit e përkushtuar.
Ju uroj suksese!
Ps. Fillimisht ishte planifikuar të përdorej një DB lokale PostgreSQL, por duke marrë parasysh dashurinë time për AWS, vendosa ta çoj bazën e të dhënave në cloud. Në artikullin e ardhshëm në këtë temë do të tregoj si ta zbatoj sistemin e përshkruar më sipër në AWS duke përdorur AWS Kinesis dhe AWS EMR. Qëndroni të lidhur për lajme!
Burimi: habr.com
