

Përshëndetje të gjithëve! Unë quhem Pavel Agalecki. Punoj si lider i ekipit që zhvillon sistemin e shpërndarjes për Lamoda. Në vitin 2018, kam folur në konferencën HighLoad++, dhe sot dëshiroj të paraqes transkriptingun e fjalës sime.
Tema ime është e përkushtuar për përvojën e kompanisë sonë në shpërndarjen e sistemeve dhe shërbimeve në mjedise të ndryshme. Duke filluar nga kohët tona prehistorike, kur ne shpërndanim të gjitha sistemet në servera virtualë të zakonshëm, deri në kalimin gradual nga Nomad në shpërndarjen në Kubernetes. Do të flas për arsyet pse e bëmë këtë dhe cilat ishin problemet tona në proces.

Shpërndarja e aplikacioneve në VM
Le të fillojmë duke thënë se 3 vjet më parë, të gjitha sistemet dhe shërbimet e kompanisë shpërndaheshin në servera virtualë të zakonshëm. Teknikisht, ishte organizuar në mënyrë që të gjithë kodi i sistemeve tona të ishte i vendosur dhe të mblidhte përmes mjeteve të ndihmës së automatizuar, duke përdorur Jenkins. Me ndihmën e Ansible, ai u shpërndante nga sistemi ynë i kontrollit të versioneve në serverat virtualë. Në këtë mënyrë, çdo sistem që kishte kompania jonë, shpërndahej në të paktën 2 servera: njëri prej tyre ishte head, tjetri ishte tail. Këto dy sisteme ishin të identike në të gjitha cilësitë e tyre, fuqinë, konfigurimin dhe të tjera. Diferenca midis tyre ishte vetëm se head merrte trafikun e përdoruesve, ndërsa tail kurrë nuk merrte trafik nga përdoruesit.
Pse ishte bërë kjo?
Kur ne shpërndanim versione të reja të aplikacionit tonë, dëshironim të siguronim mundësinë e shpërndarjes pa shqetësime, pra pa pasoja të dukshme për përdoruesit. Kjo arrihej përmes përdorimit të Ansible për të shpërndarë versionin e mbledhur në tail. Atje, njerëzit që ishin angazhuar me shpërndarjen mund të kontrolonin dhe të siguroheshin se gjithçka ishte mirë: të gjitha metrikat, ndarjet dhe aplikacionet funksiononin; përdoreshin skenarët e nevojshëm. Vetëm pasi ata ishin të sigurt se gjithçka ishte në rregull, trafiku do të kalonte. Ai fillonte të shkonte në atë server që deri atëherë ishte tail. Ndërsa ai që kishte qenë head, mbetej pa trafik nga përdoruesit, përkundrazi me versionin e mëparshëm të aplikacionit tonë.
Në këtë mënyrë, për përdoruesit, gjithçka ishte pa ndërprerje. Sepse kalimi është në një moment, pasi është thjesht një ndërrim balancuesi. Shumë lehtë mund të ktheheni në versionin e mëparshëm, thjesht duke ndërruar balancuesin prapa. Gjithashtu, ne mundëm të sigurojmë kapacitetin e aplikacionit në prodhim edhe para se të fillonte trafik përdoruesish, që ishte mjaft e përshtatshme.
Çfarë përfitimesh pamë në gjithë këtë?
- Së pari, kjo është mjaft thjesht funksionon. Të gjithëve iu duket e qartë si funksionon një skemë e tillë e publikuar, sepse shumica e njerëzve ndonjëherë e kanë publikuar në serverë virtualë të zakonshëm.
- Kjo është mjaft e sigurt, pasi teknologjia e publikimit është e thjeshtë dhe e provuar nga mijëra kompani. Miliona serverë publikohen në këtë mënyrë. Është e vështirë të thyesh diçka.
- Dhe përfundimisht, ne mundëm të marrim publikime atomike. Publikimet, të cilat për përdoruesit ndodhin në një moment, pa ndonjë fazë të dukshme kalimi midis versionit të vjetër dhe atij të ri.
Por në këtë të gjithë, ne gjithashtu pamë disa disavantazhe:
- Përveç mjedisit të prodhimit, mjedisi i zhvillimit, ka edhe mjedise të tjera. Për shembull, qa dhe parprodhuese. Në atë kohë, ne kishim shumë servera dhe rreth 60 shërbime. Për këtë arsye, duhej të mbajmë një version të përditësuar për secilin shërbim të makinerisë virtuale. Dhe nëse dëshironi të përditësoni bibliotekat ose të instaloni varësi të reja, duhet ta bëni këtë në të gjitha mjediset. Gjithashtu, duhej të synchronizoni kohën kur do të bëni publikimin e versionit të ri të aplikacionit tuaj, me kohën kur devops do të realizojë konfiguratat e nevojshme të mjedisit. Në këtë rast, është e lehtë të përfundoni në një situatë kur mjedisi ynë do të ndryshojë në disa mjedise njëra pas tjetrës. Për shembull, në mjedisin QA do të ketë njëra versione bibliotekash, ndërsa në prodhim do të jetë një tjetër, që do të sillte probleme.
- Vështirësia në përditësimin e varësive të aplikacionit tuaj. Kjo nuk varet nga ju, por nga një ekip tjetër. Saktësisht, nga ekipi devops, i cili mban serverët. Ju duhet të vendosni detyrën për ta dhe t'u jepni përshkrimin e asaj që doni të bëni.
- Në atë kohë, ne gjithashtu doja të ndanim monolitët e mëdhenj që kishim në shërbime më të vogla, sepse e kuptonim se ata do të rriteshin dhe më shumë. Në atë moment, ne kishim më shumë se 100 prej tyre. Ishte e nevojshme të krijoheshin makina virtuale të reja për çdo shërbim të ri, të cilat gjithashtu duhej të mbaheshin dhe të deploiheshin. Përveç kësaj, ne duhej jo një, por të paktën dy makina. Dhe kësaj i shtohet edhe një mjedis QA. Kjo shkaktonte probleme dhe e bënte krijimin dhe fillimin e sistemeve të reja më të komplikuar, të shtrenjta dhe të ngadalta.
Prandaj, ne morëm vendimin se do të ishte më e lehtë të kalonim nga depolimi i makinave virtuale të zakonshme në depolimin e aplikacioneve tona në konteinerin docker. Me docker, ju nevojitet një sistem që mund të shkojë aplikacionin në një grumbull, sepse nuk mund ta ngarkoni një konteiner thjesht kështu. Normalisht, dëshirohet të monitoroni se sa konteinerë janë ngarkuar, për të siguruar që ata ngarkohen automatikisht. Për këtë arsye, na duhej të zgjidhnim një sistem menaxhimi.
Ne menduam gjatë se cilin prej tyre mund të merrnim. Problemi është se në atë moment, ky stendë depolimi në servera virtualë të zakonshëm ishte disi e vjetruar, sepse kishte versione të pakta të sistemeve operative. Në një moment, aty madje kishte edhe FreeBSD, që nuk ishte shumë e lehtë për t'u mbështetur. Ne kuptuam se të ishim sa më shpejt të migronim në docker. DevOps-ët tanë shqyrtuan përvojën e tyre me zgjidhje të ndryshme dhe zgjodhën një sistem të tillë si Nomad.
Kalimi në Nomad
Nomad është një produkt i kompanisë "HashiCorp". Ata janë gjithashtu të njohur për zgjidhje të tjera:
"Consul" është një mjet për zbulimin e shërbimeve.
"Terraform" është një sistem për menaxhimin e serverëve, që ju lejon t'i konfiguroni ato përmes një konfigurimi, e ashtuquajtur infrastructure-as-code.
"Vagrant" ju lejon të ngrini makina virtuale në lokal ose në cloud përmes skedarëve të caktuar të konfigurimit.
Nomad në atë kohë na u duk një zgjidhje e mjaftueshme e thjeshtë, në të cilën mund të kalonim shpejt pa ndryshuar gjithë infrastrukturën. Për më tepër, është relativisht i lehtë për t'u mësuar. Prandaj, pikërisht atë e zgjodhëm si sistemin tonë të filtrimit të konteinerëve.
Çfarë nevojitet për të depoluar sistemin tuaj në Nomad?
- Para së gjithash, nevojitet një imazh docker aplikacionit tuaj. Duhet ta grumbulloni atë dhe ta vendosni në magazinën e imazheve docker. Në rastin tonë, kjo është artifactory — një sistem që ju lejon të shtoni në të artefakte të ndryshme të llojeve të ndryshme. Ajo mund të ruajë arkiva, imazhe docker, paketa composer PHP, paketa NPM dhe kështu me radhë.
- Gjithashtu kërkohet skedës së konfigurimit, i cili do t'i thotë Nomad-it se çfarë, ku dhe në çfarë sasie dëshironi të derdhni.
Kur flasim për Nomad, si format informativ ai përdor gjuhën HCL, që shkurtimisht do të thotë HashiCorp Configuration Language. Kjo është një superset mbi Yaml, që ju lejon të përshkruani shërbimin tuaj në terma të Nomad.
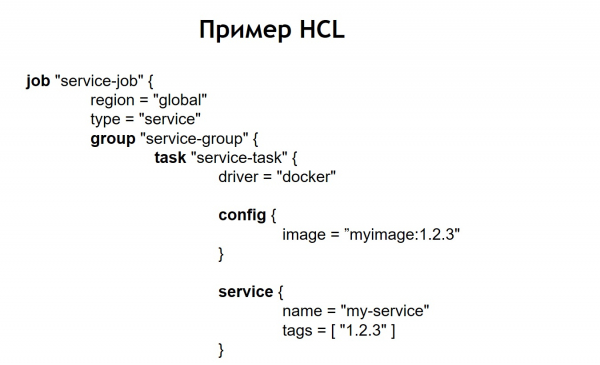
Ai lejon të deklaroni sa kontejnerë dëshironi të derdhni, nga cilat imazhe t'u kaloni atyre parametra të ndryshëm gjatë derdhjes. Në këtë mënyrë, i ushqeni këtij skedari Nomad, dhe ai nis kontejnerët në përputhje me të.
Në rastin tonë, ne e kuptuam se thjesht të shkruajmë skedarë HCL identikë për çdo shërbim do të ishte jo shumë e përshtatshme, sepse ka shumë shërbime dhe ndonjëherë dëshirojme t'i përditësojmë ato. Ndonjëherë ndodh që një shërbim të jetë i derdhur në një vetë, por në shumë variante. Për shembull, një nga sistemet që kemi në prodhim, ka më shumë se 100 instanca në prodhim. Ato nisin nga të njëjtat imazhe, por dallojnë për konfigurimet dhe skedarët e konfigurimeve.
Prandaj, ne vendosëm se do të ishte e përshtatshme të ruajmë të gjithë skedarët tanë të konfigurimit për derdhje në një depo të përbashkët. Kështu, ato bëheshin të shikueshme: ishte e lehtë t'i mirëmbash dhe mund të shikoje se cilat sisteme kemi. Në rast nevoje, gjithashtu nuk është e komplikuar të përditësosh ose të ndryshosh diçka. Të shtosh një sistem të ri gjithashtu nuk do të jetë një problem — mjafton të krijosh një skedar konfigurimi brenda një direktoriumi të ri. Brenda saj ka skedarë: service.hcl, i cili përmban përshkrimin e shërbimit tonë, dhe disa skedarë env që lejojnë që ky shërbim, duke u derdhur në prodhim, të konfigurohet.
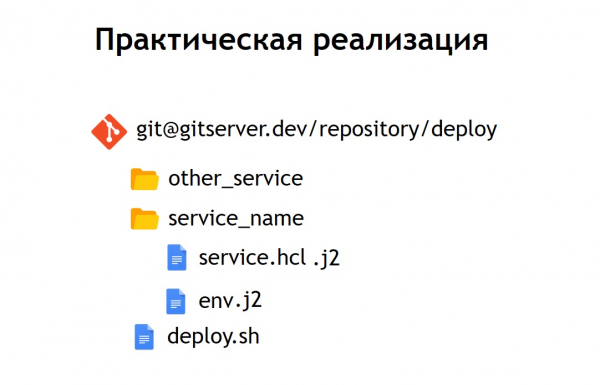
Megjithatë, disa nga sistemet tona janë të derdhura në prodhim jo në një vetë, por në disa në të njëjtën kohë. Prandaj, ne vendosëm se do të ishte më e përshtatshme të ruajmë jo konfiguracionet në formën e pastër, por formën e tyre të templatuar. Dhe si gjuhë templatuese ne zgjodhëm jinja 2. Në këtë format ruajmë si konfigurimet e shërbimit, ashtu edhe skedarët env që i duhet atij.
Përveç kësaj, ne vendosëm në repository një skenar-deploy të përbashkët për të gjithë projektet, i cili lejon të ndizni dhe implementoni shërbimin tuaj në prodhim, në mjedisin e duhur, në destinacionin e duhur. Në rast se kthejmë konfigurimin tonë HCL në një model, skedari HCL që më parë ishte një konfigurim i zakonshëm Nomad tani duket disi ndryshe.
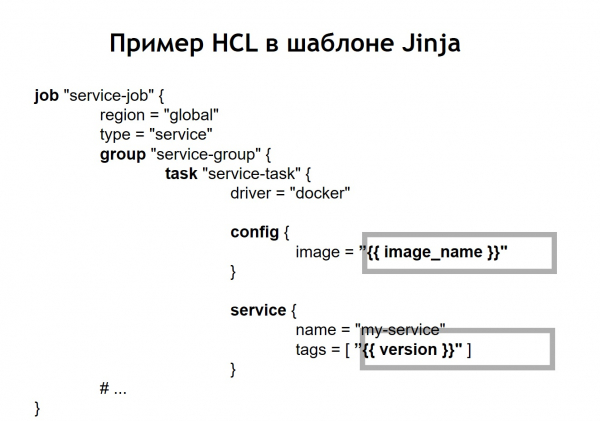
Kjo do të thotë se ne zëvendësuam disa variabla vendesh të konfigurimit me vendosje variablash që merren nga skedarët env ose burime të tjera. Përveç kësaj, ne fituam mundësinë për të ndërtuar skedarë HCL në mënyrë dinamike, pra mund të aplikojmë jo vetëm vendosje të zakonshme variablash. Duke qenë se jinja mbështet ciklet dhe kushtet, gjithashtu mund të bëjmë skedarë konfigurimi që ndryshojnë varësisht nga vendi ku e implantoni aplikacionin tuaj.
Për shembull, ju dëshironi të implantoni shërbimin tuaj në përpara-prodhuese dhe në prodhim. Le të themi se në përpara-prodhuese nuk dëshironi të ndizni skriptet cron, por vetëm dëshironi të shihni shërbimin në një domain të veçantë për të siguruar që po funksionon. Për çdo kush që implanton shërbimin, procesi duket shumë i thjeshtë dhe i qartë. Mjafton të ekzekutoni skedarin deploy.sh, të specifikoni se cilin shërbim dëshironi të implantoni dhe në cilin destinacion. Për shembull, dëshironi të implantoni një sistem në Rusi, në Bjellorusi apo në Kazakistan. Për këtë, mjafton të ndërroni një nga parametrat dhe do të krijohet skedari i saktë i konfigurimit.
Kur shërbimi Nomad tashmë është implantuar në klaster, ai duket kështu.
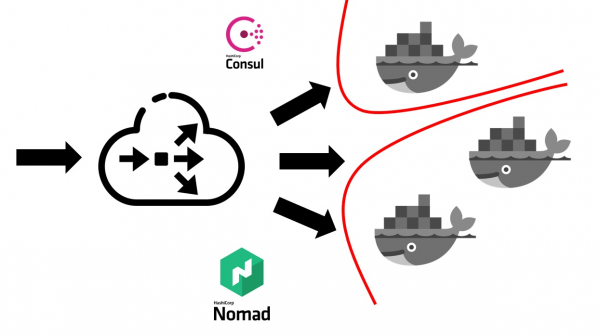
Në fillim, ju nevojitet një balancues i jashtëm që do të pranojë të gjithë trafik-in e përdoruesve. Ai do të funksionojë së bashku me Consul dhe do të mësojë nga ai, ku, në cilën nodë, për cilin adresë IP ndodhet shërbimi konkret që i përgjigjet emrit të caktuar të domainit. Shërbimet në Consul shfaqen nga Nomad vetë. Duke qenë se këto janë produkte të së njëjtës kompani, ato janë të lidhura mirë me njëra-tjetrën. Mund të thuhet se Nomad nga kutia regjistron të gjitha shërbimet e aktivizuara brenda tij në Consul.
Kur pasi balancuesi juaj i jashtëm mëson se në cilin shërbim duhet të drejtojë trafikun, ai e redirekton atë në të përkatësin kontejner ose në disa kontejnerë, të cilët i përgjigjen aplikacionit tuaj. Natyrisht, është e nevojshme të mendojmë edhe për sigurinë. Edhe pse të gjithë shërbimet ekzekutohen në të njëjtat makina virtuale në kontejnerë, zakonisht kërkohet të ndalohet qasja e lirë nga çdo shërbim në çdo shërbim tjetër. Këtë e arritëm përmes segmentimit. Çdo shërbim ishte në një rrjet të vetin virtual, në të cilin ishin shkruar rregullat e rrugëzimit dhe rregullat e lejes/ndalimit të qasjes në sisteme dhe shërbime të tjera. Ato mund të ishin brenda këtij klasteri ose jashtë tij. Për shembull, nëse dëshironi të ndaloni një shërbim që të lidhet me një bazë të dhënash të caktuar, kjo mund të bëhet përmes segmentimit në nivel rrjeti. Pra, ashtu siç thashë, edhe me një gabim nuk mund të lidheni rastësisht nga ambienti testues me bazën tuaj të të dhënave prodhuese.
Sa na kushtoi procesi i kalimit në aspektin e burimeve njerëzore?
Një periudhë prej rreth 5-6 muajsh zgjati kalimi i të gjithë kompanisë në Nomad. Ne kaluam shërbim pas shërbimi, por me një ritëm mjaft të shpejtë. Çdo skuadër duhej të krijonte kontejnerët e saj për shërbimet.
Ne kemi pranuar një qasje të tillë, që çdo skuadër është përgjegjëse për imazhet docker të sistemeve të saj në mënyrë të pavarur. DevOps ofron infrastrukturën e përgjithshme të nevojshme për deploy, pra mbështetje për vetë klasterin, mbështetje për sistemin CI etj. Dhe në atë kohë, mbi 60 sisteme ishin transferuar në Nomad, duke arritur rreth 2,000 kontejnerë.
DevOps është përgjegjës për infrastrukturën e përgjithshme të gjithçkaje që lidhet me deploy, me serverët. Ndërsa çdo skuadër zhvillimi, nga ana e saj, është përgjegjëse për implementimin e kontejnerëve për sistemin e saj konkret, pasi vetë skuadra e di se çfarë i nevojitet në atë ose atë kontejner.
Arsyet për refuzimin e Nomad
Cilat janë përfitimet që kemi marrë duke kaluar në deploy me Nomad dhe docker gjithashtu?
- Ne siguruam kushte të barabarta për të gjitha mjediset. Në zhvillim, mjedisin QA, në pra-prodhuese dhe prodhim përdoren të njëjtat image konteinerësh, me të njëjtat varësi. Prandaj, ju praktikisht nuk keni shansin që në prodhim të bëni ndonjë ndryshim nga ajo që keni testuar lokalisht apo në mjedisin e testimit.
- Gjithashtu, ne zbulua më se lehtë mund të shtoni një shërbim të ri. Çdo sistem i ri nga perspektiva e deploy-it aktivizohet shumë lehtë. Mjafton të shkoni në repository-n që mban konfigurat e, të shtoni aty konfigun për sistemin tuaj dhe gjithçka është gati. Ju mund të deploy-oni sistemin tuaj në prodhim pa përpjekje shtesë nga DevOps.
- Të gjitha skedarët konfiguruese në një repository të vetëm shfaqeshin të rishikueshme. Në momentin kur ne deploy-onim sistemet tona përmes serverave virtuale, ne përdorëm Ansible, ku konfigurat ndodheshin në të njëjtin repository. Megjithatë, për shumicën e zhvilluesve, punimi me këtë ishte pak më i ndërlikuar. Këtu volumi i konfigurat dhe kodit që duhet të shtoni për të deploy-uar shërbimin u bë ndjeshëm më i vogël. Plus, për DevOps është shumë e lehtë ta rregullojnë ose ta ndryshojnë atë. Në rast të kalimeve, për shembull, në versionin e ri të Nomad-it, ata mund të marrin dhe të përditësojnë masivisht të gjitha skedarët operativë që ndodhen në të njëjtin vend.
Por përballëm edhe me disa disavantazhe:
E para, ne nuk arritëm të arrinim pa ndonjë problem deploy-et në rastin e Nomad-it. Kur kontejnerët shpërndaheshin nga kushte të ndryshme, mund të ndodhte që ai të ishte aktivizuar dhe Nomad e perceptonte atë si një kontejner të gatshëm për të pranuar trafik. Kjo ndodhte edhe para se aplikacioni brenda tij të kishte mundësinë të aktivizohej. Për këtë arsye, sistemi për një periudhë të shkurtër fillonte të jepte gabime 500, sepse trafiku fillonte të shkonte në kontejnerin që ende nuk ishte i gatshëm ta priste atë.
Ne hasëm ndonjë defekte. Problemi më i rëndësishëm është se Nomad nuk e përballon shumë mirë një klaster të madh, nëse keni shumë sisteme dhe konteinerë. Kur dëshironi të nxirrni për mirëmbajtje një nga serverët që është pjesë e klasterit Nomad, ka një probabilitet të madh që klasteri të ketë probleme dhe të shpërbëhet. Disa nga konteinerët mund të bien dhe të mos ngrihen më — kjo do t'ju kushtojë shumë nëse të gjitha sistemet tuaja në prodhim janë në klasterin e menaxhuar nga Nomad.
Prandaj, ne vendosëm të mendojmë për hapat e ardhshëm. Në atë moment, ne filluam të kuptonim më mirë se çfarë dëshironim të arrinim. Konkretisht: donim besueshmëri, pak më shumë funksionalitete se ato që ofron Nomad, dhe një sistem më të pjekur, më stabil.
Në këtë aspekt, zgjedhja jonë ra mbi Kubernetes si platforma më popullore për të drejtuar klasterë. Sidomos duke pasur parasysh se madhësia dhe numri i konteinerëve tanë ishin mjaft të mëdha. Për këto qëllime, Kubernetes dukej si sistemi më i përshtatshëm nga ato që mund të shqyrtonim.
Kalimi në Kubernetes
Do të flas pak për konceptet kryesore të Kubernetes dhe se si ato dallojnë nga Nomad.
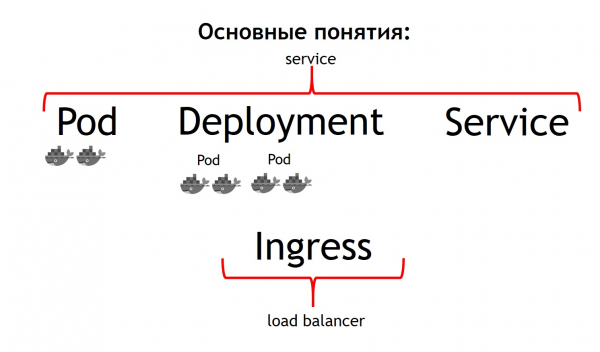
Së pari, koncepti më themelor në Kubernetes është koncepti i pod. Pod — është një grup i një ose më shumë konteinerëve, të cilët ekzekutohen gjithmonë së bashku. Ato punojnë sikur gjithmonë të ishin në një makinë virtuale. Ato janë të aksesueshme për njëra-tjetrën përmes IP adresës 127.0.0.1 në porte të ndryshme.
Supozoni se keni një aplikacion PHP, i cili përbëhet nga nginx dhe php-fpm – një skemë klasike. Më shumë gjasa, do të dëshironit që dhe konteinerët nginx dhe php-fpm të ishin gjithmonë së bashku. Kubernetes e lejon këtë përmes përshkrimit të tyre si një pod të përbashkët. Kjo është pikërisht ajo që ne nuk mund ta arrinim me Nomad.
Koncepti i dytë është deployment. E vërteta është se pod vetë – është një gjë efemere, ajo ngrihet dhe zhduket. A dëshironi ta ndihmoni të gjithë konteinerët tuaj të mëparshëm ose dëshironi t'i lëshoni gradualisht – pikërisht për këtë proces përgjigjet koncepti i deployment. Ai përshkruan se si e grumbulloni pod-at tuaj, në sa sasi dhe si t'i rifreskoni ato.
Koncepti i tretë është shërbim. Shërbimi juaj është në thelb sistemi juaj që merr një trafik të caktuar dhe më pas e drejton atë në një ose disa pod-e që përputhen me shërbimin tuaj. Kështu që, ai lejon të thuhet se të gjithë trafiku i ardhshëm në shërbimin me emrin e tillë duhet të dërgohet në këto pod-e të caktuara. Dhe në të njëjtën kohë, ai siguron balancimin e trafikut. Kështu që mund të nisni dy pod-e të aplikacionit tuaj dhe të gjithë trafiku i ardhshëm do të balancohet në mënyrë të barabartë mes pod-eve që lidhen me këtë shërbim.
Dhe koncepti i katërt kryesor — Ingress. Ky është një shërbim që aktivizohet në një klaster Kubernetes. Ai vepron si një balancues i ngarkesës jashtë, që merr të gjitha kërkesat. Përmes API Kubernetes Ingress, ai mund të përcaktojë se ku duhet dërguar këto kërkesa. Dhe e bën këtë në mënyrë shumë fleksibile. Mund të thoni se të gjitha kërkesat në këtë host dhe këtë URL dërgohen në këtë shërbim. Ndërsa ato kërkesa që vijnë në këtë host dhe në një URL tjetër, dërgohen në një shërbim tjetër.
Më e shkëlqyera nga pikëpamja e atij që zhvillon aplikacionin është se ju keni mundësinë të menaxhoni gjithçka vetë. Duke vendosur konfigurimin e Ingress, mund të dërgoni gjithë trafikun që vjen në një API të caktuar në kontejnerë të veçantë, të shkruar, për shembull, në Go. Ndërsa ky trafik, që vjen në të njëjtin domen, por në një URL tjetër, dërgohet në kontejnerë të shkruar në PHP, ku ka shumë logjikë, por ata nuk janë shumë të shpejtë.
Nëse e krahasojmë të gjitha këto koncepte me Nomad, mund të thoshim se tre konceptet e para janë së bashku Shërbimi. Ndërsa koncepti i fundit në Nomad është i munguar. Ne përdorëm një balancues të jashtëm për këtë: mund të jetë haproxy, nginx, nginx+ dhe kështu me radhë. Në rastin e kubit, nuk keni nevojë të futni këtë koncept të shtuar veçmas. Megjithatë, nëse shikoni brenda Ingress, atëherë është ose nginx, ose haproxy, ose traefik, por si një funksionalitet i integruar në Kubernetes.
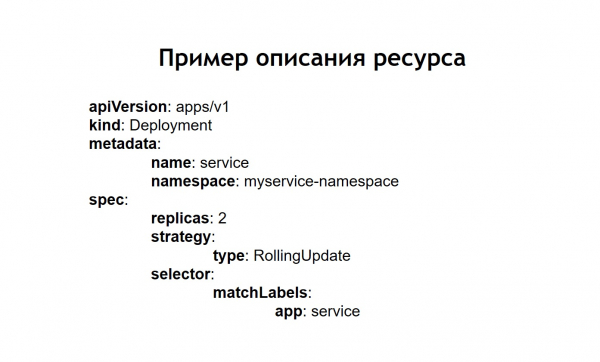
Të gjitha konceptet që përshkrova — në thelb janë burime që ekzistojnë brenda klasterit Kubernetes. Për përshkrimin e tyre në kube përdoret formati yaml, më i lexueshëm dhe më i njohur se skedarët HCL në rastin e Nomad. Por strukturisht ata përshkruajnë të njëjtën gjë në rastin e, për shembull, pod-it. Ata thonë — dëshiroj të depozitoj ato pod-e atje, me këto imazhe, në këtë numër.
Përveç kësaj, ne kuptuam se nuk dëshironim të krijonim manualisht çdo burim të veçantë: deployment, shërbime, Ingress dhe të tjera. Në vend të kësaj, ne donim që gjatë deployment-it të përshkruanim çdo sistem tonin në terminologjinë e Kubernetes, në mënyrë që të mos e kishim të nevojshme të ripërsërisnim manualisht të gjitha varësitë e nevojshme të burimeve në rendin e duhur. Si një sistem që na lejonte ta bënim këtë, u zgjodh Helm.
Koncepte kryesore në Helm
Helm është , një grup utilitarësh standard (binutils, coreutils, netutils, extrautils), shell-in e komandave për Kubernetes. Ai është shumë i ngjashëm me mënyrën se si funksionojnë menaxherët e pakove në gjuhët e programimit. Ata ju lejojnë të ruani një shërbim që përbëhet, për shembull, nga një deployment nginx, një deployment php-fpm, një konfigurim për Ingress, configmaps (kjo është një entitet që ju lejon të përcaktoni env dhe parametra të tjerë për sistemin tuaj) në formën e ashtuquajturve charts. Në këtë rast, Helm funksionon mbi Kubernetes. Pra, kjo nuk është ndonjë sistem që qëndron jashtë, por thjesht një shërbim tjetër që ekzekutohet brenda kubit. Ju ndërveproni me të nëpërmjet API-t të tij përmes komandës në konsolë. Komforti dhe bukuria e tij është se madje edhe nëse helm dështojnë ose e fshini atë nga klasteri, shërbimet tuaja nuk do të zhduken, pasi helm shërben në thelb vetëm për të nisur sistemin. Për funksionimin dhe gjendjen e shërbimeve përgjigjet vetë Kubernetes.
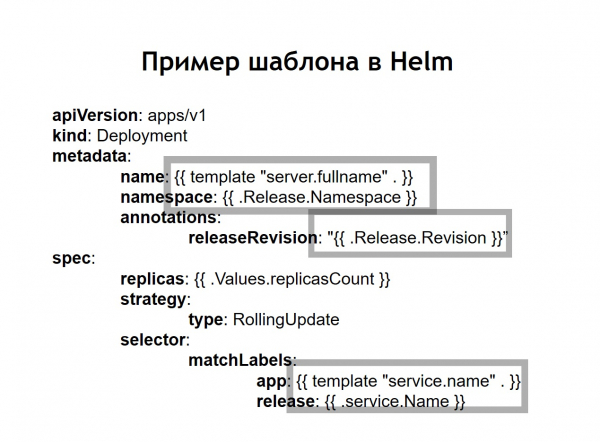
Gjithashtu ne kuptuam se templating, e cila deri tani kishim qenë të detyruar ta bënim vetë përmes integrimit të jinja në konfigurimet tona, është një nga mundësitë kryesore të helm. Të gjitha konfigurimet që krijoni për sistemet tuaja ruhen në helm në formën e shablloneve, disi të ngjashme me jinja, por në të vërtetë përdorin një templating të gjuhës Go, në të cilën është shkruar helm, ashtu si Kubernetes.
Helm na sjell disa koncepte shtesë.
Grafiku — është përshkrimi i shërbimit tuaj. Në menaxherët e tjerë të pakove mund ta quajnë atë paketë, bundle ose diçka të ngjashme. Këtu quhet chart.
Values – janë variablat që dëshironi të përdorni për ndërtimin e konfigurimeve tuaja nga shabllonet.
ReleaseÇdo herë që shërbimi, i cili deploy-het përmes helm, merr një version incremental të lëshimit. Helm mban mend se cili ka qenë konfigurimi i shërbimit në lëshimet e mëparshme. Prandaj, nëse është e nevojshme të kthehemi prapa, mjafton të ekzekutojmë komandën helm callback dhe të especificojmë versionin e mëparshëm të lëshimit. Edhe nëse në momentin e rikthimit, konfigurimi përkatës nuk është i disponueshëm në depot tuaj, helm akoma do ta mbajë mend si ka qenë dhe do ta kthejë sistemin tuaj në gjendjen që kishte në lëshimin e mëparshëm.
Në rastin kur ne përdorim helm, konfigurimet e zakonshme për Kubernetes gjithashtu shndërrohen në shabllone, ku ka mundësi të përdoren variabla, funksione dhe të aplikohen operatorë kushtorë. Kështu, ju mund të ndërtoni konfigurimin e shërbimit tuaj në varësi të mjedisit.
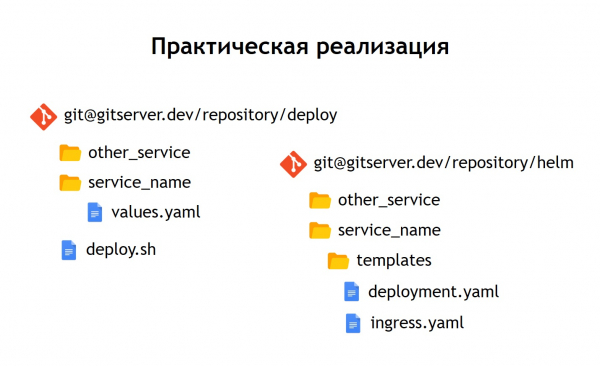
Në praktikë kemi vendosur të veprojmë pak ndryshe nga si kemi bërë në rastin me Nomad. Nëse në Nomad në një depo ruheshin si konfigurimet për deploy dhe variablat n që nevojiten për të deploy-uar shërbimin tonë, këtu kemi vendosur t'i ndajmë ato në dy depo të veçanta. Në depon "deploy" ruhen vetëm variablat n të nevojshëm për deploy, ndërsa në depon "helm" ruhen konfigurimet ose chartet.
Çfarë na dha kjo?
Megjithëse në vetë skedat konfiguratore nuk ruajmë ndonjë të dhënë vërtet të ndjeshëm, për shembull, fjalëkalimet për bazat e të dhënave. Ato ruhen në formë secrets në Kubernetes, megjithatë, ka disa elemente për të cilat nuk duam të japim akses për të gjithë. Prandaj, aksesit në depon "deploy" është më i kufizuar, ndërsa depon "helm" përmban thjesht përshkrimin e shërbimit. Për këtë arsye, në të mund të jepet akses në mënyrë të sigurt për më shumë njerëz.
Meqenëse ne kemi jo vetëm prodhimin, por edhe mjedise të tjera, përmes këtij ndarjeje mund të ripërdorim chartet tona helm për të deploy-uar shërbimet jo vetëm në prodhim, por edhe, për shembull, në ambientin QA. Edhe për të zhvilluar ato në mënyrë lokale, duke përdorur Minikube — kjo është një gjë për nisjen lokale të Kubernetes.
Brenda çdo repozitor ne kemi lënë ndarjen në drejtoritë e veçanta për çdo shërbim. Kështu që brenda çdo drejtorie ndodhen shabllone që i përkasin chart-it përkatës dhe përshkruajnë burimet që duhet të vendosen për të nisur sistemin tonë. Në repozitorin "deploy" kemi lënë vetëm envar. Në këtë rast, nuk e përdorëm shabllonizimin përmes jinja, sepse helm vetë ofron shabllonizim nga kuti – kjo është një nga funksionet e tij kryesore.
Kemi lënë skenarin për vendosjen – deploy.sh, i cili e thjeshtëson dhe standardizon lançimin për vendosjen me helmin. Kështu, për çdo person që dëshiron të vendosë, ndërfaqja e vendosjes duket saktësisht siç ishte në rastin e vendosjes përmes Nomad. I njëjti deploy.sh, emri i shërbimit tuaj dhe vendi ku dëshironi ta vendosni. Kjo çon në atë që helm nis. Ai ngaana e tij mbledh konfigurimet nga shabllonet, i vendos ato në skedarët e nevojshëm të vlerave, pastaj vendos, duke i dërguar në Kubernetes.
Përfundimet
Shërbimi Kubernetes duket më i komplikuar se Nomad.
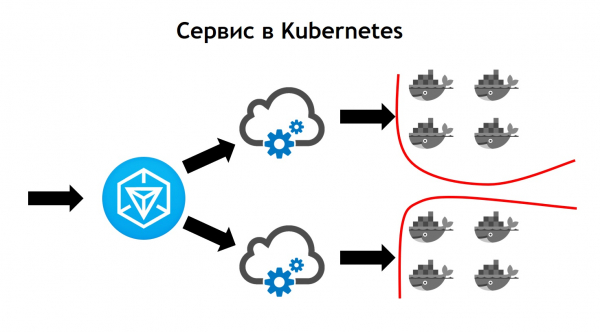
Këtu trafiku dalës vjen në Ingress. Ky është pikërisht kontrolluesi i përparë, i cili merr të gjitha kërkesat dhe më pas i dërgon ato në shërbimet përkatëse për kërkesat. Ai i përcakton ata në bazë të konfigurimeve, të cilat janë pjesë e përshkrimit të aplikacionit tuaj në helm dhe që zhvilluesit i caktuan vetë. Shërbimi pastaj dërgon kërkesat në pod-et e tij, pra në kontejnerët specifik, duke balancuar trafikun e hyrës ndërmjet të gjithë kontejnerëve që i përkasin këtij shërbimi. Dhe, sigurisht, nuk duhet harruar se nga siguria në nivelin e rrjetit, ne nuk duhet të largohemi. Prandaj në klastrin Kubernetes funksionon segmentimi, i cili bazohet në etiketim. Të gjithë shërbimet kanë etiketa të caktuara, të cilat lidhen me të drejtat e aksesit të shërbimeve në burime të ndryshme/ brenda ose jashtë klastri.
Përmes kalimit, ne vëmë re se Kubernetes ka të gjitha aftësitë që kishte Nomad, të cilin ne e përdornim më parë, dhe gjithashtu sjell shumë gjëra të reja. Ai mund të zgjerohet përmes plug-in-ëve, dhe në fakt përmes tipave të personalizuar të burimeve. Kështu që keni mundësinë të mos përdorni vetëm atë që vjen me Kubernetes nga fillimi, por të krijoni burimin dhe shërbimin tuaj, të cilët do të lexojnë burimin tuaj. Kjo ofron mundësi të tjera për zgjerimin e sistemit tuaj pa pasur nevojë për riinstalimin e Kubernetes dhe pa ndryshime të nevojshme.
Një shembull i këtij përdorimi është Prometheus, i cili funksionon brenda klasterit Kubernetes. Për ta bërë atë të fillojë të mbledhë metrika nga një shërbim i caktuar, na nevojitet të shtojmë në përshkrimin e shërbimit një tip të ri burimi, të ashtuquajturin monitor-shërbimi. Prometheus, për shkak se di të lexojë, duke u ekzekutuar në Kubernetes, tipin e personalizuar të burimeve, automatikisht fillon të mbledhë metrika nga sistemi i ri. Kjo është mjaft e përshtatshme.
Deploy-i i parë që bëmë në Kubernetes ishte në mars 2018. Dhe gjatë kësaj kohe ne nuk kemi përjetuar kurrfarë problemi me të. Ai punon mjaft stabilisht pa ndonjë defekt të rëndësishëm. Gjithashtu, ne mund ta zgjerim më tej. Aktualisht, na mjaftojnë ato mundësi që ka, dhe ritmi i zhvillimit të Kubernetes na pëlqen shumë. Në këtë moment, mbi 3000 konteinerë ndodhen në Kubernetes. Klasteri përbëhet nga disa Node. Ndërkohë, ai është i mbështetur, stabil dhe shumë i kontrollueshëm.
Burimi: habr.com
