

Autori i artikullit, përkthimi i të cilit po publikojmë sot, thotë se qëllimi i saj është të tregojë për zhvillimin e një web-scraper në Python duke përdorur Selenium, i cili kërkon çmimet e biletave te avionit. Gjatë kërkimit të biletave përdoren data fleksibile (+- 3 ditë rreth datave të caktuara). Scraper ruan rezultatet e kërkimit në një skedar Excel dhe i dërgon atij që e nisi, një email me informacion të përgjithshëm rreth asaj që arriti të gjejë. Qëllimi i këtij projekti është ndihma për udhëtarët në gjetjen e ofertave më të favorshme.
Nëse, duke u marrë me materialin, ndiheni të humbur - shikoni te artikullin.
Çfarë do të kërkojmë?
Jeni të lirë të përdorni sistemin e përshkruar këtu siç dëshironi. Unë, për shembull, e kam përdorur atë për të kërkuar tura fundjave dhe bileta në qytetin tim të lindjes. Nëse jeni të vendosur seriozisht për të gjetur bileta të favorshme - mund të ndizni skenarin në një server (një i thjeshtë, , për 130 rubla në muaj, është më thanë i mjaftueshëm për këtë) dhe ta vendosni atë që të funksionojë një ose dy herë në ditë. Rezultatet e kërkimit do t'ju vijnë përmes emailit. Për më tepër, rekomandoj që të gjitha të konfigurohen në mënyrë që skenari të ruajë skedarin Excel me rezultatet e kërkimit në një dosje Dropbox, çka do t'ju lejojë të shihni skedarë të tillë nga çdo vend dhe në çdo kohë.
Unë ende nuk kam gjetur tarifa me gabime, por mendoj se kjo është e mundur.
Gjatë kërkimit, siç u tha më parë, përdoret "data fleksibile", skenari gjen oferta që ndodhen brenda tri ditëve nga datat e caktuara. Megjithatë, kur ndizet skenari, kërkimi kryhet vetëm për një drejtim, nuk është e vështirë ta përmirësosh atë që të mund të mbledhë të dhëna për disa drejtime fluturimesh. Me ndihmën e tij mund të kërkohen edhe tarifa të gabuara, zbulime të tilla mund të jenë shumë interesante.
Pse është nevojshme një tjetër web-scraper?
Kur kam fillova të merrem me web scraping, sinqerisht, kjo nuk ishte shumë e interesant. Dëshiroja të bëja më shumë projekte në fushën e modelimit parashikues, analizës financiare, dhe ndoshta në fushën e analizës së ngjyrës emocionale të teksteve. Por doli se ishte shumë interesante – të kuptoj se si të krijosh një program që mbledh të dhëna nga faqet e internetit. Me kalimin e kohës, kuptova se vetë web scraping është 'motorri' i internetit.
Ndoshta do të vendosni se kjo është një deklaratë e guximshme. Por mendoni për faktin se kompania Google filloi me një web scraper, të cilin Larry Page e krijoi duke përdorur Java dhe Python. Robotët e Google eksplorojnë dhe vazhdojnë të eksplorojnë internetin, duke u përpjekur të ofrojnë përdoruesve të tyre përgjigjet më të mira për pyetjet e tyre. Web scraping ka një numër të pafund aplikimesh dhe, edhe nëse në fushën e Data Science jeni të interesuar për diçka tjetër, do t'ju duhen disa aftësi scraping për të siguruar të dhënat për analizë.
Disa nga teknikat e përdorura këtu i gjeta në një të mrekullueshme për web scraping, të cilën e kam marrë së fundmi. Ajo përmban shumë shembuj të thjeshtë dhe ide për aplikimin praktik të asaj që kemi mësuar. Për më tepër, ka një kapitull të shumë interesante për kalimin e kontrolleve reCaptcha. Për mua kjo ishte një lajm, pasi nuk dija se ekzistonin mjete të veçanta dhe madje edhe shërbime të tëra për zgjidhjen e këtyre detyrave.
A e doni të udhëtoni?!
Në një pyetje të thjeshtë dhe mjaft paqësore, e cila është paraqitur në titullin e këtij kapitulli, shpesh mund të dëgjoni një përgjigje pozitive, e cila shoqërohet me disa histori nga udhëtimet e atij që është pyetur. Shumica prej nesh do të pajtohen se udhëtimet janë një mënyrë e shkëlqyer për t'u zhytur në kultura të reja dhe për të zgjeruar horizontet tona. Megjithatë, nëse i pyesni dikë nëse i pëlqen të kërkojë fluturojë, unë jam i sigurt se përgjigjja do të jetë shumë më pak pozitive. Në të vërtetë, këtu na vjen në ndihmë Python.
Detyra e parë që duhet të zgjidhim në rrugën e krijimit të një sistemi kërkimi për informacionin mbi biletat e avionëve është zgjedhja e platformës së duhur nga e cila do të marrim informacionin. Zgjidhja e kësaj detyre nuk ishte e lehtë për mua, por në fund zgjodha shërbimin Kayak. Provova shërbimet Momondo, Skyscanner, Expedia dhe disa të tjera, por mekanizmat e mbrojtjes nga robotët në këto burime ishin të pakalueshëm. Pas disa përpjekjesh, gjatë të cilave, duke u përpjekur të bindja sistemet se isha njeri, mu desh të merrem me semaforë, kalime këmbësorësh dhe biçikleta, vendosa se Kayak ishte më i përshtatshmi për mua, pavarësisht se edhe këtu, nëse ngarkohem me shumë faqe në një kohë të shkurtër, fillojnë kontrollet. Arrita të bëj që boti të dërgonte kërkesa në site në intervale prej 4 deri në 6 orë, dhe gjithçka funksionoi normalisht. Periodikisht, ndodhin vështirësi edhe me Kayak, por nëse filloni të shqetësoheni nga kontrollet, duhet ose të merret me to manualisht dhe pastaj të ndizni botin, ose të prisni disa orë dhe kontrolli duhet të ndalet. Nëse është e nevojshme, mund ta përshtatni kodin për një platformë tjetër, dhe nëse e bëni këtë — na informoni në komentet.
Nëse sapo po filloni të njiheni me web scraping dhe nuk e dini pse disa faqet e internetit e luftojnë me gjithë forcën këtë praktikë, para se të filloni projektin tuaj të parë në këtë fushë — bëni vetes një shërbim dhe kërkoni në Google materiale me fjalët "web scraping etiquette". Eksperimentet tuaja mund të përfundojnë më shpejt sesa mendoni, nëse bëni web scraping pa mend.
Fillimi i punës
Ja një përmbledhje e përgjithshme e asaj që do të ndodhë në kodin e web scrapern tonë:
- Importimi i bibliotekave të nevojshme.
- Hapja e skedës Google Chrome.
- Thirrja e funksionit që aktivizon botin, duke i kaluar qytetet dhe datat që do të përdoren gjatë kërkimit të biletave.
- Ky funksion merr rezultatet e para të kërkimit, të renditura sipas kritereve të tërheqjes më të madhe (best), dhe klikon mbi butonin për të ngarkuar rezultate shtesë.
- Një funksion tjetër mbledh të dhëna nga e gjithë faqja dhe kthen një kornizë të dhënash.
- Dy hapat e mëparshëm kryhen duke përdorur llojet e renditjes sipas çmimeve të biletave (cheap) dhe sipas shpejtësisë së fluturimit (fastest).
- Përdoruesit e skenarit i dërgohet një email që përmban një përmbledhje të shkurtër të çmimeve të biletave (biletat më të lira dhe çmimi mesatar), ndërsa një kornizë të dhënash me informacionin e renditur sipas tre treguesve të përmendur ruhet në formën e një skedari Excel.
- Të gjitha veprimet e përmendura më parë kryhen në një cikël në intervale të caktuara kohore.
Duhet të theksohet se çdo projekt Selenium fillon me web driver-in. Unë përdor , duke punuar me Google Chrome, por ka edhe opsione të tjera. PhantomJS dhe Firefox janë gjithashtu të njohura. Pas shkarkimit të driver-it, ai duhet të vendoset në dosjen përkatëse, dhe përgatitja për përdorimin e tij përfundon këtu. Në rreshtat e parë të skenarit tonë hapet një skedë e re në Chrome.
Kini parasysh se unë, në tregimin tim, nuk përpiqem të hap horizontet e reja në kërkimin e ofertave më të mira për biletat e avionëve. Ka teknika shumë më të avancuara për gjetjen e këtyre ofertave. Më shumë, dëshiroj t'u ofroj lexuesve të këtij materiali një mënyrë të thjeshtë, por praktikisht të zbatueshme për zgjidhjen e kësaj çështjeje.
Këtu është kodi për të cilin folëm më parë.
from time import sleep, strftime
from random import randint
import pandas as pd
from selenium import webdriver
from selenium.webdriver.common.keys import Keys
import smtplib
from email.mime.multipart import MIMEMultipart

# Përdorni këtu rrugën tuaj për chromedriver!
chromedriver_path = 'C:/ {YOUR PATH HERE}/chromedriver_win32/chromedriver.exe'

driver = webdriver.Chrome(executable_path=chromedriver_path) # Ky komandë hap dritaren e Chrome
sleep(2)
Në fillim të kodit, mund të shihni komandat e importit të paketave që përdoren gjatë gjithë projektit tonë. Kështu, randint përdoret për të bërë që boti "të flejë" për një numër rastësor sekondash para se të fillojë një operacion të ri kërkimi. Zakonisht, asnjë bot nuk mund të anashkalohet pa këtë. Nëse ekzekutoni kodin e mësipërm, do të hapet një dritare Chrome, e cila do të përdoret nga boti për të punuar me faqet web.
Le të bëjmë një eksperiment të vogël dhe të hapim në një dritare të veçantë faqen kayak.com. Do të zgjedhim qytetin nga ku do të fluturojmë dhe qytetin në të cilin duam të shkojmë, si dhe datat e fluturimeve. Kur të zgjidhim datat, sigurohuni që të përdorni një gamë prej +-3 ditësh. Unë kam shkruar kodin duke marrë parasysh atë që kthehet nga faqja në përgjigje të kërkesave të tilla. Nëse, për shembull, ju nevojitet të kërkoni bileta vetëm për datat e caktuara, atëherë ka shumë gjasa që do të duhet ta rregulloni kodin e bllokut. Ndërsa flas për kodin, bëj shpjegime përkatëse, por nëse ndiheni të hutuar — më njoftoni.
Tani kliko në butonin e fillimit të kërkimit dhe shiko linkun në barin e adresave. Ai duhet të jetë i ngjashëm me atë link që unë po përdor si shembull më poshtë, aty ku shpallet variabla kayak, i cili ruan URL-në, dhe përdoret metoda merr e web-driverit. Pas shtypjes së butonit të kërkimit, rezultatet duhet të shfaqen në faqe.

Kur kam përdorur komandën merr më shumë se dy-tre herë në një periudhë disa minutash, më ofruan të kaloj një verifikim duke përdorur reCaptcha. Ky verifikim mund të kalojë manualisht dhe të vazhdoni eksperimentet deri atëherë sa sistemi të vendosë të bëjë një verifikim të ri. Kur e testova skriptin, krijohej ndjenja se seanca e parë e kërkimit gjithmonë kalonte pa probleme, prandaj, nëse dëshironi të eksperimentoni me kodin, do t'ju duhet të kaloni manualisht verifikimin dhe ta lëshoni kodin të funksionojë, duke përdorur intervale të gjata midis seancave të kërkimit. Po ashtu, nëse kuptoni, njeriu për së afërti nuk ka nevojë për informacion në lidhje me çmimet e biletave të marrë me intervale 10-minutëshe midis operacioneve të kërkimit.
Puna me faqen duke përdorur XPath
Pra, ne hapëm një dritare dhe ngarkuam faqen. Për të marrë informacion mbi çmimet dhe informacion të tjera, na nevojitet të përdorim teknologjinë XPath ose CSS-selektuesit. Kam vendosur të ndalem te XPath dhe nuk ndjeva nevojë për të përdorur CSS-selektues, por është krejtësisht e mundur të punohet edhe kështu. Lëvizja nëpër faqe duke përdorur XPath mund të jetë një gjë e vështirë, dhe madje edhe nëse përdorni ato metoda që unë kam përshkruar në në artikullin ku u aplikua kopjimi i identifikuesve përkatës nga kodi i faqeve, kuptova se ky në të vërtetë nuk është një mënyrë optimale për t'u qasur në elementët e nevojshëm. Për më tepër, në libër mund të gjeni një përshkrim të shkëlqyer të bazave të punës me faqet duke përdorur XPath dhe selektorët CSS. Këtu është se si duket metoda përkatëse e web-driver.

Pra, vazhdojmë punën mbi botin. Do të shfrytëzojmë mundësitë e programit për të zgjedhur biletat më të lira. Në imazhin e ardhshëm, kodi i selektorit XPath është theksuar me të kuqe. Për të parë kodin, duhet të klikoni me të djathtën mbi elementin e faqeve që ju intereson dhe të zgjidhni komandën Shiko kodin (Inspect) nga menuja që shfaqet. Këtë komandë mund ta thërrisni për elemente të ndryshme të faqeve, kodi i të cilëve do të shfaqet dhe do të theksohet në dritaren e shikimit të kodit.
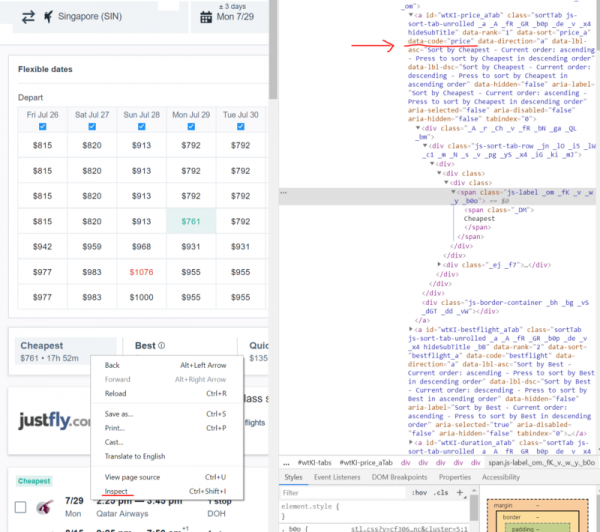
Shikimi i kodit të faqeve
Për të gjetur një konfirmim për argumentet e mia mbi disavantazhet e kopjimit të selektorëve nga kodi, ju lutem vini re karakteristikat e mëposhtme.
Ja çfarë ndodh kur kopjohet kodi:
//*[@id="wtKI-price_aTab"]/div[1]/div/div/div[1]/div/span/spanPër të kopjuar diçka të ngjashme, duhet të klikoni me të djathtën mbi pjesën e kodit që ju intereson dhe të zgjidhni komandën Copy > Copy XPath nga menuja që shfaqet.
Ja çfarë kam përdorur për të përcaktuar butonin Cheapest:
cheap_results = '//'a[@data-code = "price"]' 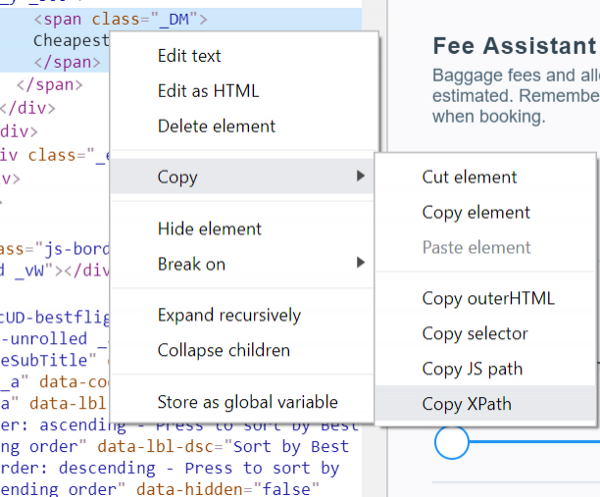
Komanda Copy > Copy XPath
Duket qartë se varianti i dytë duket shumë më i thjeshtë. Duke e përdorur, bëhet kërkimi i elementit a, i cili ka atributin data-code, i barabartë me price. Duke përdorur variantin e parë, bëhet kërkimi i elementit id i cili është i barabartë me wtKI-price_aTab, ndërsa rruga XPath deri në element duket si /div[1]/div/div/div[1]/div/span/span. Një kërkesë e tillë XPath në faqen do të kryejë punën e saj, por — vetëm një herë. Mund ta them tani që id do të ndryshojë me ngarkimin e ardhshëm të faqes. Se vula e karaktereve wtKI ndryshon dinamikisht me çdo ngarkim të faqes, si rezultat, kodi në të cilin përdoret, pas rinovimit të faqes, do të bëhet i padobishëm. Prandaj, merrni pak kohë për të kuptuar XPath. Këto njohuri do t'ju shërbejnë mirë.
Megjithatë, duhet të theksohet se kopjimi i selektorëve XPath mund të jetë i dobishëm kur punoni me faqe mjaft të thjeshta, dhe nëse kjo ju përshtatet, nuk ka asgjë të keqe në këtë.
Tani e të mendojmë për atë se çfarë të bëjmë nëse na nevojitet të marrim të gjitha rezultatet e kërkimit në disa rreshta, brenda një liste. Shumë thjesht. Çdo rezultat ndodhet brenda një objekti me klasën resultWrapper. Ngarkimi i të gjitha rezultateve mund të realizohet në një cikël, i cili do të tregohet më poshtë.
Duhet të theksohet se nëse ju është e kuptueshme ajo që u tha më sipër, atëherë nuk do të keni probleme të kuptoni shumicën e kodit që do të shqyrtojmë. Gjatë funksionimit të këtij kodi në atë që na nevojitet (faktikisht, ky është elementi në të cilin është e mbWrappedul rezultati), ne i qasemi duke përdorur një mekanizëm të caktimit të rrugës (XPath). Kjo bëhet për të marrë tekstin e elementit dhe për ta vendosur atë në një objekt nga i cili mund të lexojmë të dhënat (fillimisht përdoret flight_containers, pastaj — flights_list).
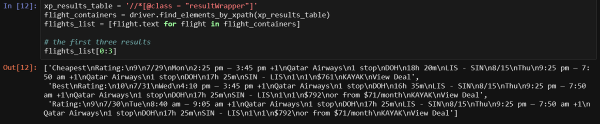
Dalin tre rreshta të parë dhe ne mund të shohim qartë gjithçka që na nevojitet. Megjithatë, kemi dhe mënyra më interesante për të marrë informacionin. Na nevojitet të marrim të dhënat nga çdo element veç e veç.
Në punë!
Më lehtë është të shkruaj një funksion për ngarkimin e rezultateve shtesë, kështu që do ta fillojmë me të. Doja të maksimizoja numrin e fluturimeve, të dhënat e të cilave e merr programi, dhe në të njëjtën kohë të mos shkaktoj ndonjë dyshim te shërbimi, prandaj unë klikoj një herë mbi butonin Ngarko rezultatet e tjera çdo herë që shfaqet faqja. Në këtë kod, duhet të kushtohet vëmendje bllokut përpiqem, të cilin e kam shtuar për shkak se ndonjëherë butoni nuk ngarkohet siç duhet. Nëse ju ndodheni gjithashtu përballë kësaj — komentoni thirrjet e kësaj funksioni në kodin e funksionit start_kayak, që do të shqyrtojmë më poshtë.
# Загрузка большего количества результатов для того, чтобы максимизировать объём собираемых данных
def load_more():
    try:
        more_results = '//a[@class = "moreButton"]'
        driver.find_element_by_xpath(more_results).click()
        # Вывод этих заметок в ходе работы программы помогает мне быстро выяснить то, чем она занята
        print('sleeping.....')
        sleep(randint(45,60))
    except:
        pass
Tani, pas një analize të gjatë të këtij funksioni (ndonjëherë mund të merrem shumë me të), jemi gati të shpallim një funksion që do të merret me skrapimin e faqes.
Unë kam grumbulluar shumicën e asaj që nevojitet, në funksionin e ardhshëm, të quajtur page_scrape. Ndërsa të dhënat e kthyera për fazat e rrugës ndonjëherë duken të bashkuara, për t'i ndarë unë përdor një metodë të thjeshtë. Për shembull, kur e përdor për herë të parë variablat section_a_list dhe section_b_list. Funksioni ynë kthen një të dhënë të çarë flights_df, kjo na lejon të ndajnë rezultatet e marra duke përdorur metoda të ndryshme të renditjes së të dhënave, dhe më vonë — t’i bashkojmë ato.
def page_scrape():
    """This function takes care of the scraping part"""

    xp_sections = '//*[@class="section duration"]'
    sections = driver.find_elements_by_xpath(xp_sections)
    sections_list = [value.text for value in sections]
    section_a_list = sections_list[::2] # так мы разделяем информацию о двух полётах
    section_b_list = sections_list[1::2]

    # Если вы наткнулись на reCaptcha, вам может понадобиться что-то предпринять.
    # О том, что что-то пошло не так, вы узнаете исходя из того, что вышеприведённые списки пусты
    # это выражение if позволяет завершить работу программы или сделать ещё что-нибудь
    # тут можно приостановить работу, что позволит вам пройти проверку и продолжить скрапинг
    # я использую тут SystemExit так как хочу протестировать всё с самого начала
    if section_a_list == []:
        raise SystemExit

    # Я буду использовать букву A для уходящих рейсов и B для прибывающих
    a_duration = []
    a_section_names = []
    for n in section_a_list:
        # Получаем время
        a_section_names.append(''.join(n.split()[2:5]))
        a_duration.append(''.join(n.split()[0:2]))
    b_duration = []
    b_section_names = []
    for n in section_b_list:
        # Получаем время
        b_section_names.append(''.join(n.split()[2:5]))
        b_duration.append(''.join(n.split()[0:2]))

    xp_dates = '//div[@class="section date"]'
    dates = driver.find_elements_by_xpath(xp_dates)
    dates_list = [value.text for value in dates]
    a_date_list = dates_list[::2]
    b_date_list = dates_list[1::2]
    # Получаем день недели
    a_day = [value.split()[0] for value in a_date_list]
    a_weekday = [value.split()[1] for value in a_date_list]
    b_day = [value.split()[0] for value in b_date_list]
    b_weekday = [value.split()[1] for value in b_date_list]

    # Получаем цены
    xp_prices = '//a[@class="booking-link"]/span[@class="price option-text"]'
    prices = driver.find_elements_by_xpath(xp_prices)
    prices_list = [price.text.replace('$','') for price in prices if price.text != '']
    prices_list = list(map(int, prices_list))

    # stops - это большой список, в котором первый фрагмент пути находится по чётному индексу, а второй - по нечётному
    xp_stops = '//div[@class="section stops"]/div[1]'
    stops = driver.find_elements_by_xpath(xp_stops)
    stops_list = [stop.text[0].replace('n','0') for stop in stops]
    a_stop_list = stops_list[::2]
    b_stop_list = stops_list[1::2]

    xp_stops_cities = '//div[@class="section stops"]/div[2]'
    stops_cities = driver.find_elements_by_xpath(xp_stops_cities)
    stops_cities_list = [stop.text for stop in stops_cities]
    a_stop_name_list = stops_cities_list[::2]
    b_stop_name_list = stops_cities_list[1::2]

    # сведения о компании-перевозчике, время отправления и прибытия для обоих рейсов
    xp_schedule = '//div[@class="section times"]'
    schedules = driver.find_elements_by_xpath(xp_schedule)
    hours_list = []
    carrier_list = []
    for schedule in schedules:
        hours_list.append(schedule.text.split('n')[0])
        carrier_list.append(schedule.text.split('n')[1])
    # разделяем сведения о времени и о перевозчиках между рейсами a и b
    a_hours = hours_list[::2]
    a_carrier = carrier_list[1::2]
    b_hours = hours_list[::2]
    b_carrier = carrier_list[1::2]


    cols = (['Out Day', 'Out Time', 'Out Weekday', 'Out Airline', 'Out Cities', 'Out Duration', 'Out Stops', 'Out Stop Cities',
            'Return Day', 'Return Time', 'Return Weekday', 'Return Airline', 'Return Cities', 'Return Duration', 'Return Stops', 'Return Stop Cities',
            'Price'])

    flights_df = pd.DataFrame({'Out Day': a_day,
                               'Out Weekday': a_weekday,
                               'Out Duration': a_duration,
                               'Out Cities': a_section_names,
                               'Return Day': b_day,
                               'Return Weekday': b_weekday,
                               'Return Duration': b_duration,
                               'Return Cities': b_section_names,
                               'Out Stops': a_stop_list,
                               'Out Stop Cities': a_stop_name_list,
                               'Return Stops': b_stop_list,
                               'Return Stop Cities': b_stop_name_list,
                               'Out Time': a_hours,
                               'Out Airline': a_carrier,
                               'Return Time': b_hours,
                               'Return Airline': b_carrier,
                               'Price': prices_list})[cols]

    flights_df['timestamp'] = strftime("%Y%m%d-%H%M") # время сбора данных
    return flights_df
Kam përpiqem t'i emërtoj variablat në mënyrë që kodi të jetë i qartë. Mbani mend se variablat që fillojnë nga a i përkasin fazës së parë të rrugës, ndërsa b — i përket fazës së dytë. Të kalojmë në funksionin tjetër.
Mekanizmat ndihmës
Tani kemi një funksion që lejon ngarkimin e rezultateve të ndihmëse të kërkimeve dhe një funksion për përpunimin e këtyre rezultateve. Ky artikull mund të përfundohet këtu, pasi këto dy funksione ofrojnë gjithçka të nevojshme për skrapimin e faqeve që mund të hapen vetë. Por ende nuk kemi shqyrtuar disa mekanizma ndihmës që u përmendën më parë. Për shembull — ky është kodi për dërgimin e email-eve dhe disa gjëra të tjera. Të gjitha këto mund të gjenden në funksionin start_kayak, të cilin tani do ta shqyrtojmë.
Për punimin e këtij funksioni nevojiten të dhena rreth qyteteve dhe datave. Ai, duke përdorur këto të dhëna, formon një lidhje në variablin kayak, i cili përdoret për të kaluar në faqen ku do të gjenden rezultatet e kërkimeve, të renditura sipas përputhjes së tyre më të mirë me kërkesën. Pas seancës së parë të skrapimit, ne do të punojmë me çmimet që ndodhen në tabelë, në pjesën e sipërme të faqes. Ajo që duhet të gjejmë është çmimi minimal i biletës dhe çmimi mesatar. Të gjitha këto, së bashku me parashikimin që ofron faqja, do të dërgohen me email. Në faqen përkatëse, tabela duhet të jetë në këndin e majtë të sipërm. Punimi me këtë tabelë, përkujdes, mund të shkaktojë një gabim kur kërkohet përdorimi i datave të sakta, pasi në këtë rast tabela në faqe nuk shfaqet.
def start_kayak(city_from, city_to, date_start, date_end):
    """Kodet e qytetit - këto janë kodet IATA!
    Formati i datës - YYYY-MM-DD"""

    kayak = ('https://www.kayak.com/flights/' + city_from + '-' + city_to +
             '/' + date_start + '-flexible/' + date_end + '-flexible?sort=bestflight_a')
    driver.get(kayak)
    sleep(randint(8,10))

    # ndonjëherë shfaqet një dritare, për kontrollin e saj dhe mbylljen e saj mund të përdorim bllokun try
    try:
        xp_popup_close = '//*[contains(@id,"dialog-close") and contains(@class,"Button-No-Standard-Style close ")]'
        driver.find_elements_by_xpath(xp_popup_close)[5].click()
    except Exception as e:
        pass
    sleep(randint(60,95))
    print('duke ngarkuar më shumë.....')

#     load_more()

    print('duke filluar scraping-un e parë.....')
    df_flights_best = page_scrape()
    df_flights_best['sort'] = 'best'
    sleep(randint(60,80))

    # Të marrim çmimin më të ulët nga tabela, e cila ndodhet në pjesën e sipërme të faqeve
    matrix = driver.find_elements_by_xpath('/*[contains(@id,"FlexMatrixCell")]')
    matrix_prices = [price.text.replace('$','') for price in matrix]
    matrix_prices = list(map(int, matrix_prices))
    matrix_min = min(matrix_prices)
    matrix_avg = sum(matrix_prices)/len(matrix_prices)

    print('duke kaluar te rezultatet më të lira.....')
    cheap_results = '//*[contains(@data-code = "price")]'
    driver.find_element_by_xpath(cheap_results).click()
    sleep(randint(60,90))
    print('duke ngarkuar më shumë.....')

#     load_more()

    print('duke filluar scraping-un e dytë.....')
    df_flights_cheap = page_scrape()
    df_flights_cheap['sort'] = 'cheap'
    sleep(randint(60,80))

    print('duke kaluar te rezultatet më të shpejta.....')
    quick_results = '//*[contains(@data-code = "duration")]'
    driver.find_element_by_xpath(quick_results).click()
    sleep(randint(60,90))
    print('duke ngarkuar më shumë.....')

#     load_more()

    print('duke filluar scraping-un e tretë.....')
    df_flights_fast = page_scrape()
    df_flights_fast['sort'] = 'fast'
    sleep(randint(60,80))

    # Ruajtja e kornizës së re në një skedar Excel, emri i së cilës reflekton qytetet dhe datat
    final_df = df_flights_cheap.append(df_flights_best).append(df_flights_fast)
    final_df.to_excel('search_backups//{}_flights_{}-{}_from_{}_to_{}.xlsx'.format(strftime("%Y%m%d-%H%M"),
                                                                                   city_from, city_to,
                                                                                   date_start, date_end), index=False)
    print('ruajtur df.....')

    # Mund të ndjekim se si parashikimi, i dhënë nga situs, korrespondon me realitetin
    xp_loading = '//*[contains(@id,"advice")]'
    loading = driver.find_element_by_xpath(xp_loading).text
    xp_prediction = '//*[contains(@class="info-text")]'
    prediction = driver.find_element_by_xpath(xp_prediction).text
    print(loading+'n'+prediction)

    # ndonjëherë në variablin loading ndodhet kjo linjë, e cila, më vonë, shkakton probleme me dërgimin e emailit
    # nëse ndodh kjo - e ndryshojmë në "Not Sure"
    weird = '¯_(ツ)_/¯'
    if loading == weird:
        loading = 'Not sure'

    username = 'YOUREMAIL@hotmail.com'
    password = 'YOUR PASSWORD'

    server = smtplib.SMTP('smtp.outlook.com', 587)
    server.ehlo()
    server.starttls()
    server.login(username, password)
    msg = ('Subject: Flight Scrapernn
Fluksi më i lirë: {}nÇmimi mesatar: {}nnRekomandimi: {}nnKëtu mbaron mesazhi'.format(matrix_min, matrix_avg, (loading+'n'+prediction)))
    message = MIMEMultipart()
    message['From'] = 'YOUREMAIL@hotmail.com'
    message['to'] = 'YOUROTHEREMAIL@domain.com'
    server.sendmail('YOUREMAIL@hotmail.com', 'YOUROTHEREMAIL@domain.com', msg)
    print('email dërguar.....')
Unë e testova këtë skript duke përdorur një llogari Outlook (hotmail.com). Nuk e kam kontrolluar për funksionalitetin e tij me një llogari Gmail, kjo sistem i postës është shumë popullor, por ka shumë mundësi të tjera. Nëse në anën tjetër po përdorni një llogari Hotmail, për ta bërë që gjithçka të funksionojë, mjafton të futni të dhënat tuaja në kod.
Nëse dëshironi të kuptoni se çfarë është duke u ekzekutuar në copa të veçanta të këtij kodi, mund t'i kopjoni ato dhe të eksperimentoni me to. Eksperimentimi me kodin është mënyra e vetme për ta kuptuar siç duhet.
Sistemi i gatshëm
Tani që është bërë gjithçka për të cilën folëm, ne mund të krijojmë një cikël të thjeshtë në të cilin thirren funksionet tona. Skripti kërkon nga përdoruesi të dhëna mbi qytetet dhe datat. Kur e testoni me rinisje të vazhdueshme të skriptit, ndoshta nuk do të doni të futni këto të dhëna manualisht çdo herë, prandaj rreshtat përkatës, gjatë testimit, mund të komentoni, duke çkomentuar ato që vijnë më poshtë, në të cilat janë caktuar të dhënat e kërkuara për skriptin.
city_from = input('Nga cili qytet? ')
city_to = input('Ku? ')
date_start = input('Kërko rreth cilës date nisjeje? Ju lutem përdorni vetëm formatin YYYY-MM-DD ')
date_end = input('Kthehu kur? Ju lutem përdorni vetëm formatin YYYY-MM-DD ')

# city_from = 'LIS'
# city_to = 'SIN'
# date_start = '2019-08-21'
# date_end = '2019-09-07'

for n in range(0,5):
    start_kayak(city_from, city_to, date_start, date_end)
    print('itera {} u përfundua @ {}'.format(n, strftime("%Y%m%d-%H%M")))

    # Presim 4 orë
    sleep(60*60*4)
    print('gjumë përfundoi.....')
Këtu është si duket një nisje testuese e skriptit.
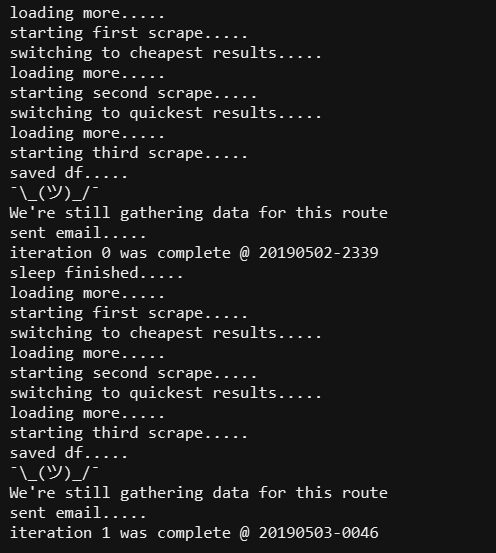
Nisja testuese e skriptit
Përfundime
Nëse keni arritur deri në këtë pikë — pranoni urimet! Tani keni një web scraper në funksion, megjithëse unë tashmë shoh shumë mundësi për ta përmirësuar. Për shembull, mund ta integrosh me Twilio, në mënyrë që ai, në vend të email-eve, të dërgonte mesazhe tekstuale. Mund të përdorni një VPN ose diçka tjetër për të marrë rezultatet nga disa serverë në të njëjtën kohë. Ka edhe një problem që ndodh herë pas here me verifikimin e përdoruesit nëse ai është një njeri, por këtë problem gjithashtu mund ta zgjidhni. Në çdo rast, tani keni një bazë që, nëse dëshironi, mund ta zgjeroni. Për shembull, ta bëni që skedari Excel të dërgohej përdoruesit si një shtesë në një email.
Vetëm përdoruesit e regjistruar mund të marrin pjesë në anketë. , ju lutem.
A përdorni teknologjitë e web-scraping?
Po.
Jo
Të votojnë 8 përdorues. U përgjigj një përdorues.
Burimi: habr.com
