

Historia e mëparshme
Ka happened that the server was attacked by a ransomware virus, which, by "happy coincidence," partially left the .ibd files (raw data files of InnoDB tables) untouched, while completely encrypting the .fpm files (structure files). In this case, .idb could be divided into:
- those that can be recovered through standard tools and guides. For such cases, there is an excellent ;
- partially encrypted tables. This mainly includes large tables, which, as I understood, the attackers did not have enough memory for full encryption;
- and completely encrypted tables, which are not recoverable.
Determining which option the tables belong to was achieved by simply opening them in any text editor with the appropriate encoding (in my case, this is UTF8) and just checking the file for text fields, for example:
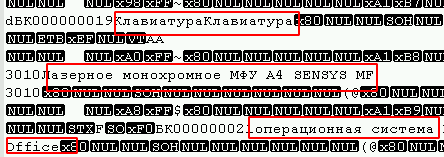
Also, at the beginning of the file, you can observe a large number of 0 bytes, and viruses that use block encryption algorithms (which is the most common) usually also affect them.

In my case, the attackers left a string of 4 bytes (1, 0, 0, 0) at the end of each encrypted file, which simplified the task. To find the uninfected files, even a script was sufficient:
def opened(path):
    files = os.listdir(path)
    for f in files:
        if os.path.isfile(path + f):
            yield path + f

for full_path in opened("C:somepath"):
    file = open(full_path, "rb")
    last_string = ""
    for line in file:
        last_string = line
        file.close()
    if (last_string[len(last_string) - 4:len(last_string)]) != (1, 0, 0, 0):
        print(full_path)
Thus, it turned out to find files belonging to the first type. The second involves a long manual process, but the found ones were already sufficient. Everything would be good, but it is necessary to know the absolutely exact structure and (of course) there was such a case that I had to work with a frequently changing table. Nobody remembered whether the field type had changed or whether a new column had been added.
Unfortunately, the City Debris could not help with such a case, which is why this article is being written.
Closer to the point
There is a table structure from three months ago that does not match the current one (possibly by one field, but possibly more). The table structure:
CREATE TABLE `table_1` (
    `id` INT (11),
    `date` DATETIME ,
    `description` TEXT ,
    `id_point` INT (11),
    `id_user` INT (11),
    `date_start` DATETIME ,
    `date_finish` DATETIME ,
    `photo` INT (1),
    `id_client` INT (11),
    `status` INT (1),
    `lead__time` TIME ,
    `sendstatus` TINYINT (4)
);
Në të njëjtën kohë, është e nevojshme të nxirret:
id_pointINT (11);id_userINT (11);date_startDATETIME ;date_finishDATETIME .
Për rikuperimin përdoret analiza byte për byte e skedarit .ibd, duke e transferuar në një format më të lexueshëm. Duke qenë se për të gjetur atë që kërkojmë, mjafton të analizojmë llojet e dhënash si int dhe datetime, në këtë artikull do të përshkruhen vetëm ato, por ndonjëherë do të referohem edhe në lloje të tjera të të dhënave, që mund të ndihmojnë në ngjarje të tjera të ngjashme.
Problemi 1: në fushat me llojet DATETIME dhe TEXT kishte vlera NULL, dhe në skedar ato thjesht kalohen, për shkak të kësaj, të përcaktosh strukturën për rikuperim në rastin tim nuk arrita. Në kolonat e reja, vlera e paracaktuar ishte null, dhe një pjesë e transaksionit mund të kishte humbur për shkak të konfigurimit innodb_flush_log_at_trx_commit = 0, prandaj për të përcaktuar strukturën do të kishte nevojë për më shumë kohë.
Problemi 2: duhet të keni parasysh se rreshtat e fshirë nëpërmjet DELETE, gjithmonë do të jenë në skedarin ibd, por gjatë ALTER TABLE struktura e tyre nuk do të përditësohet. Në fund, struktura e të dhënave mund të ndryshojë nga fillimi i skedarit deri në fund të tij. Nëse përdorni shpesh OPTIMIZE TABLE, është e vështirë të hasni një problem të tillë.
Vini re, versioni i DBMS ndikon në mënyrën e ruajtjes së të dhënave, dhe ky shembull mund të mos funksionojë për versione të tjera kryesore. Në rastin tim, përdorej versioni Windows i mariadb 10.1.24. gjithashtu, ndonëse në mariadb punoni me tabela InnoDB, në fakt ato janë , që përjashton aplikimin e metodës me InnoDB mysql.
Analiza e skedarit
Në python, lloji i të dhënave tregon të dhënat në unicode në vend të një grupi të zakonshëm numërash. Edhe pse skedari mund të shqyrtohet në këtë mënyrë, për lehtësi mund të konvertohet bytes në formë numerike duke e kthyer masivin e bytes në një masiv të zakonshëm (list(example_byte_array)). Në çdo rast, të dy mënyrat do të jenë të dobishme për analizë.
Pasi kam shqyrtuar disa skedarë ibd, mund të hasni në të mëposhtmet:
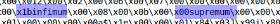
Dhe, nëse e ndajmë skedarin sipas këtyre fjalëve kyçe, do të dalin kryesisht blloqe të njëtrajtshme të dhënash. Do të përdorim infimum si ndarës.
table = table.split("infimum".encode())Një vëzhgim interesant, për tabelat me një numër të vogël të të dhënave, midis infimum dhe supremum është një tregues për numrin e rreshtave në bllok.
 — tabela testuese me një rresht
 — tabela testuese me dy rreshta
Mënyra e vargut table[0] mund të injorohet. Pasi e shqyrtova, nuk arrita të zbuloj të dhëna të papërpunuara nga tabelat. Në të vërtetë, ky bllok shërben për ruajtjen e indekseve dhe çelësave.
Duke filluar nga table[1] dhe duke e kaluar atë në një varg numerik, tashmë mund të vërehen disa rregulla, konkretisht:
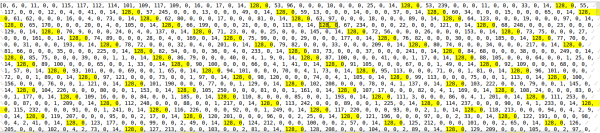
Këto janë vlera int të ruajtura në varg. Biti i parë tregon nëse numri është pozitiv apo negativ. Në rastin tim, të gjitha numrat janë pozitivë. Nga tre bitët e tjerë, mund të përcaktohet numri duke përdorur funksionin e mëposhtëm. Skripti:
def find_int(val: str):  # shembuj '128, 1, 2, 3'
    val = [int(v) për v në val.split(", ")]
    result_int = val[1]*256**2 + val[2]*256*1 + val[3]
    return result_int
Për shembull, 128, 0, 0, 1 = 1, ose 128, 0, 75, 108 = 19308.
Tabela kishte një çelës primar me autoincrement, dhe këtu mund të zbulohet gjithashtu.
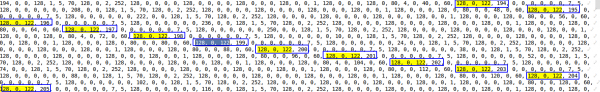
Duke përputhur të dhënat nga tabelat testuese, u zbulua se objekti DATETIME përbëhet nga 5 bite që fillojnë me 153 (këtu ndoshta tregon për intervalet e viteve). Duke e pasur parasysh se diapazoni DATTIME është ‘1000-01-01’ deri në ‘9999-12-31’, mendoj se numri i biteve mund të ndryshojë, por në rastin tim, të dhënat bien në intervalin nga 2016 deri në 2019, kështu që do të konsiderojmë se 5 bite janë të mjaftueshëm.
Për të përcaktuar kohën pa sekonda, janë shkruar funksionet e mëposhtme. Skripti:
day_ = lambda x: x % 64 // 2  # {x,x,X,x,x }

def hour_(x1, x2):  # {x,x,X1,X2,x}
    nëse x1 % 2 == 0:
        kthe x2 // 16
    elif x1 % 2 == 1:
        kthe x2 // 16 + 16
    tjetër:
        shkakto VlerëGabimi

min_ = lambda x1, x2: (x1 % 16) * 4 + (x2 // 64)  # {x,x,x,X1,X2}
Për vitin dhe muajin nuk arrita të shkruaj një funksion që të punojë siç duhet, prandaj m'u desh të përdor kod të ngurtë. Skripti:
ym_list = {'2016, 1': '153, 152, 64', '2016, 2': '153, 152, 128',
           '2016, 3': '153, 152, 192', '2016, 4': '153, 153, 0',
           '2016, 5': '153, 153, 64', '2016, 6': '153, 153, 128',
           '2016, 7': '153, 153, 192', '2016, 8': '153, 154, 0',
           '2016, 9': '153, 154, 64', '2016, 10': '153, 154, 128',
           '2016, 11': '153, 154, 192', '2016, 12': '153, 155, 0',
           '2017, 1': '153, 155, 128', '2017, 2': '153, 155, 192',
           '2017, 3': '153, 156, 0', '2017, 4': '153, 156, 64',
           '2017, 5': '153, 156, 128', '2017, 6': '153, 156, 192',
           '2017, 7': '153, 157, 0', '2017, 8': '153, 157, 64',
           '2017, 9': '153, 157, 128', '2017, 10': '153, 157, 192',
           '2017, 11': '153, 158, 0', '2017, 12': '153, 158, 64',
           '2018, 1': '153, 158, 192', '2018, 2': '153, 159, 0',
           '2018, 3': '153, 159, 64', '2018, 4': '153, 159, 128',
           '2018, 5': '153, 159, 192', '2018, 6': '153, 160, 0',
           '2018, 7': '153, 160, 64', '2018, 8': '153, 160, 128',
           '2018, 9': '153, 160, 192', '2018, 10': '153, 161, 0',
           '2018, 11': '153, 161, 64', '2018, 12': '153, 161, 128',
           '2019, 1': '153, 162, 0', '2019, 2': '153, 162, 64',
           '2019, 3': '153, 162, 128', '2019, 4': '153, 162, 192',
           '2019, 5': '153, 163, 0', '2019, 6': '153, 163, 64',
           '2019, 7': '153, 163, 128', '2019, 8': '153, 163, 192',
           '2019, 9': '153, 164, 0', '2019, 10': '153, 164, 64',
           '2019, 11': '153, 164, 128', '2019, 12': '153, 164, 192',
           '2020, 1': '153, 165, 64', '2020, 2': '153, 165, 128',
           '2020, 3': '153, 165, 192','2020, 4': '153, 166, 0',
           '2020, 5': '153, 166, 64', '2020, 6': '153, 1, 128',
           '2020, 7': '153, 166, 192', '2020, 8': '153, 167, 0',
           '2020, 9': '153, 167, 64','2020, 10': '153, 167, 128',
           '2020, 11': '153, 167, 192', '2020, 12': '153, 168, 0'}

def year_month(x1, x2):  # {x,X,X,x,x }

    for key, value in ym_list.items():
        key = [int(k) for k in key.replace("'", "").split(", ")]
        value = [int(v) for v in value.split(", ")]
        if x1 == value[1] and x2 // 64 == value[2] // 64:
            return key
    return 0, 0
Jam mendon, nëse kalon n për kohë, mund të rregullohet edhe ky keqkuptim.
Më pas, një funksion që kthen një objekt datetime nga një varg. Skripti:
def find_data_time(val: str):
    val = [int(v) for v in val.split(", ")]
    day = day_(val[2])
    hour = hour_(val[2], val[3])
    minutes = min_(val[3], val[4])
    year, month = year_month(val[1], val[2])
    return datetime(year, month, day, hour, minutes)
Arritëm të zbulonim vlera të përsëritura shpesh nga int, int, datetime, datetime 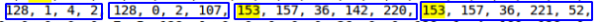 , duket se kjo është ajo që nevojitet. Dhe, ky rregullim nuk përsëritet dy herë për rresht.
Duke përdorur një shprehje të rregullt, gjejmë të dhënat e nevojshme:
fined = re.findall(r'128, d*, d*, d*, 128, d*, d*, d*, 153, 1[6,5,4,3]d, d*, d*, d*, 153, 1[6,5,4,3]d, d*, d*, d*', int_array)Vini re se, gjatë kërkimit me këtë shprehje, nuk do të mund të identifikoni vlerat NULL në fushat e kërkuara, por në rastin tim kjo nuk është kritike. Më pas, në cikël kalojmë atë që kemi gjetur. Skripti:
rezultati = []
per val në fined:
    pre_rezultati = []
    bd_int  = re.findall(r"128, d*, d*, d*", val)
    bd_date= re.findall(r"(153, 1[6,5,4,3]d, d*, d*, d*)", val)
    për it në bd_int:
        pre_rezultati.append(find_int(bd_int[it]))
    për bd në bd_date:
        pre_rezultati.append(find_data_time(bd))
    rezultati.append(pre_rezultati)
Përgjithësisht, të dhënat nga vargu rezultati, janë ato që na duhen. ###PS.###
E kuptoj që ky metodë nuk është e përshtatshme për të gjithë, por qëllimi kryesor i artikullit është më shumë të inkurajojë veprimin sesa të zgjidhë të gjitha problemet tuaja. Më duket se zgjidhja më e duhur do ishte të fillonit të studionit kodin burimor të vetë , por për shkak të kohës së kufizuar, metoda aktuale duket më e shpejtë.
Në disa raste, duke analizuar skedarin, do të jeni në gjendje të përcaktoni strukturën aproximative dhe të rikuperoni me njërën nga metodat standarde nga lidhjet e mësipërme. Kjo do të ishte shumë më e saktë dhe do të shkaktonte më pak probleme.
Burimi: habr.com
