

Përshëndetje të gjithëve. Miq, po ndajmë me ju përkthimin e një artikulli, të përgatitur veçanërisht për studentët e kursit . Le të fillojmë!
Apache Beam dhe DataFlow për pipeline të vërtetë në kohë reale
Postimi i sotëm bazohet në një detyrë që unë kam punuar së fundmi në punë. Ishte një kënaqësi e madhe ta realizoja dhe ta përshkruaja atë në formatin e një blogu, pasi më dha mundësinë të angazhohem me inxhinierimin e të dhënave dhe gjithashtu të bëj diçka që do të ishte shumë e dobishme për ekipin tim. Nuk ka shumë kohë që zbulova se sistemet tona ruanin një sasi të madhe logs përdoruesish, të lidhura me një nga produktet tona për punën me të dhënat. Doli se askush nuk e kishte përdorur këto të dhëna, prandaj qëndrova i interesuar për atë që do të mund të mësonim nëse do të fillonim t'i analizojmë ato në mënyrë të rregullt. Megjithatë, kishte disa probleme në rrugë. Problemi i parë ishte se të dhënat ishin të ruajtura në shumë skedarë të ndryshëm tekstualë, të cilët nuk ishin në dispozicion për analizën e menjëhershme. Problemi i dytë ishte se ato ishin ruajtur në një sistem të mbyllur, kështu që nuk mund të përdorja asnjë nga mjetet e mia të preferuara për analizën e të dhënave.
Duhej të vendosja se si ta bënim aksesin më të lehtë për ne dhe të sillnim ndonjë vlerë, duke integruar këtë burim të dhënash në disa nga zgjidhjet tona për angazhimin me përdoruesit. Pas një kohe reflektimi, vendosa të ndërtoja një pipeline për të transferuar këto të dhëna në një bazë të dhënash në облак, në mënyrë që unë dhe ekipi të kishim qasje në to dhe të fillonim të gjeneronim ndonjë përfundim. Pas përfundimit të specializimit në Inxhinierën e Të Dhënave në Coursera disa kohë më parë, isha shumë i etur të përdorja disa mjete nga kursi në projekt.
Kështu, ruajtja e të dhënave në një bazë të dhënash në cloud dukej si një mënyrë e arsyeshme për të zgjidhur problemin tim të parë, por çfarë mund të bëja për problemin numër 2? Për fat të mirë, kishte një mënyrë për të transferuar këto të dhëna në një mjedis ku mund të kisha qasje në mjete si Python dhe Google Cloud Platform (GCP). Megjithatë, ky ishte një proces i gjatë, prandaj duhej të bëja diçka që do të më lejonte të vazhdoja zhvillimin derisa të prisja përfundimin e transferimit të të dhënave. Zgjidhja që kam arritur ishte të krijoja të dhëna të falsifikuara duke përdorur bibliotekën Faker në Python. Nuk kisha përdorur kurrë këtë bibliotekë më parë, por shpejt kuptova se sa e dobishme është. Përdorimi i këtij qasja më lejoi të filloja të shkruaja kod dhe të testoja pipeline-in pa të dhëna të vërteta.
Duke marrë parasysh tashmë të thënë, në këtë postim do të flas për mënyrën sesi e ndërtova pipeline-in e përshkruar më sipër, duke përdorur disa nga teknologjitë e disponueshme në GCP. Në veçanti, do të përdor Apache Beam (versionin për Python), Dataflow, Pub/Sub dhe BigQuery për mbledhjen e log-eve të përdoruesve, transformimin e të dhënave dhe dërgimin e tyre në bazën e të dhënave për analizë të mëtejshme. Në rastin tim, më duhej vetëm funksionaliteti i paketave të Beam, pasi të dhënat e mia nuk vinin në kohë reale, prandaj Pub/Sub nuk ishte i nevojshëm. Megjithatë, do të ndalem në versionin e rrjedhës, pasi është ajo që mund të hasni në praktikë.
Hyrje në GCP dhe Apache Beam
Google Cloud Platform ofron një grup mjetesh shumë të dobishme për përpunimin e të dhënave të mëdha. Ja disa nga mjetet që do të përdor:
- është një shërbim mesazherësh që përdor modelin Publisher-Subscriber, i cili na lejon të marrim të dhëna në kohë reale.
- është një shërbim që e bën më të thjeshtë ndërtimin e pipeline-ve të të dhënave dhe zgjidh automatikisht detyra si skalimi i infrastrukturës, që do të thotë se mund të përqendrohemi vetëm në shkruan kodin për pipeline-in tonë.
- është një ruajtës i të dhënave në cloud. Nëse jeni të njohur me bazat e tjera të të dhënave SQL, me BigQuery nuk do të keni vështirësi të mëdha.
- Në fund, do të përdorim Apache Beam, duke u fokusuar në versionin Python për të krijuar tubimin tonë. Ky mjet do të na lejojë të krijojmë një tubim për përpunim në kohë reale ose me grumbull, i cili integrohet me GCP. Ai është veçanërisht i dobishëm për përpunimin paralel dhe është i përshtatshëm për detyra të tipit nxjerrje, transformim dhe ngarkim (ETL), kështu që, nëse na nevojitet të zhvendosim të dhënat nga një vend në një tjetër me transformime ose llogaritje, Beam është një zgjedhje e mirë.
Ka një gamë të gjerë mjetesh të disponueshme në GCP, kështu që mund të jetë e vështirë të ndjekësh të gjitha ato dhe çfarësh përdorimi ka secili, por ja një përmbledhje e tyre për referencë.
Në GCP është në dispozicion një numër i madh mjetesh, kështu që mund të jetë e vështirë t'i mbulosh të gjitha, duke përfshirë qëllimin e tyre, megjithatë, një përmbledhje për referencë.
Vizualizimi i tubimit tonë
Le të vizualizojmë komponentët e tubimit tonë në figura 1. Në një nivel të lartë, ne duam të mbledhim të dhënat e përdoruesve në kohë reale, t'i përpunojmë ato dhe t'i transferojmë në BigQuery. Kjo logaritet kur përdoruesit ndërveprojnë me produktin, duke dërguar kërkesa në server, të cilat pastaj logohen. Këto të dhëna mund të jenë veçanërisht të dobishme për të kuptuar se si përdoruesit ndërveprojnë me produktin tonë dhe nëse ai funksionon siç duhet. Përgjithësisht, tubimi do të përmbajë këto faza:
Beam e bën këtë proces shumë të thjeshtë, pavarësisht nga ajo nëse kemi një burim të dhënash në kohë reale ose një skedë CSV, dhe ne duam të kryejmë përpunim në grumbull. Më vonë do të shihni se kodi ka vetëm ndryshime minimale të nevojshme për të kaluar mes tyre. Ky është një nga përfitimet e përdorimit të Beam.
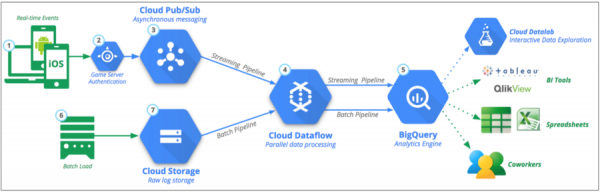
Figura 1: Tubimi kryesor i të dhënave: Burimi:
Krijimi i të dhënave të rreme duke përdorur Faker
Siç e përmenda më parë, për shkak të qasjes së kufizuar në të dhëna, vendosa të krijoj të dhëna të rreme në të njëjtin format si ato reale. Ky ishte një ushtrim shumë i dobishëm, pasi mund të shkruaj kodin dhe të provoj tubimin, ndërkohë që prisja të dhënat. Le të shikojmë në Faker, nëse dëshironi të dini se çfarë tjetër mund të ofrojë kjo bibliotekë. Të dhënat tona të përdoruesve do të ngjajnë në përgjithësi me shembullin më poshtë. Duke u bazuar në këtë format, ne mund të gjenerojmë të dhëna rresht më rresht për të imituar të dhëna në kohë reale. Këto regjistrime na japin informacione si data, lloji i kërkesës, përgjigjja nga serveri, adresa IP etj.
192.52.197.161 - - [30/Apr/2019:21:11:42] "PUT /tag/category/tag HTTP/1.1" [401] 155 "https://harris-lopez.com/categories/about/" "Mozilla/5.0 (Macintosh; PPC Mac OS X 10_11_2) AppleWebKit/5312 (KHTML, like Gecko) Chrome/34.0.855.0 Safari/5312"
Duke u bazuar në rreshtin më sipër, ne duam të krijojmë variablin tonë LINE, duke përdorur 7 variabla në kllapa më poshtë. Ne gjithashtu do t'i përdorim ato si emra variablash në strukturën tonë të tabelave pak më vonë.
LINJA = """
 {remote_addr} - - [{time_local}] "{request_type} {request_path} HTTP/1.1" [{status}] {body_bytes_sent} "{http_referer}" "{http_user_agent}"
 """
Nëse do të ishim duke kryer përpunim masiv, kodi do të ishte shumë i ngjashëm, megjithatë do të na duhej të krijonim një grup mostrash brenda një intervali temporal. Për të përdorur faker, thjesht krijojmë një objekt dhe thërrasim metodat që na duhen. Në veçanti, Faker ishte e dobishme për të krijuar adresa IP dhe gjithashtu faqe interneti. Kam përdorur metodat e mëposhtme:
fake.ipv4()
 fake.uri_path()
 fake.uri()
 fake.user_agent()
from faker import Faker
import time
import random
import os
import numpy as np
from datetime import datetime, timedelta


LINE = """
{remote_addr} - - [{time_local}] "{request_type} {request_path} HTTP/1.1" [{status}] {body_bytes_sent} "{http_referer}" "{http_user_agent}"
"""


def generate_log_line():
    fake = Faker()
    now = datetime.now()
    remote_addr = fake.ipv4()
    time_local = now.strftime('%d/%b/%Y:%H:%M:%S')
    request_type = random.choice(["GET", "POST", "PUT"])
    request_path = "/" + fake.uri_path()

    status = np.random.choice([200, 401, 404], p = [0.9, 0.05, 0.05])
    body_bytes_sent = random.choice(range(5, 1000, 1))
    http_referer = fake.uri()
    http_user_agent = fake.user_agent()

    log_line = LINE.format(
        remote_addr=remote_addr,
        time_local=time_local,
        request_type=request_type,
        request_path=request_path,
        status=status,
        body_bytes_sent=body_bytes_sent,
        http_referer=http_referer,
        http_user_agent=http_user_agent
    )

    return log_line
Krahu i parë është përfunduar.
Në ditët në vijim do të ndajmë me ju vazhdimin e artikullit, ndërkohë që tradicionalisht presim komentet tuaja ;-).
Burimi: habr.com
