

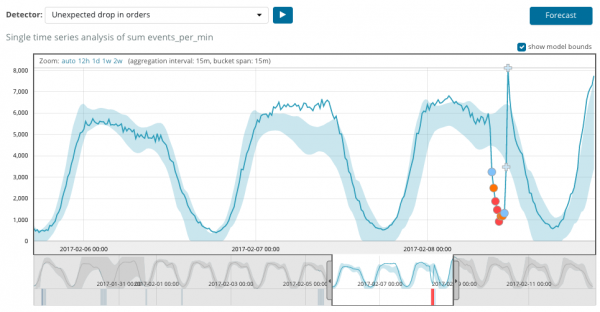
Kujtojmë se Elastic Stack bazohet në një bazë të dhënash jo-relacionale Elasticsearch, një ndërfaqe në internet Kibana dhe ndërlidhës-dhënës (më i njohur Logstash, Beats të ndryshme, APM dhe të tjera). Një prej shtesave të këndshme të gjithë këtij rrjeti produktesh është analiza e të dhënave me ndihmën e algoritmeve të mësimit makinerik. Në këtë artikull, ne shqyrtojmë se çfarë përfaqësojnë këto algoritme. Ju lutemi, lexoni më tej.
Mësimi makinerik është një funksion me pagesë i Elastic Stack dhe përfshihet në paketën X-Pack. Për të filluar ta përdorni, mjafton pas instalimit të aktivizoni një provë 30-ditore. Pas skadimit të periudhës së provës, mund të kërkoni mbështetje për zgatjen e saj ose të blini një abonim. Çmimi i abonimit nuk llogaritet sipas sasisë së të dhënave, por sipas numrit të nyjeve të përdorura. Po, sasia e të dhënave natyrisht ndikon në numrin e nyjeve të nevojshme, por ende ky qasje për licencimin është më humane ndaj buxhetit të kompanisë. Nëse nuk keni nevojë për performancë të lartë, mund të kurseni.
ML në Elastic Stack është shkruar në C++ dhe funksionon jashtë JVM, në të cilën funksionon vetë Elasticsearch. Kështu që procesi (ai është quajtur autodetect) konsumon gjithçka që JVM nuk e përpunon. Në një demonstrim kjo nuk është kaq kritike, por në një ambient prodhimi është e rëndësishme të ndahen nyje të veçanta për detyrat ML.
Algoritmet e mësimit makinerik ndahen në dy kategori — dhe . Në Elastic Stack algoritmi është nga kategoria "pa mbikëqyrje". Me mund të shihni aparatin matematikor të algoritmeve të mësimit makinerik.
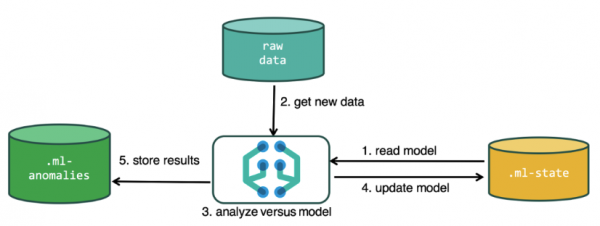
Për të kryer analizën, algoritmi i mësimit makinerik përdor të dhënat e ruajtura në indekset Elasticsearch. Të dhëna për analizë mund të krijohen si nga ndërfaqja Kibana ashtu edhe përmes API-së. Nëse e bëni këtë përmes Kibana-s, disa gjëra nuk është e nevojshme të dihen. Për shembull, indekset shtesë që përdor algoritmi gjatë punës së tij.
Indeksat shtesë të përdorur gjatë procesit të analizës.ml-state — informacion mbi modelet statistikore (caktimet e analizës);
.ml-anomalies-* — rezultatet e punës së algoritmeve ML;
.ml-notifications — caktimet e njoftimeve mbi rezultatet e analizës.
Struktura e dhënash në bazën Elasticsearch përbëhet nga indekse dhe dokumentet që ruhen në to. Nëse e krahasojmë me një bazë të dhënash relationale, indeksi mund të krahasohet me skemën e bazës së të dhënave, ndërsa dokumenti me një rekord në tabelë. Ky krahasim është i kushtëzuar dhe është dhënë për të thjeshtuar kuptimin e materialeve të mëtejshme për ata që kanë dëgjuar vetëm për Elasticsearch.
Përmes API-së është i aksesueshëm të njëjtin funksionalitet si përmes ndërfaqes web, prandaj për qartësi dhe kuptimin e koncepteve ne do të tregojmë se si të konfigurojmë përmes Kibana. Në menunë e majtë ekziston seksioni Machine Learning, në të cilin mund të krijoni një detyrë të re (Job). Në ndërfaqen Kibana kjo duket si në imazhin më poshtë. Tani do të shqyrtojmë çdo lloj detyre dhe do të tregojmë llojet e analizës që mund të krijoni këtu.
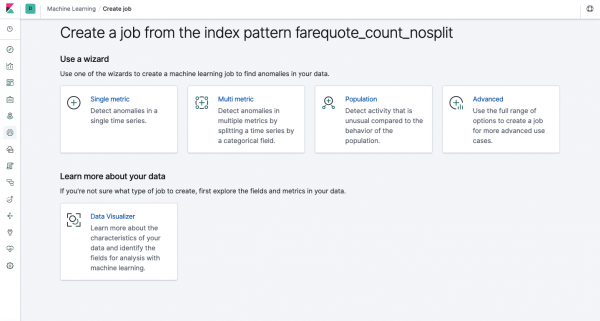
Single Metric — analiza e një metri, Multi Metric — analiza e dy apo më shumë metrikeve. Në të dy rastet, çdo metrikë analizohet në një ambient të izoluar, dmth. algoritmi nuk merr parasysh sjelljen e metrikeve që shqyrtohen paralelisht ashtu siç mund të dukej në rastin e Multi Metric. Për të kryer llogaritjen duke marrë parasysh korrelacionin e metrikeve të ndryshme, mund të aplikoni analizën e Popullatës. Dhe Advanced — është cilësimi i imët i algoritmeve me opsione shtesë për detyra të caktuara.
Single Metric
Analiza e ndryshimeve të një metri të vetme — është gjëja më e thjeshtë që mund të bëni këtu. Pasi të klikoni Create Job, algoritmi do të kërkojë anomali.
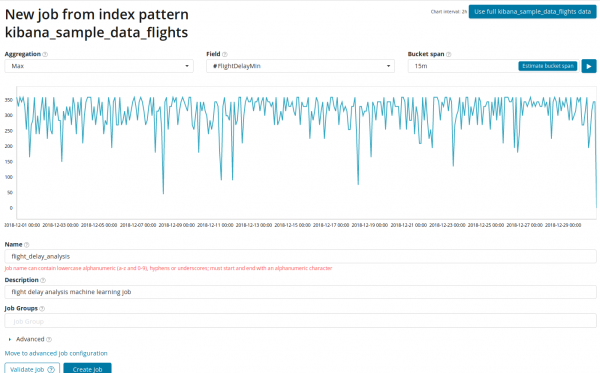
Në fushën Agregimi mund të zgjidhni qasjen për të gjetur anomali. Për shembull, kur Min do të konsiderohen si anomali vlerat nën ato tipike. Ka Max, Hign Mean, Low, Mean, Distinct dhe të tjera. Përshkrimi i të gjitha funksioneve mund të shihet .
Në fushën Fusha tregon fushën numerike në dokument, mbi të cilën do ta realizojmë analizën.
Në fushën — granulariteti i intervaleve në kohëlinë, mbi të cilat do të bëhet analiza. Mund t’i besoni automatizimit ose ta zgjidhni manualisht. Në imazhin më poshtë është dhënë një shembuj i granularitetit të ulët — mund të humbni një anomali. Me anë të këtij cilësimi mund të ndryshoni ndjeshmërinë e algoritmit ndaj anomali.
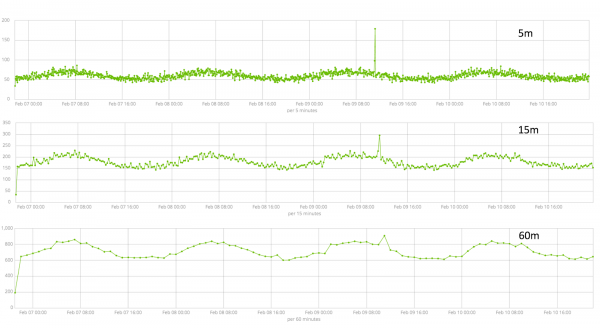
Kohëzgjatja e të dhënave të mbledhura — është çështje kyçe, e cila ndikon në efikasitetin e analizës. Gjatë analizës, algoritmi përcakton intervalet e përsëritura, llogarit intervalin e besueshmërisë (bazat e linjës) dhe identifikon anomali — devijime të pazakonshme nga sjellja e zakonshme e metrikeve. Thjesht për shembull:
Bazat përkatëse për një sasi të vogël të dhënash:
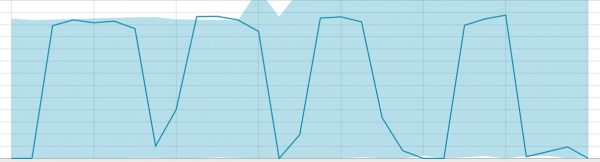
Kur algoritmi ka për të mësuar diçka - bazat duken kështu:
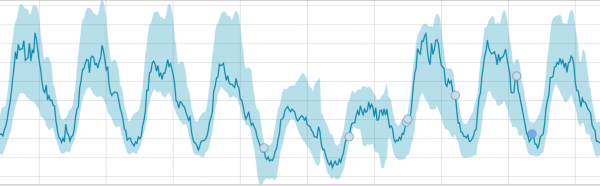
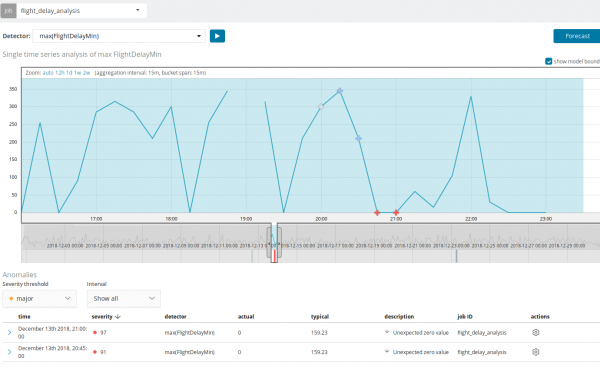
Pas fillimit të detyrës, algoritmi përcakton devijimet anomale nga norma dhe i rendit ato sipas probabilitetit të anomalisë (në kllapa është treguar ngjyra e etiketës përkatëse):
Warning (blu): më pak se 25
Minor (e verdhë): 25-50
Major (portokalli): 50-75
Critical (e kuqe): 75-100
Në grafikën më poshtë është një shembull me anomali të gjetura.
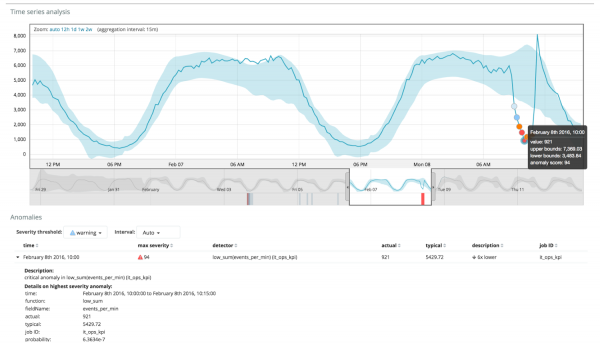
Këtu shihet numri 94, i cili tregon probabilitetin e anomalisë. Kuptohet se, pasi vlera është afër 100, kemi një anomalie. Në kolonën nën grafik është shfaqur një probabilitet ekstremisht i vogël prej 0.000063634% për shfaqjen e atij vlerë metriç.
Përveç gjetjes së anomalive, në Kibana mund të filloni parashikimin. Kjo bëhet lehtësisht dhe nga e njëjta pamje me anomali - butoni Forecast në këndin e sipërm të djathtë.
Parashikimi ndërtomaximumi në 8 javët e ardhshme. Edhe nëse dëshiron shumë - nuk lejohet më shumë për arsye dizajni.
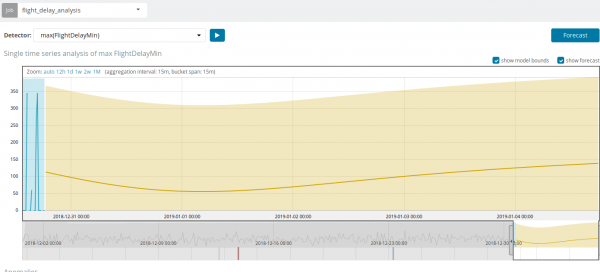
Në disa situata parashikimi do të jetë shumë i dobishëm, për shembull, kur ndiqet ngarkesa e përdoruesve në infrastrukturë.
Multi Metric
Kalojmë te mundësia tjetër e ML në Elastic Stack - analiza e disa metrikave në një grup. Por kjo nuk do të thotë se do të analizohet varësia e një metrike nga tjetra. Kjo është e njëjtë si Single Metric, vetëm me shumë metrika në një ekran për lehtësinë e krahasimit të ndikimit të njëra mbi tjetrën. Për analizën e varësisë së një metrike nga njëra tjetra, do të flasim në pjesën Population.
Pas klikimit në katrorin e Multi Metric do të shfaqet një dritare me cilësimet. Ne do të ndalemi më në detaje mbi to.
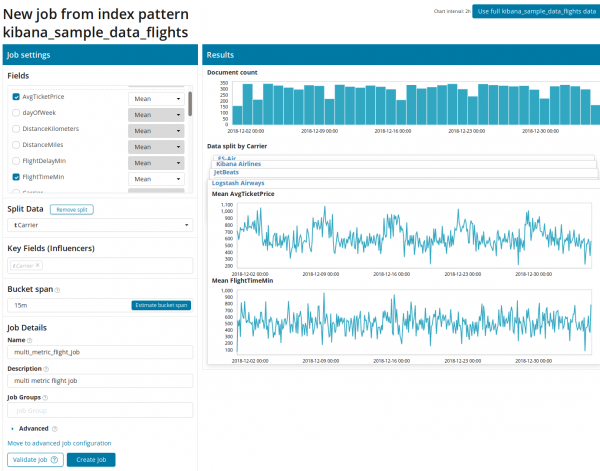
Fillimisht duhet zgjedhur fushat për analizë dhe agregimin e të dhënave mbi to. Opcione të agregimit këtu janë të njëjtat si për Single Metric (Max, Hign Mean, Low, Mean, Distinct dhe të tjera). Më pas, të dhënat, nëse dëshirohet, ndahen sipas njërit prej fushave (fusha Split Data). Në shembullin tonë, e kemi bërë për fushën OriginAirportID. Vini re se tani grafiku i metrikave në të djathtë është paraqitur në formën e shumë grafikëve.
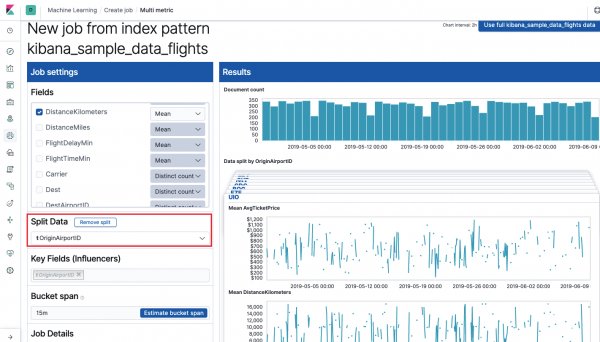
Fusha Key Fields (Influencers) ndikon drejtpërdrejt në anomali të gjetura. Nga ana tjetër, gjithmonë do të ketë të paktën një vlerë këtu, dhe ju mund të shtoni të tjera. Algoritmi do të ketë parasysh ndikimin e këtyre fushave gjatë analizës dhe do të tregojë vlerat më "ndikues".
Pas fillimit, në ndërfaqen e Kibana do të duket afërsisht kështu.
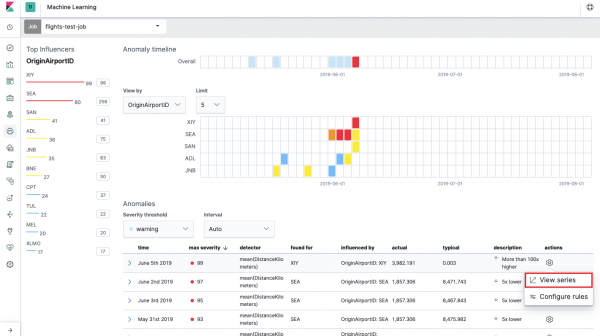
Kjo është një hartë nxehtësie e anomaliëve për secilën vlerë të fushës OriginAirportID, e cila është treguar nga ne. Split Data. Si në rastin e Single Metric, ngjyra tregon nivelin e devijimit anormal. Një analizë e ngjashme është e dobishme, për shembull, për stacionet e punës për të ndjekur ato, ku ka shumë autorizime të dyshimta, etj. Ne kemi shkruar tashmë , të cilat gjithashtu mund të mblidhen dhe analizohen këtu.
Nën hartën termike, lista e anomali, nga çdo një mund të kaloni në pamjen e Single Metric për analizë të detajuar.
Popullsia
Për të kërkuar anomali në mes të korelacioneve midis metrikave të ndryshme në Elastic Stack, ekziston analiza e specializuar të Popullsisë. Me anë të saj, mund të kërkoni vlera anormale në performancën e ndonjë serveri në krahasim me të tjerët në rast se, për shembull, rritet numri i kërkesave në sistemin e synuar.
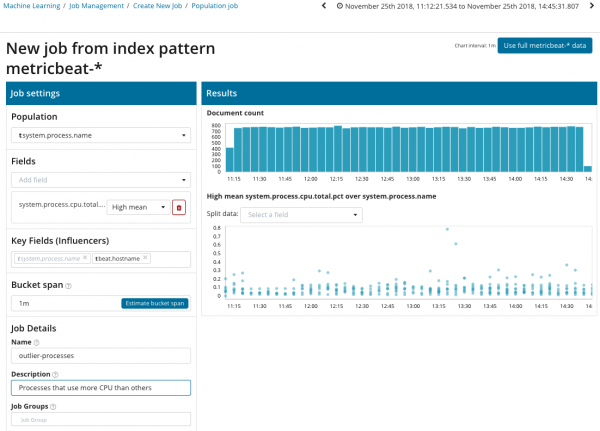
Në këtë ilustrim, në fushën e Popullsisë është treguar vlera, ndaj së cilës do t'i referohemi metrikave që po analizohet. Në këtë rast, është emri i procesit. Si rezultat, do të shohim si ngarkesa e procesorit nga secili nga proceset ka ndikuar në njëri-tjetrin.
Vini re se grafiku i të dhënave të analizuar është ndryshe nga rastet me Single Metric dhe Multi Metric. Kjo është bërë në Kibana me qëllim për një perceptim më të mirë të shpërndarjes së vlerave të të dhënave të analizuar.
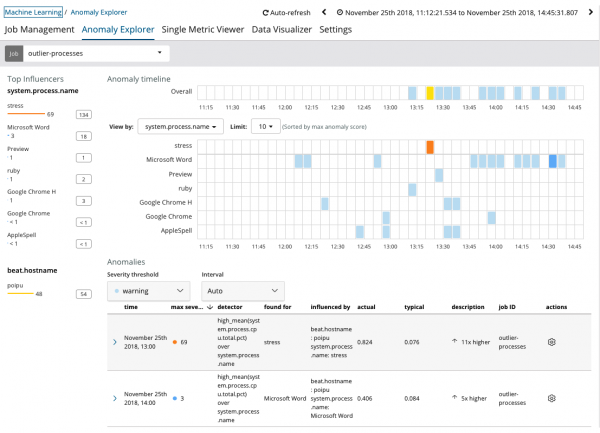
Nga grafiku, duket se procesi ka sjellë anomali stress (për ta thënë, i krijuar nga një utilitar të veçantë) në serverin poipu, i cili ndihmoi (ose ishte influenceri) në shfaqjen e kësaj anomie.
Të avancuara
Analitika me cilësi të lartë. Gjatë analizës së avancuar në Kibana, shfaqen cilësime të tjera. Pas klikimit në menunë e krijimit në pllakën Advanced shfaqet ky dritare me skeda. Skedën Detajet e Punës e kemi lënë të kaluar qëllimisht, pasi aty ka cilësime bazike që nuk lidhen drejtpërdrejt me cilësimin e analizës.
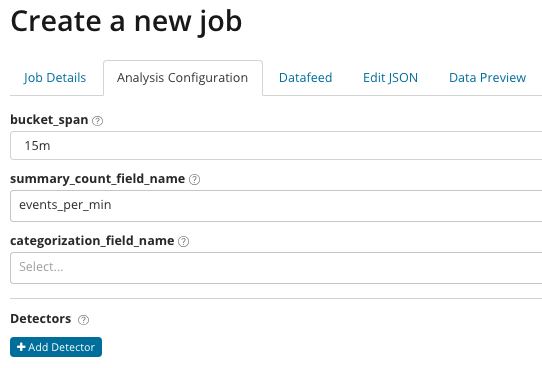
Në emri_fushës_së_përmbledhjes mund të specifikohet opsionalisht emri i fushës nga dokumentet që përmban vlerat e agreguara. Në këtë rast — numri i ngjarjeve për minutë. Në specifikohet emri i vlerës së fushës nga dokumenti, i cili përmban një vlerë të caktuar. Sipas maskës së kësaj fushe, mund të ndajmë të dhënat e analizuar në nëngrupe. Vini re butonin Shto detektor në ilustrimin e mëparshëm. Më poshtë është rezultati i klikimit në këtë buton.
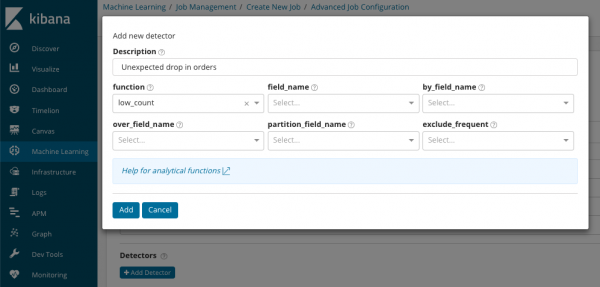
Këtu është një bllok shtesë cilësimesh për të konfigurimin e detektorëve të anomalisë për një detyrë të caktuar. Raste specifike përdorimi (veçanërisht për sigurinë) ne planifikojmë t'i shqyrtojmë në artikujt e ardhshëm. Si shembull, një nga rastet e shqyrtuara. Ai lidhet me gjetjen e vlerave që shfaqen rrallë dhe realizohet .
Në fushën function mund të zgjidhet një funksion i caktuar për gjetjen e anomalisë. Përveç rare, ka edhe disa funksione interesante të tjera — . Ato zbulojnë anomali në sjelljen e metrike gjatë ditës ose javës përkatësisht. Funksionet e tjera të analizës .
Në field_name specifikon fushën e dokumentit, sipas së cilës do të bëhet analiza. By_field_name mund të përdoret për ndarjen e rezultateve të analizës sipas çdo vlere të veçantë të fushës së dokumentit të specifikuar këtu. Nëse mbushni over_field_name do të rezultojë në një analizë populacioni, të cilin ne e shqyrtuam më lart. Nëse specifikoni një vlerë në partition_field_name, atëherë për këtë fushë dokumenti do të llogariten bazat e veçanta për çdo vlerë (si vlerë mund të shërbejë, për shembull, emri i serverit ose procesit në server). Në exclude_frequent mund të zgjidhet të gjitha ose none, që do të thotë përjashtim (ose përfshirje) e vlerave të shpeshta të fushave të dokumenteve.
Në këtë artikull përpiqem t'i ofrojmë një pasqyrë të shkurtuar të mundësive të mësimit automatik në Elastic Stack, ka ende shumë detaje pas skenës. Na tregoni në komentet se cilat raste arritët t'i zgjidhni me ndihmën e Elastic Stack dhe për cilat detyra e përdorni. Për të na kontaktuar, mund të përdorni mesazhe personale në Habrë ose .
Burimi: habr.com
