

Së fundi doli , e cila tregon mirë tendencat në mësimin makinerik të viteve të fundit. Nëse flasim shkurt: numri i startup-eve në fushën e mësimit makinerik ka rënë ndjeshëm gjatë dy viteve të fundit.
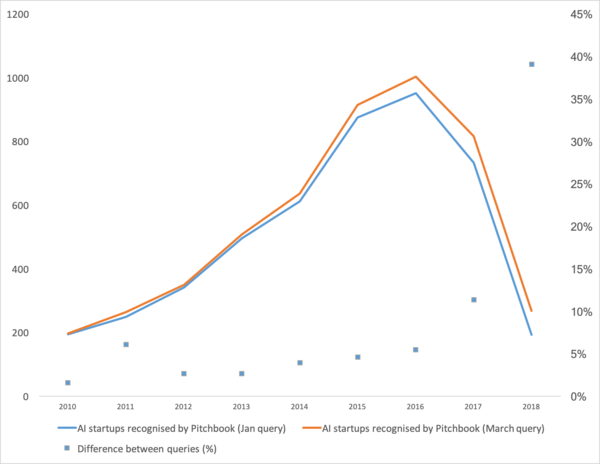
E para, le të shqyrtojmë nëse ‘burrat e bubullimës’ u rrezikuan, ‘si të jetojmë më tej’ dhe të flasim për nga erdhi fare kjo situatë.
Për të filluar, le të flasim për atë që ishte burimi i kësaj curve. Nga erdhi ajo. Sigurisht që të gjithë do të kujtojnë e mësimit makinerik në vitin 2012 në konkursin ImageNet. Sepse ky është ngjarja e parë globale! Por në të vërtetë nuk është kështu. Po ashtu, rritja e kësaj curve fillon disa vite më parë. Do ta ndaja atë në disa momente.
- Viti 2008 shënon shfaqjen e termit “të dhënat e mëdha”. Produktet reale filluan nga viti 2010. Të dhënat e mëdha janë ngushtësisht të lidhura me mësimin makinerik. Pa të dhëna të mëdha, funksionimi stabil i algoritmeve që ekzistonin atëherë nuk ishte i mundur. Dhe këto nuk ishin rrjete neuronale. Deri në vitin 2012, rrjetet neuronale ishin një privilegj i një pakice margjinale. Megjithatë, atëherë filluan të punonin algoritme krejt të ndryshme, të cilat kishin ekzistuar për vite, madje për dekada: (1963, 1993), (1995), (2003),... Startupet e viteve ato ishin më së shumti të lidhura me përpunimin automatik të të dhënave të strukturuara: kasa, përdoruesit, reklamat, shumë të tjera.
Përderisa kjo ishte vala e parë, një grup framework-e, si XGBoost, CatBoost, LightGBM, etj.
- Në vitet 2011-2012 fituan disa konkurse për njohjen e imazheve. Përdorimi i tyre real zgjati paksa. Do të thoja që startup-et dhe zgjidhjet e kuptueshme masivisht filluan të shfaqeshin nga viti 2014. Nevojiteshin dy vjet për të kuptuar se rrjetet neuronale në të vërtetë funksiononin, për të krijuar framework-e komod që mund të vendoseshin dhe aktivizoheshin brenda një kohe të arsyeshme, për të zhvilluar metoda që do të stabilizonin dhe përshpejtonin kohën e konvergjencës.
Rrjetet konvencionale lejuan zgjidhjen e problemeve të vizionit makinerik: klasifikimi i imazheve dhe objekteve në imazh, zbulimi i objekteve, njohja e objekteve dhe njerëzve, përmirësimi i imazheve, etj., etj.
- Viti 2015-2017. Boom i algoritmeve dhe projekteve të lidhura me rrjetet recurrence ose variants e tyre (LSTM, GRU, TransformerNet, etj.). U shfaqën algoritme që funksiononin mirë për "folje në tekst", sisteme për përkthimin automatik. Disa prej tyre bazohen në rrjetet konvolucionale për të nxjerrë karakteristikat themelore. Disa janë rezultat i aftësisë për të mbledhur së bashku dataset-e reale të mëdha dhe të mira.
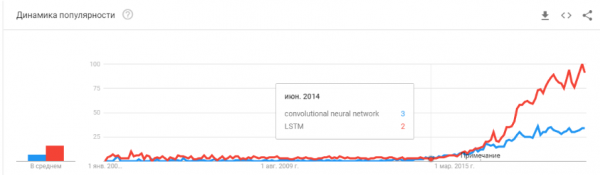
"A shpërtheu flluska? A është hype i tepërt? A vdiqën si blockchain?"
Sigurisht! Nesër në telefonin tuaj nuk do të funksionojë Siri, dhe pasnesër Tesla nuk do ta dallojë kthesën nga një kengur.
Rrjetet neuronale janë tashmë në funksionim. Ato janë në dhjetëra pajisje. Realisht ato lejojnë fitime, ndryshojnë tregun dhe botën përreth. Hype duket disi ndryshe:
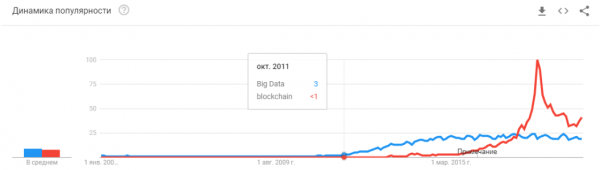
Simple, rrjetet neuronale kanë ndaluar së qeni diçka e re. Po, shumë njerëz kanë pritshmëri të tepruara. Por numri i madh i kompanive ka mësuar se si të aplikojnë rrjetet neuronale në produktet e tyre. Rrjetet neuronale ofrojnë funksionalitete të reja, reduktojnë vendet e punës, ulin çmimin e shërbimeve:
- Kompanitë prodhuese integrojnë algoritme për analizën e defekteve në linjat e prodhimit.
- Fermerët blejnë sisteme për monitorimin e lopëve.
- Kombajnerë automatikë.
- Qendra telefonske automatizuar.
- Filtra në SnapChat. (po të paktën diçka e dobishme!)
Por e rëndësishmja, dhe jo aq e qartë: "Nuk ka më ide të reja, ose ato nuk do të sjellin kapital të menjëhershëm." Rrjetet neuronale kanë zgjidhur dhjetëra probleme. Dhe do të zgjidhin edhe më shumë. Të gjitha idetë e dukshme që ishin - sollën një mori start-up-esh. Por gjithçka që ishte në sipërfaqe - është tashmë mbledhur. Në dy vitet e fundit nuk kam takuar asnjë ide të re për aplikimin e rrjeteve neuronale. Asnjë qasje të re (po, në rregull, ka disa probleme me GAN-at).
Dhe çdo start-up tjetër bëhet gjithnjë e më i komplikuar. Ai kërkon jo vetëm dy djem që e trajnojnë rrjetin neural me të dhëna të hapura. Ai kërkon programues, serverë, një ekip etiketuesish, mbështetje të komplikuar, etj.
Si rezultat — numri i start-up-eve po zvogëlohet. Ndërkohë, prodhimi po rritet. Duhet të implementoni njohjen e numrave të automjeteve? Në treg janë qindra specialistë me përvojë përkatëse. Mund të angazhoni dhe pas disa muajsh punonjësi juaj do të krijojë sistemin. Ose të blini një të gatshme. Por të bëni një start-up të ri?.. Është një marrëzi!
Duhet të krijoni një sistem ndjekjeje të vizitorëve — pse të paguani për shumë licenca kur mund të krijoni një tuajin, të përgatitur për biznesin tuaj, brenda 3-4 muajsh.
Aktualisht, rrjetet neurale po kalojnë të njëjtin rrugë si shumë teknologji të tjera.
A e mbani mend se si ndryshoi koncepti i 'zhvilluesit të faqeve' që nga viti 1995? Deri tani, tregu nuk është mbushur me specialistë. Ka shumë pak profesionistë. Por mund të spekulojmë se pas 5-10 vjetësh nuk do të ketë ndonjë dallim të veçantë mes një programuesi Java dhe një zhvilluesi të rrjeteve neurale. Të dyja profesione do të jenë të pranishme në treg.
Thjesht do të ketë një klasë detyrash për të cilat do të përdoren rrjetet neurale. Nëse shfaqet një detyrë — angazhoni një specialist.
“Çfarë ndodh më pas? Ku është inteligjenca artificiale e premtuar?”
Këtu ka një paqartësi të vogël, por interesante :)
Ajo teknikë teknologjish që kemi sot, duket se nuk na çon në inteligjencën artificiale. Idetë, rinovimi i tyre — në masë të madhe i kanë shteruar. Le të flasim për atë që mban aktualisht nivelin e zhvillimit.
Kufizimet
Le të fillojmë me automjetet pa pilot. Duket se është e qartë se ndërtimi i automjeteve plotësisht autonom, me teknologjitë e sotme — është i mundur. Por pas sa vitesh do të ndodhë kjo — nuk është e qartë. Tesla beson se do të ndodhë brenda disa viteve —
Ka shumë ekspertë të tjerë , që e vlerësojnë këtë si 5-10 vjet.
Sipas mendimit tim, shumë tërësisht, pas 15 vjetësh infrastrukturat e qyteteve do të ndryshojnë vetvetiu, të bëjnë që shfaqja e automjeteve autonome të bëhet e pashmangshme, e bërë pjesë e saj. Por kjo nuk mund të konsiderohet si inteligjencë. Tesla moderne — është një linjë shumë komplekse për filtrimin e të dhënave, kërkimin e tyre dhe ri-mësimin. Këto janë rregulla-rregulla-rregulla, mbledhje të të dhënave dhe filtra mbi to (ja kam shkruar pak më shumë për këtë, ose mund të shihni me shënimin).
Problemi i parë
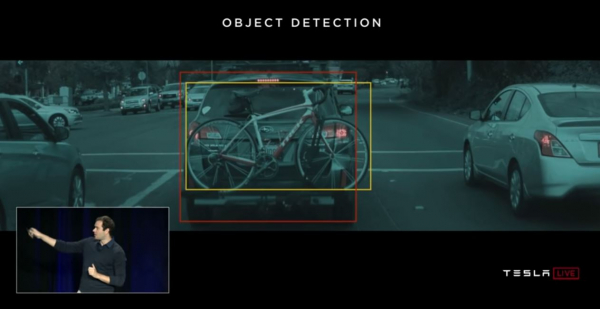
Dhe pikërisht këtu shohim problemin e parë themelor. Të dhënat e mëdha. Kjo është pikërisht ajo që shkaktoi valën aktuale të rrjeteve neuronale dhe mësimit të makinerive. Tani, për të bërë diçka komplekse dhe automatike, nevojiten shumë të dhëna. Jo vetëm shumë, por shumë shumë. Nevojiten algoritme automatizimi për grumbullimin, etiketimin dhe përdorimin e tyre. Nëse dëshirojmë që makina të shohë kamionët ndaj diellit — duhet së pari të grumbullojmë një numër të mjaftueshëm të tyre. Nëse dëshirojmë që makina të mos çmendet nga një biçikletë e lidhur me bagazhin — nevojiten më shumë mostra.
Madje një shembull nuk mjafton. Qindra? Mijëra?
Problemi i dytë
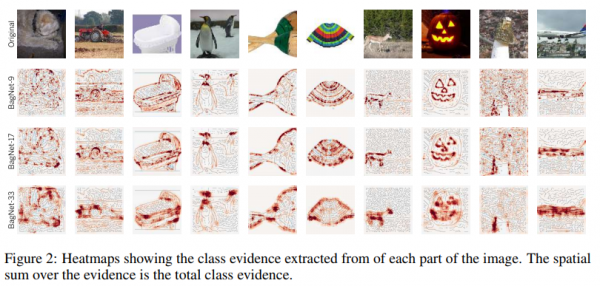
Problemi i dytë — vizualizimi i asaj që rrjeti ynë neuronale kupton. Kjo është një detyrë shumë e komplikuar. Edhe sot pak kush e kupton se si ta vizualizojë. Këto artikuj janë shumë të rinj, këto janë vetëm disa shembuj, edhe pse të largët:
përsëritjes mbi tekstura. Tregon mirë për çfarë i pëlqen rrjetit të përqendrohet + çfarë e percepton si informacion fillestar.
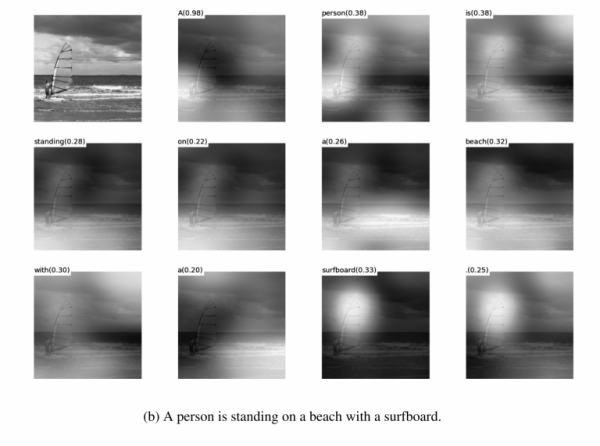
vëmendje gjatë . Realisht, vëmendja shpesh mund të përdoret pikërisht për të treguar se çfarë shkaktoi një reagim të tillë në rrjet. Kam parë këto gjëra si për debugging ashtu edhe për zgjidhje produkti. Ka shumë artikuj në këtë temë. Por sa më të komplikuara të jenë të dhënat, aq më e vështirë është të kuptosh se si të arrish një vizualizim të qëndrueshëm.
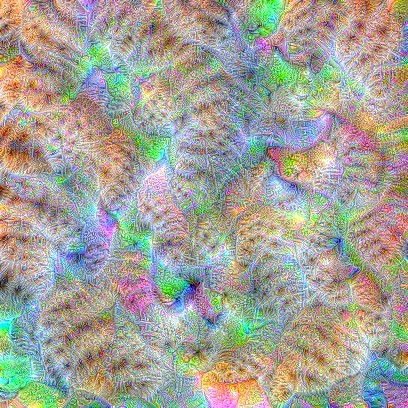
Po ashtu, ajo e vjetër e "shiko çfarë ka brenda rrjetit në ". Këto imazhe ishin të njohura për 3-4 vjet, por të gjithë e kuptuan shpejt se këto imazhe ishin të bukura, por pak kuptim kishin.
Nuk përmenda dhjetra të tjera truke, metoda, hakerë, kërkime mbi se si të shfaqësh brendësinë e rrjetit. A funksionojnë këto mjete? A ndihmojnë ato të kuptosh shpejt se çfarë është problemi dhe të debugosh rrjetin?.. Të nxjerrësh përqindjet e fundit? Po, më pak më kështu:
Mund të shikosh çdo konkurs në Kaggle. Dhe përshkrimin se si njerëzit bëjnë zgjidhjet përfundimtare. Kemi mbledhur 100-500-800 milion modele dhe ajo funksionoi!
Sigurisht, po e teproj. Por këto qasje nuk ofrojnë përgjigje të shpejta dhe të drejtpërdrejta.
Duke pasur mjaft përvojë, duke provuar variante të ndryshme, mund të japësh një verdikt mbi arsyen pse sistemi yt mori një vendim të tillë. Por të korrigjosh sjelljen e sistemit do të jetë e vështirë. Të vendosësh një ndihmë, të rregullosh pragun, të shtosh një dataset, të marrësh një rrjet tjetër backend.
Problemi i tretë
Problemi i tretë themelor — rrjetet mësojnë jo logjikën, por statistikat. Statistikisht, kjo është :
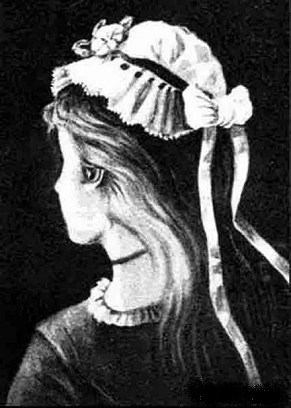
Logjikisht — nuk duket shumë e ngjashme. Rrjetet nervore nuk mësojnë diçka komplekse përveç nëse e detyrohen. Ato gjithmonë mësojnë karakteristikat maksimale të thjeshta. A ka sy, hundë, kokë? Atëherë është fytyrë! Ose jepni një shembull ku sytë nuk do të thonin fytyrë. Dhe përsëri — miliona shembuj.
Ka shumë hapësirë poshtë
Do të thosha se këto tri probleme globale po kufizojnë zhvillimin e rrjeteve nervore dhe mësimit të makinave. Dhe aty ku këto probleme nuk e kufizuan — tashmë po përdoren aktivisht.
A është ky fundi? Rrjetet nervore u ndalën?
Nuk dihet. Por, sigurisht, të gjithë shpresojnë që jo.
Ka shumë qasje dhe drejtime për zgjidhjen e atyre problemeve themelore që i përmenda më lart. Por deri tani asnjë nga këto qasje nuk ka lejuar të bëjë diçka themelore të re, të zgjidhë diçka që ende nuk është zgjidhur. Deri tani, projektet themelore bëhen mbi baza të qëndrueshme (Tesla), ose mbeten projekte testuese të institucioneve ose korporatave (Google Brain, OpenAI).
Nëse flasim në terma të përgjithshëm, drejtimi kryesor është krijimi i një përfaqësimi të lartë të të dhënave hyrëse. Në një kuptim të caktë, “memorie”. Shembulli më i thjeshtë i memories është përfaqësimet e ndryshme “Embedding” — përfaqësimet e imazheve. Për shembull, të gjitha sistemet e njohjes së fytyrave. Rrjeti mëson të marrë nga fytyra një përfaqësim të qëndrueshëm që nuk varet nga këndi, ndriçimi, rezolucioni. Në thelb rrjeti minimizon metrikën “fytyra të ndryshme — larg” dhe “të njëjta — afër”.
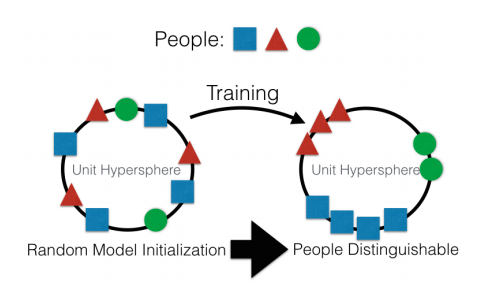
Për këtë mësim nevojiten dhjetëra dhe qindra mijëra shembuj. Por, rezultati çon në disa elemente të “One-shot Learning”. Tani nuk na duhen qindra fytyra për të mbajtur mend një person. Mjafton një fytyrë, dhe gjithçka — ne !
Por problemi është... Rrjeti mund të mësojë vetëm objekte ose karakteristika mjaft të thjeshta. Në përpjekjen për të dalluar jo fytyra, por, për shembull, “njerëzit sipas veshjes” (detyra ) — cilësia bie në shumë shkallë. Dhe rrjeti nuk mund të mësojë aq qartë ndryshimet e këndvështrimeve.
Po ashtu, të mësohet mbi miliona shembuj — është gjithashtu një argëtim ashtu siç duhet.
Ka punime mbi zvogëlimin e ndjeshëm të zgjedhjeve. Për shembull, një nga punimet e para për OneShot Learning :
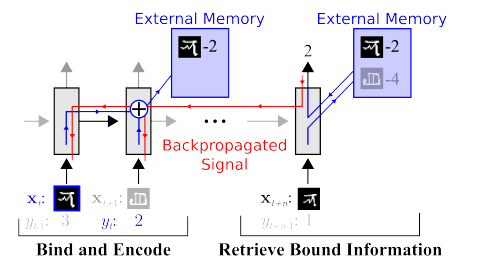
Ka shumë punime të tilla, për shembull ose ose .
Një minus është se zakonisht trajnimi funksionon mirë me disa shembuj të thjeshtë, si "MNIST". Por kur kalojmë në detyrat më komplekse, nevojitet një bazë më e madhe, modeli i objekteve, ose ndonjë magji.
Në të vërtetë, puna mbi trajnimet One-Shot është një temë shumë interesante. Gjen shumë ide. Por pjesa më e madhe e dy problemeve që përmenda (paratraining në një dataset të madh / paqëndrueshmëri në të dhëna të ndërlikuara) pengojnë shumë trajnimin.
Nga ana tjetër, tema e Embedding përputhet me GAN - rrjetet gjeneruese konkurruese. Ju ndoshta keni lexuar shumë artikuj në këtë temë në Habrë., ,)
Karakteristika e GAN është formimi i disa hapësirave të brendshme të gjendjeve (në thelb e njëjtë me Embedding), që lejon të krijohet një imazh. Këto mund të jenë , mund të jenë .
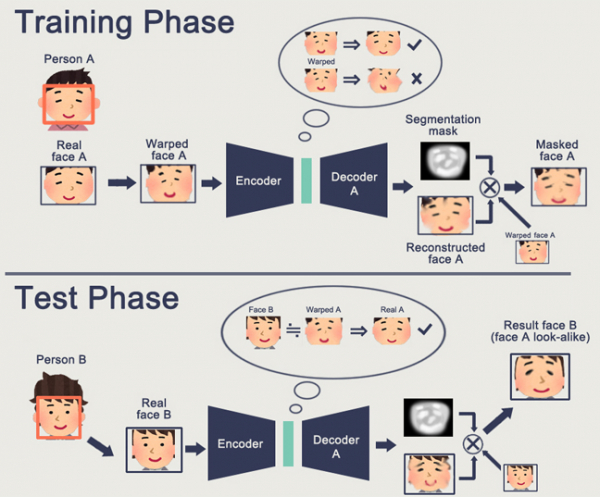
Problemi me GAN është që sa më e komplikuar të jetë objekti që gjenerohet, aq më e vështirë është ta përshkruash atë në logjikën "generues-diskriminues". Si rezultat, nga përdorimet reale të GAN, ato që janë më të njohura janë vetëm DeepFake, e cila përsëri manipulon përfaqësimet e fytyrave (për të cilat ekziston një bazë e madhe).
Përdorime të tjera të dobishme kam takuar shumë pak. Zakonisht janë disa lodra me piktura të shkruara.
Dhe përsëri. Askush nuk ka një kuptim se si kjo do të na ndihmojë të ecim drejt një të ardhmeje më të ndritshme. Përfaqësimi i logjikës/hapsirës në një rrjet neuronal është mirë. Por nevojiten shumë shembuj, nuk e kuptojmë se si neuroni e përfaqëson atë, nuk e kuptojmë se si ta detyrojmë neuronin të mbajë një përfaqësim realisht të komplikuar.
Mësimi përforcues është një qasje krejt tjetër. Sigurisht që e mbani mend se si Google mundi të gjithë në Go. Fitorja e fundit në Starcraft dhe në Dota. Por këtu gjithçka nuk është kaq optimiste dhe perspektive. Më së miri për RL dhe vështirësitë e tij flet .
Nëse e përmbledhim shkurtimisht atë që tha autori:
- Modelet nga kutia nuk i përmbushin / funksionojnë dobët në shumicën e rasteve.
- Problemet praktike është më e lehtë t'i zgjidhni nëpërmjet mënyrave të tjera. Boston Dynamics nuk përdor RL për shkak të kompleksitetit / papërshtatshmërisë / vështirësive të llogaritjeve.
- Për të funksionuar RL-në, nevojitet një funksion kompleks. Shpesh është e vështirë ta krijosh / shkruash.
- Është e vështirë të trajnohen modelet. Duhet të harxhosh shumë kohë për t'i nxitur dhe për t'i nxjerrë nga optimumet lokale.
- Si نتيجة, është e vështirë të përsëritet modeli, pasiguria e modelit me ndryshime të vogla
- Shpesh e tepruara në disa rregulla të rastësishme, deri në gjeneratorin e numrave të rastësishëm
Çështja kyçe është - RL ende nuk funksionon në prodhim. Google ka disa eksperimente ( , ). Por unë nuk kam parë asnjë sistem produktiv.
Memorie. Disavantazhi i gjithë atij që përshkruhet më lart është çnuk structuruar. Një nga qasjet si të gjithë këtë përpiqen ta rregullojnë është të ofrojnë një rrjet nervor akses në një memorje të veçantë. Kështu që ajo mund të regjistrojë dhe rregullojë atje rezultatet e hapave të saj. Atëherë rrjeti nervor mund të përcaktohet nga gjendja aktuale e memorjes. Kjo është shumë e ngjashme me procesorët dhe kompjuterët klasikë.
Më e njohura dhe e popullarizuara — nga DeepMind:
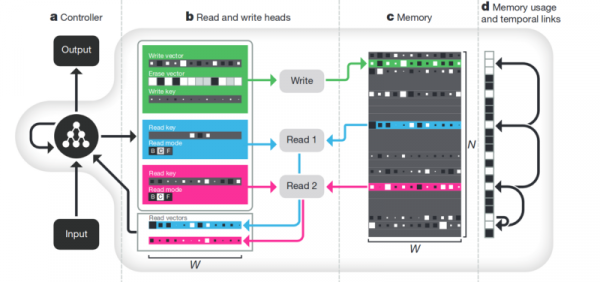
Duket se është çelësi për të kuptuar inteligjencën? Por më shumë se sa jo. Sistemi ende ka nevojë për një masiv të madh të të dhënave për trajnim. Dhe ai punon kryesisht me të dhëna të strukturuara tabelare. Ndërkohë, kur Facebook një problem të ngjashëm, ata ndoqën rrugën "harroje memorjen, thjesht do të ndërtosh një nervore më të komplikuar, po do të kemi më shumë shembuj - dhe ajo do të mësojë vetë."
Disentanglement. Një mënyrë tjetër për të krijuar një memorje të rëndësishme është të marrim të njëjtat embeding, por gjatë trajnimit të futim kritere shtesë që do të lejonin të veçonin "kuptimet" në to. Për shembull, ne duam të trajnojmë një rrjet nervor për të dalluar sjelljen e një njeriu në një dyqan. Nëse do të shkonim në rrugën standarde - do të kishim bërë një duzinë rrjetesh. Një kërkon njeriun, tjetra përcakton çfarë po bën ai, e treta moshën e tij, e katërta - gjininë. Një logjikë e veçantë shikon pjesën e dyqanit ku ai po bën / mëson për këtë. E treta përcakton trajektoren e tij, etj.
Ose, nëse do të kishte një sasi të pafund të dhënash, atëherë do të ishte e mundur të trajnohej një rrjet për të gjitha rezultatet e mundshme (sigurisht, një masë e tillë të dhënash nuk mund të grumbullohet).
Qasja disentralizuar na thotë - le të mësojmë rrjetin në një mënyrë që ai vetë të jetë në gjendje të dallojë konceptet. Që ai të formojë një embed nëpërmjet videove, ku një zonë do të përcaktonte veprimin, një tjetër - pozita në hapësirë në kohë, një tjetër - lartësia e personit, dhe një tjetër - gjinia e tij. Kurse në procesin e mësimit dëshirohet të mos i jepet shumë udhëheqje rrjetit për këto koncepte kyçe, por të lejohet ai vetë të identifikojë dhe grupojë zonat. Ka shumë pak artikuj të tillë (disa nga ata , , ) dhe në përgjithësi ata janë mjaft teorikë.
Por kjo drejtim, të paktën në teorinë, duhet të adresojë problemet e përmendura më parë.
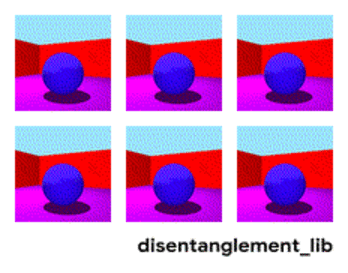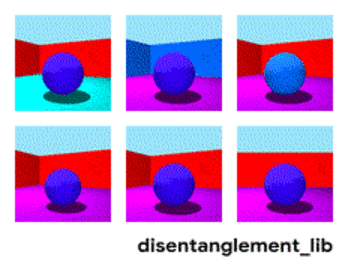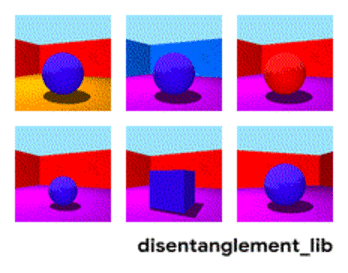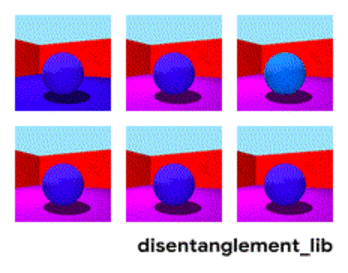
Shkëputja e imazhit sipas parametrave "ngjyra e murit/ngjyra e dyshemesë/formati i objektit/ngjyra e objektit/etj."
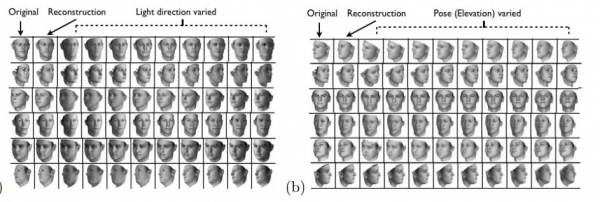
Shkëputja e fytyrës sipas parametrave "madhësia, vetullat, orentimi, ngjyra e lëkurës, etj."
Të tjera
Ka shumë drejtime të tjera që nuk janë aq globale, por lejojnë në njëfarë mënyre reduktimin e bazave, punën me të dhëna më heterogjene, etj.
Vëmendja. Njësoj, ndoshta nuk ka kuptim ta veçosh këtë si një metodë të veçantë. Thjesht një qasje që forcon të tjerat. Atij i janë dedikuar shumë artikuj (,,). Qëllimi i Vëmendjes është të forcojë reagimin e rrjetit pikërisht ndaj objekteve të rëndësishme gjatë mësimit. Shpesh me ndihmën e një sinjali të jashtëm, ose një rrjeti të vogël jashtë.
Simulimi 3D. Nëse krijohet një motor 3D i mirë, atëherë ai shpesh mund të mbulojë 90% të të dhënave të trajnimit (kam parë shembuj kur pothuajse 99% e të dhënave mbuloheshin me një motor të mirë). Ka shumë ide dhe hakerime se si të bëhet që rrjeti i trajnuar në motorin 3D të punojë me të dhëna reale (Fine tuning, transferimi i stilit, etj.). Por shpesh krijimi i një motori të mirë është disa renditje më i komplikuar se sa mbledhja e të dhënave. Shembuj kur janë krijuar motorë:
Trajnimi i roboteve (, )
Arsimimi produkteve në dyqane (por në dy projektet që kemi realizuar ne - kemi kaluar pa këtë).
Trajnimi në Tesla (sërish video që ishte më sipër).
Përfundimet
I gjithë artikulli është në një farë mase përfundimet. Ndoshta, qëllimi kryesor që doja të dalloja ishte - "falas nuk ka më, rrjetet neurale nuk ofrojnë më zgjidhje të thjeshta". Tani duhet të punohet duke ndërtuar zgjidhje të komplikuara. Apo të punohet në kërkime shkencore të komplikuara.
Në përgjithësi, kjo temë është e diskutueshme. Ndoshta lexuesit kanë shembuj më interesantë?
Burimi: habr.com
