

Si e lexoni këtë artikull: më falni që teksti doli kaq i gjatë dhe kaotik. Për të kursyer kohën tuaj, çdo kapitull e filloj me një hyrje "Çfarë mësova", ku përmbledh në një ose dy fjali thelbin e kapitullit.
"Thjesht trego zgjidhjen!" Nëse dëshironi vetëm të shihni se çfarë arrita, kaloni në kapitullin "Po bëhem më shpikës", por unë mendoj se është më interesante dhe e dobishme të lexoni për dështimet.
Së fundmi, më kërkuan të konfiguroj procesin e përpunimit të një volum të madh të sekuencave të ADN-së (teknikisht ky është SNP-chip). Duhej të merrja shpejt të dhëna për një lokacion të caktuar gjenetik (i cili quhet SNP) për modelimin e mëtejshëm dhe detyra të tjera. Me ndihmën e R dhe AWK, arrita të pastroj dhe organizoj të dhënat në një mënyrë natyrale, duke e përshpejtuar ndjeshëm përpunimin e kërkesave. Kjo nuk ishte e lehtë për mua dhe kërkoi shumë iteracione. Ky artikull do t'ju ndihmojë të shmangni disa nga gabimet e mia dhe do të demonstrojë se çfarë arrita në fund.
Së pari, disa shpjegime hyrëse.
Të dhënat
Qendra jonë universitare për përpunimin e informacionit gjenetik na ofroi të dhënat në formatin TSV me volum 25 TB. Ato më erdhën të ndara në 5 paketa, të kompresuara me Gzip, secila prej të cilave përmbante rreth 240 skedarë katër gigabajtësh. Çdo rresht përmbante të dhëna për një SNP të një personi. Në total u dorëzuan të dhëna për ~2.5 milion SNP dhe ~60 mijë njerëz. Përveç informacionit SNP, në skedarë kishte shumë kolona me numra që pasqyronin karakteristika të ndryshme, si intensiteti i leximit, frekuenca e aleleve të ndryshme etj. Në total kishte rreth 30 kolona me vlera unike.
Qëllimi
Ashtu si në çdo projekt menaxhimi të të dhënave, më e rëndësishmja ishte të përcaktohej se si do të përdoren të dhënat. Në këtë rast ne kryesisht do të përshtatim modele dhe flukse pune për SNP në bazë të SNP. Pra, në të njëjtën kohë, na nevojiten të dhëna vetëm për një SNP. Duhej të mësoja si të nxjerr të gjitha shënimet që i përkasin njërit prej 2.5 milion SNP-ve sa më thjeshtë, shpejt dhe lirë.
Si të mos e bëni këtë
Do të citoj një klishe të përshtatshme:
Nuk kam dështuar mijëra herë, thjesht kam zbuluar mijëra mënyra për të mos zhvilluar një sasi të madhe të dhënash në një format të përshtatshëm për kërkesa.
Përpjekja e parë
Çfarë mësova: nuk ka një mënyrë të lirë për të analizuar 25 Tb njëherësh.
Pas dëgjimit të kursit "Metodat Avancuara të Përpunimit të Dhënave të Mëdha" në Universitetin Vanderbilt, isha i sigurt se isha në rrugën e duhur. Ndoshta do të duheshin rreth një orë deri dy për të konfiguruar një server Hive për të kaluar nëpër të dhëna dhe për të raportuar rezultatin. Duke qenë se të dhënat tona ruhen në AWS S3, përfitoi nga shërbimi , i cili lejon aplikimin e kërkesave Hive SQL në të dhënat S3. Nuk është e nevojshme të konfigurosh/nxjerrësh një klaster Hive, dhe paguani vetëm për të dhënat që kërkoni.
Pasi i tregova Athena të dhënat e mia dhe formatin e tyre, kam ekzekutuar disa teste me kërkesa të ngjashme:
select * from intensityData limit 10;Dhe shpejt mora rezultate të strukturuara mirë. Gati.
Derisa nuk e provuam të përdorim të dhënat në punë...
Më kërkuan të nxjerr gjithë informacionin mbi SNP, për ta testuar atë në model. Çfarë kërkoi:
select * from intensityData
where snp = 'rs123456';
...dhe fillova të prisja. Pasi kaluan tetë minuta dhe më shumë se 4 Tb të dhënash të kërkuara, mora rezultatin. Athena ka një tarifë për volumin e të dhënave të gjetura, $5 për terabajt. Pra, ky kërkesë i vetëm më kushtoi $20 dhe tetë minuta pritje. Për të kaluar modelin për të gjitha të dhënat, do të duhej të prisja 38 vjet dhe të paguaj $50 milion. Është e qartë se kjo nuk ishte zgjidhja për ne.
Duhej të përdorim Parquet...
Çfarë mësova: kujdes nga madhësia e skedarëve tuaj Parquet dhe organizimi i tyre.
Fillimisht përpiqesha të rregulloja situatën duke konvertuar të gjitha TSV në Ato janë të përshtatshme për punë me grupe të mëdha të dhënash, sepse informatat në to ruhen në format kolonor: çdo kolonë ndodhet në një segment të vetëm të memories/diskut, ndryshe nga skedarët tekstualë, ku rreshtat përmbajnë elemente të çdo kolone. Dhe nëse duhen gjetur disa, mjafton të lexoni kolonën përkatëse. Për më tepër, në çdo skedar në kolonë ruhet një gamë vlerash, prandaj, nëse vlera e kërkuar nuk është në gamën e kolonës, Spark nuk do të humbasë kohë duke skanuar të gjithë skedarin.
Kam nisur një detyrë të thjeshtë për të konvertuar TSV-të tona në Parquet dhe hedhur skedarë të rinj në Athena. Kjo zbuloi rreth 5 orë. Por kur e nisi kërkesën, ekzekutimi i saj zgjati afërsisht po aq dhe disi më pak para. Problemi është se Spark, duke përpjekur të optimizojë detyrën, thjesht e çoi një TSV-chunk dhe e vendosi në një chunk të tijin Parquet. Dhe, pasi çdo chunk ishte mjaft i madh dhe përmbante të dhëna të plota për shumë njerëz, çdo skedar kishte të gjitha SNP-të, kështu që Spark duhej të hapte të gjitha skedarët për të marrë informacionin e nevojshëm.
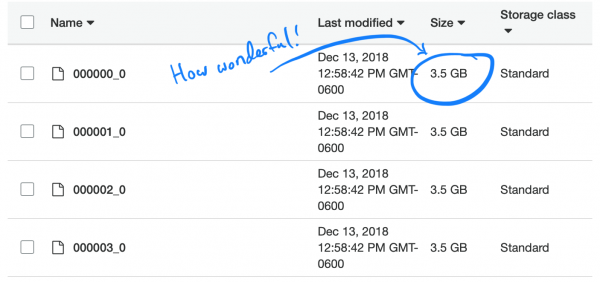
Është e çuditshme që lloji i kompresimit i përdorur nga default (dhe i rekomanduar) në Parquet — snappy, — nuk është ndarës (splitable). Prandaj çdo execucator ngec në detyrën e ç'kompresimit dhe ngarkimi i dataset-it të plotë prej 3.5 GB.
Po shqyrtojmë problemin
Çfarë mësova: është e komplikuar të renditësh, veçanërisht nëse të dhënat janë të shpërndara.
Më dukej se tani kuptoja thelbin e problemit. Ndoshta duhej thjesht të renditja të dhënat sipas kolonës SNP, jo sipas njerëzve. Në këtë mënyrë, në një chunk të veçantë të të dhënave do të ishin disa SNP, dhe atëherë do të shfaqej në të gjithë madhështinë e saj funksioni "inteligjent" të Parquet-it "hap vetëm nëse vlera është brenda gamës". Fatkeqësisht, renditja e miliardave rreshtash të shpërndara në një grup rezultoi të ishte një detyrë sfiduese.
Unë duke marrë një klasë algoritmesh në kolegj: «Ugh, askush nuk i intereson kompleksiteti kompjuterik i këtyre algoritmeve renditëse»
Unë duke u përpjekur të rendit në një kolonë në 20TB tabelë: «Pse po zgjat kaq shumë?» vështirësi.
— Nick Strayer (@NicholasStrayer)
AWS me siguri nuk dëshiron të kthejë paratë për shkak të "Jam një student i shpërndarë". Pasi e nisa renditjen në Amazon Glue, ajo punoi për 2 ditë dhe përfundoi me dështim.
Çfarë ndodhi me ndarjen në pjesë?
Çfarë mësova: ndarjet në Spark duhet të jenë të balancuara.
Pastaj më erdhi ideja për të ndarë të dhënat në kromozome. Janë 23 (dhe disa të tjera nëse merren parasysh DNA mitokondriale dhe territore të paqartësuara (unmapped)).
Kjo do të lejojë ndarjen e të dhënave në pjesë më të vogla. Nëse shtojmë në funksionin e eksportit të Spark në skriptin Glue vetëm një rresht partition_by = "chr", atëherë të dhënat duhet të jenë të ndara në bakete (buckets).
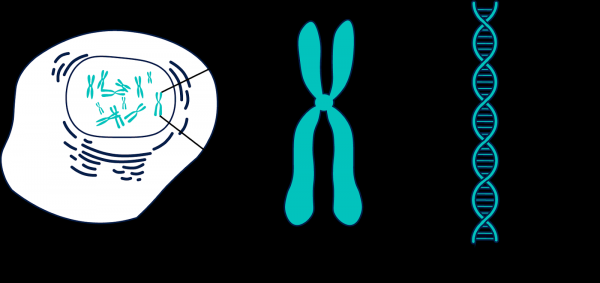
Gjenomi përbëhet nga shumë fragmente, të quajtur kromozome.
Fatkeq, kjo nuk funksionoi. Kromozomet kanë madhësi të ndryshme, kështu që kanë edhe sasi të ndryshme informacioni. Kjo do të thotë se detyrat që Spark i dërgoi punëtorëve nuk ishin të balancuara dhe u ekzekutuan ngadalë, pasi disa nyje përfunduan më herët dhe mbetën pa punë. Megjithatë, detyrat u përfunduan. Por kur kërkohej një SNP, disbalancimi përsëri shkaktoi probleme. Kostumi i përpunimit të SNP në kromozomet më të mëdha (pra atje ku ne duam të marrim të dhënat) u ul vetëm rreth 10 herë. Shumë, por jo mjaftueshëm.
Dhe çfarë nëse e ndajmë në parti edhe më të vogla?
Çfarë mësova: asnjëherë mos u përpiqni të bëni 2.5 milion partie.
Unë vendosa të ecja deri në fund dhe i partiçionova çdo SNP. Kjo garantoi madhësi të njëjtë për partitë. ISHTE NJË IDE E KEQE. Përdora Glue dhe shtova një varg të pafajshëm partition_by = 'snp'. Detyra u nis dhe filloi të ekzekutohej. Një ditë më vonë kontrollova dhe pashë se në S3 ende nuk ishte shkruar asgjë, prandaj e ndalova detyrën. Duket se Glue shkruante skedarët përkohësorë në një vend të fshehur në S3, dhe kishte shumë skedarë, ndoshta disa milion. Si rezultat, gabimi im kushtoi më shumë se një mijë dollarë dhe nuk e gëzoi mentorin tim.
Particionimi + renditja
Çfarë mësova: ende është e vështirë të renditësh, ashtu si dhe të konfigurosh Spark.
Përpjekja e fundit për partitionim ishte që unë partitionova kromozomet dhe më pas rendita çdo parti. Në teori, kjo do të lejonte të përshpejtonte çdo kërkesë, sepse të dhënat e dëshiruara për SNP do të ishin brenda disa Parquet chank-ëve brenda një diapazoni të dhënë. Fatkeqësi, renditja e të dhënave të partiçionuara rezultoi të ishte një detyrë e vështirë. Si rezultat, kalova në EMR për një grup të personalizuar dhe përdora tetë instanca të fuqishme (C5.4xl) dhe Sparklyr për të krijuar një proces më fleksibël…
# Sparklyr snippet to partition by chr and sort w/in partition
# Join the raw data with the snp bins
raw_data
  group_by(chr) %>%
  arrange(Position) %>%
  Spark_write_Parquet(
    path = DUMP_LOC,
    mode = 'overwrite',
    partition_by = c('chr')
  )
…sidoqoftë detyra përsëri nuk u ekzekutua. Unë e konfigurova në të gjitha mënyrat: rita memorie për çdo ekzekutor të kërkesave, përdora nyje me më shumë memorie, aplikoja variabla të transmetimit (broadcasting variable), por çdo herë, këto ishin gjysmë masa, dhe gradualisht ekzekutorët filluan të prisnin, derisa gjithçka ndaloi.
Update: kështu fillon.
— Nick Strayer (@NicholasStrayer)
Po bëhem më kreativ
Çfarë mësova: ndonjëherë të dhënat e veçanta kërkojnë zgjidhje të veçanta.
Çdo SNP ka një vlerë pozite. Ky numër korrespondon me numrin e bazave që ndodhen përgjatë kromozomit të tij. Kjo është një mënyrë e mirë dhe natyrale për të organizuar të dhënat tona. Fillimisht doja të bëja ndarje sipas rajoneve të çdo kromozomi. Për shembull, pozitat 1 - 2000, 2001 - 4000, etj. Por problemi është se SNP janë të shpërndara në kromozome në mënyrë të pabarabartë, kështu që madhësia e grupeve do të ndryshonte ndjeshëm.
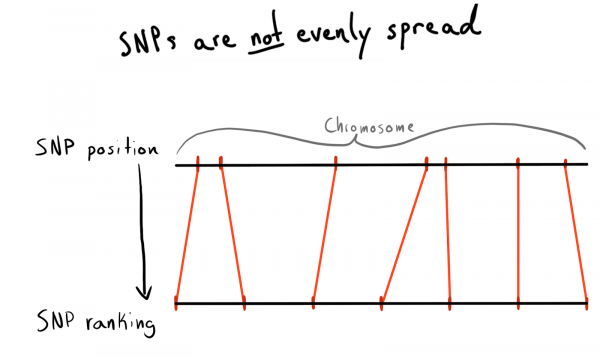
Si rezultat, arrij në ndarjen sipas kategorive (rank) të pozita. Nga të dhënat e ngarkuara tashmë, ekzekutova një pyetje për të marrë një listë të SNP-ve unikë, pozitat dhe kromozomet e tyre. Pastaj rendita të dhënat brenda çdo kromozomi dhe grumbullova SNP në grupe (bin) me madhësi të caktuar. Le të themi, për 1000 SNP. Kjo më dha lidhjen e SNP me grupin-në-kromozom.
Në fund, bëra grupe (bin) me 75 SNP, arsyen e shpjegoj më poshtë.
snp_to_bin %
  group_by(chr) %>%
  arrange(position) %>%
  mutate(
    rank = 1:n()
    bin = floor(rank/snps_per_bin)
  ) %>%
  ungroup()
Përpjekja e parë me Spark
Çfarë mësova: bashkimi në Spark funksionon shpejt, por ndarja ende kushton shumë.
Doja të lexoja këtë kuadër të vogël (2.5 milion rreshta) në Spark, ta bashkoja me të dhëna të papërpunuara, dhe pastaj ta ndaja sipas kolonës së sapo shtuar. bin.
# Join the raw data with the snp bins
data_w_bin <- raw_data %>%
  left_join(sdf_broadcast(snp_to_bin), by ='snp_name') %>%
  group_by(chr_bin) %>%
  arrange(Position) %>%
  Spark_write_Parquet(
    path = DUMP_LOC,
    mode = 'overwrite',
    partition_by = c('chr_bin')
  )
Kam përdorur sdf_broadcast(), kështu që Spark merr vesh se duhet të dërgojë kuadrin e të dhënave në të gjitha nyjet. Kjo është e dobishme nëse të dhënat janë të vogla dhe kërkohen për të gjitha detyrat. Ndryshe, Spark përpiqet të jetë i mençur dhe shpërndan të dhënat sipas nevojës, që mund të shkaktojë ngadalësim.
Dhe përsëri, ideja ime nuk funksionoi: detyrat punuan për njëfarë kohe, përfunduan bashkimin, dhe pastaj, siç bënë ekzekutuesit që ishin nën ndarjen, filluan të dështojnë.
Po shtoj AWK
Çfarë mësova: mos flini kur ju mësojnë bazat. Sigurisht, dikush e ka zgjidhur problemin tuaj ndonjëherë në vitet 1980.
Derisa të këtij momenti, arsyeja e të gjitha dështimeve të mia me Spark ishte përzierja e të dhënave në klaster. Mund të përmirësohet situata me përpunim të parakohshëm. Vendosa të provoj të ndaj të dhënat e papërpunuara në kolona kromozomesh, kështu që shpresoja t'i ofroja Spark-u të dhënat "të parakohshme të ndara".
Kërkova në StackOverflow se si të ndaj sipas vlerave të kolonave dhe gjeta Me AWK, mund të ndani një skedar teksti sipas vlerave të kolonave, duke bërë një regjistrim në skript, në vend që të dërgoni rezultatet në stdout.
Për prova, shkrova një skript Bash. Shkova një nga paketat e TSV, pastaj e dekompresova me gzip dhe e dërgova në awk.
gzip -dc path/to/chunk/file.gz |
awk -F 't'
'{print $1",..."$30">"chunked/"$chr"_chr"$15".csv"}'
Kjo funksionoi!
Plotësimi i bërthamave
Çfarë mësova: gnu parallel është diçka magjike, çdo kush duhet ta përdorë atë.
Ndarja po shkonte mjaft ngadalë, dhe kur e nisa htop, për të kontrolluar përdorimin e instancës EC2 (dhe të shtrenjtë) të fuqishme, u zbulua se po përdorja vetëm një bërthamë dhe rreth 200 MB memorie. Për të zgjidhur problemin dhe për të mos humbur shumë para, duhej të mendoja se si të parallelizoja punën. Me fat, në një libër të mrekullueshëm të Jeron Jansens, gjeta një kapitull që merret me parallelizimin. Nga ai mësova për gnu parallel, një metodë shumë fleksibël për implementimin e multi-threading në Unix.
Kur e nisa ndarjen me procesin e ri, gjithçka ishte shkëlqyer, por kishte një ngushticë - shkarkimi i objekteve S3 në disk nuk ishte shumë i shpejtë dhe nuk ishte plotësisht i parallelizuar. Për ta korrigjuar këtë, bëra këto:
- Pashë se mund të realizoja fazën e shkarkimit S3 direkt nëpërmjet tubit, duke përjashtuar plotësisht ruajtjen përkohësisht në disk. Kjo do të thotë se mund të shmangia shkrimin e të dhënave të papërpunuara në disk dhe të përdorja një ruajtje edhe më të vogël, dhe kështu më të lira në AWS.
- Me komandën
aws configure set default.s3.max_concurrent_requests 50rrit shumë numrin e threads që përdor AWS CLI (në mënyrë standarde janë 10). - Kalova në një instancë EC2 të optimizuar për shpejtësinë e rrjetit, me shkronjën n në emër. Zbulova se humbja e fuqisë llogaritëse duke përdorur instancat n u kompensua me shpejtësinë e ngarkesës. Për shumicën e detyrave përdora c5n.4xl.
- Ndryshova
gzipnë , kjo është një mjet gzip që di të bëjë gjëra të mrekullueshme për të parallelizuar një detyrë fillimisht jo të parallelizuar të dekompresimit të skedarëve (kjo ndihmoi më pak).
# Let S3 use as many threads as it wants
aws configure set default.s3.max_concurrent_requests 50

for chunk_file in $(aws s3 ls $DATA_LOC | awk '{print $4}' | grep 'chr'$DESIRED_CHR'.csv') ; do

        aws s3 cp s3://$batch_loc$chunk_file - |
        pigz -dc |
        parallel --block 100M --pipe
        "awk -F 't' '{print $1",..."$30">"chunked/{#}_chr"$15".csv"}'"

       # Combine all the parallel process chunks to single files
        ls chunked/ |
        cut -d '_' -f 2 |
        sort -u |
        parallel 'cat chunked/*_{} | sort -k5 -n -S 80% -t, | aws s3 cp - '$s3_dest'/batch_'$batch_num'_{}'

         # Clean up intermediate data
       rm chunked/*
done
Këto hapa u kombinuan me njëri-tjetrin që të gjitha të funksiononin shumë shpejt. Falë rritjes së shpejtësisë së shkarkimit dhe heqjes së shkrimit në disk, tani mund të procesoj një paketë 5 terabajtësh për vetëm disa orë.
Nuk ka asgjë më të ëmbël se të shohësh të gjithë bërthamat që po paguan në AWS duke u përdorur. Falë gnu-parallel mund të shpërndaj dhe ndaj një CSV prej 19 gigabajtësh po aq shpejt sa mund ta shkarkoj. As nuk arrin ta bëjë të funksionojë Spark.
— Nick Strayer (@NicholasStrayer)
Ky tweet do të duhej të përmendte ‘TSV’. fatkeqësisht.
Përdorimi i të dhënave të riparasura
Çfarë mësova: Spark-i do të dhëna të pambushura dhe nuk e do të kombinojë partitë.
Tani të dhënat ishin në S3 në një format të papackuar (lexo, të ndara) dhe gjysmë të renditur, dhe mund të kthehesha përsëri te Spark. Më priste një surprizë: sërish nuk arrija të arrija atë që dëshiroja! Ishte shumë e vështirë t’i thoja Spark-ut se si ishin të partizuara të dhënat. Dhe edhe kur e bëra këtë, rezultoi se kishim shumë patica (95 mijë), dhe kur me pomocën e coalesce e zvogëlova atë në kufij të arsyeshëm, prishja rregullimin tim të particioneve. Jam i sigurt se mund të rregullohet, por pas disa ditësh kërkime nuk arrita të gjej një zgjidhje. Në fund, e plotësova të gjitha detyrat në Spark, edhe pse kjo mori pak kohë, dhe skedarët e mi të ndarë Parquet nuk ishin shumë të vegjël (~200 KB). Megjithatë, të dhënat ishin aty ku duhej.
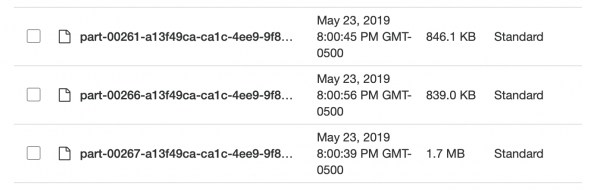
Shumë të vogla dhe të ndryshme, mrekulli!
Testimi i kërkesave lokale në Spark
Çfarë mësova: në Spark ka shumë të meta kur zgjidhni detyra të thjeshta.
Duke ngarkuar të dhënat në një format të menduar, arrita të testoj shpejtësinë. Përshtata skriptin në R për të nisur një server lokal Spark, dhe më pas ngarkova kornizën e të dhënave Spark nga magazina e caktuar Parquet-bins. Përpika të ngarkoja të gjithë të dhënat, por nuk arrita ta bëj Sparklyr të njohë partizionimin.
sc <- Spark_connect(master = "local")

desired_snp <- 'rs34771739'

# Filloni një kohëmatës
start_time <- Sys.time()

# Ngarko binin e dëshiruar në Spark
intensity_data %
  Spark_read_Parquet(
    name = 'intensity_data',
    path = get_snp_location(desired_snp),
    memory = FALSE )

# Ndarja e binit në snp dhe pastaj mbledhja në lokal
test_subset %
  filter(SNP_Name == desired_snp) %>%
  collect()

print(Sys.time() - start_time)
Ekzekutimi zgjati 29.415 sekonda. Shumë më mirë, por jo aq mirë për testimin masiv të diçkaje. Për më tepër, nuk mund të shkurtova kohën me ndihmën e caching, sepse kur përpiqesha të ruaja në memory kornizën e të dhënave, Spark gjithmonë dështonte, edhe kur ndaja më shumë se 50 GB memorie për një dataset që peshoi më pak se 15.
Kthimi te AWK
Çfarë mësova: strukturat associative në AWK janë shumë efikase.
E dija se mund të arrija shpejtësi më të lartë. Më kujtohej një herë kur isha duke lexuar një Kam lexova për një karakteristikë të shkëlqyer që quhet "". Në thelb, janë çifte çelësi-vlerë, që për një arsye e ndryshuan emrin në AWK dhe për këtë arsye nuk i kisha kujtuar shumë. më kujtoi se termi "marrëdhënie asociative" është shumë më i vjetër se termi "çelës-vlerë". Edhe nëse ju , nuk do ta gjeni këtë term, por do të gjeni marrëdhënie asociative! Për më tepër, "çelësi-vlerë" shpesh lidhet me bazat e dhënave, prandaj është shumë më logjike të krahasohet me hashmap. E kuptova se mund t'i përdor këto marrëdhënie asociative për të lidhur SNP-të e mia me tabelën e grupeve (tabela binare) dhe të dhënat e papërpunuara pa përdorur Spark.
Për këtë, në skenarin AWK përdora bllokun FILLON. Ky është një fragment kodi që ekzekutohet para se të kalojë rreshti i parë i të dhënave në trupin kryesor të skenarit.
join_data.awk
BEGIN {
  FS=",";
  batch_num=substr(chunk,7,1);
  chunk_id=substr(chunk,15,2);
  while(getline  "chunked/chr_"chr"_bin_"bin[$1]"_"batch_num"_"chunk_id".csv"
}
Ekipa while(getline...) ngarkohet të gjitha rreshtat nga CSV e grupit (binar), caktohet kolonën e parë (emri i SNP) si çelësi për marrëdhënien asociative bin dhe vlera e dytë (grupi) si vlera. Pastaj në bllokun { }, i cili ekzekutohet për të gjitha rreshtat e skedarit kryesor, çdo rresht dërgohet në skedarin e daljes, që merr një emër unik në varësi të grupit të tij (binar): ..._bin_"bin[$1]"_....
Variablat batch_num dhe chunk_id përputheshin me të dhënat e ofruara nga tubi, duke shmangur kështu një gjendje konkurruese, dhe çdo rrjedhë ekzekutimi e nisur paralelet, shkruante në skedarin e saj unik.
Dukeqë të gjitha të dhënat e papërpunuara i kisha shpërndarë në dosje sipas kromosomeve, që kishin mbetur pas eksperimenteve të mia të mëparshme me AWK, tani mund të shkruaja një skenar tjetër Bash për të përpunuar një kromozom në një herë dhe dorëzuar në S3 të dhëna më të ndara.
DESIRED_CHR='13'

# Shkarko të dhënat e kromozomeve nga s3 dhe ndaj në bins
aws s3 ls $DATA_LOC |
awk '{print $4}' |
grep 'chr'$DESIRED_CHR'.csv' |
parallel "echo 'po lexoj {}'; aws s3 cp "$DATA_LOC"{} - | awk -v chr=""$DESIRED_CHR"" -v chunk="{}" -f split_on_chr_bin.awk"

# Bashko të gjitha proceset paralele në skedarë të vetëdijshëm dhe ngarko në rds duke përdorur R
ls chunked/ |
cut -d '_' -f 4 |
sort -u |
parallel "echo 'po zip' { }; cat chunked/*_bin_{}_*.csv | ./upload_as_rds.R '$S3_DEST'/chr_'$DESIRED_CHR'_bin_{}.rds"
rm chunked/*
Në skenar ka dy pjesë paralelet.
Në seksionin e parë, të dhënat lexohen nga të gjitha skedarët që përmbajnë informacionin për kromozomën e nevojshme, pastaj këto të dhëna shpërndahen në thread-e, të cilat i ndajnë skedarët në grupet përkatëse (bin). Për të shmangur një gjendje garash, kur disa thread-e shkruajnë në një skedar të vetëm, AWK kalon emrat e skedarëve për të shkruar të dhënat në vende të ndryshme, për shembull, chr_10_bin_52_batch_2_aa.csv. Si rezultat, krijohet një numër i madh skedash të vegjël në disk (për këtë kam përdorur vëllime EBS me kapacitet një terabajt).
Përçuesi nga seksioni i dytë paralelet kalon nëpër grupet (bin) dhe bashkon skedarët e tyre të veçantë në CSV të përbashkët cat, dhe pastaj i dërgon ata për eksport.
Translacioni në R?
Çfarë mësova: mund të referohesh në stdin dhe stdout nga skripti R, çka do të thotë që mund ta përdorësh atë në përçues.
Në skriptin Bash, mund të keni vënë re këtë rresht: ...cat chunked/*_bin_{}_*.csv | ./upload_as_rds.R.... Ai transfton të gjithë skedarët e lidhur të grupit (bin) në skriptin R më poshtë. {} është një metodë speciale paralelet, e cila çdo të dhënë të dërguar në atë rrjedhë e vendos direkt në komandën e vet. Opsioni {#} siguron një ID unik të rrjedhës së ekzekutimit, dhe {%} përfaqëson numrin e slotit të detyrës (ripërseritet, por kurrë në të njëjtën kohë). Lista e të gjitha opsioneve mund të gjendet në
#!/usr/bin/env Rscript
library(readr)
library(aws.s3)

# Read first command line argument
data_destination <- commandArgs(trailingOnly = TRUE)[1]

data_cols <- list(SNP_Name = 'c', ...)

s3saveRDS(
  read_csv(
        file("stdin"),
        col_names = names(data_cols),
        col_types = data_cols
    ),
  object = data_destination
)
Kur variabla file("stdin") i kalon në readr::read_csv, të dhënat e transfuara në skriptin R ngarkohen në një frame, i cili më pas në formën e .rds-skedarit me anë të aws.s3 shkruhet direkt në S3.
RDS është ngjashëm me një version më të vogël të Parquet, pa rafinimet e magazinimit kolonor.
Pas përfundimit të skriptit Bash, kam marrë një grumbull .rds-skedash në S3, që më lejoj të përdor kompresim efektiv dhe lloje të integrate.
Pavarësisht nga përdorimi ngadalësues të R, gjithçka punonte shumë shpejt. Nuk është e habitshme që fragmentet në R, që janë përgjegjëse për të lexuar dhe shkruar të dhëna, janë optimizuar mirë. Pas testimit në një kromozom me madhësi mesatare, detyra u përfundua në instancën C5n.4xl për rreth dy orë.
Kufizimet S3
Çfarë mësova: falë implementimit të mençur të rrugëve, S3 mund të përpunojë një numër të madh skedash.
Ishte shqetësim nëse S3 do të mund të procesonte shumicën e skedarëve që i dërgoheshin. Mund të kisha bërë emrat e skedarëve kuptimplotë, por si do të kërkonte S3 sipas tyre?
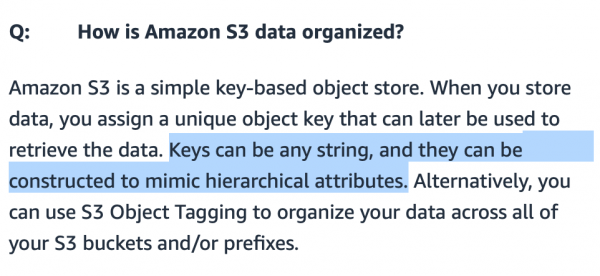
Folderët në S3 janë thjesht për bukuri, në të vërtetë sistemi nuk i intereson simboli /.
Duket se S3 paraqet rrugën deri te një skedar të caktuar si një çelës të thjeshtë në një tabelë hash ose në një bazë të dhënash të bazuar në dokumente. Cisternat (buckets) mund të merren si tabela, ndërsa skedarët si regjistrime në këtë tabelë.
Pasi që shpejtësia dhe efikasiteti janë të rëndësishme për realizimin e fitimeve në Amazon, nuk është çudi që ky sistem "çelës-në-si-rrugë-deri-te-skedarin" është jashtëzakonisht i optimizuar. Kam tentuar të gjej një ekuilibër: që të mos jetë e nevojshme të bëhen shumë kërkesa get, por që kërkesat të ekzekutohen shpejt. Doli që më së miri të bëhen rreth 20,000 skedarë binarë. Mendoj se nëse vazhdoj të optimizoj, mund të arrij një rritje të shpejtësisë (për shembull, të bëj një cisternë të veçantë vetëm për të dhënat, duke zvogëluar kështu madhësinë e tabelës së kërkimit). Megjithatë, nuk kishte më kohë dhe mundësi për eksperimente të mëtejshme.
Çfarë ndodh me përputhshmërinë ndërkufitare?
Çfarë mësova: arsyeja kryesore e humbjes së kohës është optimizimi i parakohshëm i metodës suaj të ruajtjes.
Në këtë moment është shumë e rëndësishme të pyesni veten: "Pse të përdorim një format skedari pronësor?" Arsyeja qëndron në shpejtësinë e ngarkimit (skedarët gzip CSV të paketuar ngarkoheshin 7 herë më gjatë) dhe përputhshmërinë me proceset tona të punës. Mund të rishikoj vendimin tim nëse R do të ishte në gjendje të ngarkonte lehtësisht skedarët Parquet (apo Arrow) pa ngarkesa nga Spark. Të gjithë në laboratorin tonë përdorin R, dhe nëse duhet të konvertoj të dhënat në një format tjetër, kam ende të dhënat origjinale tekstuale, kështu që mund ta filloj përsëri procesin.
Ndara e punës
Çfarë mësova: mos u përpoqni të optimizoni detyrat manualisht, lejoje këtë ta bëjë kompjuteri.
Kam debatuar procesin e punës në një kromozom, tani është koha të përpunoj të dhënat e tjera.
Dëshiroja të ngrija disa instancë EC2 për konvertim, por në të njëjtën kohë kisha frikë se do të merrja ngarkesë jashtëzakonisht të paekuilibruar në detyrat e përpunimit (ashtu si Spark kishte vuajtur nga partitë e paekuilibruar). Për më tepër, nuk më pëlqente të ngrija një instancë për çdo kromozom, sepse ka një kufizim të paracaktuar prej 10 instancash për llogaritë AWS.
Atëherë vendosa të shkruaj një skritp në R për optimizimin e detyrave të përpunimit.
Së pari kërkova nga S3 të llogariste sesa hapësirë në ruajtje zë çdo kromozom.
library(aws.s3)
library(tidyverse)

chr_sizes %
  mutate(Size = as.numeric(Size)) %>%
  filter(Size != 0) %>%
  mutate(
    # Nxjerr kromozomin nga emri i skedarit
    chr = str_extract(Key, 'chr.{1,4}.csv') %>%
             str_remove_all('chr|.csv')
  ) %>%
  group_by(chr) %>%
  summarise(total_size = sum(Size)/1e+9) # Ndaj për të marrë vlerën në GB


# Një tibble: 27 x 2
   chr   total_size

 1 0           163.
 2 1           967.
 3 10          541.
 4 11          611.
 5 12          542.
 6 13          364.
 7 14          375.
 8 15          372.
 9 16          434.
10 17          443.
# … me 17 rreshta të tjerë
Më pas shkrova një funksion që merr dimensionin total, përzjen renditjen e kromozomeve, i ndan në grupe. num_jobs dhe raporton se sa ndryshojnë dimensionet e të gjitha detyrave për procesim.
num_jobs <- 7
# Sa i madh do të ishte secili punë nëse do të ndaheshin perfekt?
job_size <- sum(chr_sizes$total_size)/7

shuffle_job %
    sample_frac() %>%
    mutate(
      cum_size = cumsum(total_size),
      job_num = ceiling(cum_size/job_size)
    ) %>%
    group_by(job_num) %>%
    summarise(
      job_chrs = paste(chr, collapse = ','),
      total_job_size = sum(total_size)
    ) %>%
    mutate(sd = sd(total_job_size)) %>%
    nest(-sd)
}

shuffle_job(1)


# Një tibble: 1 x 2
     sd data

1  153.
Më pas e kam drejtuar me purrr një mijë përzierje dhe kam zgjedhur më të mirën.
1:1000 %>%
  map_df(shuffle_job) %>%
  filter(sd == min(sd)) %>%
  pull(data) %>%
  pluck(1)
Kështu mora një set detyrash, shumë të ngjashme në madhësi. Më pas mbeti vetëm ta vështjelloj skriptin tim të mëparshëm në një cikël të madh. për. Shkrimi i kësaj optimizimi zuri rreth 10 minuta. Dhe kjo është shumë më pak sesa do të kisha shpenzuar për krijimin manual të detyrave në rast të pamjaftueshmërisë së tyre. Prandaj mendoj se me këtë optimizim paraprak nuk kam gabuar.
për DESIRED_CHR në "16" "9" "7" "21" "MT"
do
# Kodi për procesimin e një kromozomi të vetëm
fi
Në fund shtoj komandën e fikjes:
sudo shutdown -h now … dhe gjithçka funksionoi! Me ndihmën e AWS CLI ngrita instanca dhe përmes opsionit user_data i kalova skriptet e Bash-eve të detyrave për procesim. Ato u ekzekutuan dhe u fikën automatikisht, kështu që nuk paguaj për forcën kompjuterike të tepërt.
aws ec2 run-instances ...
--tag-specifications "ResourceType=instance,Tags=[{Key=Name,Value=<>}]"
--user-data file://<>
Po paketojmë!
Çfarë mësova: API duhet të jetë i thjeshtë për shkak të thjeshtësisë dhe fleksibilitetit të përdorimit.
Më në fund mora të dhënat në vendin dhe formën e dëshiruar. Duhej të thjeshtoja procesin e përdorimit të të dhënave, që kolegët e mi të kishin më të lehtë. Doja të bëja një API të thjeshtë për krijimin e kërkesave. Nëse në të ardhmen vendos të kaloj nga .rds në skedarët Parquet, kjo duhet të jetë një problem për mua, jo për kolegët. Prandaj, vendosa të krijoj një paketë të brendshme R.
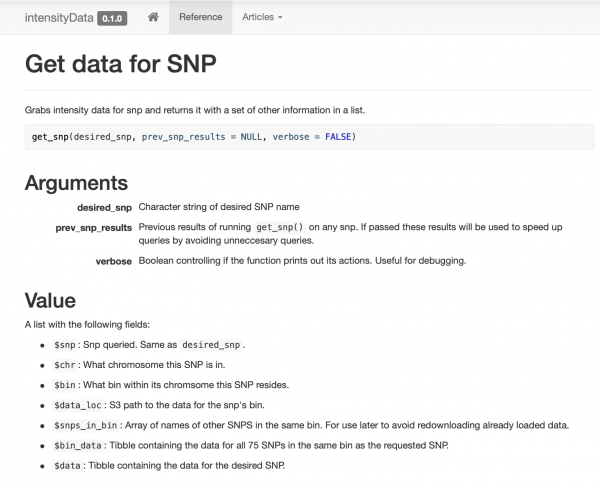
Mblodha dhe dokumentova një paketë shumë të thjeshtë, e cila përmban vetëm disa funksione për qasjen në të dhënat, të mbledhura rreth funksionit get_snp. Gjithashtu, për kolegët krijova një faqe , në mënyrë që ata të mund ta shohin lehtësisht shembujt dhe dokumentacionin.
Keqja inteligjente
Çfarë mësova: nëse të dhënat tuaja janë mirë përgatitur, do të jetë e lehtë të keqkuptohet!
Duke qenë se një nga proceset kryesore aplikonte të njëjtin model analize në paketën SNP, vendosa ta përdor grupimin (binning) në përfitimin tim. Kur kalojmë të dhënat nga SNP, informacioni nga grupa (bin) bashkëngjitet me objektin e kthyer. Kështu, kërkesat e vjetra mund (teoretikisht) të shpejtojnë përpunimin e kërkesave të reja.
# Part of get_snp()
...
  # Test if our current snp data has the desired snp.
  already_have_snp <- desired_snp %in% prev_snp_results$snps_in_bin

  if(!already_have_snp){
    # Grab info on the bin of the desired snp
    snp_results <- get_snp_bin(desired_snp)

    # Download the snp's bin data
    snp_results$bin_data <- aws.s3::s3readRDS(object = snp_results$data_loc)
  } else {
    # The previous snp data contained the right bin so just use it
    snp_results <- prev_snp_results
  }
...
Gjatë ndërtimit të paketës, bëra shumë benchmark-e për të krahasuar shpejtësinë e përdorimit të metodave të ndryshme. E rekomandoj atë, sepse ndonjëherë rezultatet janë të papritura. Për shembull, dplyr::filter u tregua shumë më i shpejtë se sa kapja e rreshtave me filtrimin në bazë të indeksimit, dhe marrja e një kolone nga korniza e dhënash e filtruar punonte shumë më shpejt se sa përdorimi i sintaksës së indeksimit.
Kujdes, që objekti prev_snp_results përmban çelësin snps_in_bin. Ky është një array i të gjitha SNP-ve unike në grup (bin), duke lejuar kontrollin e shpejtë për të parë nëse të dhënat nga kërkesa e mëparshme tashmë ekzistojnë. Gjithashtu, e thjeshton kalimin përmes të gjitha SNP-ve në grup (bin) me këtë kod:
# Get bin-mates
snps_in_bin <- my_snp_results$snps_in_bin

for(current_snp in snps_in_bin){
  my_snp_results <- get_snp(current_snp, my_snp_results)
  # Do something with results
}
Rezultatet
Tani mund të (dhe filluam seriozisht) të përjashtojmë modele dhe skenarë, të cilat më pare ishin të paarritshme për ne. Më e mira është se kolegët e mi në laborator nuk duhet të mendojnë për ndonjë ndërlikim. Ata thjesht kanë një funksion që funksionon.
Dhe ndonëse paketa i çliron ata nga detajet, përpiqesha ta bëja formatin e të dhënave të mjaftueshëm të thjeshtë, në mënyrë që ata të mund të kuptonin nëse nesër unë papritur zhdukem...
Shpejtësia është rritur ndjeshëm. Zakonisht ne skanojmë fragmente funksionale të rëndësishme të genomit. Më parë nuk mund të bënim këtë (ishte shumë e shtrenjtë), por tani, falë strukturës grupore (bin) dhe keqkuptimit, kërkesa për një SNP mesatarisht zgjat më pak se 0,1 sekondë, dhe përdorimi i të dhënave është aq i ulët, sa shpenzimet për S3 janë shumë të vogla.
Së fundmi, më vunë përgjegjës për menaxhimin e mbi 25 TB të të dhënave të papërpunuara të gjenotipizimit për laboratorin tim. Kur fillova, përdorimi i spark merrte 8 minuta dhe kushtonte 20 dollarë për të kërkuar një SNP. Pas përdorimit të AWK + për procesimin, tani zgjat më pak se një të dhjetën e sekondës dhe kushton 0.00001 dollarë. Fitimi im personal arth.
— Nick Strayer (@NicholasStrayer)
Përfundim
Ky artikull nuk është një udhëzues fare. Zgjidhja rezultoi të ishte individuale dhe pothuajse me siguri jo optimale. Në të vërtetë, ky është një tregim për një udhëtim. Dua që të tjerët të kuptojnë se zgjidhjet e tilla nuk ndodhin plotësisht të formuara në mendje, ato janë rezultat i provave dhe gabimeve. Për më tepër, nëse jeni në kërkim të një specialisti në analizën e të dhënave, merrni parasysh se për përdorimin efektiv të këtyre instrumenteve nevojitet përvojë, dhe përvoja kërkon para. Jam i lumtur që pata fonde për të paguar, por shumë të tjerë, që mund të bëjnë punën e njëjtë më mirë se unë, kurrë nuk do të kene këtë mundësi për shkak të mungesës së parave edhe për të provuar.
Mjetet për të dhëna të mëdha janë universale. Nëse keni kohë, pothuajse me siguri do të jeni në gjendje të shkruani një zgjidhje më të shpejtë duke aplikuar "pastrimin inteligjent" të të dhënave, ruajtjen dhe metodologjitë e nxjerrjes. Në fund të fundit, gjithçka vjen në analizën e shpenzimeve dhe përfitimeve.
Çfarë kam mësuar:
- nuk ka një mënyrë të lirë për të procesuar 25 TB të dhëna njëherësh;
- të jeni të kujdesshëm me madhësinë e skedarëve tuaj Parquet dhe organizimin e tyre;
- particionet në Spark duhet të jenë të balancuara;
- kurrë mos përpiquni të krijoni 2.5 milion partitore;
- grupimi mbetet i vështirë, ashtu si konfigurimi i Spark;
- ndonjëherë të dhënat e veçanta kërkojnë zgjidhje të veçanta;
- bashkimi në Spark funksionon shpejt, por partitoret ende kanë kosto të larta;
- mos flini kur ju mësojnë bazat, sigurisht që dikush tashmë e ka zgjidhur problemin tuaj që në vitet 1980;
gnu parallel- është një gjë magjike, të gjithë duhet ta përdorin;- Spark preferon të dhëna të pakompresuara dhe nuk dëshiron të kombinojë partitoret;
- në Spark ka shumë overhead për zgjidhjen e problemeve të thjeshta;
- çfarë grupimeve associative në AWK janë shumë efikase;
- mund të adresohet
stdindhestdoutnga skripti R, kështu që mund ta përdorësh atë në pipeline; - falë implementimit inteligjent të ndalesave S3 mund të përpunojë shumë skedarë;
- arsyeja kryesore e humbjes së kohës është optimizimi i parakohshëm i metodës suaj të ruajtjes;
- mos u përpiqni të optimizoni detyrat manualisht, lejoni kompjuterin ta bëjë atë;
- API duhet të jetë i thjeshtë për thjeshtësinë dhe fleksibilitetin e përdorimit;
- nëse të dhënat tuaja janë të përgatitura mirë, cache do të jetë i lehtë!
Burimi: habr.com
