

Puna kërkimore është, ndoshta, pjesa më interesante e edukimit tonë. Ideja është që edhe në universitet të provoni veten në drejtim të zgjedhur. Për shembull, studentët nga degët Software Engineering dhe Machine Learning shpesh kryejnë kërkime në kompani (në shumicën e rasteve, JetBrains ose Yandex, por jo vetëm).
Në këtë postim do të flas për projektin tim në fushën e Shkencës Kompjuterike. Në kuadër të punës, studova dhe implementova në praktikë qasje për zgjidhjen e një prej problemeve më të njohura NP-të vështira: problemi i mbulimit të majave.
Aktualisht, një qasje interesante ndaj problemeve NP-të vështira po zhvillohet shumë shpejt — algoritmet parametrike. Do të përpiqem t'ju njoh me këtë çështje, të flas për disa algoritme parametrike të thjeshta dhe të përshkruaj një metodë të fuqishme, e cila më ka ndihmuar shumë. Rezultatet e mia i prezantova në garën PACE Challenge: sipas testeve të hapura, zgjidhja ime zë vendin e tretë, dhe rezultatet përfundimtare do të njoftohen më 1 korrik.
Për vetë
Jam Vasily Alfërov, tani po përfundoj vitin e tretë në HSE — Shën Petersburg. Më janë pëlqyer algoritmet që nga koha e shkollës kur isha në shkollën 179 të Moskës dhe merrja pjesë me sukses në olimpiada të informatikës.
Një numër i fundit specialistësh për algoritmet parametrike hyjnë në një bar...
Shembulli është marrë nga libri
Imagjinoni se jeni roje në një bar në një qytet të vogël. Çdo të premte, gjysma e qytetit vjen në barin tuaj për t'u relaksuar, çka ju shkakton shumë telashe: duhet të nxirrni nga barra vizitorët e trazuar për të parandaluar ndodhitë. Në fund të fundit, ju mërzitet dhe vendosni të merrni masa parandaluese.
Duke qenë se qyteti është i vogël, ju e dini përfundimisht se cilat çifte vizitorësh me probabilitet të lartë do të grinden nëse hynë në bar së bashku. Keni një listë të n personave që do të vijnë sonte në bar. Vendosni të mos i lejoni disa banorë në bar në një mënyrë që askush të mos përfshihet në një rrebesht. Në të njëjtën kohë, shefi juaj nuk dëshiron të humbasë fitimet dhe do të jetë i pakënaqur nëse nuk lejoni më shumë se k persona.
Fatkeqësisht, problemi që keni përpara është një problem klasik NP-të vështirë. Mund të ketë qenë e njohur si , ose si për problemin e mbulimit të pikave. Për këto lloje problemesh, në përgjithësi nuk dihen algoritma që funksionojnë në një kohë të pranueshme. Nëse jemi saktë, hipoteza e pa provuar dhe mjaft e fortë ETH (Hipoteza e Kohës Eksponenciale) thotë se ky problem nuk zgjidhet brenda një kohe  , dmth nuk ka ndonjë zgjidhje që është dukshëm më e mirë se sa përmbytja e plotë. Për shembull, le të supozojmë se do të vijë në barin tuaj n = 1000 njerëz. Pastaj, përmbytja e plotë do të përmbante
 mundësi, që është përafërsisht
 — jashtëzakonisht shumë. Për fat të mirë, udhëheqja juaj ju ka vënë një kufi k = 10, kështu që numri i kombinimeve që duhet të shqyrtoni është shumë më i vogël: numri i nëngrupeve me dhjetë elemente është
 . Kjo është më mirë, por përsëri nuk do të numërohet brenda një dite madje as në një klaster të fuqishëm.
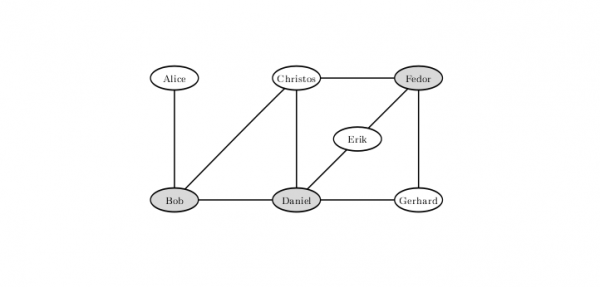
Për të përjashtuar mundësinë e një rrethimi në një konfigurim të tillë të tensioneve ndërmjet vizitorëve të barit, duhet të mos lejoni Bobin, Danielin dhe Fyodorin. Zgjidhjet, ku ngelën vetëm dy, nuk ekzistojnë.
A do të thotë kjo se është koha të dorëzoheni dhe të lejoni të gjithë? Le të shqyrtojmë mundësi të tjera. Pra, për shembull, mund të mos lejoni vetëm ata që përballen me një numër shumë të madh njerëzish. Nëse dikush mund të përballet me të paktën k + 1 njerëz të tjerë, atëherë ai nuk duhet lejuar — përndryshe do të duhet të mos lejoni të gjithë k + 1 banorët, me të cilët mund të përballet, që do të shqetësojë udhëheqjen.
Le të supozojmë se keni hequr të gjithë ata që mundët me këtë parim. Pastaj, të gjithë të tjerët mund të përballen me më shumë se k njerëz. Duke hequr prej tyre k njerëz, mund të parandaloni më shumë se  konflikte. Kështu, nëse gjithsej më shumë se
 njerëz marrin pjesë në të paktën një konflikt, atëherë me siguri nuk do të mund të parandaloni të gjithë. Gjithashtu, është e qartë se njerëzit që fare nuk kanë konflikte duhet patjetër t'i lejoni, kështu që duhet të shqyrtoni të gjitha nëngrupet me madhësi dhjetë nga dyqind njerëz. Ato janë përafërsisht
 , dhe një sasi e tillë operimesh tashmë mund të shqyrtohet në një klaster.
Nëse mund të marrim personalitete tërësisht jo konfliktuale, çfarë ndodh me ata që marrin pjesë vetëm në një konflikt? Në të vërtetë, ata gjithashtu mund të priten, duke mbyllur dyert përpara kundërshtarit të tyre. Në fakt, nëse Alicia ka një konflikt vetëm me Bobin, nëse pranojmë Alician nga ata dy, ne nuk do të humbim: Bobi mund të ketë konflikte të tjera, ndërsa Alicia sigurisht nuk ka. Për më tepër, është pa kuptim të mos lejojmë asnjërin. Pas këtyre operacioneve, mbeten jo më shumë se  mysafirë me fatin e pazgjidhur: gjithsej kemi
 konflikte, ku secili ka dy pjesëmarrës dhe secili merr pjesë të paktën në dy. Pra, mbetet të zgjidhen vetëm
 mundësi, që mjafton për të llogaritur brenda një gjysmë dite në një laptop.
Në të vërtetë, me arsyetim të thjeshtë mund të arrijmë kushte edhe më atraktive. Vërejmë se na nevojitet të zgjidhim të gjitha mosmarrëveshjet, pra nga çdo çift konfliktual të zgjedhim të paktën një njeri, që nuk do ta pranojmë. Le të shqyrtojmë një algoritëm të tillë: të marrim ndonjë konflikt, nga i cili heqim një pjesëmarrës dhe të fillojmë rekursivisht nga pjesa që mbetet, pastaj të heqim tjetrin dhe gjithashtu të fillojmë rekursivisht. Duke qenë se në çdo hap heqim dikë, struktura e rekursions së këtij algoritmi është një pemë binarë me thellësi k, pra algoritmi punon për një total prej  index n – numri i majave, dhe m – numri i faltave. Në shembullin tonë, ky numër është rreth dhjetë milionë, që llogaritet për shpejtësi nën sekonda jo vetëm në laptop, por edhe në një telefon mobil.
Shembulli i mësipërm është një shembull i algoritmit të parametrizuar. Algoritmet e parametrizuar janë ato algoriteme që punojnë në kohë f(k) poly(n)index p – polinom, f – funksion i llogaritshëm, dhe k – ndonjë parameter, i cili, është tepër mundshëm, do të jetë shumë herë më i vogël se madhësia e problemit.
Të gjitha arsyetimet deri në këtë algoritëm çojnë në shembullin kërnelizimit — një nga teknikët e zakonshme për krijimin e algoritmëve të parameterizuar. Kernelizimi është zvogëlimi i madhësisë së detyrës në një vlerë të kufizuar nga funksioni i parametrave. Detyra e marrë shpesh quhet bërthamë. Kështu, me arsyetime të thjeshta mbi shkallët e pikëve, arritëm një bërthame katrore për detyrën e Vertex Cover, e parametrizuar sipas madhësisë së përgjigjes. Ekzistojnë edhe parametra të tjerë që mund të zgjidhen për këtë detyrë (për shembull, Vertex Cover Above LP), por ne do të diskutojmë pikërisht këtë parametrin.
Pace Challenge
Garë (The Parameterized Algorithms and Computational Experiments Challenge) u themelua në vitin 2015 për të vendosur lidhjen midis algoritmëve të parametrizuar dhe qasjeve që përdoren në praktikë për zgjidhjen e problemeve kompjuterike. Garat e para tre ishin të dedikuara për kërkimin e gjerësi së pemës së grafit (), kërkimin e pemës së Steinert () dhe kërkimin e një grupi pikash që prishin ciklet (). Në këtë vit, një nga detyrat në të cilat mund të provoheshin aftësitë ishte detyra e mbuluar nga pika e përmendur më sipër.
Gara po fiton popullaritet çdo vit. Nëse besoni të dhënat paraprak, këtë vit në garën për zgjidhjen e detyrës së mbulimit të pikave morën pjesë 24 ekipe. Vlen të theksohet se gara nuk zgjat disa orë dhe as një javë, por disa muaj. Ekipet kanë mundësinë të studiojnë literaturën, të mendojnë një ide origjinale dhe të përpiqen ta realizojnë atë. Në thelb, kjo garë përfaqëson një punë kërkimore. Ideja e zgjidhjeve më efektive dhe shpallja e fituesve do të ndodhin së bashku me konferencën (International Symposium on Parameterized and Exact Computation) brenda mbledhjes më të madhe vjetore algorithmi në Europë . Informacione më të hollësishme mbi garën vetë mund të gjenden në , dhe rezultatet e viteve të kaluara janë të vendosura .
Schemi i zgjidhjes
Për të përballuar detyrën e mbulimit të majave, provova të aplikoj algoritme të parametrizuara. Ato, në përgjithësi, përbëhen nga dy pjesë: rregullat e thjeshtimit (të cilat në mënyrë ideale çojnë në kernelizim) dhe rregullat e ndarjes. Rregullat e thjeshtimit janë një përgatitje e hyrjes në kohë polinomiale. Qëllimi i aplikimit të këtyre rregullave është të reduktojë detyrën në një detyrë ekuivalente me një madhësi më të vogël. Rregullat e thjeshtimit janë pjesa më e kushtueshme e algoritmit, dhe aplikimi i kësaj pjesë çon në një kohë totale të funksionimit  në vend të kohës së thjeshtë polinomiale. Në rastin tonë, rregullat e ndarjes janë të bazuara në faktin se për çdo majë duhet të marrim si përgjigje ose atë, ose fqinjën e saj.
Schemi i përgjithshëm është ky: aplikojmë rregullat e thjeshtimit, pastaj zgjedhim ndonjë majë dhe bëjmë dy thirrje_recursive: në të parën ne e marrim atë si përgjigje, ndërsa në të dytën marrim të gjithë fqinjët e saj. Kjo e quajmë ndarje (brancho) nëpërmjet kësaj maje.
Në këtë skemë do të bëhet pikërisht një shtesë në paragrafin e ardhshëm.
Ide për rregullat e ndarjes (brancho)
Le të diskutojmë si të zgjedhim një majë, për të cilën do të ndodhë ndarja.
Ideja kryesore është shumë lakmitare në kuptimin algoritmik: le të marrë një majë me gradë maksimale dhe të ndajmë përmes saj. Pse duket se kështu është më mirë? Sepse në degën e dytë të thirrjes_recursive ne në këtë mënyrë do të heqim shumë maja. Mund të presim se do të mbeten një grafik i vogël dhe mbi të do të punojmë shpejt.
Ky qasje me teknikat e thjeshta të diskutuar për kernelizimin tregon rezultate të mira, zgjidh disa teste me mijëra maja. Por, për shembull, nuk funksionon mirë për grafikat kubike (domethënë grafikat, ku grada e çdo maje është e barabartë me tre).
Ka një ide tjetër, e bazuar në një mendim mjaft të thjeshtë: nëse grafiku është i palidhur, detyrën mbi komponentët e tij lidhur mund ta zgjidhim në mënyrë të pavarur, duke kombinuar përgjigjet në fund. Kjo, për fat të keq, është një modifikim i vogël i premtuar në skemë, që do të përshpejtojë zgjidhjen: më parë në një rast të tillë ne punonim me shumën e kohëve të llogaritjes së përgjigjeve të komponentëve, ndërsa tani punojmë me shifrën e tyre. Dhe për të përshpejtuar ndarjen, duhet të kthejmë grafikun e lidhur në një grafik të palidhur.
Si si e bërë? Nëse grafi ka një pikë bashkimi, duhet të branchojmë pikërisht aty. Pika e bashkimin është maja e tillë, me zhdukje të së cilës grafi humbet lidhshmërinë. Të gjitha pikët e bashkimit në graf mund të gjenden me një algoritëm klasik në kohë lineare. Ky qasje ndjeshëm përshpejton branchoimin.
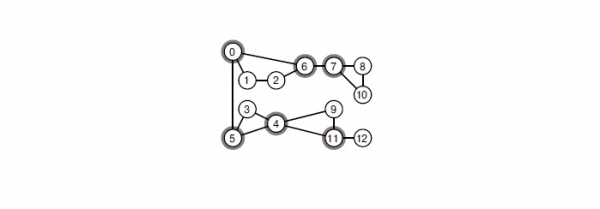
Me heqjen e cilësdo prej kulmëve të veçuara, grafi do të shpërbëhet në componente lidhshmërie.
Këtë do ta bëjmë, por dëshirojmë më shumë. Për shembull, të kërkojmë në graf prerje të vogla kulmore dhe të kryejmë ndarje sipas kulmëve në të. Mënyra më efikase që e njoh për të gjetur prerjen minimale globale kulmore është të përdorim pemën Gomori-Hu, e cila ndërtohet në kohë kubike. Në PACE Challenge, përmasat tipike të grafit janë disa mijëra kulme. Në këtë rast, në secilën kulm të recursit duhen kryer miliarda operacione. Kështu, zgjidhja e problemit brenda kohës së caktuar është thjesht e pamundur.
Le të përpiqemi të optimizojmë zgjidhjen. Prerja minimale kulmore midis një çifti kulmesh mund të gjendet me ndihmën e çdo algoritmi që ndërton fluks maksimal. Mund të përdorim në një rrjet të tillë , në praktikë ai punon shumë shpejt. Kam dyshime se teorikisht është e mundur të provohet një vlerësim për kohën e funksionimit  , që është tashmë mjaft e pranueshme.
Kam provuar disa herë të kërkoj prerje midis çifteve të kulmeve të rastësishme dhe të marr nga ato më të balancuara. Fatkeqësisht, në provat e hapura të PACE Challenge, kjo jap një rezultat të keq. Kam krahasuar me algoritmin që ndan në kulmet me gradën maksimale, duke i drejtuar ato me një kufizim në thellësinë e zbritjes. Pas algoritmit që përpiqet të gjejë prerjen në këtë mënyrë, mbetën grafe të mëdha. Kjo është për shkak se prerjet ishin shumë të papërshtatshme: duke hequr 5-10 kulme, arrinim të izolojmë vetëm 15-20.
Duhet të theksohet se në artikujt që flasin për algoritmet më të shpejta teorike, përdoren teknika shumë më të avancuara për zgjedhjen e kulmeve për ndarje. Këto teknika kanë një realizim shumë të komplikuar dhe shpesh ofrojnë vlerësime të dobëta për kohën dhe kujtesën. Nuk arrita të theksoj ndonjë nga to si mjaft të pranueshme për praktikën.
Si të aplikoni rregullat e thjeshtimit
Kemi tashmë ide për kernelizimin. Më kujtohet:
- Nëse ka një kulm të izoluar, hiqeni atë.
- Nëse ka një kulm me gradë 1, hiqeni atë dhe merrni fqinjit e saj si përgjigje.
- Nëse ka një kulm me gradë të paktën k + 1, merreni atë si përgjigje.
Me dy të parat gjithçka është e qartë, me të tretin ka një hile. Nëse në problemin e humorit rreth barit na u dha një kufizim të sipërm për k, në PACE Challenge thjesht duhet të gjejmë një mbulim kulmor të madhësisë minimale. Ky është një transformim tipik i problemeve të kërkimit (Search Problem) në problemet e zgjidhjes (Decision Problem), shpesh nuk bëhet ndonjë dallim midis dy llojeve të problemeve. Në praktikë, nëse ne shkruajmë një zgjidhës për problemin e mbulimit kulmor, dallimi mund të ekzistojë. Për shembull, siç është në pikën e tretë.
Nga pikëpamja e zbatimit, mund të veprohet në dy mënyra. Qasja e parë quhet Iterative Deepening. Ajo përbëhet nga kjo: ne mund të fillojmë me një kufizim të arsyeshëm poshtë për përgjigjen, dhe më pas të fillojmë algoritmin tonë duke përdorur këtë kufizim si kufizim të sipërm për përgjigjen, pa shkuar në rekursivë më poshtë se ky kufizim. Nëse kemi gjetur një përgjigje, ajo është garantuar të jetë optimale, ndryshe mund të rrisim këtë kufizim me një dhe të fillojmë përsëri.
Qasja tjetër është të mbajmë një ndonjë përgjigje aktuale optimale dhe të kërkojmë një përgjigje me një madhësi më të vogël, duke ndryshuar këtë parametër kur e gjejmë k për të bërë ndonjë prerje të madhe të degëve të kota në kërkim.
Pas disa eksperimenteve gjatë natës, u ndala te kombinimi i këtyre dy mënyrave: fillimisht e filloj algoritmin tim me një kufizim për thellësinë e kërkimit (duke e zgjedhur atë, që të marrë një kohë të parëndësishme në krahasim me zgjidhjen kryesore) dhe e përdor zgjidhjen më të mirë të gjetur si kufizim të sipërm për përgjigjen — pra, për ate të njëjtën k.
Kulmet me gradë 2
Me kulmet me gradë 0 dhe 1 e dimë. Raste që kjo mund të bëhet edhe me kulmet me gradë 2, por për këtë do të kërkohen operacione më të ndërlikuara në graf.
Për ta shpjeguar këtë, duhet ndonjëherë të shënohet kulmi. Le ta quajmë kulmin me gradë 2 si kulm v, dhe fqinjit e tij si kulmet x dhe y. Më pas do të kemi dy raste.
- Kur x dhe y — fqinjit. Atëherë mund të marrim si përgjigje x dhe y, ndërsa v heqim. Dhe me të vërtetë, nga ky trekëndësh duhet të marrim së paku dy kulme në përgjigje dhe ne me siguri nuk do të humbasim, nëse marrim x dhe y: ndoshta kanë edhe fqinj tjetër, ndërsa v ata nuk kanë.
- Kur x dhe y — nuk janë fqinj. Atëherë pretendohet se të tri majat mund të ngjiten në një. Ideja është që në këtë rast ka një odgovor optimal, në të cilin do të marrim ose v, ose të dy majat x dhe y. Ndërsa në rastin e parë do të duhet të marrim në përgjigje të gjithë fqinjët x dhe y, ndërsa në të dytin nuk është e domosdoshme. Kjo saktësisht përputhet me rastet kur ne nuk marrim majën e ngjitur në përgjigje dhe kur marrim. Mbetet vetëm të theksojmë se në të dy rastet, përgjigja nga një operacion i tillë zvogëlohet me një njësi.
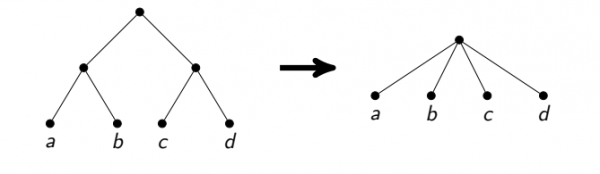
Duket se ky qasje është mjaft e komplikuar për t'u realizuar me saktësi në kohë lineare. Ngjitja e majave është një operacion kompleks, duhet të kopjoni listat e fqinjëve. Nëse kjo nuk bëhet me kujdes, mund të merrni një kohë funksionimi asimptotikisht jo optimale (p.sh., nëse pas çdo ngjitjeje kopjoni shumë boshte). U ndala në kërkimin e rrugëve të plota nga majat me gradë 2 dhe analizimin e shumë rasteve të veçanta, si ciklet nga këto maja ose nga të gjitha këto maja përveç një.
Për më tepër, është e nevojshme që ky operacion të jetë i kthyeshëm, në mënyrë që gjatë kthimit nga rekursioni të rikthejmë grafikun në formën e tij fillestare. Për ta siguruar këtë, nuk e pastruar listat e boshteve të majave të bashkuara, pasi e dija thjesht se cilat boshte duhej të dërgoheshin në cilin drejtim. Kjo realizim e grafikëve gjithashtu kërkon kujdes, por siguron kohë të drejtë lineare. Dhe për grafikët me disa dhjetëra mijëra boshte, ajo përshtatet mirë në cache-in e procesorit, që jep përparësi të mëdha në shpejtësi.
Nukleusi lineare
Së fundi, pjesa më interesante e nukleusit.
Për të filluar, le të kujtojmë se në grafikët bipartit minimal mbulimi i majave mund të kërkohet për  . Për këtë nevojitet të shfrytëzohet algoritmi për të gjetur aty përputhjen maksimale, dhe më pas të shfrytëzojmë teoremën .
Ideja e nukleusit linear është kështu: fillimisht e dyfishojmë grafikën, dmth në vend të çdo maja v ngremë dy maja  dhe
 , dhe në vend të çdo boshte u — v ngremë dy boshte
 dhe
 Grafiku i marrë do të jetë dypartiak. Ne do të gjejmë mbulimin minimal të qosheve në të. Disa qoshe të grafikut fillestar do të bien aty dy herë, disa vetëm një herë, dhe disa asnjëherë. Teorema e Nemhauser-Trotter thotë se në këtë rast mund të hiqen qoshet që nuk kanë rënë asnjëherë dhe të merret si përgjigje atyre që ra dy herë. Më shumë se kaq, ajo thotë se nga qoshet e mbetura (ato që kanë rënë një herë), duhet të merret si përgjigje të paktën gjysma.
Sapo mësuam të lëmë në graf më pak se 2k qoshe. Në të vërtetë, nëse në mbetje përgjigja është të paktën gjysma e të gjitha qosheve, atëherë numri i përgjithshëm i qosheve nuk është më shumë se 2k.
Këtu arrita të bëj një hap të vogël përpara. Është e qartë se bërthama e ndërtuar në këtë mënyrë varet nga cili mbulim minimal i qosheve në grafikun dypartiak kemi marrë. Dëshironi të merrni një të tillë që numri i qosheve të mbetura të jetë minimal. Më parë, kjo ka qenë e mundur të bëhet vetëm për një kohë  . Unë shpika një realizim të këtij algoritmi për një kohë
 , kështu që kjo bërthamë mund të kërkohet në grafika me qindra mijëra qoshe në çdo etapë të branchnimit.
Rezultati
Praktika tregon se zgjidhja ime funksionon mirë në testet me disa qindra qoshe dhe disa mijëra brezash. Në këto teste, është plotësisht e mundur të pritet që zgjidhja të gjendet brenda gjysmë ore. Shtysa për të gjetur një përgjigje brenda një kohe të pranueshme në parim rritet nëse në grafik ka mjaft qoshe me grado të madhe, për shembull grado 10 dhe më sipër.
Për të marrë pjesë në garë, zgjidhjet duhej të dërgoheshin në . Duke gjykuar nga tabela e paraqitur atje , zgjidhja ime në testet e hapura zë vendin e tretë nga vinte me shumë distancë nga vendi i dytë. Nëse të jesh krejtësisht i sinqertë, nuk është krejtësisht e qartë se si do të vlerësohen zgjidhjet në garën e vërtetë: për shembull, zgjidhja ime kalon më pak teste se zgjidhja e vendit të katërt, por në ato që kalon, funksionon më shpejt.
Rezultatet në testet e mbyllura do të bëhen të njohura më parë se 1 korriku.
Burimi: habr.com
