

Përshëndetje, Hajrosh! Kjo libër është e përshtatshme për çdo zhvillues që dëshiron të kuptojë trajtimin e rrjedhave. Kuptimi i programimit të shpërndarë do të ndihmojë në studimin më të mirë të Kafka dhe Kafka Streams. Do të ishte mirë të njihni edhe vetë framework-un Kafka, por kjo nuk është e domosdoshme: unë do t'ju them gjithçka që duhet. Zhvilluesit e përvojës në Kafka, ashtu si dhe ata të rinjtë, do të mësojnë të krijojnë aplikacione interesante për trajtimin e rrjedhave me bibliotekën Kafka Streams falë këtij libri. Zhvilluesit Java të nivelit të mesëm dhe të lartë, të cilët janë tashmë të njohur me koncepte si serializimi, do të mësojnë të aplikojnë aftësitë e tyre për krijimin e aplikacioneve Kafka Streams. Kodi burimor i librit është shkruar në Java 8 dhe ndihmon thelbësisht në përdorimin e sintaksës së shprehjeve lambda në Java 8, kështu që aftësia për të punuar me funksionet lambda (edhe në një gjuhë tjetër programimi) do t'ju ndihmojë.
Fragment. 5.3. Agregimi dhe operacionet e dritareve
Në këtë seksion do të kalojmë në studimin e pjesëve më premtuese të Kafka Streams. Deri tani kemi shqyrtuar aspektet e mëposhtme të Kafka Streams:
- krijimi i topologjisë së trajtimit;
- përdorimi i gjendjes në aplikacionet e rrjedhave;
- kryerja e lidhjeve të rrjedhave të të dhënave;
- dallimet midis rrjedhave të ngjarjeve (KStream) dhe rrjedhave të përditësimeve (KTable).
Në shembujt e ardhshëm ne do të mbledhim të gjitha këto elemente së bashku. Për më tepër, do të njihni operacionet e dritareve — një tjetër mundësi të shkëlqyer për aplikacionet e rrjedhave. Shembulli ynë i parë do të jetë agregimi i thjeshtë.
5.3.1. Agregimi i volumit të shitjeve të aksioneve sipas sektorëve të industrisë
Agregimi dhe grupimi janë mjete jetësore kur punoni me të dhëna të rrjedhave. Kërkimi i regjistrimeve të veçanta në momentin e marrjes shpesh nuk është i mjaftueshëm. Për të nxjerrë informacione shtesë nga të dhënat, nevojitet grupimi dhe kombinimi i tyre.
Në këtë shembull do të duhet të vishni kostumin e një tregtari intraditar, i cili duhet të ndjekë volumet e shitjeve të aksioneve të kompanive në disa sektorë të industrisë. Në veçanti, do t'ju interesojnë pesë kompanitë me volumin më të madh të shitjeve të aksioneve në secilin nga sektorët e industrisë.
Për një agregim të tillë do të nevojiten disa hapa në përkthimin e të dhënave në formatin e duhur (nëse flasim në terma të përgjithshëm).
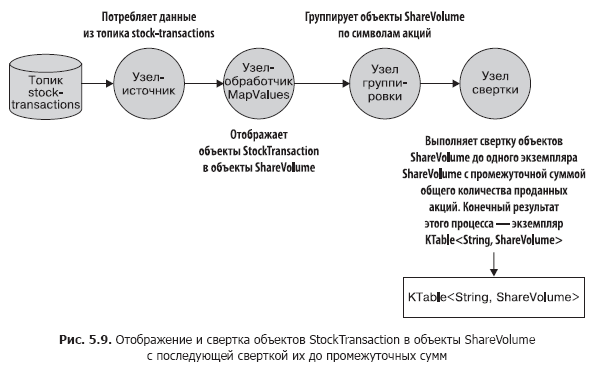
- Krijo një burim bazuar në temën që publikojnë informacionin e papërpunuar mbi tregtinë e aksioneve. Ne do të duhet të shfaqim një objekt të llojit StockTransaction në një objekt të llojit ShareVolume. Problemi është se objekti StockTransaction përmban informacionin mbi shitjet, ndërsa ne na duhen vetëm të dhënat për numrin e aksioneve të shitura.
- Gruponi të dhënat ShareVolume sipas simboleve të aksioneve. Pas grupimit sipas simboleve, këto të dhëna mund të shkurtohen në shuma të përkohshme të volumit të shitjeve të aksioneve. Vlen të theksohet se metoda KStream.groupBy kthen një instancë të llojit KGroupedStream. Ndërsa për të marrë një instancë të KTable, mund të thërrisni më pas metodën KGroupedStream.reduce.
Çfarë është interfaca KGroupedStream
Metodat KStream.groupBy dhe KStream.groupByKey kthejnë një instancë KGroupedStream. KGroupedStream është një përfaqësim përkohës i rrjedhës së ngjarjeve pas grupimit sipas çelësave. Ai nuk është në të vërtetë i destinuar për t'u punuar drejtpërdrejt me të. Në vend të kësaj, KGroupedStream përdoret për operacionet e agregimit, rezultati i të cilave gjithmonë është një KTable. Dhe pasi rezultatet e operacioneve të agregimit janë një KTable dhe në to aplikohet një depo e gjendjes, ndoshta nuk të gjitha përditësimet e rezultateve dërgohen më tutje në tub.
Metoda KTable.groupBy kthen një KGroupedTable të ngjashëm — një përfaqësim përkohës të rrjedhës së përditësimeve, të ribashkuara sipas çelësit.
Le të bëjmë një pushim të vogël dhe të shikojmë fig. 5.9, e cila tregon atë që arritëm. Kjo topologji duhet të jetë e njohur për ju tashmë.
Tani, le të shikojmë kodin për këtë topologji (mund ta gjeni në skedarin src/main/java/bbejeck/chapter_5/AggregationsAndReducingExample.java) (listing 5.2).
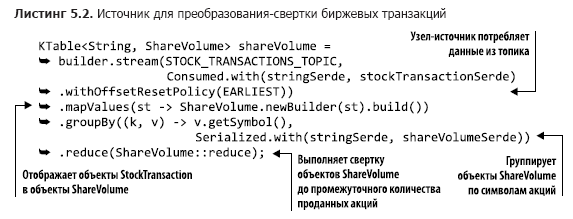
Kodi i dhënë është i shkurtër dhe përmban shumicën e veprimeve të realizuara në disa rreshta. Në parametrin e parë të metodës builder.stream mund të vini re diçka të re për ju: vlera e enumerimit AutoOffsetReset.EARLIEST (ekziston gjithashtu dhe LATEST), e cila përcaktohet nga metoda Consumed.withOffsetResetPolicy. Me këtë enumerim mund të përcaktoni strategjinë e riciklimit të offseteve për çdo KStream ose KTable, e cila ka prioritet mbi parametrin e riciklimit të offseteve nga konfigurimi.
GroupByKey dhe GroupBy
Në interfesën KStream ka dy metoda për të grupuar regjistrat: GroupByKey dhe GroupBy. Të dyja kthejnë një KGroupedTable, kështu që mund të keni një pyetje të natyrshme: çfarë është ndryshimi midis tyre dhe kur të përdorni cilin nga ato?
Metoda GroupByKey aplikohet kur çelësat në KStream janë tashmë të plotë. Më e rëndësishmja, flagu 'kërkon ripjesëzimin' nuk është vendosur asnjëherë.
Metoda GroupBy supozon se keni ndryshuar çelësat për grupimin, kështu që flagu i ripjesëzimit është vendosur në true. Ekzekutimi pas metodës GroupBy i bashkimeve, agregimeve dhe të tjerave do të çojë në ripjesëzim automatik.
Përmbledhje: duhet të përdorni GroupByKey sa herë që është e mundur dhe jo GroupBy.
Çfarë bëjnë metodat mapValues dhe groupBy është e qartë, kështu që le të shikojmë metodën sum() (mund ta gjeni në skedarin src/main/java/bbejeck/model/ShareVolume.java) (lista 5.3).
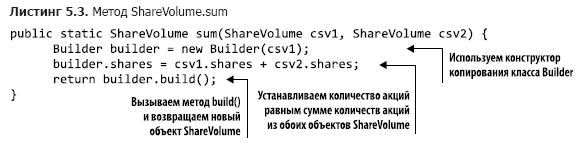
Metoda ShareVolume.sum kthehet shumen e ndërmjetme të vëllimit të tregtisë së aksioneve, dhe rezultati i gjithë zinxhirit të llogaritjeve paraqet një objekt KTable. Tani e kuptoni se çfarë roli luan KTable. Kur objekto ShareVolume arrijnë, përditësimi më i fundit ruhet në objektin përkatës KTable. Është e rëndësishme të mos harrohet se të gjitha përditësimet reflektohen në shareVolumeKTable të mëparshëm, por jo të gjitha dërgohen më tutje.
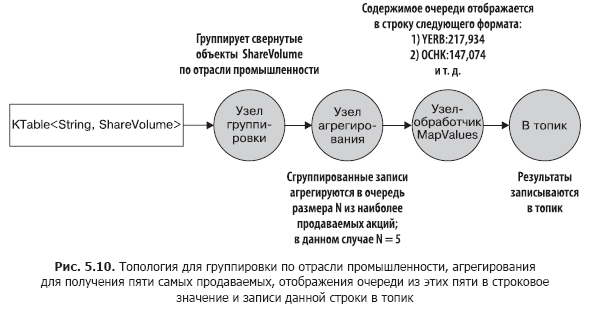
Më pas, me këtë KTable kryejmë agregimin (sipër sasisë së aksioneve të shitur), për të marrë pesë kompanitë me vëllimet më të mëdha të tregtisë së aksioneve në çdo industri. Veprimet tona do të jenë të ngjashme me veprimet në agregimin e parë.
- Kryeni një operacion më të grupimit për të grupuar objektet ShareVolume sipas industrive.
- Vazhdoni me shumimin e objekteve ShareVolume. Kësaj here, objekti i agregimit është një radhë me prioritet të madhësisë fikse. Në këtë radhë me madhësi fikse ruhet vetëm pesë kompanitë me sasinë më të madhe të aksioneve të shitura.
- Shfaqni radhën e mëparshme në një vlerë string dhe ktheni pesë aksionet më të shitura sipas sasisë për industrinë.
- Shkruani rezultatet në formatin e stringut në temën.
Në figurën 5.10 shfaqet grafiku i topologjisë së lëvizjes së të dhënave. Siç e shihni, cikli i dytë i përpunimit është mjaft i thjeshtë.
Tani, duke e kuptuar qartë strukturën e këtij cikli të dytë të përpunimit, mund të referoheni në kodin e tij burimor (do ta gjeni në skedarin src/main/java/bbejeck/chapter_5/AggregationsAndReducingExample.java) (lista 5.4).
Në këtë inicializues ka një variablë fixedQueue. Ky është një objekt personal - një adapter për java.util.TreeSet, i cili përdoret për të ndjekur N rezultatet më të mëdha në rend në rënie të numrit të aksioneve të shitura.
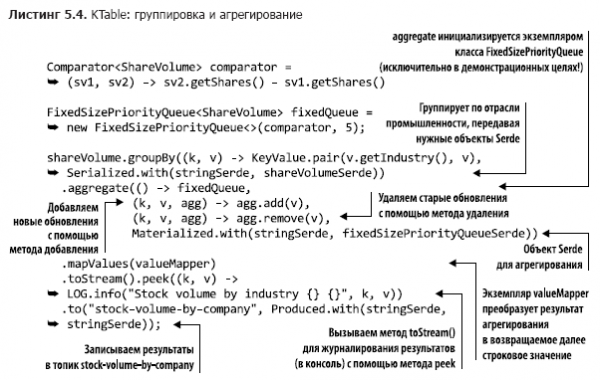
Ju tashmë keni hasur me thirrjet groupBy dhe mapValues, kështu që nuk do të ndalemi te to (ne thërrasim metodën KTable.toStream, pasi metoda KTable.print është e vjetër). Por ende nuk keni parë versionin KTable të metodës aggregate(), kështu që do të kalojmë pak kohë për ta diskutuar atë.
Siç e mbani mend, KTable karakterizohet nga fakti se regjistrimet me çelësa të njëjtë konsiderohen si përditësime. KTable zëvendëson regjistrimin e vjetër me një të re. Agregimi ndodh në një mënyrë të ngjashme: regjistrimet e fundit me një çelës agregohen. Kur një regjistrim arrin, ai shtohet në instancën e klasës FixedSizePriorityQueue me ndihmësin (parametri i dytë në thirrjen e metodës aggregate), por nëse tashmë ekziston një regjistrim tjetër me të njëjtin çelës, regjistrimi i vjetër fshihet me ndihmësin (parametri i tretë në thirrjen e metodës aggregate).
Kjo do të thotë se agregatori ynë, FixedSizePriorityQueue, në të vërtetë nuk agregon të gjitha vlerat me një çelës të vetëm, por ruan shumën lëshuese të sasisë N të llojeve të aksioneve më të shitura. Në çdo regjistrim që arrin, përmban shumën totale të aksioneve të shitura deri tani. KTable do t'ju japë informacion se cilat kompani kanë aksionet më të shitura në këtë moment, dhe agregimi lëshuese i çdo përditësimi nuk nevojitet.
Ne mësuam të bëjmë dy gjëra të rëndësishme:
- të grumbullojmë vlerat në KTable sipas një çelësi të përbashkët;
- të kryejmë operacione të dobishme si shkrirje dhe agregim mbi këto vlera të grumbulluara.
Të qenit në gjendje të kryejmë këto operacione është e rëndësishme për të kuptuar kuptimin e të dhënave që lëvizin përmes aplikacionit Kafka Streams dhe për të zbuluar informacionin e që ata bartin.
Ne kemi bashkuar gjithashtu disa nga konceptet kyçe që u diskutuan më parë në këtë libër. Në kapitullin 4, ne folëm për rëndësinë e gjendjes lokale për aplikacionet e transmetimit. Shembulli i parë në këtë kapitull demonstroi pse gjendja lokale është kaq e rëndësishme — ajo mundëson ndjekjen e informacionit që keni parë tashmë. Qasja lokale ndihmon për të evituar vonesat e rrjetit, duke i bërë aplikacionet më të shpejta dhe më të qëndrueshme ndaj gabimeve.
Kur kryeni çdo operacion të përmbledhjes ose agregatës, duhet të especificoni emrin e depozitës së gjendjes. Operacionet e përmbledhjes dhe agregatës kthejnë një ekzemplar KTable, dhe KTable përdor depozitën e gjendjes për të zëvendësuar rezultatet e vjetra me të rejat. Siç keni parë, jo të gjitha përditësimet dërgohen përpara në përpunim, dhe kjo është e rëndësishme, pasi operacionet e agregatës janë të destinuara për të marrë informacionin përfundimtar. Nëse nuk përdoret gjendja lokale, KTable do të dërgojë përpara të gjitha rezultatet e agregatës dhe përmbledhjes.
Më tej do të shqyrtojmë kryerjen e operacioneve si agregata brenda një intervali të caktuar — ato që quhen operacione dritare (windowing operations).
5.3.2. Operacione dritare
Në seksionin e mëparshëm u njohëm me përmbledhjen dhe agregatën "lëvizëse". Aplikacioni kryente një përmbledhje të vazhdueshme të vëllimit të shitjeve të aksioneve me një agregatë të pesë aksioneve më të shitura në bursë.
Ndonjëherë, këto agregata dhe përmbledhje të vazhdueshme janë të nevojshme. Dhe ndonjëherë, duhet të kryhen operacione vetëm mbi një interval të caktuar kohor. Për shembull, të llogarisim se sa operacione janë kryer mbi aksionet e një kompanie të caktuar në 10 minutat e fundit. Ose sa përdorues kanë klikuar mbi një banderola të re reklamuese në 15 minutat e fundit. Aplikacioni mund të kryejë këto operacione shumë herë, por me rezultate që i përkasin vetëm intervaleve të caktuara (dritareve të kohës).
Numërimi i transaksioneve të bursës sipas blerësit
Në shembullin e ardhshëm ne do të angazhohemi në ndjekjen e transaksioneve të bursës për disa tregtarë — ose organizata të mëdha, ose financistë të mençur individualë.
Ka janë dy arsye të mundshme për një ndjekje të tillë. Njëra prej tyre është nevoja për të ditur se çfarë blejnë/shesin liderët e tregut. Nëse këta lojtarë të mëdhenj dhe investitorë të njohur shohin mundësi që hapen për ta, ka kuptim të ndjekin strategjitë e tyre. Arsyeja tjetër është dëshira për të vërejtur çdo shenjë të mundshme të transaksioneve të paligjshme duke përdorur informacionin e brendshëm. Për këtë, do të nevojitet të analizoni korrelacionin mes shpërthimeve të mëdha të shitjeve dhe njoftimeve të rëndësishme për shtyp.
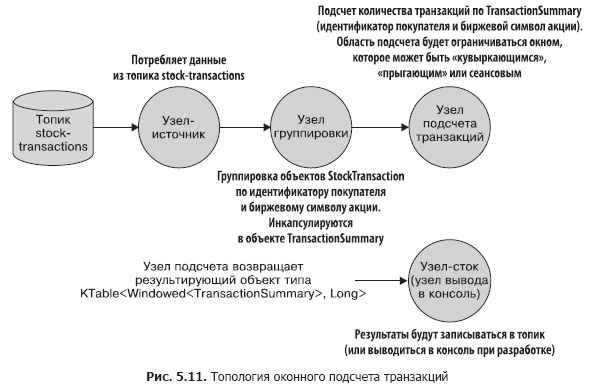
Kjo ndjekje përbëhet nga faza të tilla si:
- krijimi i një rrjedhe për lexim nga tema stock-transactions;
- grupimi i regjistrimeve të ardhura sipas identifikuesit të blerësit dhe simbolit të aksionit. Thirrja e metodës groupBy kthen një instancë të klasës KGroupedStream;
- kthimi me metodën KGroupedStream.windowedBy të një rrjedhe të dhënash të kufizuar nga një dritare kohore, e cila lejon kryerjen e agregimit të dritareve. Sipas llojit të dritares, kthehet ose TimeWindowedKStream ose SessionWindowedKStream;
- numërimi i transaksioneve për operacionin e agregimit. Rrjedha e dhënash të dritares përcakton nëse regjistrimi konkret përfshihet në këtë numërim;
- shënimi i rezultateve në temë ose dalja e tyre në konsol në kohën e zhvillimit.
Topologjia e këtij aplikacioni është e thjeshtë, por një pamje vizuale e saj nuk do të ishte e panevojshme. Le të shikojmë në figurën 5.11.
Më pas, do të shqyrtojmë funksionalitetin e operacioneve të dritareve dhe kodin përkatës.
Llojet e dritareve
Në Kafka Streams ekzistojnë tri lloje dritare:
- dritare sesionale;
- dritare 'tumbling' (kufizuese);
- dritare të lëvizshme/'hopping' (sliding/hopping).
Cila të zgjidhet — varet nga kërkesat biznesore. Dritaret 'tumbling' dhe 'hopping' kufizohen në kohë, ndërsa kufizimet e dritareve sesionale lidhen me veprimet e përdoruesve — gjatësi e sesioneve (në) përcaktohet ekskluzivisht nga sa aktiv është përdoruesi. E rëndësishme është të mos harrosh se të gjitha llojet e dritareve bazohen në etiketat e datës/kohës së regjistrimeve, dhe jo në kohën e sistemit.
Më pas, do të implementojmë topologjinë tonë me çdo lloj të dritareve. Kodi i plotë do të jepet vetëm në shembullin e parë, për llojet e tjera të dritareve nuk do të ketë asgjë të ndryshuar, përveç llojit të operacionit të dritareve.
Dritaret sesionale
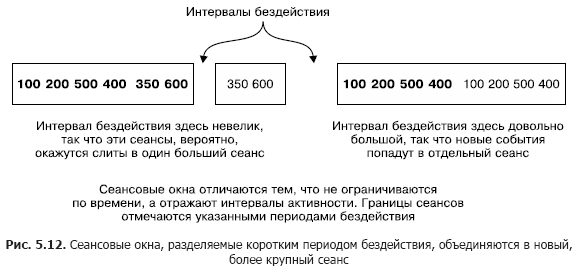
Dritaret e seancave dallojnë shumë nga të gjitha llojet e tjera të dritareve. Ato kufizohen jo aq shumë nga koha, sa nga aktiviteti i përdoruesit (ose aktiviteti i asaj entiteti që do të dëshironit të ndiqni). Dritaret e seancave ndahen në periudha pasiviteti.
Figura 5.12 ilustron konceptin e dritareve të seancave. Një seancë më e vogël do të shpërndajë me seancën në të majtë të saj. Ndërsa seanca në të djathtë do të jetë e veçantë, pasi ndjek një periudhë të gjatë pasiviteti. Dritaret e seancave bazohen në veprimet e përdoruesve, por përdorin etiketat e datës / orës nga regjistrimet për të përcaktuar se kujt seance i përket regjistrimi.
Përdorimi i dritareve të seancave për ndjekjen e transaksioneve të bursës
Le të përdorim dritaret e seancave për të kapur informacionin mbi transaksionet e bursës. Zbatimi i dritareve të seancave është i paraqitur në listimin 5.5 (i cili mund të gjendet në skedarin src/main/java/bbejeck/chapter_5/CountingWindowingAndKTableJoinExample.java).
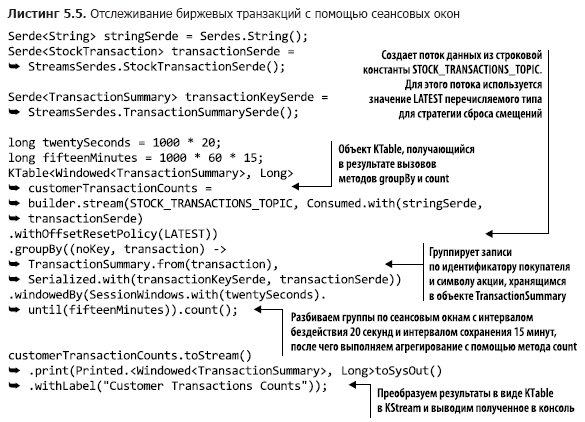
Shumica e operacioneve të kësaj topologjie ju kanë takuar tashmë, kështu që nuk ka nevojë të shqyrtojmë ato përsëri këtu. Por ka disa elemente të reja këtu, të cilat do t'i diskutojmë tani.
Me çdo operacion groupBy zakonisht kryhet ndonjë operacion agregimi (agregim, përmbledhje ose numërim). Mund të kryhet ose aggregim akumulativ me rezultat të akumuluar, ose agregim dritareje, ku merren parasysh regjistrimet brenda një dritareje të caktuar kohore.
Kodi nga listimi 5.5 kryen numërimin e transaksioneve brenda dritareve të seancave. Në fig. 5.13 këto veprime analizohen hap pas hapi.
Me thirrjen windowedBy(SessionWindows.with(twentySeconds).until(fifteenMinutes)) krijojmë një dritare seance me një interval pasiviteti prej 20 sekondash dhe një interval ruajtjeje prej 15 minutash. Intervali i pasivitetit prej 20 sekondash do të thotë që aplikacioni do të përfshijë çdo regjistrim që vjen brenda 20 sekondave nga fundi ose fillimi i seancës aktuale në seancën aktuale (aktive).
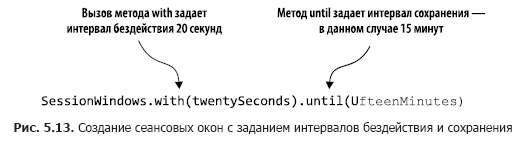
Më pas, ne tregojmë se cilën operacion agregimi duhet të kryejmë në dritaren e seancës — në këtë rast, count. Nëse regjistrimi i ardhshëm kalon jashtë kufijve të intervalit të papunësisë (në njëra anë nga marka e datës/ora), aplikacioni krijon një seancë të re. Intervali i ruajtjes nënkupton mbajtjen e seancës për një periudhë të caktuar kohore dhe lejon të dhëna të vonuara që kalojnë jashtë periudhës së papunësisë së seancës, por që ende mund të bashkohen. Për më tepër, fillimi dhe përfundimi i seancës së re, të krijuar nga bashkimi, korrespondon me markën më të hershme dhe më të vonë të datës/ora.
Le të shqyrtojmë disa regjistrime nga metoda count, për të parë si funksionojnë seancat (tabela 5.1).
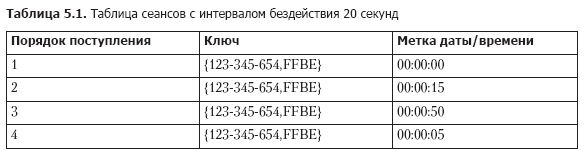
Kur regjistrimet mbërrijnë, ne kërkojmë seancat ekzistuese me të njëjtin çelës, me kohën e përfundimit të mëparshme se marka aktuale e datës/ora — intervali i papunësisë dhe me kohën fillestare të mëvonshme se marka aktuale e datës/ora + intervali i papunësisë. Duke e konsideruar këtë, katër regjistrimet nga tabela 5.1 bashkohen në një seancë të vetme në këtë mënyrë.
1. Regjistrimi 1 mbërrin i pari, kështu që koha fillestare është e barabartë me kohën e përfundimit dhe është e barabartë me 00:00:00.
2. Më pas mbërrin regjistrimi 2, dhe ne kërkojmë seancat që përfundojnë jo më herët se 23:59:55 dhe fillojnë jo më vonë se 00:00:35. Gjejmë regjistrimin 1 dhe bashkojmë seancat 1 dhe 2. Marrim kohën fillestare të seancës 1 (më të hershme) dhe kohën e përfundimit të seancës 2 (më të vonë), kështu që seanca jonë e re fillon në 00:00:00 dhe përfundon në 00:00:15.
3. Më mbërrin regjistrimi 3, ne kërkojmë seancat midis 00:00:30 dhe 00:01:10 dhe nuk gjejmë asnjërën. Shtojmë seancën e dytë për çelësin 123-345-654,FFBE, që fillon dhe përfundon në 00:00:50.
4. Më mbërrin regjistrimi 4, dhe ne kërkojmë seancat midis 23:59:45 dhe 00:00:25. Këtë herë gjenden të dyja seancat — 1 dhe 2. Të gjitha tre seancat bashkohen në një, me kohën fillestare 00:00:00 dhe kohën e përfundimit 00:00:15.
Nga ajo që u tha në këtë seksion, duhen mbajtur mend këto detaje të rëndësishme:
- seancat — nuk janë dritare me përmasa fikse. Zgjatja e seancës përcaktohet nga aktiviteti brenda një intervali të caktuar kohor;
- markat e datës/ora në të dhëna përcaktojnë nëse një ngjarje bie në një seancë ekzistuese ose në një periudhë papunësie.
Më pas do të diskutojmë llojin tjetër të dritareve — "rrotulluese".
"Rrotulluese" dritare
Dritaret "tumblluese" kapin ngjarjet që bie në një interval të caktuar kohor. Imagjinoni se duhet të kapni të gjitha transaksionet bursore të një kompanie çdo 20 sekonda, kështu që mbledhni të gjitha ngjarjet për këtë kohë. Pas skadimit të intervalit 20-sekondor, dritarja "tumbllohet" dhe kalon në një interval të ri 20-sekondor të vëzhgimit. Figura 5.14 ilustron këtë situatë.
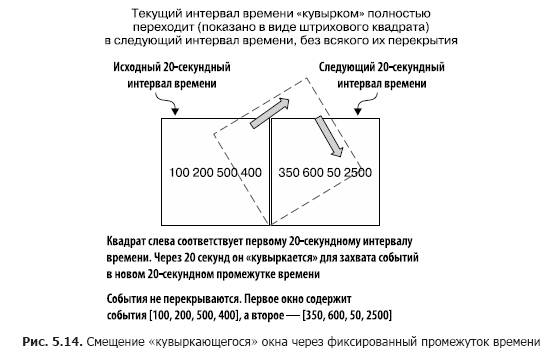
Siç mund ta shihni, të gjitha ngjarjet e pranuara për 20 sekondat e fundit janë të përfshira në dritare. Pas skadimit të këtij intervali, krijohet një dritare e re.
Në listën 5.6 është dhënë kodi që demonstron përdorimin e dritareve "tumblluese" për të kapur çdo 20 sekonda transaksionet bursore (e gjeni në skedarin src/main/java/bbejeck/chapter_5/CountingWindowingAndKtableJoinExample.java).
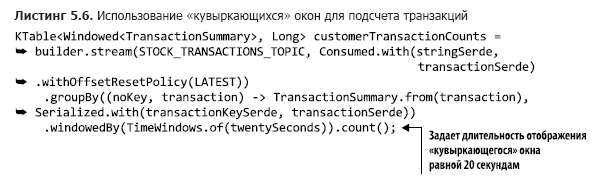
Falë këtij ndryshimi të vogël në thirrjen e metodës TimeWindows.of, mund të përdoret dritarja "tumblluese". Në këtë shembull nuk ka thirrje për metodën until(), duke përdorur kështu intervalin e ruajtjes me default, 24 orë.
Në fund, është koha të kalojmë në opsionin e fundit të dritareve — dritaret "hopping".
Dritaret lëvizëse ("hopping")
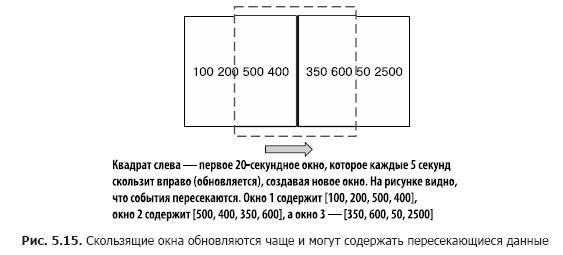
Dritaret lëvizëse/"hopping" (sliding/hopping) janë të ngjashme me dritaret "tumblluese", por me një ndryshim të vogël. Dritaret lëvizëse nuk presin skadimin e intervalit kohor për të krijuar një dritare të re për përpunimin e ngjarjeve të fundit. Ato fillojnë llogaritjet e reja pas një intervali pritej, që është më i vogël se kohëzgjatja e dritares.
Për të ilustruar diferencat ndërmjet dritareve "tumblluese" dhe "hopping", le të kthehemi në shembullin e llogaritjes së transaksioneve bursore. Qëllimi ynë mbetet të llogaritë numrin e transaksioneve, por nuk do të donim të prisnim të gjithë intervalin para se të përditësojmë numëruesin. Në vend të kësaj, do të përditësojmë numëruesin çdo 5 sekonda, duke llogaritur ende numrin e transaksioneve çdo 20 sekonda, siç tregohet në fig. 5.15. Kështu, ne kemi tre dritare rezultate me të dhëna të mbivendosura.
Në listën 5.7 është dhënë kodi për caktimin e dritareve lëvizëse (e gjeni në skedarin src/main/java/bbejeck/chapter_5/CountingWindowingAndKtableJoinExample.java).
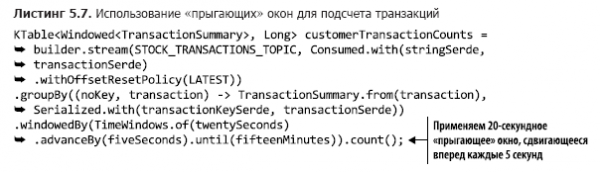
"Kuvyrkayushchiesya" okno mund të transformohet në "prijgajues" duke shtuar thirrjen e metodës advanceBy(). Në shembullin e dhënë, intervali i ruajtjes është 15 minuta.
Keni parë në këtë seksion se si të kufizoni rezultatet e agregatimit me dritare kohore. Në veçanti, do të donim që të mbani mend nga ky seksion tre gjëra të mëposhtme:
- sizmi i dritareve të sesioneve kufizohet nga aktiviteti i përdoruesve, jo nga periudha kohore;
- "kuvyrkayushchiesya" dritaret japin një pamje të ngjarjeve brenda një periudhe të caktuar kohore;
- zgjatja e punës së "prijgajuesve" është fiksuar, por ato rifreskohen shpesh dhe mund të përmbajnë regjistrime të mbivendosura në të gjithë dritaret.
Më pas do të mësojmë se si të kthejmë KTable përsëri në KStream për lidhje.
5.3.3. Lidhja e objekteve KStream dhe KTable
Në kapitullin 4 diskutuam lidhjen e dy objekteve KStream. Tani na nevojitet të mësojmë se si të lidhim KTable me KStream. Kjo mund të jetë e nevojshme për një arsye të thjeshtë. KStream është një rrjedhë regjistrimesh, ndërsa KTable është një rrjedhë azhurnimesh regjistrimesh, por ndonjëherë mund të jetë e nevojshme të shtoni kontekst shtesë në rrjedhën e regjistrimeve përmes azhurnimeve nga KTable.
Të marrim të dhënat për numrin e transaksioneve të aksioneve dhe t'i lidhim ato me lajmet e aksioneve sipas industrive përkatëse. Ja se çfarë duhet të bëni, duke marrë parasysh kodin e tashëm.
- Transformoni objektin KTable me të dhënat për numrin e transaksioneve të aksioneve në KStream duke ndryshuar çelësin me një çelës që përfaqëson industrinë e përkatshme për këtë simbol aksionesh.
- Krijoni një objekt KTable që lexon të dhëna nga topic me lajmet e aksioneve. Ky KTable i ri do të kategorizohet sipas industrive.
- Lidhni azhurnimet e lajmeve me informacionin mbi numrin e transaksioneve të aksioneve sipas industrive.
Tani le të shohim se si duhet ta zbatojmë këtë plan veprimi.
Transformimi i KTable në KStream
Për të transformuar KTable në KStream duhen bërë këto hapat e mëposhtme.
- Thirrni metodën KTable.toStream().
- Me anë të thirrjes së metodës KStream.map, zëvendësoni çelësin me emrin e industrisë, pas së cilës nxirrni nga instanca Windowed objektin TransactionSummary.
Ne do t'i lidhim këto operacione në një zinxhir si më poshtë (kodi mund të gjendet në skedarin src/main/java/bbejeck/chapter_5/CountingWindowingAndKtableJoinExample.java) (listing 5.8).
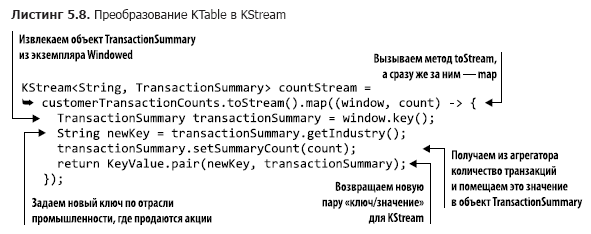
Duke ne ekzekutojmë operacionin KStream.map, ri-sekcionimi për instancën e kthyer KStream kryhet automatikisht kur përdoret në lidhje.
Ne kemi përfunduar procesin e transformimit, tani na nevojitet të krijojmë një objekt KTable për të lexuar lajmet e tregut.
Krijimi i KTable për lajmet e tregut
Fatmirësisht, për të krijuar objektin KTable mjafton një rresht kodi (ky kod mund të gjendet në skedarin src/main/java/bbejeck/chapter_5/CountingWindowingAndKtableJoinExample.java) (listimi 5.9).
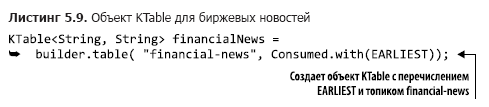
Vlen të theksohet se nuk nevojiten objekte Serde, pasi në konfigurim përdoren Serde të stringjeve. Gjithashtu, falë përdorimit të enumerimit EARLIEST, tabela mbushet me regjistrime që në fillim.
Tani mund të kalojmë në hapin përfundimtar — lidhjen.
Lidhja e përditësimeve të lajmeve me të dhënat e numrit të transaksioneve
Krijimi i lidhjes nuk përfaqëson ndonjë vështirësi. Ne do të përdorim një lidhje të majtë në rast se nuk ka lajme të tregut për industrinë përkatëse (kode e nevojshme mund të gjendet në skedarin src/main/java/bbejeck/chapter_5/CountingWindowingAndKtableJoinExample.java) (listimi 5.10).
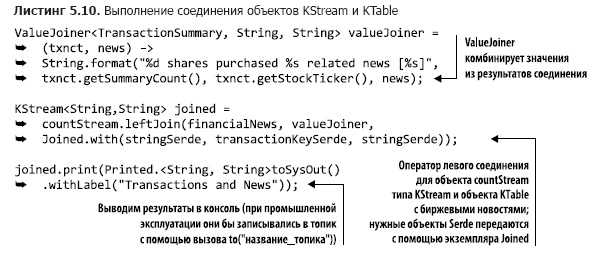
Ky operator leftJoin është mjaft i thjeshtë. Ndryshe nga lidhjet nga kapitulli 4, metoda JoinWindow nuk përdoret, pasi në ekzekutimin e lidhjes KStream-KTable për çdo çelës në KTable ekziston vetëm një regjistrim. Kjo lidhje nuk është e kufizuar në kohë: regjistrimi ose ekziston në KTable, ose nuk ekziston. Përfundimi kryesor: me objekte KTable mund të pasurohet KStream me të dhëna referuese që përditësohen më rrallë.
Tani do të shqyrtojmë një mënyrë më efikase për të pasuruar ngjarjet nga KStream.
5.3.4. Objektet GlobalKTable
Siç e kuptuat, ka nevojë për pasurimin e rrjedhave të ngjarjeve ose për shtimin e kontekstit. Në kapitullin 4 keni parë lidhjet e dy objekteve KStream, dhe në seksionin e mëparshëm — lidhjen KStream dhe KTable. Në të gjitha këto raste, është e nevojshme ri-sekcionimi i rrjedhës së të dhënave kur çelësat shndërrohen në një lloj ose vlerë të re. N sometimese ri-sekcionimi bëhet në mënyrë të drejtpërdrejtë, dhe ndonjëherë Kafka Streams e bën atë automatikisht. Ri-sekcionimi është i nevojshëm, pasi çelësat janë ndryshuar dhe regjistrimet duhet të ndodhen në seksione të reja, ndryshe lidhja do të jetë e pamundur (kjo u diskutua në kapitullin 4, në pikën 'Ri-sekcionimi i të dhënave' të nenit 4.2.4).
Risekcioni ka një çmim
Risekcioni kërkon shpenzime - shpenzime shtesë të burimeve për krijimin e temave ndërmjetësuese, ruajtjen e të dhënave të dyfishta në një temë tjetër; gjithashtu do të thotë rritje të vonesave si rezultat i shkrimit dhe leximit nga kjo temë. Për më tepër, kur është e nevojshme të realizohet lidhja për më shumë se një aspekt ose dimension, është e nevojshme të organizohen lidhjet në një zinxhir, të shfaqen regjistrimet me çelësa të rinj dhe përsëri të realizohet procesi i risekcionimit.
Lidhja me grupe të dhënash më të vogla
Në disa raste, volume i të dhënave referuese, me të cilat parashikohet lidhja, është relativisht i vogël, saqë kopjet e plota të tyre mund të vendosen lokalisht në secilin nga nyjat. Për situata të tilla, në Kafka Streams parashikohet klasa GlobalKTable.
Instancat e GlobalKTable janë unike, pasi aplikacioni replikon të gjitha të dhënat në çdo nyje. Dhe për shkak se në secilën nyje janë të gjitha të dhënat, nuk ka nevojë të risekcionohet rrjedha e ngjarjeve sipas çelësit të të dhënave referuese, që të jetë i aksesueshëm për të gjitha sekcionet. Me objektet GlobalKTable është gjithashtu e mundur të realizohen lidhje pa çelësa. Le të kthehemi në një nga shembujt e mëparshëm për të demonstruar këtë mundësi.
Lidhja e objekteve KStream me objekte GlobalKTable
Në nënkapitullin 5.3.2, ne realizuam agregimin me dritare të transaksioneve të bursës sipas blerësve. Të dhënat e këtij agregimi duken si në vijim:
{customerId='074-09-3705', stockTicker='GUTM'}, 17
{customerId='037-34-5184', stockTicker='CORK'}, 16
Megjithëse këto rezultate përputhen me qëllimin e vendosur, do të ishte më e dobishme nëse do të shfaqej gjithashtu emri i klientit dhe emri i plotë i kompanisë. Për të shtuar emrin e blerësit dhe emrin e kompanisë, mund të realizohen lidhje të zakonshme, por kjo do të kërkonte dy mapime çelësash dhe risekcionim. Me ndihmën e GlobalKTable, mund të shmangen shpenzimet për këto operacione.
Për këtë, ne do të përdorim objektin countStream nga lista 5.11 (kodi përkatës mund të gjendet në skedarin src/main/java/bbejeck/chapter_5/GlobalKTableExample.java), duke e lidhur atë me dy objekte GlobalKTable.
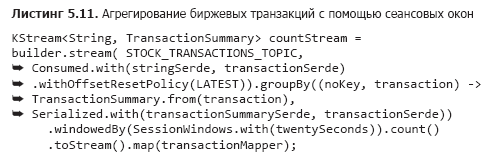
Kemi tashmë e kemi diskutuar këtë më herët, prandaj nuk do të përsëris atë. Por dua të theksoj se kodi në funksionin toStream().map është abstraktizuar në një objekt-funksion për lehtësinë e leximit në vend të shprehjeve lambda të nodhura.
Hapi tjetër është shpallja e dy ekzemplarëve GlobalKTable (kodin e dhënë mund ta gjeni në skedarin src/main/java/bbejeck/chapter_5/GlobalKTableExample.java) (lista 5.12).
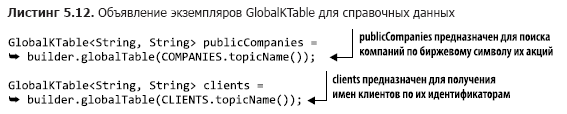
Vini re se emrat e tematizave përshkruhen duke përdorur lloje enumeruese.
Tani, kur kemi përgatitur të gjitha komponentët, mbetet të shkruajmë kodin për lidhjen (të cilin mund ta gjeni në skedarin src/main/java/bbejeck/chapter_5/GlobalKTableExample.java) (lista 5.13).
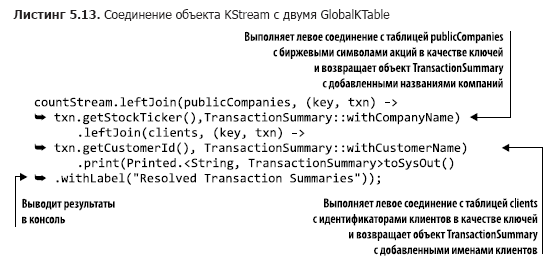
Megjithëse në këtë kod ka dy lidhje, ato janë organizuar në formë zinxhiri, sepse veçmas asnjë nga rezultatet e tyre nuk përdoret. Rezultatet paraqiten në fund të tërë operacionit.
Kur të ekzekutoni operacionin e lidhjes të mësipërm, do të merrni rezultate të tilla:
{customer='Barney, Smith' company="Exxon", transactions= 17}Thelbi nuk ka ndryshuar, por këto rezultate duken më të qarta.
Nëse numëroni kapitullin 4, keni parë disa lloje lidhjesh në veprim. Ato janë listuar në tabelën 5.2. Kjo tabelë reflekton mundësitë e lidhjes, të vlefshme për versionin 1.0.0 të Kafka Streams; në publikimet e ardhshme, mund të ndodhin disa ndryshime.
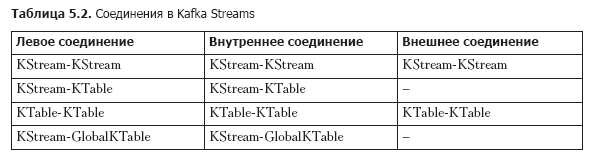
Në përfundim, dua të rikujtoj esencën: ju mund të lidhni rrjedha ngjarjesh (KStream) dhe rrjedha azhurnimesh (KTable) duke përdorur një gjendje lokale. Për më tepër, nëse madhësia e të dhënave ndihmëse nuk është shumë e madhe, mund të përdorni objektin GlobalKTable. GlobalKTable replikon të gjitha seksionet në secilën nga nodet e aplikacionit Kafka Streams, duke siguruar kështu disponueshmërinë e të gjitha të dhënave, pavarësisht nga se cilës seksion i përket çelësi.
Më pas do të shohim një mundësi të Kafka Streams, e cila lejon vëzhgimin e ndryshimeve të gjendjes pa konsumimin e të dhënave nga tema Kafka.
5.3.5. Gjendja e disponueshme për pyetje
Ne kemi kryer disa operacione me përfshirjen e gjendjes dhe gjithmonë kemi shfaqur rezultatet në konsolë (për qëllime zhvillimi) ose i kemi regjistruar në një temë (për qëllime industriale). Kur regjistrojmë rezultatet në një temë, duhet të përdorim konsumatorin Kafka për t'i parë ato.
Leximi i të dhënave nga këto tema mund të konsiderohet si një lloj i pamjeve të materializuara (materialized views). Për ne, mund të përdorim përkufizimin e pamjes së materializuar nga "Wikipedia": "... një objekt fizik i bazës së të dhënave, që përmban rezultatet e ekzekutimit të një pyetje. Për shembull, ajo mund të jetë një kopje lokale e të dhënave të largëta, ose një nëngrup i rreshtave dhe/o ose kolonave të tabelës, ose rezultatet e një bashkimi, ose një tabelë përmbledhëse e marrë përmes agregimit" (https://en.wikipedia.org/wiki/Materialized_view).
Kafka Streams gjithashtu lejon që të kryhen pyetje interaktive (interactive queries) në depozitat e gjendjes, çka ofron mundësinë për të lexuar direkt këto pamje të materializuara. Është e rëndësishme të theksohet se një pyetje në depozitën e gjendjes ka natyrën e një operacioni "të vetëm për lexim". Falë kësaj, ju mund të mos keni frikë të bëni rastësisht gjendjen të paqëndrueshme gjatë procesimit të të dhënave nga aplikacioni.
Mundësia për të kryer pyetje direkte në depozitat e gjendjes ka rëndësi të madhe. Kjo do të thotë se është e mundur të krijoni aplikacione — tabela informuese pa pasur nevojë për të marrë së pari të dhënat nga konsumatori i Kafka. Ajo gjithashtu rrit efikasitetin e aplikacionit, sepse nuk është e nevojshme të shkruhen sërish të dhënat:
- mënyra që të dhënat janë lokale, mund të aksesohen shpejt;
- duplikimi i të dhënave eliminohet, sepse ato nuk shkruhen në një depo të jashtme.
Gjëja kryesore që do të doja të mbani mend: është e mundur të bëni pyetje direkt në gjendje nga aplikacioni. Nuk mund të nënvleftësoni mundësitë që kjo ju ofron. Në vend që të konsumoni të dhënat nga Kafka dhe të ruani regjistrat në një bazë të dhënash për aplikacionin, mund të kryeni pyetje në depozitat e gjendjes me të njëjtin rezultat. Pyetje direkte në depozitat e gjendjes nënkupton një volum më të vogël kodi (nuk ka konsumator) dhe më pak software (nuk ka nevojë për një tabelë bazash për të ruajtur rezultatet).
Ne kemi mbuluar një sasi të konsiderueshme informacioni në këtë kapitull, prandaj përkohësisht do ta ndalim diskutimin tonë mbi kërkesat interaktive për magazinat e gjendjes. Por mos u shqetësoni: në kapitullin 9 do të krijojmë një aplikacion të thjeshtë - një panel informativ me kërkesa interaktive. Për të demonstruar kërkesat interaktive dhe mundësitë e shtimit të tyre në aplikacionet Kafka Streams, do të përdoren disa nga shembujt e këtij dhe kapitujve të mëparshëm.
CV
- Objektet KStream simbolizojnë rrjedha ngjarjesh, të krahasueshme me insertimet në një bazë të dhënash. Objektet KTable simbolizojnë rrjedha përditësimesh, ato janë më shumë të ngjashme me përditësimet në një bazë të dhënash. Madhësia e objektit KTable nuk rritet, regjistrimet e vjetra zëvendësohen me të rejat.
- Objektet KTable janë të nevojshme për operacionet e agregatës.
- Me operacionet e dritareve mund të ndahen të dhënat e agreguara në kosha kohorë.
- Përmes objekteve GlobalKTable mund të aksesohen të dhënat referuese në çdo pikë të aplikacionit, pavarësisht nga ndarja në seksione.
- Janë të mundshme lidhje ndërmjet objekteve KStream, KTable dhe GlobalKTable.
Derisa deri tani kemi fokusuar vëmendjen në krijimin e aplikacioneve Kafka Streams duke përdorur DSL-in e nivelit të lartë KStream. Edhe pse qasja e nivelit të lartë lejon krijimin e programeve të pastër dhe të ngushta, përdorimi i saj përfaqëson një kompromis. Të punosh me DSL KStream do të thotë të rrisësh elegancën e kodit përmes uljes së kontrollit. Në kapitullin tjetër do të shqyrtojmë API-në e nivelit të ulët të nodit-përpunues dhe do të provojmë kompromise të tjera. Programet do të bëhen më të gjata se më parë, por do të kemi mundësinë të krijojmë pothuajse çdo nod-përpunues që na nevojitet.
→ Më shumë detaje mbi librin mund të gjenden në
→ Për anëtarët e Habr, një zbritje prej 25% me kuponin - Kafka Streams
→ Pas pagesës për versionin në letër të librit, dërgohet një libër elektronik në e-mail.
Burimi: habr.com
