

LINQ hyri në .NET si një gjuhë e re e fuqishme për manipulimin e të dhënave. LINQ to SQL si pjesë e tij lejon një komunikim të përshtatshëm me DBMS përmes, për shembull, Entity Framework. Megjithatë, shpesh duke e përdorur, zhvilluesit harrojnë të shikojnë se çfarë lloj pyetje SQL do të gjenerojë provider-i queryable, në rastin tuaj — Entity Framework.
Le të analizojmë dy pika kryesore me një shembull.
Për këtë, në SQL Server do të krijojmë një bazë të dhënash Test, dhe brenda saj do të krijojmë dy tabela me anë të pyetjes së mëposhtme:
Krijimi i tabelave
USE [TEST]
GO

SET ANSI_NULLS ON
GO

SET QUOTED_IDENTIFIER ON
GO

CREATE TABLE [dbo].[Ref](
	[ID] [int] NOT NULL,
	[ID2] [int] NOT NULL,
	[Name] [nvarchar](255) NOT NULL,
	[InsertUTCDate] [datetime] NOT NULL,
 CONSTRAINT [PK_Ref] PRIMARY KEY CLUSTERED
(
	[ID] ASC
)WITH (PAD_INDEX = OFF, STATISTICS_NORECOMPUTE = OFF, IGNORE_DUP_KEY = OFF, ALLOW_ROW_LOCKS = ON, ALLOW_PAGE_LOCKS = ON) ON [PRIMARY]
) ON [PRIMARY]
GO

ALTER TABLE [dbo].[Ref] ADD  CONSTRAINT [DF_Ref_InsertUTCDate]  DEFAULT (getutcdate()) FOR [InsertUTCDate]
GO

USE [TEST]
GO

SET ANSI_NULLS ON
GO

SET QUOTED_IDENTIFIER ON
GO

CREATE TABLE [dbo].[Customer](
	[ID] [int] NOT NULL,
	[Name] [nvarchar](255) NOT NULL,
	[Ref_ID] [int] NOT NULL,
	[InsertUTCDate] [datetime] NOT NULL,
	[Ref_ID2] [int] NOT NULL,
 CONSTRAINT [PK_Customer] PRIMARY KEY CLUSTERED
(
	[ID] ASC
)WITH (PAD_INDEX = OFF, STATISTICS_NORECOMPUTE = OFF, IGNORE_DUP_KEY = OFF, ALLOW_ROW_LOCKS = ON, ALLOW_PAGE_LOCKS = ON) ON [PRIMARY]
) ON [PRIMARY]
GO

ALTER TABLE [dbo].[Customer] ADD  CONSTRAINT [DF_Customer_Ref_ID]  DEFAULT ((0)) FOR [Ref_ID]
GO

ALTER TABLE [dbo].[Customer] ADD  CONSTRAINT [DF_Customer_InsertUTCDate]  DEFAULT (getutcdate()) FOR [InsertUTCDate]
GO
Tani do të mbushim tabelën Ref duke realizuar skenarin e mëposhtëm:
Mbushja e tabelës Ref
USE [TEST]
GO

DECLARE @ind INT=1;

WHILE(@ind<1200000)
BEGIN
	INSERT INTO [dbo].[Ref]
           ([ID]
           ,[ID2]
           ,[Name])
    SELECT
           @ind
           ,@ind
           ,CAST(@ind AS NVARCHAR(255));

	SET @ind=@ind+1;
END
GO
Po ashtu do ta mbushim tabelën Customer me anë të skenarit të mëposhtëm:
Mbushja e tabelës Customer
PËRDOR [TEST]
SHKO

DEKLARO @ind INT=1;
DEKLARO @ind_ref INT=1;

NDERSA(@ind<=12000000)
FILLIM
	NËSE(@ind%3=0) CENO @ind_ref=1;
	NËSE NDAJ (@ind%5=0) CENO @ind_ref=2;
	NËSE NDAJ (@ind%7=0) CENO @ind_ref=3;
	NËSE NDAJ (@ind=0) CENO @ind_ref=4;
	NËSE NDAJ (@ind=0) CENO @ind_ref=5;
	NËSE NDAJ (@ind=0) CENO @ind_ref=6;
	NËSE NDAJ (@ind=0) CENO @ind_ref=7;
	NËSE NDAJ (@ind=0) CENO @ind_ref=8;
	NËSE NDAJ (@ind=0) CENO @ind_ref=9;
	NËSE NDAJ (@ind=0) CENO @ind_ref=10;
	NËSE NDAJ (@ind=0) CENO @ind_ref=11;
	NËSE CENO @ind_ref=@ind90000;

	SHKRUAJ NË [dbo].[Customer]
	 ([ID]
	 ,[Emri]
	 ,[Ref_ID]
	 ,[Ref_ID2])
	 ZGJEDH
	 @ind,
	 CAST(@ind AS NVARCHAR(255)),
	 @ind_ref,
	 @ind_ref;


	SET @ind=@ind+1;
FUND
SHKO
Kështu kemi marrë dy tabela, ku njërën prej të cilave ka mbi 1 milion rreshta të dhënash, ndërsa tjetrën ka mbi 10 milion rreshta.
Tani në Visual Studio është e nevojshme të krijoni një projekt testues Visual C# Console App (.NET Framework):
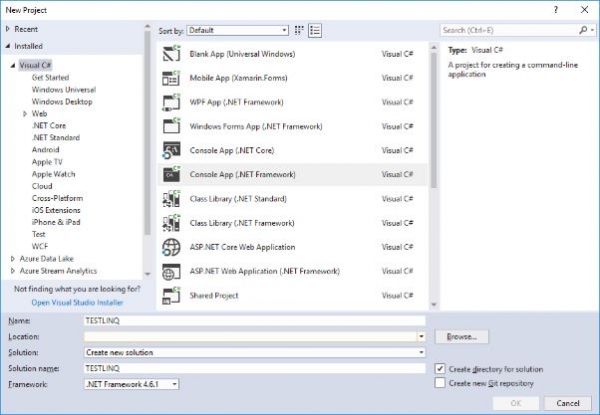
Më tej, duhet të shtoni bibliotekën për Entity Framework për ndërveprimin me bazën e të dhënave.
Për ta shtuar atë, klikoni me të djathtën mbi projektin dhe zgjidhni nga menuja kontekstuale Menaxho Paketat NuGet:
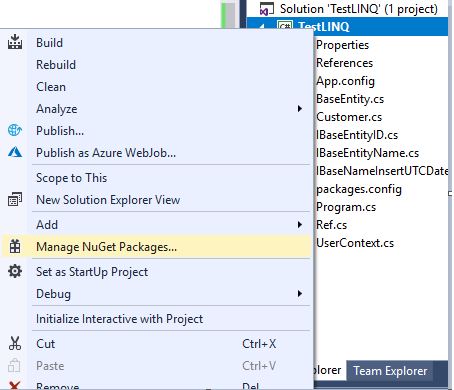
Pastaj në dritaren që shfaqet për menaxhimin e paketave NuGet, në fushën e kërkimit shkruani fjalën «Entity Framework» dhe zgjidhni paketën Entity Framework dhe instalojeni atë:
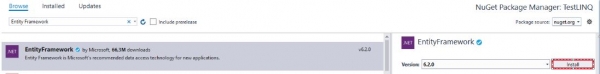
Më pas, në skedarin App.config pas mbylljes së elementit configSections, duhet të shtoni bllokun e mëposhtëm:
Në connectionString, duhet të jepni stringun e lidhjes.
Tani do të krijojmë në skedarë të veçantë 3 ndërfaqe:
- Implementimi i ndërfaqes IBaseEntityID
namespace TestLINQ { public interface IBaseEntityID { int ID { get; set; } } } - Implementimi i ndërfaqes IBaseEntityName
namespace TestLINQ { public interface IBaseEntityName { string Name { get; set; } } } - Implementimi i ndërfaqes IBaseNameInsertUTCDate
namespace TestLINQ
{
    public interface IBaseNameInsertUTCDate
    {
        DateTime InsertUTCDate { get; set; }
    }
}
Dhe në një skedar të veçantë do të krijojmë klasën bazë BaseEntity për dy entitetet tona, në të cilën do të përfshihen fushat e përbashkëta:
Implementimi i klasës bazë BaseEntity
namespace TestLINQ
{
    public class BaseEntity : IBaseEntityID, IBaseEntityName, IBaseNameInsertUTCDate
    {
        public int ID { get; set; }
        public string Name { get; set; }
        public DateTime InsertUTCDate { get; set; }
    }
}
Më pas, në skedarë të veçantë do të krijojmë dy entitetet tona:
- Implementimi i klasës Ref
using System.ComponentModel.DataAnnotations.Schema; namespace TestLINQ { [Table("Ref")] public class Ref : BaseEntity { public int ID2 { get; set; } } } - Implementimi i klasës Customer
using System.ComponentModel.DataAnnotations.Schema;

namespace TestLINQ
{
    [Table("Customer")]
    public class Customer: BaseEntity
    {
        public int Ref_ID { get; set; }
        public int Ref_ID2 { get; set; }
    }
}
Tani do të krijojmë në një skedar të veçantë kontekstin UserContext:
Implementimi i klasës UserContex
using System.Data.Entity;

namespace TestLINQ
{
    public class UserContext : DbContext
    {
        public UserContext()
            : base("DbConnection")
        {
            Database.SetInitializer(null);
        }

        public DbSet Customer { get; set; }
        public DbSet Ref { get; set; }
    }
}
Kemi marrë një zgjidhje të gatshme për të kryer teste optimizimi me LINQ to SQL përmes EF për MS SQL Server:
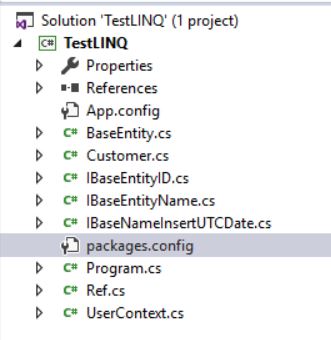
Tani në skedarin Program.cs, shtoni kodin e mëposhtëm:
Skedari Program.cs
using System;
using System.Collections.Generic;
using System.Linq;

namespace TestLINQ
{
    class Program
    {
        static void Main(string[] args)
        {
            using (UserContext db = new UserContext())
            {
                var dblog = new List();
                db.Database.Log = dblog.Add;

                var query = from e1 in db.Customer
                            from e2 in db.Ref
                            where (e1.Ref_ID == e2.ID)
                                 && (e1.Ref_ID2 == e2.ID2)
                            select new { Data1 = e1.Name, Data2 = e2.Name };

                var result = query.Take(1000).ToList();

                Console.WriteLine(dblog[1]);

                Console.ReadKey();
            }
        }
    }
}
Më pas do ta fillojmë projektin tonë.
Në fund të ekzekutimit, në konsol do të shfaqet:
Kërkesa SQL e gjeneruar
SELECT TOP (1000)
    [Extent1].[Ref_ID] AS [Ref_ID],
    [Extent1].[Name] AS [Name],
    [Extent2].[Name] AS [Name1]
    FROM  [dbo].[Customer] AS [Extent1]
    INNER JOIN [dbo].[Ref] AS [Extent2] ON ([Extent1].[Ref_ID] = [Extent2].[ID]) AND ([Extent1].[Ref_ID2] = [Extent2].[ID2])
Dmth, në përgjithësi, kërkesa LINQ gjeneroi një kërkesë SQL për SGBD-në MS SQL Server.
Tani do të ndryshojmë kushtin AND në OR në kërkesën LINQ:
Kërkesa LINQ
var query = from e1 in db.Customer
                            from e2 in db.Ref
                            where (e1.Ref_ID == e2.ID)
                                || (e1.Ref_ID2 == e2.ID2)
                            select new { Data1 = e1.Name, Data2 = e2.Name };
Dhe përsëri do ta fillojmë aplikacionin tonë.
Ekzekutimi do të dështojë me një gabim që lidhet me tejkalimin e kohës së ekzekutimit të komandës në 30 sekonda:
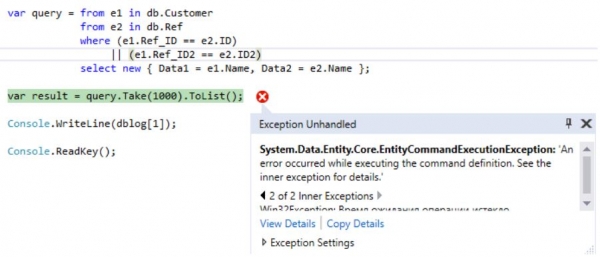
Nëse shqyrtojmë se cila kërkesë është gjeneruar në këtë rast nga LINQ:
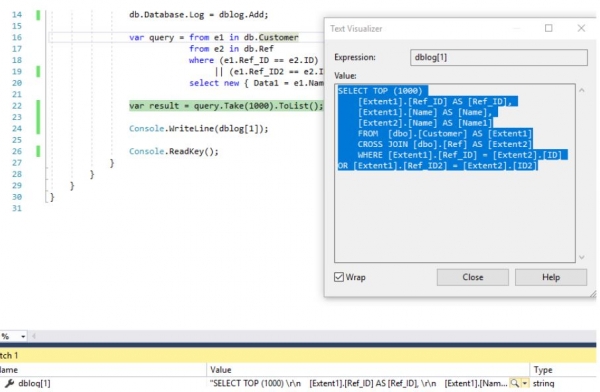
, atëherë mund të sigurohemi që përzgjedhja po bëhet përmes produktit kartesian të dy grupeve (tabelave):
Kërkesa SQL e gjeneruar
SELECT TOP (1000)
    [Extent1].[Ref_ID] AS [Ref_ID],
    [Extent1].[Name] AS [Name],
    [Extent2].[Name] AS [Name1]
    FROM  [dbo].[Customer] AS [Extent1]
    CROSS JOIN [dbo].[Ref] AS [Extent2]
    WHERE [Extent1].[Ref_ID] = [Extent2].[ID] OR [Extent1].[Ref_ID2] = [Extent2].[ID2]
Le të ri-shkruajmë kërkesën LINQ si më poshtë:
Kërkesa LINQ e optimizuar
var query = (from e1 in db.Customer
                   join e2 in db.Ref
                   on e1.Ref_ID equals e2.ID
                   select new { Data1 = e1.Name, Data2 = e2.Name }).Union(
                        from e1 in db.Customer
                        join e2 in db.Ref
                        on e1.Ref_ID2 equals e2.ID2
                        select new { Data1 = e1.Name, Data2 = e2.Name });
Atëherë do të marrim kërkesën e mëposhtme SQL:
Kërkesa SQL
Zgjidhni
    [Limit1].[C1] SI [C1],
    [Limit1].[C2] SI [C2],
    [Limit1].[C3] SI [C3]
    NGA ( Zgjidhni DISTINCT TOP (1000)
        [UnionAll1].[C1] SI [C1],
        [UnionAll1].[Name] SI [C2],
        [UnionAll1].[Name1] SI [C3]
        NGA  (Zgjidhni
            1 SI [C1],
            [Extent1].[Name] SI [Name],
            [Extent2].[Name] SI [Name1]
            NGA  [dbo].[Customer] SI [Extent1]
            INNER JOIN [dbo].[Ref] SI [Extent2] NË [Extent1].[Ref_ID] = [Extent2].[ID]
        UNION ALL
            Zgjidhni
            1 SI [C1],
            [Extent3].[Name] SI [Name],
            [Extent4].[Name] SI [Name1]
            NGA  [dbo].[Customer] SI [Extent3]
            INNER JOIN [dbo].[Ref] SI [Extent4] NË [Extent3].[Ref_ID2] = [Extent4].[ID2]) SI [UnionAll1]
    )  SI [Limit1]
Fatkeqësisht, në kërkesat LINQ, kushti i bashkimit mund të jetë vetëm një, kështu që është e mundur të krijohet një kërkesë ekuivalente përmes dy kërkesave për secilin kusht dhe pastaj t'i bashkohen ato përmes Union për të eliminuar duplikatet në rreshta.
Po, kërkesat në përgjithësi do të rezultojnë jo ekuivalente duke marrë parasysh se mund të kthehen duplikate të plota rreshtash. Megjithatë, në jetën reale duplikate të plota nuk nevojiten dhe përpiqen të hiqen.
Tani le të krahasojmë planet e ekzekutimit të këtyre dy kërkesave:
- për CROSS JOIN mesatarisht koha e ekzekutimit është 195 sekonda:

- për INNER JOIN-UNION mesatarisht koha e ekzekutimit është më pak se 24 sekonda:

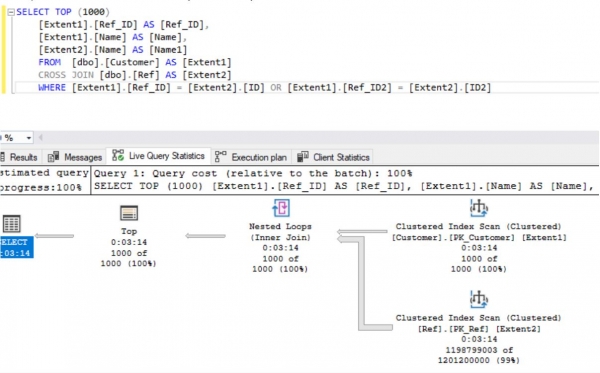
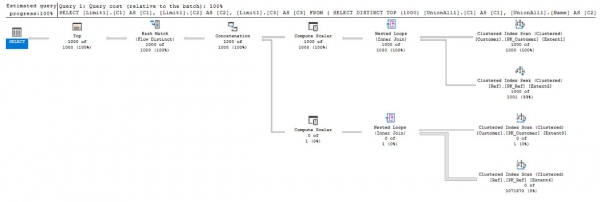
Siç duket nga rezultatet, për dy tabela me miliona regjistrimesh, kërkesa LINQ e optimizuar punon shumë më shpejt se ajo e paoptimizuar.
Për variantin me 'Dhe' në kushtet LINQ, kërkesa duket si:
Kërkesa LINQ
var query = from e1 in db.Customer
                            from e2 in db.Ref
                            ku (e1.Ref_ID == e2.ID)
                                 && (e1.Ref_ID2 == e2.ID2)
                            zgjidhni një të ri { Data1 = e1.Name, Data2 = e2.Name };
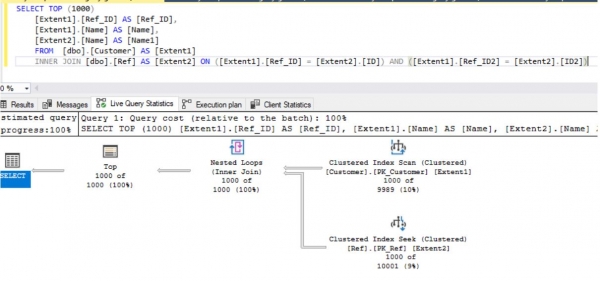
pothuajse gjithmonë do të gjenerohet një kërkesë SQL e saktë, e cila do të ekzekutohet mesatarisht për rreth 1 sekondë:
Po ashtu, për manipulime LINQ to Objects në vend të kërkesës së tillë:
Kërkesa LINQ (variant 1)
var query = from e1 in seq1
                            from e2 in seq2
                            ku (e1.Key1==e2.Key1)
                               && (e1.Key2==e2.Key2)
                            zgjidhni një të ri { Data1 = e1.Data, Data2 = e2.Data };
mund të përdorni kërkesën si:
Kërkesa LINQ (variant 2)
var query = from e1 in seq1
                            bashko e2 në seq2
                            mbi të reja { e1.Key1, e1.Key2 } baraz të reja { e2.Key1, e2.Key2 }
                            zgjidhni një të ri { Data1 = e1.Data, Data2 = e2.Data };
ku:
Pë definimin e dy array-ve
Para[] seq1 = new[] { new Para { Key1 = 1, Key2 = 2, Data = "777" }, new Para { Key1 = 2, Key2 = 3, Data = "888" }, new Para { Key1 = 3, Key2 = 4, Data = "999" } };
Para[] seq2 = new[] { new Para { Key1 = 1, Key2 = 2, Data = "777" }, new Para { Key1 = 2, Key2 = 3, Data = "888" }, new Para { Key1 = 3, Key2 = 5, Data = "999" } };
, dhe tipi Para përcaktohet si vijon:
Pë definimin e tipit Para
class Para
{
        public int Key1, Key2;
        public string Data;
}
Kështu kemi shqyrtuar disa aspekte të optimizimit të pyetjeve LINQ për MS SQL Server.
Fatkeqësisht, madje edhe zhvilluesit e përvojshëm dhe kryesorë të .NET harrojnë se është e domosdoshme të kuptojnë se çfarë bëjnë në prapaskenë ato instrukcione që ata përdorin. Ndryshe, ata bëhen konfigurues dhe mund të vendosin një bombë me vonesë në të ardhmen, si gjatë shkallëzimit të zgjidhjeve programore, ashtu edhe në raste të ndryshme të kushteve të jashtme.
Gjithashtu, një përmbledhje e vogël është bërë dhe .
Burimet për testin - vetë projekti, krijimi i tabelave në bazën e të dhënave TEST dhe mbushja me të dhëna të këtyre tabelave ndodhen .
Gjithashtu në këtë repositor është folderi Plani, i cili përmban planet e ekzekutimit të pyetjeve me kushte OSE.
Burimi: habr.com
