

3. Mundësitë e strukturave kur përdoren globalët
Një strukturë si një pemë e renditur ka raste të ndryshme të veçanta. Le të shqyrtojmë ato që kanë vlerë praktike kur punojmë me globalët.
3.1 Rast specifik 1. Një nod pa dega
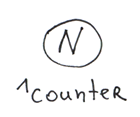 Globalët mund të përdoren jo vetëm si një Array, por edhe si variabla të zakonshme. Për shembull si një numërues:
Set ^counter = 0  ; vendosja e numëruesit
Set id=$Increment(^counter) ;  inkrementimi atomik
Në këtë rast, globali, përveç të dhënës, mund të ketë gjithashtu dega. Njëra nuk përjashton tjetrën.
3.2 Rast specifik 2. Një majë dhe shumë dega
Në përgjithësi — kjo është një bazë klasike key-value. Dhe nëse si vlerë ruajmë një grup vlerash, atëherë do të marrim një tabelë normale me një çelës primar.
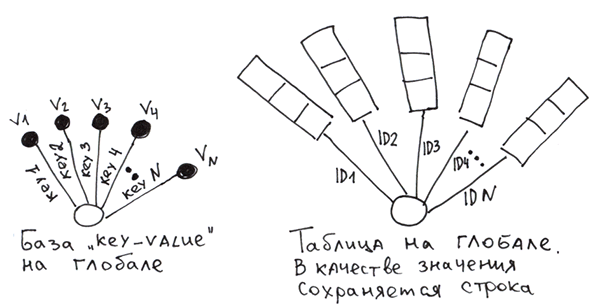
Për të implementuar tabelën në globalë, ne do të duhet të formojmë vetë rreshtat nga vlerat e kolonave, dhe pastaj t'i ruajmë ato në global sipas çelësit primar. Që kur të lexojmë të jetë e mundur të ndajmë përsëri rreshtin në kolona, mund të përdorim:
- simbolet ndarës.
Set ^t(id1) = "col11/col21/col31" Set ^t(id2) = "col12/col22/col32" - një skemë të rreptë, ku çdo fushë zë një numër të paracaktuar bajtësh. Ashtu siç bëhet në bazat e të dhënave relacionale.
- një funksion special $LB (i cili ekziston në Cache), që formon një rresht nga vlerat.
Set ^t(id1) = $LB("col11", "col21", "col31")
Set ^t(id2) = $LB("col12", "col22", "col32")
Çka është interesante, nuk është e vështirë të krijosh një strukturë të ngjashme me indekset dytësore në bazat e të dhënave relacionale. Le ta quajmë këto struktura globalë indeksi. Globali indeksi është një pemë ndihmëse për kërkim të shpejtë sipas fushave që nuk janë pjesë përbërëse të çelësit primar të globalit kryesor. Për ta mbushur dhe përdorur, duhet të shkruhet kod shtesë.
Le të krijojmë një global indeks mbi kolonën e parë.
Set ^i("col11", id1) = 1
Set ^i("col12", id2) = 1
Tani për kërkimin e shpejtë të informacionit mbi kolonën e parë, ne do të duhet të shkojmë te globali ^i dhe të gjejmë çelësat primarë (id) përkatës që i përkasin vlerës së kërkuar të kolonës së parë.
Kur vendosim një vlerë, ne mund të krijojmë menjëherë si vlerën ashtu edhe globalët indeksi për fushat përkatëse. Dhe për siguri, do ta mbështjellim të gjithë këtë në një transaksion.
TSTART
Set ^t(id1) = $LB("col11", "col21", "col31")
Set ^i("col11", id1) = 1
TCOMMIT
Detaje se si të bëni në M , .
Të punoni me tabela të tilla do të jetë po aq e shpejtë sa në DB tradicionale (ose madje edhe më shpejt) nëse funksionet për futjen/aktualizimin/zhbllokimin e rreshtave shkruhen në COS/M dhe kompilohet.Ky pohim e kam verifikuar me teste për inserte dhe seleksione masive në një tabelë me dy kolona, përfshirë përdorimin e komandave TSTART dhe TCOMMIT (transaksione).
Skenarët më të komplikuar me akses konkurrues dhe transaksione paralele nuk i kam testuar.
Pa përdorimin e transaksioneve, shpejtësia e insertit ishte 778,361 insertë/për sekondë për një milion vlera.
Në 300 milion vlera — 422,141 insertë/për sekondë.
Me përdorimin e transaksioneve — 572,082 insertë/për sekondë për 50M insertë. Të gjitha operacionet u zhvilluan nga kodi i kompiluara M.
Diskët janë të zakonshëm, jo SSD. RAID5 me Write-back. Procesori Phenom II 1100T.
Për testim të ngjashëm SQL-bazës duhet të shkruhet një procedurë e ruajtur që do të bëjë inserte në një cikël. Kur kam testuar MySQL 5.5 (ruajtja InnoDB) me këtë metodë kam marrë shifra jo më shumë se 11K insertë për sekondë.
Po, implementimi i tabelave në globalë duket më i komplikuar se në DB rrelacionale. Pra, DB-të industriale në globalë kanë qasje SQL për të lehtësuar punën me të dhënat tabelore.
 Në përgjithësi, nëse skema e të dhënave nuk do të ndryshojë shpesh, shpejtësia e insertit nuk është kritike dhe e gjithë baza mund të paraqitet lehtësisht si tabela të normalizuara, atëherë është më e lehtë të punosh saktësisht me SQL, pasi ai ofron një nivel më të lartë abstraksioni.
 Në këtë rast specifik, doja të tregoja se globalët mund të shërbejnë si një ndërfaqe për krijimin e DB-ve të tjera. Si assemblari, në të cilin mund të shkruhen gjuhë të tjera. Ja disa shembuj, se si mund të krijohen në globalë analogë
Nëse duhet të krijoni një DB jostandarde me përpjekje minimale, atëherë ia vlen të shikoni në drejtim të globalëve.
3.3 Rast i veçantë 3. Strukturë pemore me dy nivele, ku çdo nyje e nivelit të dytë ka një numër të caktuar branchesh
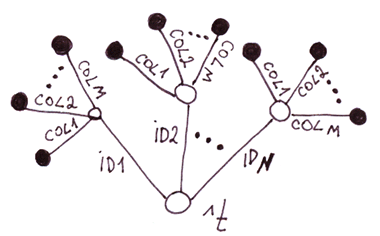 Me siguri e keni kuptuar: kjo është një implementim alternativ i tabelave në globalë. Le të krahasojmë këtë implementim me të mëparshmin.
Tabelat në pemën me dy nivele vs. në pemën me një nivel.
Disavantazhet
Pikat pozitive
- Më ngadalë në insertim, pasi duhet të vendosës numrin e nyjeve të barabartë me numrin e kolonave.
- Më shumë hapësirë e nevojshme në disk. Indeksat e globalëve (në kuptimin si indekset në array) me emrat e kolonave zënë vend në disk dhe duken për secilën rresht.
- Qasje më e shpejtë në vlerat e kolonave të veçanta, pasi nuk është e nevojshme të analizosh rreshtin. Sipas testeve të mia, është më e shpejtë me 11.5% me 2 kolona dhe edhe më shumë me një numër më të madh kolonash.
- Më e thjeshtë të ndryshosh skemën e të dhënave
- Më e qartë kodifikimi
Përfundimi: për dëshirat e individëve. Duke qenë se shpejtësia është një nga avantazhet më kyçe të globalëve, nuk ka shumë kuptim të përdoret kjo realizim, pasi me siguri do të funksionojë jo më shpejt se tabelat në bazat e të dhënave relacionale.
3.4 Rast i përgjithshëm. Pemët dhe pemët e renditura
Çdo strukturë e dhënash që mund të paraqitet si pemë, përshtatet në mënyrë të shkëlqyer me globalët.
3.4.1 Objekte me nënobjekte
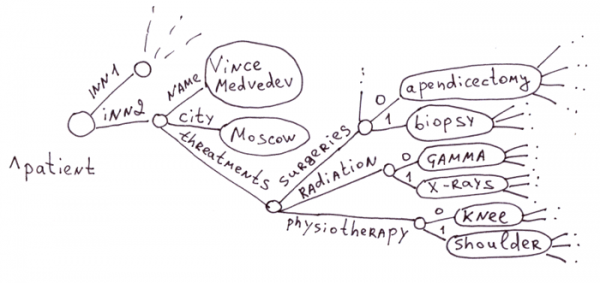
Ky është një fushë tradicionale e aplikimit të globalëve. Në fushën mjekësore ka një numër të madh sëmundjesh, ilaçesh, simptomash, metodash trajtimi. Të krijosh një tabelë për çdo pacient me një milion fusha është iracional. Sidomos kur 99% e fushave do të jenë të zbrazëta.
Imagjinoni një bazë të dhënash SQL me tabela: "pacienti" ~ 100,000 fusha, "Ilaçi" — 100,000 fusha, "Terapia" — 100,000 fusha, "Kompikimet" — 100,000 fusha etj. Ose mund të krijoni një bazë të dhënash me mijëra tabelash, secila për një tip të caktuar pacienti (dhe ato mund të përputhen!), trajtimi, ilaçi, dhe duke krijuar edhe mijëra tabela për lidhjet midis këtyre tabelave.
Globalët janë ideale për mjekësinë, pasi lejojnë krijimin e një përshkrimi të saktë të historisë mjekësore të secilit pacient, terapive të ndryshme, veprimeve të ilaçeve, në formën e një peme, pa shpenzuar hapësirë të tepërt në disk për kolona bosh, siç do të ndodhte në rastin relacional.
 Me globalët është e lehtë të krijosh një bazë të dhënash me të dhëna për njerëzit, kur është e rëndësishme të akumulohet dhe sistematizohet maksimumi i informacionit të ndryshëm rreth klientëve. Kjo është e kërkuar në mjekësi, bankar, marketing, arkivim dhe fushat e tjera.
.
Sigurisht, me SQL mund të emulosh gjithashtu një pemë me disa tabela (, ,,,,,,,,,), porqë kjo është ndjeshëm më e komplikuar dhe do të punojë më ngadalë. Në thelb, do të duhej të shkruajmë një global që funksionon në tabela dhe të fshiheshim gjithë punën me tabelat nën një shtresë abstraksioni. Nuk është e duhura të emulohet një teknologji me nivel më të ulët (globalet) me mjete më të nivelit të lartë (SQL). Nuk është e arsyeshme.
Nuk është sekret se ndryshimi i skemës së të dhënave në tabela gjigante (ALTER TABLE) mund të marrë një kohë të konsiderueshme. MySQL, për shembull, bën ALTER TABLE ADD|DROP COLUMN duke kopjuar të dhënat nga tabela e vjetër në një të re (kam testuar motorët MyISAM, InnoDB). Kjo mund të ngadalësojë bazën e të dhënave të punës me miliarda regjistrime për ditë, nëse jo javë.
 Ndryshimi i strukturës së të dhënave, nëse ne përdorim globalet, nuk na kushton asgjë. Në çdo moment mund të shtojmë çdo pronë që na nevojitet për çdo objekt, në çdo nivel hierarkie. Ndryshimet e lidhura me rinovimin e degevëve mund të nisin në sfond në një bazë të dhënash në punë.
Prandaj, kur flasim për ruajtjen e objekteve me një numër të madh pronash të opsionalit, globalet janë një zgjedhje e shkëlqyer.
Kujtoj se qasja në çdo pronë është momentale, pasi në global çdo rrugë përbën një B-tree.
Bashkëpunimet e të dhënave në globalet, në përgjithësi, janë një lloj baze të dhënash dokumentare, me mundësinë për të ruajtur informacionin hierarkik. Prandaj, në sektorin e ruajtjes së kartave mjekësore, globalet mund të konkurrojnë me bazat e të dhënave dokumentare. Por akoma, kjo nuk është plotësisht ajoLe të marrim për krahasim, për shembull, MongoDB. Në këtë fushë ajo humbet ndaj globalëve për arsye:
- Shuma e dokumentit. Njësia e ruajtjes është teksti në formatin JSON (më saktësisht BSON) me një maksimum prej rreth 16MB. Kufizimi është bërë që me qëllim që baza JSON të mos ngadalësohet gjatë përpunimit, nëse mbahet një dokument të madh JSON, e më pas të aksesohen fushat. Në këtë dokument duhet të përqendrohet gjithë informacioni mbi pacientin. Të gjithë e dimë se sa të trasha mund të jenë kartat e pacientëve. Madhësia maksimale e kartës prej 16MB e vendos një kufizim për pacientët, kur në kartë janë përfshirë skedarët e MRI, skenat e rëntgenit dhe hetimet e tjera. Në një degë të globalit, megjithatë, mund të kemi informacion deri në gigabajt dhe terabajt. Në princip, mund ta përfundoj këtu, por do të vazhdoj.
- Koha e vetëdijes/ndryshimit/fshirjes së pronave të reja në hartën e pacientit. Një bazë e tillë të dhënash duhet të ngarkojë në memorje tërë hartën në mënyrë të plotë (kjo është një volum i madh!), të analizojë BSON, të hyjë/modifikojë/fshijë një nyje të re, të përditësojë indeksat, ta paketojë në BSON, dhe ta ruajë në disk. Për globalin, mjafton vetëm të referohet te një pronë specifike dhe të kryejë manipulime me të.
- Shpejtësia e aksesit në pronat e veçanta. Kur ka shumë prona në dokument dhe struktura e tij është e shumëfishtë, aksesimi i pronave të veçanta do të jetë më i shpejtë falë faktit që çdo rrugë në global është një B-tree. Në BSON, megjithatë, do të duhet të analizojmë dokumentin në mënyrë lineare për të gjetur pronën e nevojshme.
3.3.2 Të dhënat asociative
Të dhënat asociative (edhe me arrays të ngulitura) janë perfekte për globalet. Për shembull, një array i tillë nga PHP do të shfaqet në imazhin e parë 3.3.1.
$a = array(
  "name" => "Vince Medvedev",
  "city" => "Moscow",
  "threatments" => array(
    "surgeries" => array("apedicectomy", "biopsy"),
    "radiation" => array("gamma", "x-rays"),
    "physiotherapy" => array("knee", "shoulder")
  )
);
3.3.3 Dokumentet hierarkike: XML, JSON
Gjithashtu lehtë ruhen në global. Për ruajtjen mund të organizohen në mënyra të ndryshme.
XML
Mënyra më e thjeshtë për të organizuar XML në global është kur në nyjat ruajmë atributet e etiketave. Nëse do të nevojitet akses i shpejtë në atributet e etiketave, mund t'i ndajmë ato në degë të veçanta.
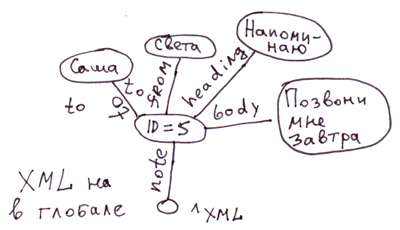
<note id="5">
<to>Vasja</to>
<from>Shpresa</from>
<heading>Kujtesë</heading>
<body>Më telefononi nesër!</body>
</note>
Në COS, kjo do të përfaqësohet me kodin:
Set ^xml("note")="id=5"
Set ^xml("note","to")="Sasha"
Set ^xml("note","from")="Sveta"
Set ^xml("note","heading")="Kujtesë"
Set ^xml("note","body")="Më telefononi nesër!"
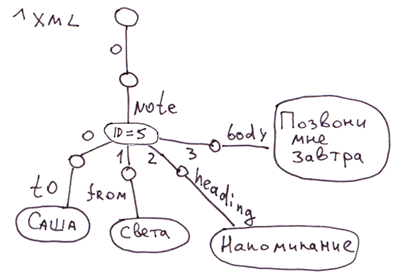
Shënim: Për XML, JSON, dhe të dhëna asociative mund të imagjinohet shumë mënyra të ndryshme për përfaqësimin në global. Në këtë rast, ne nuk pasqyruam rendin e nyjeve të ngulitura në etiketën note. Në globalin ^xml nyjat e ngulitura do të përfaqësohen në rend alfabetik. Për një pasqyrë të saktë të rendit mund të përdoret, për shembull, një përfaqësim i tillë:
JSON.
Në imazhin e parë nga seksioni 3.3.1 paraqitet pasqyra e këtij dokumenti JSON:
var document = {
  "name": "Vince Medvedev",
  "city": "Moscow",
  "threatments": {
    "surgeries": ["apedicectomy", "biopsy"],
    "radiation": ["gamma", "x-rays"],
    "physiotherapy": ["knee", "shoulder"]
  },
};
3.3.4 Struktura të njëjta, të lidhura me marrëdhënie hierarkike
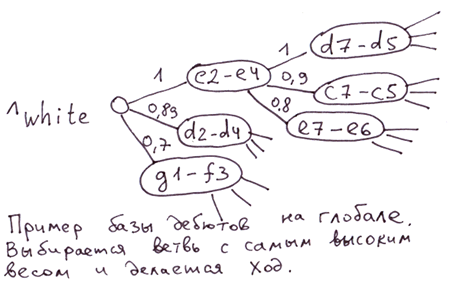
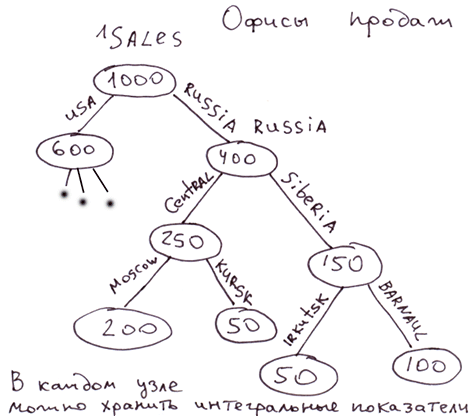
Shembuj: struktura e zyrave të shitjes, pozita e njerëzve në strukturën MLM, baza e hapjeve në shah.
Baza e hapjeve. Si mund të përdorni vlerën e indekseve në nodin global si vlerësimin e forcës së lëvizjes. Atëherë, për të zgjedhur lëvizjen më të fortë, do të mjaftojë të zgjidhni degen me peshën më të madhe. Në glob, të gjitha degët në çdo nivel do të jenë të renditura sipas forcës së lëvizjes.
Struktura e zyrave të shitjeve, struktura e njerëzve në MLM. Në nodet mund të mbahen disa vlera cache që reflektojnë karakteristikat e tërë nënstrukturës. Për shembull, volumi i shitjeve të kësaj nënstrate. Në çdo moment, ne mund të marrim një numër që tregon arritjet e çdo dege.
4. Kur është më e dobishme të përdoren globalët
Në kolonën e parë paraqiten rastet kur do të merrni përfitime të konsiderueshme në shpejtësi duke përdorur globalët, ndërsa në të dytën kur do të thjeshtohet zhvillimi ose modeli i të dhënave.
Shpejtësia
Lehtësia e përpunimit/prezantimit të të dhënave
- Inkorporimi [me renditje automatik në çdo nivel], [indeksim sipas çelësit kryesor]
- Fshirja e nënstrukturave
- Objektet me shumë pronësi të thella, për të cilat nevojitet qasje individuale
- Struktura hierarkike me mundësinë e navigimit në degët e fëmijëve nga ndonjë, edhe nëse nuk ekziston
- Shkarkimi i nënstrukturave në thellësi
- Objektet/qeniet me një numër të madh pronash/entitetesh opsionale [dhe/ose të ngulitura]
- Të dhëna pa skemë (schema-less). Kur ndodhin shpesh pronësi të reja dhe zhduken të vjetra.
- Duhet të krijoni një DB jo standard.
- Baza e rrugëve dhe pemët e vendimeve. Kur rrugët është e përshtatshme t'i paraqiten në formën e një peme.
- Fshirja e strukturave hierarkike pa përdorur rekursivitetin
Vazhdimi .
Kufizimi: Ky artikull dhe komentet e mia për të janë mendimi im dhe nuk kanë të bëjnë me pozitat zyrtare të kompanisë InterSystems.
Burimi: habr.com
