

Shën. përkth.: Ju sjellim për ju detajet teknike mbi arsyet e fundit të ndaljes në funksionimin e shërbimit cloud, të mbajtur nga krijuesit e Grafana. Ky është një shembull klasik se si një mundësi e re, dukshëm e dobishme, e krijuar për të përmirësuar cilësinë e infrastrukturës... mund të dëmtojë, nëse nuk parashikohet numri i madh i nuancave të aplikimit të saj në realitetin e prodhimit. Është e shkëlqyer kur shfaqen materiale të tilla, që lejojnë të mësojmë jo vetëm nga gabimet tona. Detajet janë në përkthimin e këtij teksti nga nën-presidenti për produktet në Grafana Labs.
Në të premten, 19 korrik, shërbimi Hosted Prometheus në Grafana Cloud ndaloi të funksiononte për rreth 30 minuta. Më vjen keq për të gjithë klientët që u preken nga ky ndërprerje. Detyra jonë është të ofrojmë mjetet e duhura për monitorim, dhe ne e kuptojmë se mosdisponueshmëria e tyre e komplikon jetën tuaj. Ne e marrim shumë seriozisht këtë incident. Në këtë shënim shpjegohet se çfarë ndodhi, si reaguam dhe çfarë po bëjmë që kjo të mos ndodhë më.
Historia e mëparshme
Shërbimi Grafana Cloud Hosted Prometheus bazohet në — projektin CNCF për krijimin e një shërbimi Prometheus me shkallëzim horizontal, me disponueshmëri të lartë dhe shumë-qiramarrës (multi-tenant). Arkitektura Cortex përbëhet nga një grup mikroshërbimesh, secili prej të cilëve kryen funksionin e tij: riplikimi, ruajtja, kërkesat etj. Cortex është në zhvillim aktiv, vazhdimisht po shfaqen mundësi të reja dhe rritet performanca. Ne rregullisht nxjerrim versione të reja të Cortex në klasterë, në mënyrë që klientët të mund të përfitojnë nga këto mundësi — fatmirësisht, Cortex di të përditësohet pa ndërprerje.
Për përditësime pa ndërprerje, shërbimi Ingester i Cortex-it kërkon një replikë shtesë të Ingester-it gjatë procesit të përditësimit. (Shën. përkth.: — komponenti bazë i Cortex-it. Detyra e tij është të grumbullojë një rrjedhë të vazhdueshme sample-sh, t'i grupojë ato në chunk-e Prometheus dhe t'i ruajë në një bazë të dhënash si DynamoDB, BigTable ose Cassandra.) Kjo lejon ingesterët e vjetër të dërgojnë të dhënat aktuale te ingesterët e rinj. Vlen të theksohet se ingesterët janë kërkues ndaj burimeve. Për funksionimin e tyre është e nevojshme të kem 4 bërthama dhe 15 GB memorie për pod, dmth. 25% e kapacitetit të procesorit dhe memories së makinës bazë në rastin e klasterëve tanë Kubernetes. Në përgjithësi, ne zakonisht kemi shumë më shumë burime të pandërprera në klaster sesa 4 bërthama dhe 15 GB memorie, prandaj mund të nisnim lehtësisht këta ingesterë shtesë gjatë përditësimeve.
Megjithatë, shpesh ndodh që gjatë punës normale asnjë nga makinat nuk ka këto 25% burime të papërdorura. Po ashtu, ne nuk përpiqemi: CPU dhe memoria gjithmonë do të jenë të nevojshme për procese të tjera. Për të zgjidhur këtë problem, ne vendosëm të përdorim . Ideja është të caktojmë ingesterëve një prioritet më të lartë sesa mikroshërbimeve të tjera (stateless). Kur na nevojitet të nisim një ingester tjetër (N+1), ne përkohësisht zhvendosim pod-ët e tjerë më të vogla. Këta pod-ë transferohen në burimet e lira në makina të tjera, duke lënë një "hapësirë" mjaft të madhe për të nisur ingesterin shtesë.
Më 18 korrik, ne lançuam katër nivele të reja prioriteti në klasterët tanë: kritik, një, mesatar dhe i ulët. Ato u testuan në klasterin tonë të brendshëm pa trafik klientësh për rreth një javë. Në mënyrë të paracaktuar, pod-ët pa prioritet të caktuar merrnin mesatar prioritet, për ingesterët ishte caktuar një klasë me të lartë Rregulli 4a: Nëse detyra përdor të gjithë dritaren e saj të caktuar kohore, atëherë prioriteti i saj Kritik ishte rezervuar për monitorimin (Prometheus, Alertmanager, node-exporter, kube-state-metrics etj.). Konfigurat tona janë të hapura, dhe mund të shihni PR-në .
Aksidente
Më 19 korrik, një nga inxhinierët nisi një klaster të ri të dedikuar Cortex për një klient të madh. Konfigurimi për këtë klaster nuk përfshinte prioritetet e reja të pod-ëve, prandaj të gjithë pod-ët e rinj morën prioritetin e paracaktuar - mesatar.
Në klasterin Kubernetes nuk kishte mjaft burime për klasterin e ri Cortex, dhe klasteri ekzistues i prodhimit Cortex nuk ishte përditësuar (ingesterët mbetën pa të lartë prioritet). Duke qenë se ingesterët e klasterit të ri kishin për parazgjedhje mesatar prioritet, dhe pod-ët ekzistues në prodhim punonin krejtësisht pa prioritet, ingesterët e klasterit të ri zhvendosën ingesterin nga klasteri ekzistues i prodhimit Cortex.
ReplicaSet për ingester-in e dëbuar në klasterin production zbuloi podin e dëbuar dhe krijoi një të ri për të mbajtur numrin e caktuar të kopjeve. Pod-i i ri iu caktua mesatar prioriteti, dhe Ingester-i «i vjetër» në production humbi burimet. Rezultati ishte një proces avullues, i cili çoi në dëbimin e të gjithë pod-eve me Ingester për klasteret production të Cortex-it.
Ingester-at mbajnë gjendjen (stateful) dhe ruajnë të dhënat për 12 orët e kaluara. Kjo na lejon të kompresojmë më efikasht ato para se të shkruhen në ruajtjen afatgjatë. Për këtë, Cortex realizon ndarjen e të dhënave sipas serive, duke përdorur një tabelë të shpërndarë hash (Distributed Hash Table, DHT), dhe riprodhon çdo seri në tre Ingester-a me ndihmën e konsensusit të kuorumit në stilin Dynamo. Cortex nuk shkruan të dhëna në Ingester-at që janë fikur. Kështu, kur numri i madh i Ingester-ave largohet nga DHT, Cortex nuk mund të sigurojë mjaftueshëm riprodhim të regjistrimeve, dhe ato “bien”.
Zbulimi dhe eliminimi
Njoftimet e reja të Prometheus që bazohen në “buxhetin e gabimeve” (error-budget-based — detajet do të shfaqen në një artikull të ardhshëm) filluan të japin alarmin pas 4 minutash nga fillimi i fikjes. Gjatë pesë minutave të ardhshme, ne realizuam diagnostikimin dhe rritëm klasterin Kubernetes të poshtëm për të mbajtur si klasterat production të rinj ashtu edhe ata ekzistues.
Pas pesë minutash, Ingester-at e vjetër shkruan me sukses të dhënat e tyre, ndërsa të rinjtë u aktivizuan, dhe klasteret Cortex u bënë përsëri të disponueshëm.
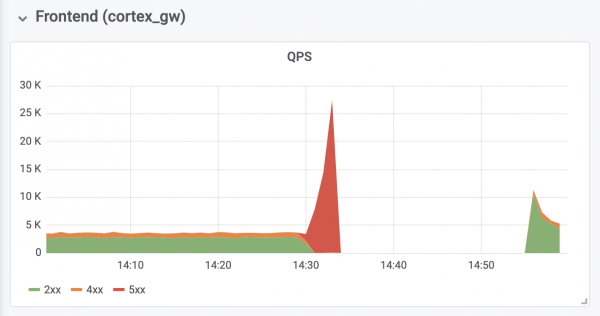
Një tjetër 10 minuta u desh për diagnostikimin dhe rregullimin e gabimeve out-of-memory (OOM) nga serverët e përparmë të autentikimit që ndodheshin përpara Cortex. Gabimet OOM ishin shkaktuar nga rritja dhjetëfish e QPS (siç besojmë, për shkak të kërkesave tepër agresive nga serverët Prometheus të klientëve).
Pasojat
Kohëzgjatja totale e ndërprerjes ishte 26 minuta. Të dhënat nuk u humbën. Ingester-at ngarkuan me sukses të gjitha të dhënat në memory në ruajtjen afatgjatë. Gjatë ndërprerjes, serverët Prometheus të klientëve ruajtën në buffer regjistrimet e largëta (remote) përmes të bazuar në WAL (të autorësisë nga Grafana Labs) dhe përsëritën regjistrimet e dështuar pas çrregullimit.
Operacionet e shkruar të klasterit production
Përfundimet
Është e rëndësishme të nxirren mësime nga ky incident dhe të ndërmerren veprimet e nevojshme për të parandaluar përsëritjen e tij.
Duke shikuar prapa, duhet të pranojmë se nuk duhej të vendosnim përparësi si parazgjedhje mesatar derisa të gjithë Ingesterët në prodhim nuk morën një prioritet. Për më tepër, duhej të ishim kujdesur për prioritetin e tyre të lartë. Tani gjithçka është rregulluar. Shpresojmë që përvoja jonë do të ndihmojë organizatat e tjera që po shqyrtojnë mundësinë e përdorimit të prioriteteve të podëve në Kubernetes.
Ne do të shtojmë një nivel të shtuar kontrolli mbi implementimin e çdo objekti shtesë, konfigurimet e të cilëve janë globale për klasterin. Në të ardhmen, ndryshime të tilla do të vlerësohen ngaonjë numër më i madh njerëzish. Për më tepër, modifikimi që çoi në dështim u konsiderua tepër i parëndësishëm për një dokument projektimi të veçantë — u diskutua vetëm në GitHub issue. Nga ky moment e tutje, të gjitha ndryshimet e tilla të konfigurove do të shoqërohen me dokumentacionin përkatës të projektit.
Në fund, do të automatizojmë rritjen e serverit të përparësisë për të parandaluar OOM gjatë mbingarkesës, të cilët ishim dëshmitarë, dhe do të analizojmë parametrat e Prometheus-it në parazgjedhje, që lidhen me rikthimin dhe dimensionimin, për të parandaluar probleme të ngjashme në të ardhmen.
Dështimi që kaluam kishte edhe disa pasoja pozitive: duke pasur burimet e nevojshme, Cortex u rikuperua automatikisht pa ndërhyrje të mëtejshme. Ne gjithashtu morëm përvojë të vyer në punën me — sistemin tonë të ri të agregimit të log-eve, — që ndihmoi në konfirmimin se të gjithë Ingesterët u sollën siç duhet gjatë dhe pas dështimit.
P.S. nga përkthyesi
Lexoni gjithashtu në blogun tonë:
- «»;
- «»;
- «»;
- «».
Burimi: habr.com
