

Në vitet e fundit, bazat e të dhënave për seritë e kohës (Time-series databases) janë kthyer nga një gjë e pazakontë (e përdorur kryesisht në sisteme specifike monitorimi ose në projekte Big Data) në një "mall për konsum të gjerë". Në territorin e RF, një falënderim të veçantë duhet t'i lutemi Yandex-it dhe ClickHouse. Deri në këtë moment, nëse ju nevojitej të ruani një sasi të madhe të dhënash time-series, duhej ose të pajtoheshit me nevojën për të ngritur një stack monstruoz Hadoop dhe ta mirrni atë, ose të flisnit me protokolle, të cilat ishin individuale për çdo sistem.
Mund të duket se në vitin 2019, një artikull mbi atë se cila TSDB duhet të përdoret do të përbëhej vetëm nga një fjali: "thjesht përdorni ClickHouse." Por... ka nuanca.
Vërtet, ClickHouse po zhvillohet me shpejtësi, baza e përdoruesve po rritet, dhe mbështetja ofrohet shumë aktivisht, por a jemi bërë rob të suksesit publik të ClickHouse, i cili ka zënë hije për zgjidhje të tjera, ndoshta më efektive/për të besuara?
Në fillim të vitit të kaluar, ne filluam rishikimin e sistemit tonë të monitorimit, dhe gjatë procesit u shfaq një pyetje për të zgjedhur bazën e përshtatshme për ruajtjen e të dhënave. Historia e këtij zgjedhjeje është ajo që dua të ndaj këtu.
Formulimi i detyrës
Së pari — një parathënie e domosdoshme. Pse na duhet një sistem monitorimi dhe si është organizuar ai?
Ne filluam ofrimin e shërbimeve të mbështetjes në vitin 2008, dhe deri në vitin 2010 u bë e qartë se ishte e vështirë të agregoheshin të dhënat mbi proceset që ndodhnin në infrastrukturën e klientit me zgjidhjet që ekzistonin në atë kohë (flasim për, s’ka gjë, Cacti, Zabbix dhe Graphite-n në zhvillim).
Kërkesat tona kryesore ishin:
- mbështetje (në atë moment — dhjetëra, dhe në perspektivë — qindra) klientësh brenda një sistemi dhe gjithashtu të kishte një sistem të centralizuar menaxhimi të njoftimeve;
- fleksibilitet në menaxhimin e sistemit të njoftimeve (eskalimi i njoftimeve mes turneve, llogaritja e orarit, baza e njohurive);
- mundësia për detaje të thelluara në grafika (Zabbix në atë moment vizatonte grafika si imazhe);
- ruajtja e gjatë e një sasi të madhe të dhënash (një vit e më shumë) dhe mundësia e nxjerrjes së shpejtë të tyre.
Në këtë artikull na intereson pika e fundit.
Kurse për ruajtjen, kërkesat ishin si në vijim:
- sistemi duhet të punojë shpejt;
- preferohet që sistemi të ketë një ndërfaqe SQL;
- sistemi duhet të jetë stabil dhe të ketë një bazë aktive përdoruesish dhe mbështetje (dikur kemi përjetuar nevojën për të mbështetur sisteme si MemcacheDB, e cila u ndal përparimi, ose depërtimi i shpërndarë MooseFS, ku problemi dokumentohej në gjuhën kineze: nuk dëshironim ta përsërisnim këtë histori për projektin tonë);
- përputhshmëria me teoremën CAP: Consistency (e nevojshme) — të dhënat duhet të jenë aktuale, nuk duam që sistemi i menaxhimit të njoftimeve të mos marrë të dhëna të reja dhe të lëshojë alarme për mungesë të dhënash për të gjithë projektet; Partition Tolerance (e nevojshme) — nuk duam të kemi një sistem Split Brain; Availability (jo kritike, në raste të një replike aktive) — mund të kalojmë vetë në sistemin rezervë në rast emergjence, me kod.
Siç ndodh shpesh, zgjidhja ideale për ne në atë moment ishte MySQL. Struktura jonë e të dhënave ishte jashtëzakonisht e thjeshtë: id e serverit, id e numëruesit, timestamp dhe vlera; kërkimi i shpejtë i të dhënave të nxehta arrihej me madhësinë e madhe të buffer pool, ndërsa kërkimi i të dhënave historike — me SSD.
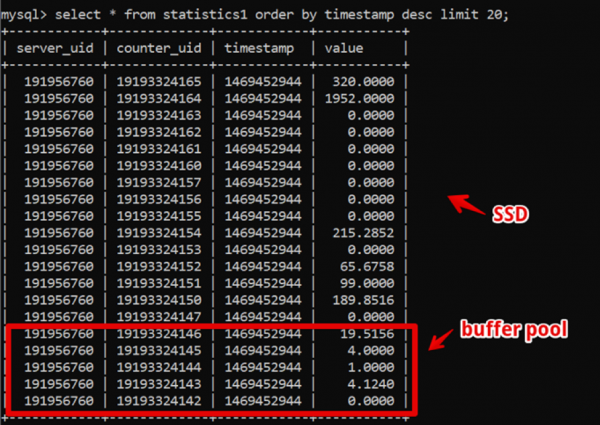
Në këtë mënyrë, arritëm të nxjerrim të dhënat e freskëta të dy javëve, me detaje deri në sekondë për 200 ms deri në momentin e plotë të vizatimit të të dhënave, dhe jetuam në këtë sistem për një kohë të gjatë.
Megjithatë, koha kalonte dhe sasia e të dhënave po rritej. Deri në vitin 2016, volumet e të dhënave arritën dhjetëra terabajt, që nën kushtet e ruajtjeve SSD në qira ishte një shpenzim substancial.
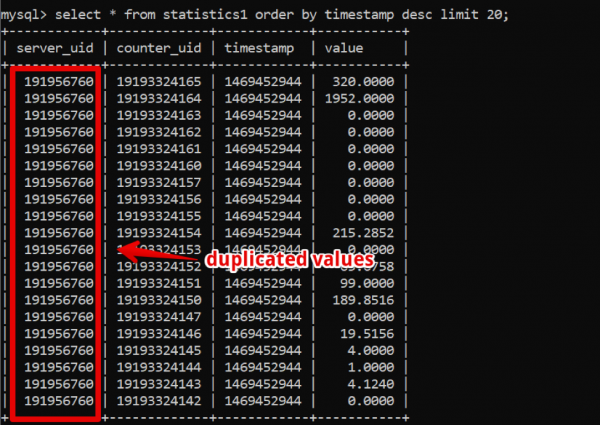
Në këtë moment, database kolonare ishin përhapur aktivisht, për të cilat filluam të mendonim seriozisht: në databazat kolonare të dhënat ruhen, siç mund ta kuptoni, në kolona, dhe nëse shikoni të dhënat tona, është e lehtë të shihni një numër të madh duplikatesh, të cilat mund të kompresohen në rastin e përdorimit të një database kolonare.
Megjithatë, sistemi kyç për funksionimin e kompanisë vazhdonte të punonte stabilisht, dhe nuk dëshironim të eksperimentonim me kalimin në diçka tjetër.
Në vitin 2017, në konferencën Percona Live në San Jose, ndoshta për herë të parë zhvilluesit e Clickhouse shpallën veten. Në pamje të parë, sistemi dukej i përshtatshëm për prodhim (për të qenë të sinqertë, Yandex.Metrica — është një prodhim i vështirë), mbështetja ishte e shpejtë dhe e thjeshtë, dhe më e rëndësishmja, operimi ishte i lehtë. Që nga viti 2018 filluam procesin e kalimit. Por në atë kohë kishte shumë sisteme TSDB të
Në shtesë të kërkesave tashmë të përmendura për magazinimin, u shfaqën disa të reja:
- sistemi i ri duhet të ofrojë, të paktën, të njëjtin performancë si MySQL, në të njëjtin sasi hardueri;
- magazina e sistemit të ri duhet të marrë ndjeshëm më pak hapësirë;
- SGBD duhet të vazhdojë të jetë i thjeshtë për t'u menaxhuar;
- do të doja të ndryshoja sa më pak aplikacionin kur të kaloj te SGBD tjetër.
Cilat sisteme filluam të shqyrtonim
Apache Hive/ Apache Impala
Staku Hadoop, i provuar nga beteja. Në thelb, ky është një ndërfaqe SQL e ndërtuar mbi ruajtjen e të dhënave në formate specifike në HDFS.
Përfitimet.
- Me një funksionim të stabilizuar, është shumë e lehtë të shkallëzosh të dhënat.
- Ka zgjidhje kolonë për ruajtjen e të dhënave (më pak hapësirë).
- Ekzekutimi i shpejtë i detyrave të ndara kur ka burime.
Disavantazhet.
- Kjo është Hadoop, dhe është e ndërlikuar për t'u operuar. Nëse nuk jemi të gatshëm të marrim një zgjidhje të gatshme në cloud (dhe ne nuk jemi të gatshëm për shkak të kostos), e gjithë staku duhet të ndërtohet dhe mbështetet manualisht nga administratorët, dhe kjo nuk është diçka që dëshirojmë.
- Të dhënat agregohen .
Megjithatë:
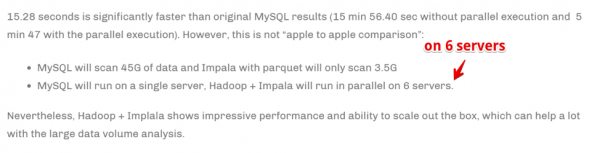
Shpejtësia arrihet duke shkallëzuar numrin e serverëve të përpunimit. Thënë ndryshe, nëse jemi një kompani e madhe, merremi me analitikën dhe për biznesin është kritikisht e rëndësishme të agregojmë informacionin sa më shpejt të jetë e mundur (madje edhe me çmimin e përdorimit të një sasie të madhe burimesh përpunuese) — kjo mund të jetë zgjedhja jonë. Por ne nuk ishim të gatshëm të rritnim ndjeshëm numrin e harduerit për shpejtësinë e ekzekutimit të detyrave.
Druid/Pinot
Tani, shumë më tepër për konkret TSDB, por përsëri — staku Hadoop.
Ka .
Në disa fjalë: Druid/Pinot duken më mirë se Clickhouse në raste kur:
- Ju keni një karakter heterogjen të të dhënave (në këtë rast ne regjistrojmë vetëm seri temporale të metrikave të serverëve, dhe, në thelb, kjo është një tabelë. Por mund të ketë raste të tjera: seri temporale të pajisjeve, seri temporale ekonomike, etj. - çdo njëra me strukturën e saj, të cilat duhet të agregohen dhe të përpunohen).
- Megjithatë, këto të dhëna janë shumë të shumta.
- Tabelat dhe të dhënat me seri temporale shfaqen dhe zhduken (domethënë, një grup i caktuar të dhënash ka ardhur, është analizuar dhe është fshirë).
- Nuk ka një kriter të qartë sipas të cilit të dhënat mund të ndahen në pjesë.
Në raste të tjera, ClickHouse tregon rezultate më të mira, dhe kjo është rasti ynë.
ClickHouse
- Përafërsisht si SQL.
- E lehtë për t'u menaxhuar.
- Njerëzit thonë se funksionon.
Bën pjesë në listën e shkurtër për testim.
InfluxDB
Alternativa ndërkombëtare për ClickHouse. Nga disavantazhet: Disponueshmëria e Lartë gjendet vetëm në versionin komercial, por duhet ta krahasojmë.
Bën pjesë në listën e shkurtër për testim.
Cassandra
Nga njëra anë, ne e dimë se përdoret për ruajtjen e serive temporale metrikore nga sisteme monitorimi si, për shembull, ose OkMeter. Megjithatë, ka disa veçori.
Cassandra nuk është një bazë të dhënash kolonore në kuptimin e zakonshëm të saj. Duket më shumë si thjesht një rresht, por në çdo rresht mund të ketë numra të ndryshëm kolonesh, çka lehtëson organizimin e përfaqësimit kolonor. Në këtë kuptim është e kuptueshme që me një kufizim prej 2 miliard kolonash, mund të ruhet disa të dhëna në kolonat (po ato seritë temporale). Për shembull, në MySQL ka një kufizim prej 4096 kolonash dhe atje është e lehtë të hasësh në gabimin me kod 1117, nëse përpiqesh të bësh të njëjtën gjë.
Motor Cassandra është i orientuar për ruajtjen e sasisë së madhe të të dhënave në një sistem të shpërndarë pa master, dhe në teoremën CAP të përmendur më sipër, Cassandra është më shumë për AP, pra për disponueshmërinë e të dhënave dhe qëndrueshmërinë ndaj ndarjes së particioneve. Kështu, ky mjet mund të jetë shumë i përshtatshëm, nëse ne duam të shkruajmë vetëm në këtë bazë dhe të lexojmë mjaft rrallë nga ajo. Dhe këtu ka logjikë që ta përdorim Cassandra si një “depozitë të ftohtë”. Kështu, si një vend të besueshëm për ruajtjen afatgjatë të sasisë së madhe të të dhënave historike që kërkohen rrallë, por në rast nevoje mund të nxirren. Megjithatë, për plotësinë e imazhit, do ta testojmë edhe atë. Por, siç e kam thënë më parë, nuk kam dëshirë të rishkruaj aktivisht kodin për zgjidhjen e zgjedhur të DB, prandaj do ta testojmë atë disi të kufizuar - pa adaptimin e strukturës së bazës sipas specifikave të Cassandra.
Prometheus
Pra, dhe tashmë nga kurioziteti, vendosëm të testojmë performancën e magazinës Prometheus - thjesht për të kuptuar nëse ne jemi më të shpejtë se zgjidhjet aktuale ose më të ngadaltë dhe sa.
Metodika dhe rezultatet e testimit
Pra, testuam 5 bazat e të dhënave në 6 konfigurime të mëposhtme: ClickHouse (1 nod), ClickHouse (tabela e shpërndarë në 3 node), InfluxDB, Mysql 8, Cassandra (3 node) dhe Prometheus. Plani i testimit është si më poshtë:
- ngarkojmë të dhënat historike për një javë (840 mln vlera në ditë; 208 mijë metrika);
- gjenerojmë ngarkesën për shkrim (kemi konsideruar 6 mënyra ngarkese, shih më poshtë);
- paralelisht me shkrimin, kryejmë përjashtime duke imituar pyetje nga përdoruesi, që punon me grafikët. Për të mos e komplikuar shumë, zgjedhim të dhënat për 10 metrika (aq sa janë në grafikun CPU) për një javë.
Ngarkojmë, duke imituar sjelljen e agjentit tonë të monitorimit, i cili dërgon në çdo metrikë vlera çdo 15 sekonda. Në këtë rast, na intereson të ndryshojmë:
- numri i përgjithshëm i metricave, në të cilat shkruhen të dhënat;
- intervali i dërgimit të vlerave në një metrikë;
- përmasat e grupit.
Përmasat e grupit. Duke qenë se pothuajse të gjitha bazat tona të studimit nuk rekomandojnë ngarkimin me inserte të vetme, do të na nevojitet një sistem që mbledh metrikat e ardhura dhe i grumbullon ato ndonjëherë dhe i shkruan në bazë me insert të paketuar.
Po kësaj radhe, për të kuptuar më mirë si të interpretojmë të dhënat e marrë më vonë, le të imagjinojmë se nuk po dërgojmë thjesht një mori metrikash, por metrikat janë të organizuara në serverë — me nga 125 metrika për server. Këtu serveri është thjesht një entitet virtual — thjesht për të kuptuar se, për shembull, 10000 metrika përputhen me rreth 80 serverë.
Dhe tani, duke marrë parasysh të gjitha këto, kemi 6 modelet e ngarkesës për bazën në shkrim:
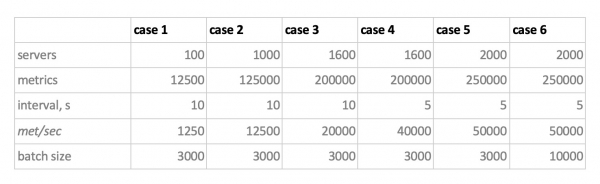
Këtu ka dy pika. Së pari, për Cassandra, këto madhësi grupesh rezultuan tepër të mëdha, aty ne përdorëm vlera 50 ose 100. Së dyti, duke qenë se Prometheus funksionon ngushtësisht në mënyrën pull, pra ai shkon dhe merr të dhëna nga burimet e metrikave (dhe madje pushgateway, pavarësisht emrit, nuk e ndryshon situatën thelbësisht), ngarkesat përkatëse u realizuan me një kombinim të konfigurimeve statike.
Rezultatet e testimit janë këto:
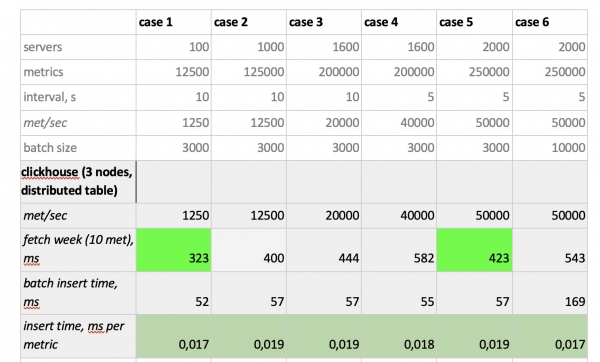
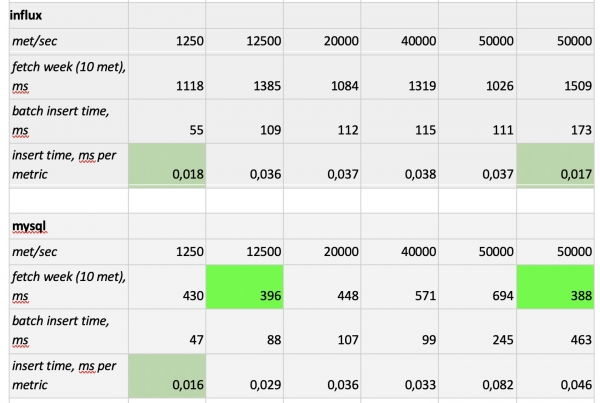
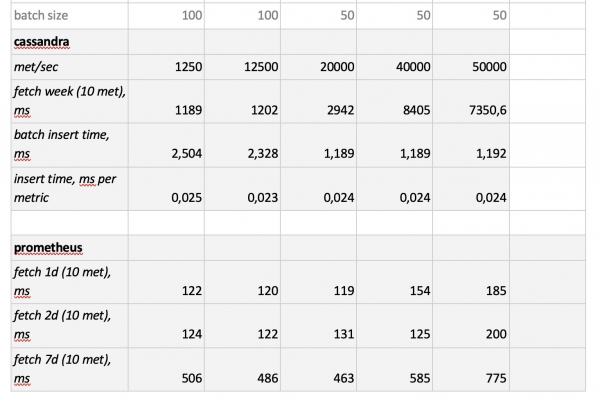
Çka është e rëndësishme të theksohet: përzgjedhjet jashtëzakonisht të shpejta nga Prometheus, përzgjedhjet tepër të ngadalta nga Cassandra, përzgjedhjet e papranueshme të ngadalta nga InfluxDB; në shpejtësinë e shkrimit, ClickHouse fitoi të gjitha garat, ndërsa Prometheus nuk mori pjesë, sepse ai bën inserte brenda vetes dhe ne nuk matim asgjë.
Në fund: më mirë se të gjithë u treguan ClickHouse dhe InfluxDB, por një klaster nga Influx mund të ndërtohet vetëm mbi bazën e versionit Enterprise, i cili ka një çmim, ndërsa ClickHouse nuk ka kosto dhe është bërë në Rusi. Logjikisht, në SHBA zgjedhja, ndoshta, do të ishte për InfluxDB, ndërsa tek ne — për ClickHouse.
Burimi: habr.com
