

Më 27 maj në sallën kryesore të konferencës DevOpsConf 2019, që po zhvillohet në kuadër të festivalit , në kuadër të sesionit "Shpërndarja e vazhdueshme", u mbajt një kumtesë "werf - mjeti ynë për CI/CD në Kubernetes". Ajo flet për ato problemet dhe sfidat me të cilat përballet çdo njeri gjatë deploimit në Kubernetes, si dhe për nuancat që mund të mos duken menjëherë. Duke analizuar posibilitetet e zgjidhjeve, ne tregojmë se si është realizuar në mjetin Open Source .
Që nga paraqitja, utilita jonë (e njohur më parë si dapp) ka kaluar një pikë historike në 1000 yje në GitHub — shpresojmë se komuniteti në rritje i përdoruesve të saj do të lehtësojë jetën e shumë inxhinierëve DevOps.
Prandaj, paraqesim (~47 minuta, shumë informative më shumë se artikulli) dhe një përmbledhje themelore të saj në formë tekstuale. Le të fillojmë!
Dërgimi i kodit në Kubernetes
Kumtesa do të flasë më shumë jo për werf, por për CI/CD në Kubernetes, duke nënkuptuar se softi ynë është paketuar në konteinerë Docker (këtë e kam folur në ), dhe K8s do të përdoret për ta nisur atë në prodhim (për këtë — në ).
Si duket dërgimi në Kubernetes?
- Ka një repozitor Git me kodin dhe udhëzimet për ndërtimin e tij. Aplikacioni ndërtohet në një imazh Docker dhe publikohet në Docker Registry.
- Në të njëjtin repozitor ka edhe udhëzime për mënyrën e deploimit dhe nisjes së aplikacionit. Në fazën e deploimit, këto udhëzime dërgohen në Kubernetes, i cili merr imazhin e nevojshëm nga registry dhe e nis atë.
- Për më tepër, zakonisht ka teste. Disa prej tyre mund të kryhen gjatë publikimit të imazhit. Gjithashtu mund të (sipër udhëzimeve të njëjta) rrisni një kopje të aplikacionit (në një hapësirë emri të veçantë K8s ose në një klaster të veçantë) dhe të kryeni testet aty.
- Në fund, nevojitet një sistem CI që merr ngjarje nga Git (ose klikime butonash) dhe thërret të gjitha fazat e caktuara: ndërtim, publikim, deploim, testim.
Këtu ka disa vërejtje të rëndësishme:
- Duke qenë se ne kemi një infrastrukturë të pandryshueshme (infrastructure e pandryshueshme), imazhi i aplikacionit, që përdoret në të gjitha fazat (staging, prodhim etj.), duhet të jetë një. Për më shumë informacion mbi këtë me shembuj kam folur .
- Duke qenë se ndiqnim qasjen infrastrukturë si kod (IaC), kodi i aplikacionit, udhëzimet për ndërtimin dhe nisjen e tij duhet të jenë pikërisht në një repozitor. Për më shumë mbi këtë - shih në .
- Faza e dorëzimit (delivery) zakonisht e shohim kështu: aplikacioni është ndërtuar, testuar, lëshuar (fazë release) dhe gjithçka — dërgesa u realizua. Por në të vërtetë, përdoruesi merr atë që ju publikoni, jo kur e çuat atë në production, dhe kur ai ka mundësinë të hyjë aty dhe ky production funksionoi. Prandaj, mendoj se zinxhiri i dërgesës përfundon vetëm në fazën e operimit (run), dhe nëse flasim më saktë, madje në atë moment, kur kodi u hoq nga production (duke e zëvendësuar atë me një të ri).
Le të kthehemi te skema e dërgesës të përmendur më sipër në Kubernetes: ajo u shpik jo vetëm nga ne, por edhe nga praktisht çdo kush që është marrë me këtë problem. E vërteta është se tani ky model quhet GitOps (më shumë për termin dhe idetë që qëndrojnë pas tij mund të lexoni ). Le të shohim fazat e skemës.
Faza e ndërtimit (build)
Duket se çfarë mund të tregosh në vitin 2019 për ndërtimin e imazheve Docker, kur të gjithë dinë të shkruajnë Dockerfile dhe të launch docker build?.. Вот нюансы, на которые хотелось бы обратить внимание:
- Pesha e imazhit ka rëndësi, prandaj përdorni , për të lënë në imazh vetëm atë që është në të vërtetë e nevojshme për funksionimin e aplikacionit.
- Numri i shtresave duhet minimizuar, duke i kombinuar zinxhirët e
RUN-komandave sipas kuptimit. - Megjithatë, kjo shton probleme në debugging, sepse kur ndodhi një gabim në ndërtim, duhet të gjejmë atë komandë të nevojshme nga zinxhiri që shkaktoi problemin.
- Shpejtësia e ndërtimit është e rëndësishme, sepse duam të nxjerrim ndryshime shpejt dhe të shohim rezultatin. Për shembull, nuk është dëshirë të ripohojmë varësitë në bibliotekat e gjuhës në çdo ndërtim të aplikacionit.
- Shpesh nga një Git-repository kërkohen shumë imazhe, që mund të zgjidhet me një grup Dockerfile-ësh (ose faza të emërtuara në një skedë) dhe një skript Bash me ndërtimin e tyre në mënyrë sekondare.
Kjo ishte vetëm maja e ajsbergut me të cilin përballen të gjithë. Por ekzistojnë edhe probleme të tjera, në veçanti:
- Shpesh në fazën e ndërtimit na nevojitet të montojmë (për shembull, të keshojmë rezultatin e komandës së tipit apt në një direktor të jashtëm).
- Ne duam Ansible ndryshe nga shkruani në shell.
- Ne duam të ndërtojmë pa Docker (pse na nevojitet një makinë virtuale shtesë, në të cilën duhet të gjitha të konfigurohen për këtë, kur tashmë ekziston një klaster Kubernetes, në të cilin mund të nisim konteinerit?).
- Ndërtimi paralel, i cili mund të kuptohet në mënyra të ndryshme: komandat e ndryshme nga Dockerfile (nëse përdoret multi-stage), disa komite të një repository, disa Dockerfile.
- Ndërtimi i shpërndarë: ne duam të mbledhim diçka në pod’ash, të cilat janë "efemerike", pasi ata humbasin cache, pra – duhet ta ruajmë diku veçmas.
- Në fund, unë e quajta majën e dëshirave automagji: do të ishte përsosmërisht të hysh në depo, të shkruash ndonjë komandë dhe të marrësh një imazh të gatshëm, i ndërtuar me kuptimin se si dhe çfarë duhet bërë siç duhet. Megjithatë, personalisht nuk jam i sigurt se të gjitha nuancat mund të parashikohen kështu.
Dhe ja, ka projekte:
- — ndërtuesi nga kompania Docker Inc (tani i integruar në versionet aktuale të Docker), e cila përpiqet të zgjidhë të gjitha këto probleme;
- — ndërtuesi nga Google, që lejon ndërtimin pa Docker;
- — përpjekja e CNCF për të bërë automagjinë dhe, në veçanti, një zgjidhje interesante me rebase për shtresa;
- dhe ende shumë utilitete të tjerë, të tillë si , …
… dhe shihni sa shumë yje kanë në GitHub. Pra, nga njëra anë, docker build ka dhe mund të bëjë diçka, por në fakt çështja nuk është e zgjidhur deri në fund — dëshmi për këtë është zhvillimi paralel i ndërtuesve alternativë, çdo njëri prej të cilëve zgjidh një pjesë të problemeve.
Ndërtimi në werf
Kështu arritëm te (më parë si dapp) — utiliteti Open Source i kompanisë "Flant", që ne e zhvillojmë tashmë për shumë vite. E gjithë kjo filloi rreth 5 vjet më parë me skriptat Bash, që optimizonin ndërtimin e Dockerfile-ve, dhe dy vitet e fundit zhvillohet një projekt i plotë me një depo të vet. (fillimisht në Ruby, dhe pastaj në Go, dhe njëkohësisht u rinovua). Çfarë probleme të ndërtimit zgjidhen në werf?
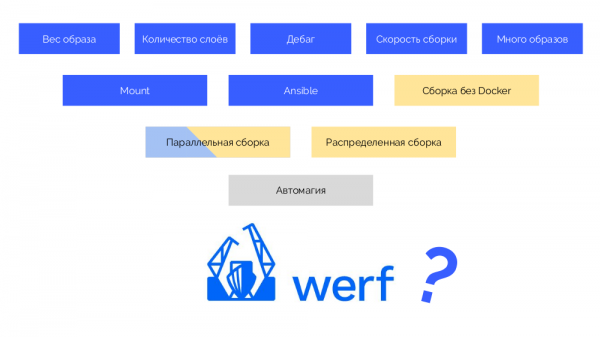
Problemet e ngjyrosura me blu janë tashmë të realizuara, ndërtimi paralel është bërë brenda një hosti, dhe problemet e shënuara me të verdhë planifikojmë t'i përfundojmë deri në fund të verës.
Faza e publikimit në registry (publish)
Mblodhëm docker push… — çfarë mund të jetë e komplikuar për të ngarkuar një imazh në registry? Dhe këtu lind pyetja: "Cila etiketë t'i japim imazhit?" Ajo lind për shkak se kemi Gitflow (ose një strategji tjetër të Git-it) dhe Kubernetes, dhe industria përpiqet që ajo që ndodh në Kubernetes të pasojë atë që bëhet në Git. Sepse Git — është burimi ynë i vetëm i të vërtetës.
Çfarë ka të vështirë në këtë? Të garantojmë riprodhueshmërinë: nga commiti në Git, i cili për natyrën e tij është i pandryshueshëm (immutable), deri në imazhin Docker, i cili duhet të ruhet i tillë.
Na është gjithashtu e rëndësishme të përcaktojmë origjinën, sepse dëshirojmë të kuptojmë nga cili commit është ndërtuar aplikacioni, i cili është e hapur në Kubernetes (ateherë mund të bëjmë diff dhe gjëra të ngjashme).
Strategjitë e etiketimit
E para është e thjeshtë git tag. Kemi një regjistrim me imazhin, i etiketuar si 1.0. Në Kubernetes ka një stage dhe prodhim, ku ky imazh është shkarkuar. Në Git ne bëjmë commit dhe në një moment vendosim një etiketë 2.0. E grumbullojmë atë sipas udhëzimeve nga repository dhe e vendosim në regjistrin me etiketën 2.0. E dërgojmë në stage dhe, nëse gjithçka shkon mirë, më pas në prodhim.
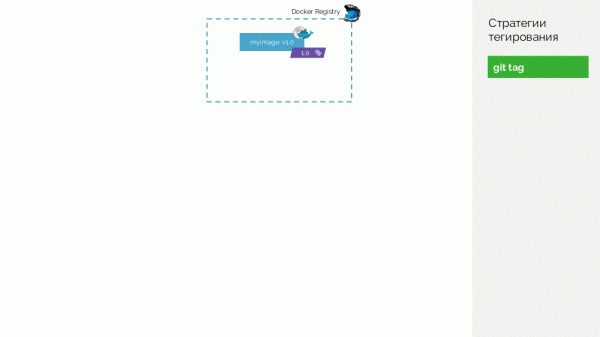
Problemi me këtë qasje është se fillimisht vendosëm etiketën dhe vetëm pastaj e testuam dhe e dërguam. Pse? Së pari, është thjesht ilogjike: ne po lëshojmë një version të softuerit, të cilin nuk e kemi verifikuar ende (nuk mund ta bëjmë ndryshe, pasi për ta verifikuar, ne duhet të vendosim etiketën). Së dyti, një rrugë e tillë nuk përputhet me Gitflow.
Opcioni i dytë është git commit + tag. Në degën master ka një etiketë 1.0; për të, në regjistrim – imazhi, i implementuar në prodhim. Për më tepër, në klasterin Kubernetes ka skema preview dhe staging. Më pas ndjekim Gitflow: në degën kryesore për zhvillim (develop) bëjmë karakteristika të reja, duke rezultuar në një commit me identifikuesin #c1. E grumbullojmë dhe e publikojmë në regjistrin, duke përdorur këtë identifikues (#c1). Me të njëjtin identifikues e dërgojmë në preview. Po ashtu, bëjmë me commitet #c2 dhe #c3.
Kur e kuptojmë se kemi mjaft karakteristika, fillojmë të stabilizojmë gjithçka. Në Git krijojmë një degë release_1.1 (bazuar në #c3 nga develop). Nuk do të nevojitet të grumbullojmë këtë lëshim, sepse është bërë në fazën e mëparshme. Prandaj mund ta dërgojmë thjesht në staging. Ndërsa korrigjojmë gabimet në #c4 dhe po ashtu e dërgojmë në staging. Paralelisht, në të njëjtën kohë zhvillohet puna në develop, ku ndryshimet e ndihen nganjëherë nga release_1.1. Në një moment e marrim commit-in e grumbulluar dhe të dërguar në staging, me të cilin jemi të kënaqur (#c25).
Atëherë bëjmë merge (me fast-forward) të degës së lëshimit (release_1.1) në master. Vendosim në këtë commit një etiketë me versionin e ri (1.1). Por ky imazh është tashmë ndërtuar në regjistër, prandaj, për të mos e ndërtuar përsëri, ne thjesht shtojmë një etiketë të dytë në imazhin ekzistues (tani ai në regjistër ka etiketat #c25 dhe 1.1). Pas kësaj, e dërgojmë në prodhim.
Ka një disavantazh, që në staging është diskutuar një imazh (#c25), ndërsa në prodhim – siç duket - një tjetër (1.1), por ne e dimë se 'fizikisht' është e njëjta imazh nga regjistri.
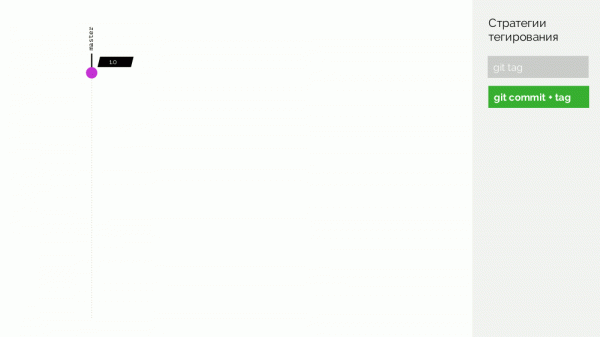
Megjithatë, disavantazhi i vërtetë është se nuk ka mbështetje për merge commit, duhet ta bëjmë fast-forward.
Mund të shkojmë më tej dhe të bëjmë një trik... Le të shqyrtojmë një shembull të një Dockerfile të thjeshtë:
FROM ruby:2.3 as assets
RUN mkdir -p /app
WORKDIR /app
COPY . ./
RUN gem install bundler && bundle install
RUN bundle exec rake assets:precompile
CMD bundle exec puma -C config/puma.rb

FROM nginx:alpine
COPY --from=assets /app/public /usr/share/nginx/www/public
Do ta ndërtojmë këtë skedar sipas kësaj parimi, që do të marrim:
- SHA256 nga identifikuesit e imazheve të përdorura (
ruby:2.3dhenginx:alpine), të cilat janë shumicat kontrolluese të përmbajtjes së tyre; - të gjitha komandat (
RUN,CMDetj.); - SHA256 nga skedarët që janë shtuar.
… dhe do të marrim shumicën kontrolluese (sërish SHA256) nga një skedar i tillë. Kjo nënshkrim e gjithçkaje që përcakton përmbajtjen e imazhit Docker.
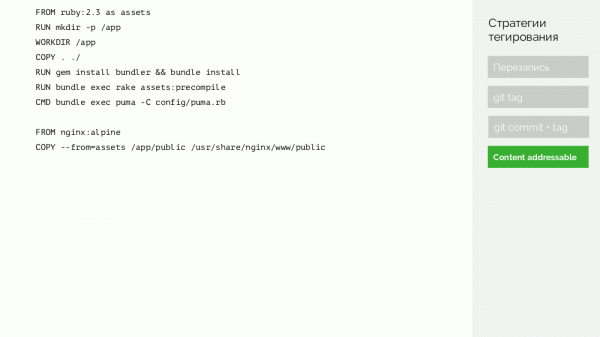
Të kthehemi te skema dhe në vend të komiteteve do të përdorim një nënshkrim të tillë, dmth. të etiketojmë imazhet me nënshkrime.
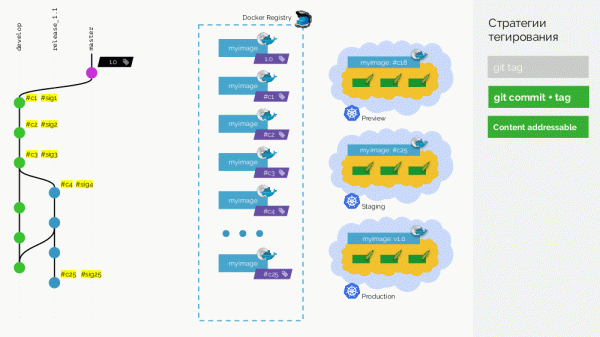
Tani, kur të nevojitet, për shembull, të 'bashkohen' ndryshimet nga lëshimi në master, mund të kryejmë një komitet të vërtetë të bashkimit: do të ketë një identifikues tjetër, por të njëjtën nënshkrim. Me të njëjtin identifikues do ta lëshojmë imazhin edhe në production.
Mungesa është se tani nuk do të jetë e mundur të përcaktojmë se cili komitet është çuar në production — shumicat kontrolluese punojnë vetëm në një drejtim. Kjo problem zgjidhet me një shtresë shtesë me metadata — do të flas më shumë për këtë më vonë.
Etiketimi në werf
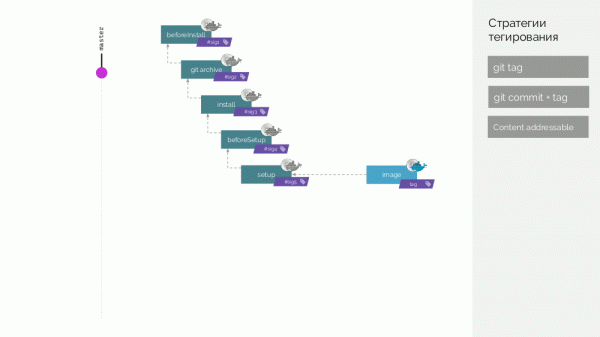
Në werf ne shkuam edhe më tej dhe po përgatitemi të bëjmë një ndërtim të shpërndarë me cache, i cili nuk ruhet në një makinë... Pra, ne po ndërtuam imazhe Docker të dy llojeve, të cilat i quajmë ) — një njësi organizimi e pipeline-it, përmban 1+ detyrë, dhe image.
Në depozita Git werf ruhen udhëzime specifike për ndërtim, që përshkruajnë fazat e ndryshme të ndërtimit (beforeInstall, instalo, paraSetup, setup). Ne e ndërtuam imazhin e parë të fazës me nënshkrim, e cila është përcaktuar si shumicë kontrolluese e hapave të parë. Pastaj shtojmë kodin burimor, për imazhin e ri të fazës e llogarisim shumicën kontrolluese... Këto operacione përsëriten për të gjitha fazat, duke rezultuar në një grup imazhesh të fazave. Pastaj krijojmë imazhin përfundimtar, i cili përmban gjithashtu metadata mbi prejardhjen e tij. Dhe ky imazh ne e etiketojmë në mënyra të ndryshme (detaje më vonë).
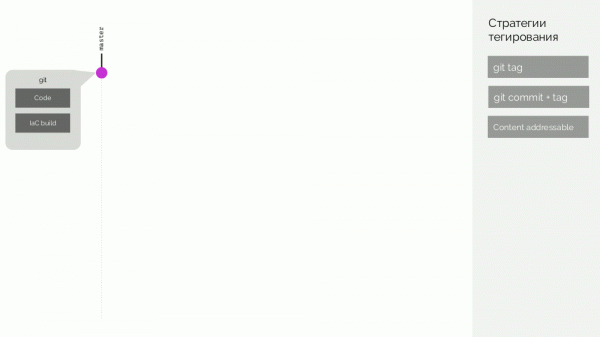
Le të ndodhë që një angazhim i ri të shfaqet, ku është ndryshuar vetëm kodi i aplikacionit. Çfarë do të ndodhë? Do të krijohet një patch për ndryshimet e kodit, një imazh i ri stage do të përgatitet. Nënshkrimi i tij do të përcaktohet si një kontrolli i shumës së vjetër të imazhit të stage dhe patch-eve të reja. Nga ky imazh do të formohet dhe një imazh final i ri.
Prandaj, imazhet stage janë një kesh që mund të ruhet në mënyrë të shpërndarë, ndërsa imazhet që krijohen prej tij ngarkohen në Docker Registry.
Pastrimi i registry
Nuk do të flasim për fshirjen e shtresave që kanë mbetur të varura pas etiketave të fshira, kjo është një mundësi standarde e Docker Registry vetë. Bëhet fjalë për situatën kur akumulohet një numër i madh i etiketave Docker dhe ne e kuptojmë se një pjesë e tyre nuk na nevojitet më, por ata po zënë hapësirë (dhe/ose ne po paguajmë për të).
Cilat janë strategjitë e pastrimit?
- Mund të mos bësh asgjë në pastrim. Ndonjëherë është gjithashtu më e lehtë të paguash për hapësirën e tepërt se sa të zgjidhesh nga një klumb i madh i etiketave. Por kjo funksionon vetëm deri në një pikë të caktuar.
- Rimbus i plotë. Nëse fshihen të gjitha imazhet dhe rikonstruktivohen vetëm ato aktuese në sistemin CI, atëherë mund të ndodhë një problem. Nëse kontejneri do të rinisë në prodhim, për të do të ngarkohet një imazh i ri — një që nuk është testuar nga askush. Kjo shkatërron idenë e infrastrukturës së pandryshueshme.
- Blu-jeshile. Një registry filloi të mbushet — ngarkohet imazhe në një tjetër. E njëjta problematikë si në mënyrën e mëparshme: në cilën pikë mund të pastroni atë registry që filloi të mbushej?
- Sipas kohës. Të fshihen të gjitha imazhet më të vjetra se 1 muaj? Por patjetër do të ketë një shërbim që nuk është përditësuar për një muaj…
- Dore të përcaktojë se çfarë mund të fshihet tashmë.
Ka dy mundësi të vërteta jetësore: të mos pastroni ose një kombinim nga blu-jeshil + dorazi. Në këtë rast, bëhet fjalë për sa vijon: kur e kuptoni se është koha për të pastruar registry, krijoni një të ri dhe shtoni të gjitha imazhet e reja në të për një periudhë, për shembull, një muaj. Pas një muaji shikoni se cilat pod-i në Kubernetes akoma përdorin registry të vjetër, dhe i transferoni ato gjithashtu në registry të ri.
Çfarë kemi arritur në werf? Мы собираем:
- Git head: të gjitha etiketat, të gjitha degët, — duke supozuar se gjithçka që është etiketuar në Git, na nevojitet dhe në imazhe (dhe nëse jo, atëherë duhet fshirë në vetë Git-in);
- të gjitha pod’ët që po shkarkohen tani në Kubernetes;
- ReplicaSet’ët e vjetra (ato që ishin shkarkuar së fundmi), si dhe do të skanojmë Helm-release dhe do të marrim imazhet më të fundit aty.
… dhe e bëjmë këtë grup whitelist — lista e imazheve që nuk do t'i heqim. Çdo gjë tjetër do ta pastronsim, pas së cilës do të gjejmë imazhet stage jetimore dhe do t'i heqim ato gjithashtu.
Faza e deploy-it
Deklarativitet i besueshëm
Momenti i parë, për të cilin do të doja të tërhiqja vëmendjen në deploy, është lëshimi i konfiguracionit të rinovuar të burimeve, i shpallur në mënyrë deklarative. Dokumenti origjinal YAML me përshkrimin e burimeve të Kubernetes gjithmonë dallon shumë nga rezultati që funksionon realisht në klaster. Sepse Kubernetes shton në konfiguracion:
- identifikuesit;
- informacionin e shërbimeve;
- shumë vlera përkatëse;
- seksionin me statusin aktual;
- ndryshimet e bëra gjatë punës së admission webhook;
- rezultatin e punës së kontrolluesve të ndryshëm (dhe planifikuesit).
Pra, kur shfaqet një konfigurim i ri burimi (të reja), ne nuk mund ta marrim thjesht dhe ta shkruajmë atë mbi konfigurimin aktual, "live", (live). Për këtë, na duhen të krahasojmë të reja me konfigurimin e aplikuar më parë (last-applied) dhe të aplikojmë live patch-in e marrë.
Ky qasje quhet 2-way merge. Ai përdoret, për shembull, në Helm.
Ka edhe 3-way merge, i cili dallon nga fakti se:
- duke krahasuar last-applied dhe të reja, ne shohim çfarë është fshirë;
- duke krahasuar të reja dhe live, ne shohim çfarë është shtuar ose ndryshuar;
- patch-i i totalizuar vihet mbi live.
Ne e deploy-ojmë 1000+ aplikacione me Helm, kështu që në fakt jetojmë me 2-way merge. Megjithatë, ai ka një sërë probleme, që i kemi zgjidhur me patch-et tona, duke ndihmuar Helm-in të punojë normalisht.
Statusi real i lëshimit
Pas kësaj, nga një ngjarje të radhës, sistemi ynë CI gjeneron një konfigurim të ri për Kubernetes, e dërgon për t'u aplikuar (apply) në klaster — me ndihmën e Helm ose kubectl apply. Ndërsa ndodh tashmë N-way merge i përshkruar, Kubernetes API përgjigjet miratueshëm sistemit CI, dhe ai — përdoruesit të tij.
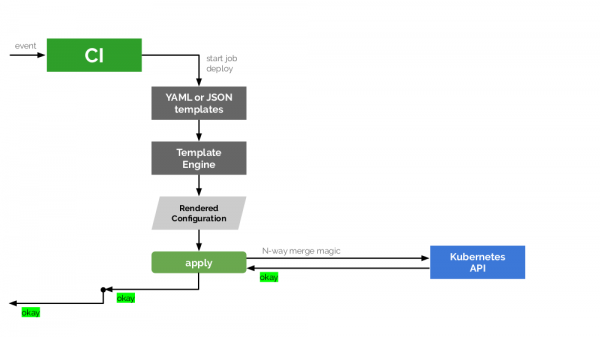
Megjithatë, ka një problem të madh: sepse aplikaimi i suksesshëm nuk do të thotë lëshim të suksesshëm. Nëse Kubernetes kupton se cilat ndryshime duhet të aplikohet, e aplikon atë — ne akoma nuk e dimë se çfarë do të marrë si rezultat. Për shembull, përditësimi dhe rinisja e pod’ëve në frontend mund të kalojë me sukses, ndërsa në backend jo, dhe do të marrim versione të ndryshme të imazheve të aplikacionit në funksion.
Për të bërë gjithçka siç duhet, ky skemë kërkon një element shtesë - një gjurmues të veçantë që do të marri informacione për statusin nga Kubernetes API dhe do t'i transmetojë ato për analizë të mëtejshme të situatës aktuale. Ne krijuam një bibliotekë Open Source në Go - (shih njoftimin e saj ), - e cila zgjidh këtë problem dhe është e integruar në werf.
Shtesat e këtij gjurmuesi për nivelin werf konfigurtohen me anë të annotimeve të vendosura në Deployments ose StatefulSets. Annotimi kryesor - fail-mode - kupton vlerat e mëposhtme:
-
IgnoreAndContinueDeployProcess- injorojmë problemet e shpërndarjes së këtij elementi dhe vazhdojmë me depon; -
FailWholeDeployProcessImmediately- një gabim në këtë element ndalon procesin e shpërndarjes; -
HopeUntilEndOfDeployProcess- shpresojmë se ky element do të funksionojë deri në fund të shpërndarjes.
Për shembull, një kombinim i tillë i burimeve dhe vlerave të annotimit fail-mode:
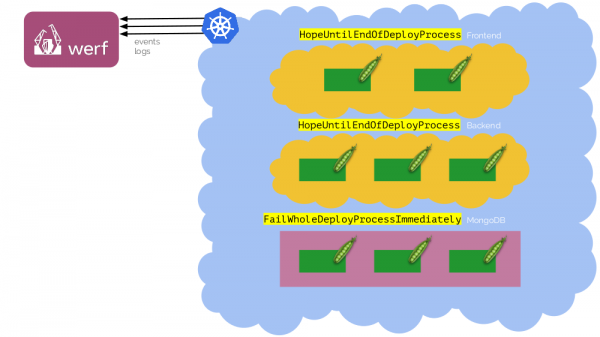
Kur e shpërndajmë për herë të parë, databaza (MongoDB) mund të mos jetë gati - Deployments do të bien. Por mund të presim momentin për ta nisur, dhe shpërndarja gjithsesi do të kalojnë.
Ekzistojnë gjithashtu dy annotime për kubedog në werf:
-
failures-allowed-per-replica- numri i dështimeve të lejuara për çdo replicë; -
show-logs-until- rregullon momentin deri në të cilin werf tregon (në stdout) log-et e të gjithë pod-eve që po shpërndahen. Si parazgjedhje ështëPodIsReady(për të injoruar mesazhet që ndoshta nuk na duhën, kur pod-i fillon të marrë trafikun), megjithatë, vlerat e lejuara janë gjithashtuControllerIsReadydheEndOfDeploy.
Çfarë tjetër duam nga shpërndarja?
Përveç dy pikave të përshkruara tashmë, ne dëshirojmë:
- të shohim log-et - për më tepër vetëm ato që na duhen, jo të gjitha pa ndonjë rend;
- të ndjekim progresin, sepse nëse një punë "nuk zëvendoset" për disa minuta, është e rëndësishme të kuptosh se çfarë po ndodh;
- të kemi rul muajor në rast se diçka shkoi keq (dhe për këtë është kritikisht e nevojshme të dinë statusin real të shpërndarjes). Shpërndarja duhet të jetë atomike: ose kalon deri në fund, ose gjithçka kthehet në gjendjen e mëparshme.
Përfundime
Ne si kompani për të realizuar të gjitha nuancat e përshkruara në faza të ndryshme të dorëzimit (ndërtimi, publikimi, shpërndarja) mjafton një sistem CI dhe një utilitar .
Përfundim:
Me ndihmën e werf, ne kemi avancuar mirë në zgjidhjen e një numri të madh problemesh për inxhinierët DevOps dhe do të ishim të lumtur nëse një komunitet më i gjerë do të provonte këtë utilitar në punë. Të arrijmë rezultate të mira bashkë do të jetë më e lehtë.
Videot dhe slidet
Video e prezantimit (~47 minuta):
Prezantimi i raportit:
P.S.
Raporte të tjera në lidhje me Kubernetes në blogun tonë:
- «» (Dmitri Stolyarov; 27 prill 2019 në «Stachka»);
- «» (Andrej Polovov; 8 prill 2019 në Saint HighLoad++);
- «» (Dmitri Stolyarov; 8 nëntor 2018 në HighLoad++);
- «» (Dmitry Stolyarov; 28 maj 2018 në RootConf);
- «» (Dmitry Stolyarov; 7 nëntor 2017 në HighLoad++);
- «» (Dmitry Stolyarov; 6 qershor 2017 në RootConf).
Burimi: habr.com
