

Përshendetje, Habr! Në këtë artikull dëshiroj të flas për një mjet të shkëlqyer për zhvillimin e proceseve batch të përpunimit të të dhënave, si në infrastrukturën e DWH të korporatave ashtu edhe në DataLake tuaj. Bëhet fjalë për Apache Airflow (më poshtë Airflow). Ai është padrejtësisht i injoruar në Habr, dhe në pjesën kryesore do të përpiqem t'ju bind për atë që të paktën duhet ta merrni parasysh Airflow si një planifikues për proceset tuaja ETL/ELT.
Më parë kam shkruar një seri artikujsh mbi temën DWH, kur punoja në Tinkoff Bank. Tani jam bërë pjesë e ekipit të Mail.Ru Group dhe merrem me zhvillimin e platformës për analizën e të dhënave në drejtimin e lojërave. Në thelb, me kalimin e kohës dhe zhvillimin e lajmeve dhe zgjidhjeve interesante, ekipi ynë do të flasë këtu për platformën tonë të analizës së të dhënave.
Prologu
Pra, le të fillojmë. Çfarë është Airflow? Ky është një bibliotekë (ose ) për zhvillimin, planifikimin dhe monitorimin e proceseve të punës. Karakteristika kryesore e Airflow: për përshkrimin (zhvillimin) e proceseve përdoret kodi në gjuhën Python. Kjo sjell një shumëllojshmëri përfitimesh për organizimin e projektit tuaj dhe zhvillimin: në thelb, projekti juaj ETL—është thjesht një projekt Python, dhe ju mund ta organizoni siç dëshironi, duke marrë parasysh veçoritë e infrastrukturës, madhësinë e ekipit dhe kërkesa të tjera. Mjetet janë shumë të thjeshta. Përdorni, për shembull, PyCharm + Git. Kjo është e shkëlqyer dhe shumë e përshtatshme!
Tani, le të shqyrtojmë entitetet kryesore të Airflow. Pasi të kuptoni thelbin dhe qëllimin e tyre, do ta organizoni në mënyrë të optimizuar arkitekturën e proceseve. Mbase entiteti kryesor është Directed Acyclic Graph (më poshtë DAG).
DAG
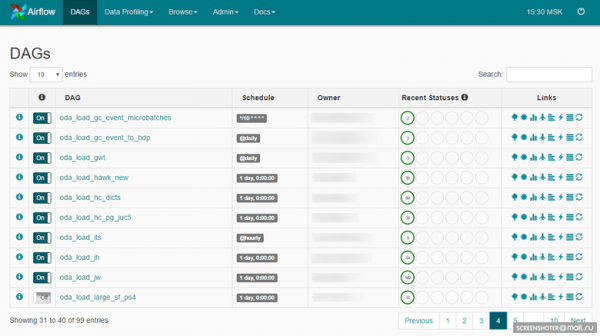
DAG është një bashkim kuptimor i detyrave tuaja, të cilat dëshironi t'i ekzekutoni në një rend të caktuar sipas një orari të caktuar. Airflow ofron një ndërfaqe web të përshtatshme për punën me DAG’ët dhe entitete të tjera:
DAG mund të duket kështu:
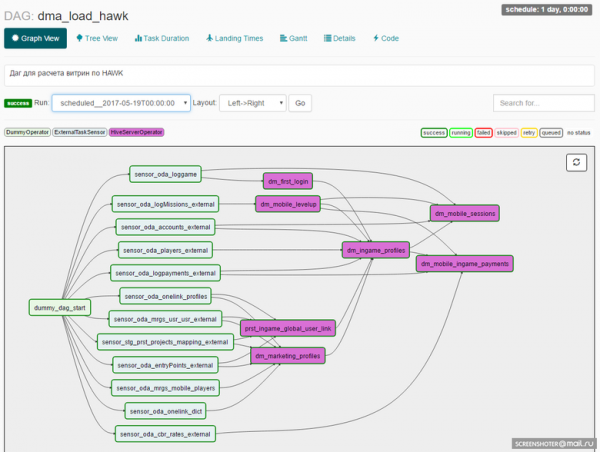
Zhvilluesi, duke projektuar DAG, vendos një grup operatorësh, mbi të cilat do të ndërtohen detyrat brenda DAG’it. Këtu arrijmë edhe në një entitet tjetër të rëndësishëm: Operatorin e Airflow.
Operatorët
Operatori është një entitet, mbi bazën e të cilit krijohen instancia të detyrave, që përshkruan se çfarë do të ndodhë gjatë ekzekutimit të instancës së detyrës. tashmë përmbajnë një grup operatorësh, të gatshëm për t'u përdorur. Shembuj:
- BashOperator — operator për ekzekutimin e komandave bash.
- PythonOperator — operator për thirrjen e kodit Python.
- EmailOperator — operator për dërgimin e email-eve.
- HTTPOperator — operator për punën me kërkesat http.
- SqlOperator — operator për ekzekutimin e kodit SQL.
- Sensor — operator që pret një ngjarje (siç është arritja e kohës së nevojshme, shfaqja e një skedari të kërkuar, një string në bazën e të dhënave, një përgjigje nga API - etj.).
Ka operatorë më specifikë: DockerOperator, HiveOperator, S3FileTransferOperator, PrestoToMysqlOperator, SlackOperator.
Ju gjithashtu mund të zhvilloni operatorë, duke u bazuar në veçoritë tuaja, dhe t'i përdorni ato në projekt. Për shembull, ne krijuam MongoDBToHiveViaHdfsTransfer, operatori për eksportimin e dokumenteve nga MongoDB në Hive, dhe disa operatorë për të punuar me : CHLoadFromHiveOperator dhe CHTableLoaderOperator. Në thelb, sa herë që në projekt lind një kod që përdoret shpesh, i ndërtuar mbi operatorët bazë, mund të mendoni të grumbulloni atë në një operator të ri. Kjo do ta thjeshtojë zhvillimin e mëtejshëm, dhe do t'i shtoni bibliotekës suaj të operatorëve në projekt.
Më pas, të gjithë këta instanca të tareas duhet të ekzekutohen, dhe tani është fjala për planifikuesin.
Dy ndryshime të dukshme në planifikim (të dyja në versionin alfa):
Planifikuesi i задач në Airflow është i ndërtuar mbi . Celery është një bibliotekë Python që lejon organizimin e një rruge plus ekzekutimin asinkron dhe të shpërndarë të detyrave. Nga ana e Airflow, të gjitha detyrat ndahen në pula. Pulat krijohen manualisht. Zakonisht, qëllimi i tyre është të kufizojnë ngarkesën e punës me burimin ose të tipizojnë detyrat brenda DWH. Pulat mund të menaxhohen përmes ndërfaqes në web:
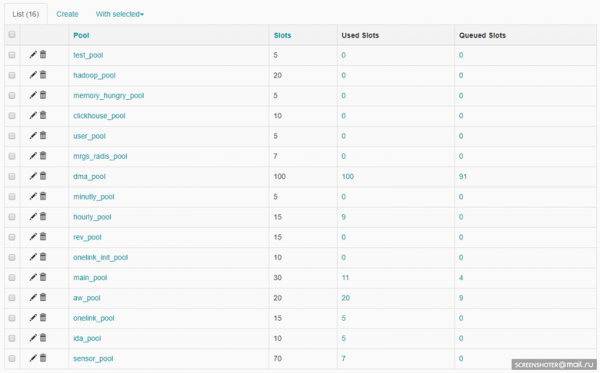
Çdo pul ka një kufizim në numrin e vendeve. Kur krijohet DAG, i caktohet një pul:
ALERT_MAILS = Variable.get("gv_mail_admin_dwh")
DAG_NAME = 'dma_load'
OWNER = 'Vasya Pupkin'
DEPENDS_ON_PAST = True
EMAIL_ON_FAILURE = True
EMAIL_ON_RETRY = True
RETRIES = int(Variable.get('gv_dag_retries'))
POOL = 'dma_pool'
PRIORITY_WEIGHT = 10

start_dt = datetime.today() - timedelta(1)
start_dt = datetime(start_dt.year, start_dt.month, start_dt.day)

default_args = {
    'owner': OWNER,
    'depends_on_past': DEPENDS_ON_PAST,
    'start_date': start_dt,
    'email': ALERT_MAILS,
    'email_on_failure': EMAIL_ON_FAILURE,
    'email_on_retry': EMAIL_ON_RETRY,
    'retries': RETRIES,
    'pool': POOL,
    'priority_weight': PRIORITY_WEIGHT
}
dag = DAG(DAG_NAME, default_args=default_args)
dag.doc_md = __doc__
Puli i caktuar në nivelin e DAG-së mund të anulohet në nivelin e detyrës.
Për planifikimin e të gjitha detyrave në Airflow është përgjegjës një proces i veçantë — Planifikuesi. Në thelb, Planifikuesi merret me të gjithë mekanikën e vendosjes së detyrave për ekzekutim. Një detyrë, përpara se të shkojë në ekzekutim, kalon disa etapa:
- Në DAG janë kryer detyrat e mëparshme, një e re mund të vendoset në radhë.
- Radhitja organizohet në bazë të prioritetit të detyrave (prioritetet gjithashtu mund të menaxhohen), dhe nëse ka një slot të lirë në pool, detyra mund të merret për punë.
- Nëse ka një worker celery të lirë, detyra dërgohet atje; fillon puna që keni programuar në detyrë, duke përdorur një operator të ndryshëm.
Mjafton.
Scheduler punon në shumicën e të gjitha DAG-eve dhe të gjitha detyrave brenda DAG-eve.
Për të filluar punën me DAG-un, DAG-u duhet të ketë një orar:
dag = DAG(DAG_NAME, default_args=default_args, schedule_interval='@hourly')Ka një grup presetësh të gatshëm: @once, @hourly, @daily, @weekly, @monthly, @yearly.
Gjithashtu mund të përdoren shprehjet cron:
dag = DAG(DAG_NAME, default_args=default_args, schedule_interval='*\/10 * * * *')Data e Ekzekutimit
Për të kuptuar se si funksionon Airflow, është e rëndësishme të kuptoni çfarë është Data e Ekzekutimit për DAG-un. Në Airflow, DAG ka një dimension të Datës së Ekzekutimit, pra, sipas orarit të punës së DAG-ut, krijohen instanca të detyrave për çdo Datë Ekzekutimi. Dhe për çdo Datë Ekzekutimi, detyrat mund të ekzekutohen përsëri - ose, për shembull, DAG mund të punojë njëkohësisht në disa Data Ekzekutimi. Kjo është e ilustruar qartë këtu:
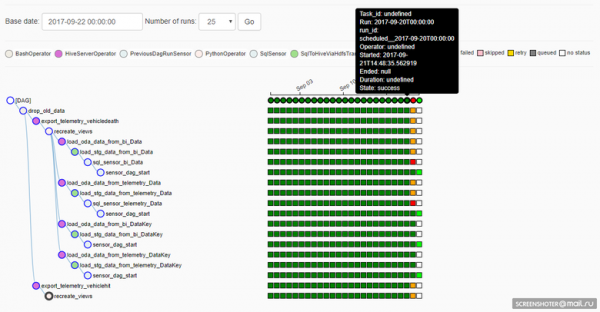
Për fat të keq (ndoshta edhe për fat të mirë: varet nga situata), nëse ndryshohet implementimi i detyrës në DAG, atëherë ekzekutimi në Data Ekzekutimi të mëparshme do të bëhet tashmë duke pasur parasysh korrigjimet. Kjo është mirë nëse është e nevojshme të ripërllogaritetin të dhënat në periudhat e kaluara me një algoritëm të ri, por është keq, sepse humbet riprodhueshmëria e rezultatit (sigurisht, askush nuk e ndalon të rikthejë versionin e nevojshëm nga Git dhe të llogarisë një herë atë që nevojitet, ashtu si duhet).
Generimi i detyrave
Implementimi i DAG-ut është kod në Python, prandaj kemi një mënyrë shumë të përshtatshme për të reduktuar volumin e kodit kur punojmë, për shembull, me burime të shard-uara. Le të themi se keni si burim tri sharda MySQL, duhet të shkoni në çdo një dhe të merrni disa të dhëna. Dhe kjo të bëhet pa varësi dhe paralelisht. Kodi në Python në DAG mund të duket kështu:
connection_list = lv.get('connection_list')

export_profiles_sql = '''
SELECT
  id,
  user_id,
  nickname,
  gender,
  {{params.shard_id}} as shard_id
FROM profiles
'''

for conn_id in connection_list:
    export_profiles = SqlToHiveViaHdfsTransfer(
        task_id='export_profiles_from_' + conn_id,
        sql=export_profiles_sql,
        hive_table='stg.profiles',
        overwrite=False,
        tmpdir='\/data\/tmp',
        conn_id=conn_id,
        params={'shard_id': conn_id[-1:], },
        compress=None,
        dag=dag
    )
    export_profiles.set_upstream(exec_truncate_stg)
    export_profiles.set_downstream(load_profiles)
DAG rezulton i tillë:
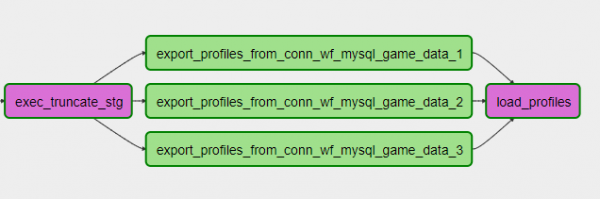
Në të njëjtën kohë, mund të shtoni ose hiqni një shard, duke korrigjuar thjesht konfigurimin dhe duke përditësuar DAG-un. Shumë e përshtatshme!
Mund të përdorni gjithashtu një gjenerim më të komplikuar të kodit, për shembull, të punoni me burime si Baza të Dhënash ose të përshkruani strukturën e tabelave, algoritmin e funksionimit me tabelat dhe, duke marrë parasysh veçoritë e infrastrukturës DWH, të gjeneroni procesin e ngarkesës së N tabelave në ruajtjen tuaj. Ose, për shembull, të punoni me një API që nuk mbështet përdorimin e parametrave në formë liste, mund të gjeneroni N detyra në DAG nga kjo listë, të kufizoni paralelizmin e kërkesave në API me një pool dhe të nxirrni të dhënat e nevojshme nga API. Shumë fleksibël!
Repo
Në Airflow ka repo backend të vet, Baza e Dhënash (mund të jetë MySQL ose Postgres, ne kemi Postgres), ku ruhen gjendjet e detyrave, DAG-eve, konfigurimet e lidhjes, variablat globale dhe të tjera. Këtu do të doja të them se repozitori në Airflow është shumë i thjeshtë (rreth 20 tabela) dhe i përshtatshëm, nëse dëshironi të ndërtoni ndonjë proces tuajin mbi të. Më kujtohet 100500 tabela në repo Informatica, të cilat duhej të merren më kohë për t'u kuptuar se si të ndërtohej një kërkesë.
Monitorimi
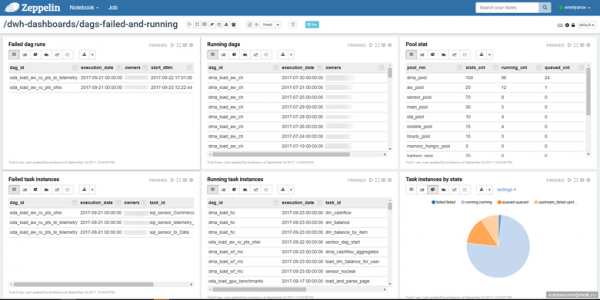
Duke marrë parasysh thjeshtësinë e repo-it, mund të ndërtoni vetë një proces të përshtatshëm për monitorimin e detyrave. Ne përdorim një shënim në Zeppelin, ku shohim gjendjen e detyrave:
Kjo mund të jetë gjithashtu një ndërfaqe web e vetë Airflow-it:
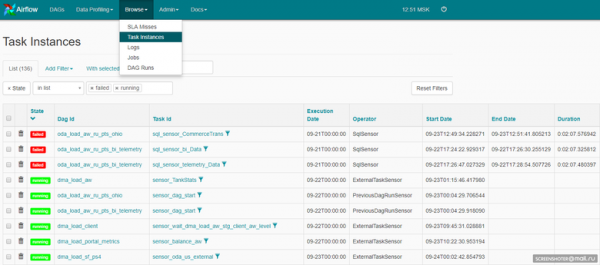
Kodi i Airflow është i hapur, prandaj ne kemi shtuar alarmin në Telegram. Çdo instancë e detyrës që punon, nëse ndodh një gabim, spamon në grupin në Telegram, ku ndodhet e gjithë ekipi i zhvillimit dhe mbështetjes.
Marrim reagime të shpejta nëpërmjet Telegram-it (nëse është e nevojshme), përmes Zeppelin-it – një pamje të përgjithshme mbi detyrat në Airflow.
Përveç kësaj
Airflow në radhë të parë është open source, dhe nuk duhet të prisni mrekulli nga ai. Bëhuni të gatshëm të kaloni kohë dhe përpjekje për të ndërtuar një zgjidhje funksionale. Qëllimi është i arritshëm, besoni, ia vlen. Shpejtësia e zhvillimit, fleksibiliteti, thjeshtësia e shtimit të proceseve të reja – do t'ju pëlqejë. Sigurisht, duhet të kushtoni shumë vëmendje organizatës së projektit, stabilitetit të funksionimit të vetë Airflow-it: nuk ka mrekulli.
Tani kemi Airflow që punon çdo ditë rreth 6,5 mijë detyra. Karakteri i tyre është mjaft i ndryshëm. Ka detyra për ngarkimin e të dhënave në DWH-in kryesor nga shumë burime të ndryshme dhe shumë specifike, ka detyra për llogaritjen e tregtarëve brenda DWH-it kryesor, ka detyra për publikimin e të dhënave në një DWH të shpejtë, ka shumë shumë detyra të ndryshme — dhe Airflow i përpunon ato çdo ditë. Nëse flasim me shifra, atëherë kjo është 2.3 mijë detyra ELT të ndryshme në DWH (Hadoop), rreth 250 bazash të dhënash burimesh, kjo është një ekip prej 4 ETL zhvilluesish, të cilët ndahen në procesimin ETL të të dhënave në DWH dhe në procesimin ELT të të dhënave brenda DWH dhe natyrisht edhe një administrator, i cili merret me infrastrukturën e shërbimit.
Planet për të ardhmen
Numri i proceseve po rritet dhe e vetmja gjë me të cilën do merren në aspektin e infrastrukturës Airflow, është shkallëzimi. Ne duam të ndërtrojmë një klaster Airflow, të ndajmë disa resurse për punëtorët Celery dhe të krijojmë një kokë të dyfishtë me proceset e planifikimit të detyrave dhe depozitën.
Epilogu
Kjo, sigurisht, nuk është gjithçka për të folur për Airflow, por përpjekjet kryesore i kam paraqitur. Atdheu vjen gjatë ngrënies, provoje — dhe do të të pëlqejë 🙂
Burimi: habr.com
