

Sistemat një informacioni moderne janë mjaft të ndërlikuara. Jo në mënyrë të vogël, kompleksiteti i tyre i atribuohet kompleksitetit të të dhënave që përpunohen prej tyre. Ndërsa, kompleksiteti i të dhënave shpesh qëndron në shumëllojshmërinë e modeleve të dhënash që përdoren. Për shembull, kur të dhënat bëhen "të mëdha", një nga karakteristikat që ndikon është jo vetëm vëllimi i tyre ("volume"), por gjithashtu shumëllojshmëria e tyre ("variety").
Nëse ende nuk keni gjetur ndonjë dobësi në arsyetimet, vazhdoni të lexoni.
Përmbajtja
Ruajtja polyglot
Ajo që u tha më sipër çon në faktin se ndonjëherë, brenda të njëjtës sistem, është e nevojshme të përdoren disa sisteme të menaxhimit të të dhënave të ndryshme për të ruajtur të dhënat dhe për të zgjidhur detyrat e tyre përpunuese, secila prej të cilave mbështet modelin e saj të të dhënave. Me ndihmën e M. Fowler, një sërë librash të njohur dhe njëri nga Agile Manifesto, kjo situatë mori emrin ruajtja shumëdimensionale ("polyglot persistence").
Fowler gjithashtu ka dhënë një shembull të organizimit të ruajtjes së të dhënave në një aplikacion të plotëfunksional dhe me ngarkesë të lartë në fushën e tregtisë elektronike.
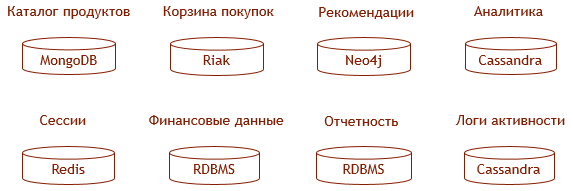
Ky shembull, sigurisht, është ndoshta paksa i tepruar, por disa konsiderata për zgjedhjen e një sistemi të menaxhimit të të dhënave të caktuar për një qëllim të caktuar mund të gjenden, për shembull, .
E qartë është se të jesh shërbëtori në një qoshe të tillë nuk është e lehtë.
- Vëllimi i kodit që kryen ruajtjen e të dhënave rritet proporcionalisht me numrin e sistemeve të menaxhimit të të dhënave të përdorura; vëllimi i kodit që sinkronizon të dhënat - mirë është nëse nuk është proporcional katrorit të këtij numri.
- Shpenzimet për të garantuar karakteristikat e nivelit enterprise (skalabilitet, qëndrueshmëri, disponueshmëri e lartë) të secilit nga sistemet e menaxhimit të të dhënave të përdorura rriten shumëfish me numrin e sistemeve të menaxhimit të të dhënave të përdorura.
- Nuk është e mundur të sigurohet karakteristikat e nivelit enterprise të nën-sistemit të ruajtjes në tërësi - veçanërisht transaksionaliteti.
Nga këndvështrimi i drejtorit të kopshtit, gjithçka duket kështu:
- Rritje e madhe e kostove të licencave dhe mbështetjes teknike nga prodhuesi i sistemit të menaxhimit të të dhënave.
- Shpërndarja e stafit dhe rritja e afateve.
- Humbe financiare direkte ose sanksione për shkak të paqartësive të të dhënave.
Ka një rritje të konsiderueshme të kostos totale të pronësisë (TCO) të sistemit. A ka ndonjë dalje nga situata e "ruajtjes multi-opcionale"?
Multimodel
Termi "ruajtja multi-opcionale" hyri në përdorim në vitin 2011. Kuptimi i problemeve të këtij qasje dhe kërkimi i zgjidhjes zgjatën disa vite, dhe deri në vitin 2015 analistët e Gartner e formuluan përgjigjen:
- Nga "»:
Të ardhmen e DBMS-ve, arkitekturave të tyre dhe mënyrave të përdorimit - multimodelimi.
- Nga "»:
DBMS-të kryesore operacionale do të ofrojnë disa modele - relacional dhe jo-relacional - të përfshira në një platformë të vetme.
Duket se këtë herë analistët e Gartner nuk gabuan në parashikimin. Nëse shkon në faqen me të DBMS-ve në DB-Engines, mund të shohish se shumica e liderëve e pozicionojnë veten pikërisht si DBMS me multimodelim. Të njëjtën gjë e sheh edhe në faqen me çdo renditje private.oNë tabelën më poshtë, janë listuar DBMS-të - liderët në çdo renditje private - që deklarojnë multimodelimin e tyre. Për çdo DBMS, është treguar modeli fillestar i mbështetur (i cili dikur ishte i vetmi) dhe përveç tij modelet që mbështeten tani. Gjithashtu janë përfshirë DBMS-të që pozicionojnë veten si "fillimisht multimodel" dhe nuk kanë, sipas pretendimeve të krijuesve, ndonjë model fillestar të trashëguar.
Modeli fillestar
| DBMS | Modelet shtesë | Relacional |
|---|---|---|
| Oracle | Grafik, dokumentar | MS SQL |
| Grafik*, dokumentar | Grafik, dokumentar | MS SQL |
| PostgreSQL | Grafik, dokumentar | MarkLogic |
| Dokumentar | Grafik, relacional | Çelës-vlerë, grafik* |
| MongoDB | Grafik, relacional | DataStax |
| Kolona të gjera | Dokumentar, grafik | Çelës-vlerë |
| Redis | Dokumentar, grafik* | Grafik, dokumentar, relacional |
| ArangoDB | — | MS SQL |
| OrientDB | — | Shënime për tabelën |
| Azure CosmosDB | — | Shënime për tabelën |
Yjet në tabelë shënojnë pohimet që kërkojnë sqarime:
DBMS PostgreSQL nuk mbështet modelin grafik të të dhënave, megjithatë ky produkt
- në bazë të saj Sa i përket MongoDB, është më e saktë të flasim për praninë e operatorëve grafikë në gjuhën e pyetjeve (
- $lookup, ), lidhur me mbështetje për modelin grafik, megjithatë, sigurisht, futja e tyre kërkoi disa optimizime në nivelin fizik të ruajtjes me qëllim mbështetje për modelin grafik.
- Kur Redis kuptohet si zgjerim .
Më pas për çdo klasë ne do të tregojmë se si implementohet mbështetje për disa modele në DBMS nga kjo klasë. Modelet më të rëndësishme do të konsiderohen ato relacionale, dokumentare dhe grafike, dhe do të ilustrohen me shembuj nga DBMS specifike për të treguar se si implementohen "modelet e mungesës".
Sistemat e menaxhimit të të dhënave multimodel në bazë të modelit relacion
DBMS kryesore aktualisht janë ato relacionale; parashikimi i Gartner nuk do të konsiderohej i realizuar nëse DBMS relacionale nuk do të tregonin lëvizje drejt multimodelit. Dhe ata po tregojnë. Tani konsideratat se një DBMS multimodel është si një thikë zvicerane, me të cilën nuk mund të bësh asgjë mirë, mund t'i drejtohen menjëherë Larry Ellison-it.
Autori, megjithatë, e preferon më shumë implementimin e multimodelit në Microsoft SQL Server, përmes shembullit të të cilit do të përshkruhet mbështetja për modelet dokumentare dhe grafike në DBMS relacionale.
Modeli dokumentar në MS SQL Server
Për mënyrën se si në MS SQL Server është implementuar mbështetje për modelin dokumentar, në Habrë janë publikuar dy artikuj të shkëlqyer, do të përmbahëm me një përmbledhje të shkurtër dhe një koment:
Mënyra e mbështetjes së modelit dokumentar në MS SQL Server është mjaft tipike për DBMS relacionale: dokumentet JSON propozohet të ruhen në fusha tekstuale të zakonshme. Mbështetja për modelin dokumentar përfshin ofrimin e operatorëve special për analizimin e këtij JSON:
- për nxjerrjen e vlerave skalarë të atributeve,
- për nxjerrjen e nën-dokumenteve.
Argumenti i dytë i të dy operatorëve është një shprehje në sintaksë të ngjashme me JSONPath.
Në mënyrë abstrakte, mund të thuhet se dokumentet e ruajtur në këtë mënyrë nuk janë "entitete të klasës së parë" në DBMS relacionale, në krahasim me tuple-t. Konkretisht në MS SQL Server aktualisht mungojnë indekset mbi fushat e dokumenteve JSON, gjë që e bën të vështirë operacionet e bashkimit të tabelave sipas vlerave të këtyre fushave dhe madje nxjerrjen e dokumenteve sipas këtyre vlerave. Megjithatë, është e mundur të krijohet një kolonë e llogaritur mbi një fushë të tillë dhe të krijohet një indeks mbi të.
Përveç kësaj, MS SQL Server ofron mundësinë për të ndërtuar lehtësisht një dokument JSON nga përmbajtja e tabelave me ndihmën e operatorit — mundësi, në një sens të njohur, e kundërt me ruajtjen e zakonshme. Është e qartë se sa do të shpejtë të jetë një RDBMS, ky qasje bie ndesh me ideologjinë e DBMS-ve dokumentarë, në thelb duke ruajtur përgjigje të gatshme për kërkesat populare, dhe mund të zgjidhë vetëm problemet e komfortit të zhvillimit, por jo të shpejtësisë.
Në fund, MS SQL Server lejon të zgjidhet problemi, i kundërt me ndërtimin e dokumenteve: mund të shpërndash JSON në tabela duke përdorur . Nëse dokumenti nuk është krejtësisht i sheshtë, do të nevojitet të përdorësh MIRATIM.
Modeli grafik në MS SQL Server
Përkrahja e modelit grafik (LPG) është implementuar në Microsoft SQL Server gjithashtu në mënyrë të qartë : propozohet të përdoren tabela speciale për ruajtjen e nyjave dhe për ruajtjen e skajeve të grafikut. Të tilla tabela krijohen duke përdorur shprehjet CREATE TABLE AS NODE dhe CREATE TABLE AS EDGE përkatësisht.
Tabela e llojit të parë janë të ngjashme me tabelat normale për ruajtjen e regjistrimeve me atë vetëm dallim ekstern, që në tabelë ka fushën sistemike $node_id — identifikues unik brenda bazës së të dhënave për nyjën e grafikut.
Në mënyrë të ngjashme, tabelat e llojit të dytë kanë fusha sistemike $from_id dhe $to_id, regjistrimet në këto tabela në mënyrë të qartë përcaktojnë lidhjet midis nyjave. Për ruajtjen e lidhjeve të secilit lloj përdoret një tabelë e veçantë.
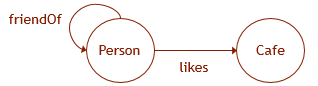 Le të ilustrojmë atë që u tha me një shembull. Le të themi se të dhënat grafike kanë skemën si në figurën e dhënë. Atëherë për të krijuar strukturën përkatëse në bazën e të dhënave nevojitet të kryhen kërkesat DDL si vijon:
CREATE TABLE Person (
  ID INTEGER NOT NULL,
  name VARCHAR(100)
) AS NODE;

CREATE TABLE Cafe (
  ID INTEGER NOT NULL,
  name VARCHAR(100),
) AS NODE;

CREATE TABLE likes (
  rating INTEGER
) AS EDGE;

CREATE TABLE friendOf
  AS EDGE;

ALTER TABLE likes
  ADD CONSTRAINT EC_LIKES CONNECTION (Person TO Cafe);
Specifika kryesore e këtyre tabelave është se në kërkesat ndaj tyre është e mundur të përdoren modele grafike me sintaksë të ngjashme me Cypher (ndonëse, "*" etj. ende nuk mbështeten). Bazuar në matjet e performancës, mund të supozohet gjithashtu se mënyra e ruajtjes së të dhënave në këto tabela është ndryshe nga mekanizmi i ruajtjes së të dhënave në tabelat normale dhe optimizuar për kryerjen e kërkesave të tilla grafike.
SELECT Cafe.name
  FROM Person, likes, Cafe
  WHERE MATCH (Person-(friendOf)-(likes)->Cafe)
  AND Person.name = 'John';
Për më tepër, është mjaft e vështirë të mos përdoren këto modele grafike kur punoni me tabela të tilla, pasi në kërkesat e zakonshme SQL për të zgjidhur detyra të ngjashme do të nevojiten përpjekje të shtuara për të marrë identifikuesit sistemikë të "grafik" të nyjave ($node_id, $from_id, $to_id; për këtë arsye, kërkesat për futjen e të dhënave nuk janë përfshirë këtu si tepër të ngarkuara).
Duke përmbledhur përshkrimin e zbatimeve të modeleve dokumentare dhe grafike në MS SQL Server, do të theksoja se zbatimi i tillë i një modeli mbi një tjetër nuk duket i suksesshëm kryesisht nga pikëpamja e dizajnit gjuhësor. Një gjuhë duhet të zgjerojë një tjetër, gjuhët nuk janë krejtësisht "ortogonale", rregullat e kombinoshmërisë mund të jenë mjaft të çuditshme.
Sistemat e menaxhimit të të dhënave multimodel në bazë të modelit dokumentar
Në këtë seksion do të dëshiroja të ilustroja realizimin e multimodelitetit në DBMS dokumentar duke marrë si shembull një nga DBMS më të njohura, MongoDB (siç u tha, ajo ka vetëm operatorë grafike të kushtezuar, $graphLookup dhe ), se sa për mbështetje të modelit grafik, megjithatë, sigurisht, futja e tyre kërkonte disa optimizime në nivelin e ruajtjes fizike në drejtimin e mbështetjes së modelit grafik.të cilët nuk punojnë në koleksione të ndara), përmes një DBMS më të pjekur dhe "enterpriz“ .
Prandaj, le të supozojmë se koleksioni përmban një grup dokumentesh XML të këtij lloji (MarkLogic gjithashtu lejon ruajtjen e dokumenteve JSON):
John
  Smith
Modeli relacion në MarkLogic
Prezantimi relacional i koleksionit të dokumenteve mund të krijohet me anë të (përmbajtja e elementeve vlera në shembullin më poshtë mund të jetë një XPath i çfarëdo lloji):
/Person


      Person


          SSN
          @SSN
          string


          name
          name


          surname
          surname
Kërkesa SQL mund të drejtohet në pamjen e krijuar (për shembull, përmes ODBC):
SELECT name, surname FROM Person WHERE name="John"Fatkeqësisht, pamja relacional e krijuar me anë të shembujve të mënyrës është vetëm për lexim. Kur për të trajtuar një kërkesë ndaj saj, MarkLogic do të përpiqet të përdorë Më parë, MarkLogic kishte edhe pamje relacionale të kufizuara, krejtësisht dhe të aksesueshme për shkrim, por tani ato konsiderohen të përdorura.
Modeli grafik në MarkLogic
Me mbështetje të modelit grafor (RDF), gjithçka është në mënyrë të ngjashme. Sërish me ndihmën e mund të krijoni një përfaqësim RDF të koleksionit të dokumenteve nga shembulli më sipër:
/Person
PREFIX
"http://example.org/example#"
sem:iri( $PREFIX || @SSN )
sem:iri( $PREFIX || surname )
sem:iri( $PREFIX || @SSN )
sem:iri( $PREFIX || name )
Në grafikun RDF të marrë, mund të adresoni një kërkesë SPARQL:
PREFIX :
SELECT ?name ?surname {
  :631803299804 :name ?name ; :surname ?surname .
}
Në krahasim me modelin relacional, modelin grafor MarkLogic e mbështet edhe në dy mënyra të tjera:
- DBMS mund të jetë një depo e plotë e dhënash RDF (tripletët do të quhen në krahasim me ato të përshkruara më sipër ).
- RDF në një serializim të veçantë mund të futur thjesht në dokumente XML ose JSON (dhe tripletët do të quhen ). Ndërkaq, kjo është një alternativë ndaj mekanizmave
idrefLidhja e këtyre instancave të predicate-ve me predicate-n e përgjithshëm vendoset me tripleta të tipit
Një përfaqësim i mirë se si "e vërteta" funksionon në MarkLogic jep , në këtë sens është me nivel të ulët, megjithëse qëllimi i tij është pikërisht i kundërt — të provojë të abstenojë nga modeli i dhënash të përdorur, të sigurojë një funksionim të qëndrueshëm me të dhënat në modele të ndryshme, transaksionalitetin etj.
Sistemat e menaxhimit të të dhënave multimodel "pa model të bazës"
Në treg janë gjithashtu DBMS që pozicionohen si fillimisht multimodale, pa ndonjë model të trashëguar. Një numër i tillë përfshin , (që nga 2018, kompania zhvillues është në pronësi të SAP) dhe (shërbimi si pjesë e platformës së re cloud të Microsoft Azure).
Në të vërtetë "modelet kryesore" në ArangoDB dhe OrientDB ekzistojnë. Kjo është njësoj për të dy rastet, modelet e dhënash janë të tipit të tyre, duke u bërë përmbledhje të modelit dokumentar. Përmbledhjet përfshijnë kryesisht lehtësimin e mundësive për të kryer kërkesa me natyrë grafike dhe relacional.
Këto modele janë të vetmet të disponueshme për përdorim në SGBD-të e përmendura, për të punuar me to janë të dedikuar gjuhët e tyre të kërkimit. Pa dyshim, këto modele dhe SGBD-të janë të perspektivë, megjithatë mungesa e përputhshmërisë me modelet dhe gjuhët standarde e bën të pamundur përdorimin e këtyre SGBD-ve në sistemet e trashëguara - zëvendësimin e SGBD-ve që janë tashmë të përdorura atje.
Për ArangoDB dhe OrientDB në Habr kishte një artikull të mrekullueshëm: .
ArangoDB
ArangoDB shpall mbështetje për modelin e të dhënave grafike.
Nodet e grafit në ArangoDB janë dokumente të zakonshme, ndërsa skajet janë dokumente të natyrës speciale, që kanë përveç fushave të zakonshme sistemore (_key, _id, _rev) fusha sistemore _from dhe _to. Dokumentet në SGBD-të dokumentare tradicionalisht grumbullohen në koleksione. Koleksionet e dokumenteve që përfaqësojnë skajet në ArangoDB quhen koleksione edge. Për ta thënë ndryshe, dokumentet e koleksioneve edge janë gjithashtu dokumente, kështu që skajet në ArangoDB mund të shërbejnë gjithashtu si nodet.
Të dhënat burimore
Le të kemi një koleksion persons, dokumentet e të cilit duken kështu:
[
  {
    "_id"  : "people\/alice" ,
    "_key" : "alice" ,
    "name" : "Alicia"
  },
  {
    "_id"  : "people\/bob" ,
    "_key" : "bob" ,
    "name" : "Bob"
  }
]
Le të ketë gjithashtu një koleksion cafes:
[
  {
    "_id" : "cafes\/jd" ,
    "_key" : "jd" ,
    "name" : "John Donne"
  },
  {
    "_id" : "cafes\/jj" ,
    "_key" : "jj" ,
    "name" : "Jean-Jacques"
  }
]
Atëherë koleksioni likes mund të duket si më poshtë:
[
  {
    "_id" : "likes\/1" ,
    "_key" : "1" ,
    "_from" : "persons\/alice" ,
    "_to" : "cafes\/jd",
    "since" : 2010
  },
  {
    "_id" : "likes\/2" ,
    "_key" : "2" ,
    "_from" : "persons\/alice" ,
    "_to" : "cafes\/jj",
    "since" : 2011
  } ,
  {
    "_id" : "likes\/3" ,
    "_key" : "3" ,
    "_from" : "persons\/bob" ,
    "_to" : "cafes\/jd",
    "since" : 2012
  }
]
Kërkesat dhe rezultatet
Një kërkesë në stilin grafik në gjuhën e përdorur në ArangoDB, që kthehet në një format të lexueshëm për njerëzit rreth atyre kujt i pëlqen cila kafe, duket kështu:
FOR p IN persons
  FOR c IN OUTBOUND p likes
  RETURN { person : p.name , likes : c.name }
Në stilin relacionale, kur ne thjesht "llogarisim" lidhjet, përndryshe i ruajmë ato, kjo kërkesë mund të ri-shkruhet kështu (përfshirë, pa koleksionin likes mund të binim dakord):
FOR p IN persons
  FOR l IN likes
  FILTER p._key == l._from
    FOR c IN cafes
    FILTER l._to == c._key
    RETURN { person : p.name , likes : c.name }
Rezultati në të dy rastet do të jetë i njëjtë:
[
  { "person" : "Alicia" , likes : "Jean-Jacques" } ,
  { "person" : "Alicia" , likes : "John Donne" } ,
  { "person" : "Bob" , likes : "John Donne" }
]
Kërkesa të tjera dhe rezultate
Nëse duket se formati i rezultatit më sipër është më karakteristik për një DBMS relacional sesa për një dokument, mund të provoni këtë kërkesë (ose mund të përdorni ):
PËR p NË persona
  KTHIM {
    person : p.emri,
    pëlqime : (
      PËR c NË DALJ p pëlqime
      KTHIM c.emri
    )
}
Rezultati do të ketë këtë pamje:
[
  { "person" : "Alicia" , pëlqime : ["Jean-Jacques" , "John Donne"]  } ,
  { "person" : "Bob" , pëlqime : ["John Donne"] }
]
OrientDB
Në themel të implementimit të modelit grafik mbi dokumentar në OrientDB qëndron fushat e dokumenteve të kenë përveç vlerave më të zakonshme skalar më shumë edhe vlera të tilla si LINK, LISTA LINK, GRUPE LINK, MAP LINK dhe ÇANTË LINK. Vlerat e këtyre tipeve janë lidhje ose koleksione lidhjesh për dokumenteve.
Identifikuesi i caktuar nga sistemi për dokumentin ka "kuptim fizik", duke treguar pozitën e regjistrimit në bazë, dhe duket përafërsisht kështu: @rid : #3:16. Kështu, vlerat e vetive lidhëse janë në të vërtetë më shumë tregues (si në modelin grafik), sesa kushte për filtrin (si në relacional).
Si në ArangoDB, në OrientDB, skellet paraqiten si dokumente të veçanta (ndonëse nëse skela nuk ka vetitë e saj, mund ta bëni , dhe nuk do t'i përkasë një dokumenti të veçantë).
Të dhënat burimore
Në një format që iu afron të bazës OrientDB, të dhënat nga shembulli i mëparshëm për ArangoDB do të duken përafërsisht kështu:
[
     {
      "@tip": "dokument",
      "@rid": "#11:0",
      "@klasa": "Person",
      "emri": "Alicia",
      "dalje_pëlqime": [
        "#30:1",
        "#30:2"
      ],
      "@tipet_e_fushës": "dalje_pëlqime=ÇANTË LINK"
    },
    {
      "@tip": "dokument",
      "@rid": "#12:0",
      "@klasa": "Person",
      "emri": "Bob",
      "dalje_pëlqime": [
        "#30:3"
      ],
      "@tipet_e_fushës": "dalje_pëlqime=ÇANTË LINK"
    },
    {
      "@tip": "dokument",
      "@rid": "#21:0",
      "@klasa": "Cafe",
      "emri": "Jean-Jacques",
      "në_pëlqime": [
        "#30:2",
        "#30:3"
      ],
      "@tipet_e_fushës": "në_pëlqime=ÇANTË LINK"
    },
    {
      "@tip": "dokument",
      "@rid": "#22:0",
      "@klasa": "Cafe",
      "emri": "John Donne",
      "në_pëlqime": [
        "#30:1"
      ],
      "@tipet_e_fushës": "në_pëlqime=ÇANTË LINK"
    },
    {
      "@tip": "dokument",
      "@rid": "#30:1",
      "@klasa": "pëlqime",
      "në": "#22:0",
      "dalje": "#11:0",
      "që nga": 1262286000000,
      "@tipet_e_fushës": "në=LINK,dashuri=LINK,që nga=data"
    },
    {
      "@tip": "dokument",
      "@rid": "#30:2",
      "@klasa": "pëlqime",
      "në": "#21:0",
      "dalje": "#11:0",
      "që nga": 1293822000000,
      "@tipet_e_fushës": "në=LINK,dashuri=LINK,që nga=data"
    },
    {
      "@tip": "dokument",
      "@rid": "#30:3",
      "@klasa": "pëlqime",
      "në": "#21:0",
      "dalje": "#12:0",
      "që nga": 1325354400000,
      "@tipet_e_fushës": "në=LINK,dashuri=LINK,që nga=data"
    }
  ]
Siç e shohim, kulmet ruajnë gjithashtu informacione mbi skellet e hyra dhe të dalë. Në API i Dokumenteve për ruajtjen e integritetit referencial kërkon monitorim të vet, ndërsa Graph API e merr këtë punë mbi vete. Le të shohim se si duken thirrjet në OrientDB në gjuhët e pyetjeve "të pastra", të paintegruara në gjuhët e programimit.
Kërkesat dhe rezultatet
Një pyetje, e ngjashme me qëllimin e pyetjes nga shembulli për ArangoDB, në OrientDB duket kështu:
SELECT name AS person_name, OUT('likes').name AS cafe_name
   FROM Person
   UNWIND cafe_name
Rezultati do të merret në të njëjtën formë:
[
  { "person_name": "Alisa", "cafe_name": "John Donne" },
  { "person_name": "Alisa", "cafe_name": "Jean-Jacques" },
  { "person_name": "Bob",  "cafe_name": "Jean-Jacques" }
]
Nëse formati i rezultatit përsëri duket tepër "relacionar", është e nevojshme të hiqni rreshtin me :
[
  { "person_name": "Alisa", "cafe_name": [ "John Donne", "Jean-Jacques" ] },
  { "person_name": "Bob",  "cafe_name": [ "Jean-Jacques" ] }
]
Gjuha e pyetjeve të OrientDB mund të përshkruhet si SQL me implikime të ngjashme me Gremlin. Në versionin 2.2 u shfaq një formë pyetjeje e ngjashme me Cypher, :
MATCH {CLASS: Person, AS: person}-likes->{CLASS: Cafe, AS: cafe}
RETURN person.name AS person_name, LIST(cafe.name) AS cafe_name
GROUP BY person_name
Formati i rezultatit do të jetë i njëjtë si në pyetjen e mëparshme. Mendoni se çfarë duhet hequr për ta bërë atë më "relacionar", si në pyetjen e parë.
Azure CosmosDB
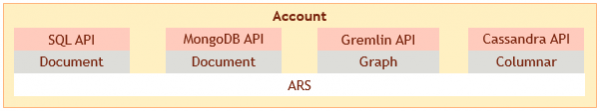
Më pak sa i përket ArangoDB dhe OrientDB, kjo përfshin Azure CosmosDB. CosmosDB ofron API të ndryshëm për qasjen në të dhëna: SQL, MongoDB, Gremlin dhe Cassandra.
API SQL dhe API MongoDB përdoren për qasjen në të dhëna në modelin e dokumenteve. API Gremlin dhe API Cassandra — për qasjen në të dhëna përkatësisht në modelin grafik dhe kolonat. Të dhënat në të gjitha modelet ruhen në formatin e modelit të brendshëm të CosmosDB: ("atom-record-sequence"), i cili gjithashtu është afër dokumenteve.
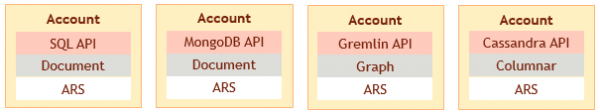
Por modeli i të dhënave të zgjedhur nga përdoruesi dhe API e përdorur fiksohen në momentin e krijimit të llogarisë në shërbim. Nuk është e mundur të aksesoni të dhënat e ngarkuara në një model, në formatin e një modeli tjetër, që do të ilustrohej më pak më këtë figurë:
Kështu, multimodeliteti në Azure CosmosDB deri më sot paraqet vetëm mundësinë për të përdorur disa baza të dhënash që mbështesin modele të ndryshme nga një prodhues, që nuk e zgjidh të gjitha problemet e ruajtjes multivariant.
Sistemat e menaxhimit të të dhënave multimodel në bazë të modelit grafik?
Vlen të theksohet se në treg ende nuk ka DBMS multimodel që ka si bazë modelin grafik (përveç mbështetjes multimodel për njëkohësisht dy modele grafike: RDF dhe LPG; shih për këtë në ). Realizimi mbi një model grafik dokumentar dhe jo relacional paraqet pengesat më të mëdha.
Çështja se si të realizohet mbi një model grafik një relacional është shqyrtuar që nga kohët e formimit të këtij të fundit. Si , për shembull, :
Nuk ka asgjë të natyrshme në qasjen grafike që e pengon krijimin e një shtrese (p.sh., me indeksimin e duhur) mbi një bazë të dhënash grafike që lejon një pamje relacional me (1) shërimin e tupleve nga çiftet e zakonshëm të çelësit dhe (2) grupimin e tupleve sipas llojit të marrëdhënies.
Kur realizohet modeli dokumentar mbi grafik duhet të kihet parasysh, për shembull, e suivantes:
- Elementet e masës JSON konsiderohen të renditura, dalin nga maja e skelës grafike — jo;
- Të dhënat në modelin dokumentar zakonisht janë denormalizuar, nuk dëshirojmë të ruajmë disa kopje të një dokumenti të njëjtë të ndërlikuar, ndërsa identifikuesit e nën-dokumenteve zakonisht nuk ekzistojnë;
- Nga ana tjetër, ideologjia e DBMS-ve dokumentar është se dokumentet janë 'agregate' të gatshme që nuk kanë nevojë të ndërtohen rishtazi çdo herë. Duhet të sigurohet në modelin grafik mundësia për të marrë shpejt një nëngraf që i përgjigjet dokumentit të gatshëm.
Pak reklame
Autori i artikullit ka lidhje me zhvillimin e DBMS-së NitrosBase, modeli i brendshëm i së cilës është grafik, ndërsa modelet e jashtme — relacional dhe dokumentar — janë përfaqësimet e saj. Të gjitha modelet janë të barabarta: pothuajse çdo të dhënë është e aksesueshme në secilën prej tyre duke përdorur gjuhën e saj natyrore të kërkimeve. Për më tepër, në çdo përfaqësim të dhënat mund të ndryshohen. Ndryshimet do të reflektohen në modelin e brendshëm dhe, përkatësisht, në përfaqësimet e tjera.
Si duket përputhja e modeleve në NitrosBase — shpresoj ta përshkruaj në një nga artikujt e ardhshëm.
Përfundim
Shpresoj që konturat e përgjithshme të asaj që quhet multimodeli, t’i jenë bërë lexuesit më shumë ose më pak të qarta. DBMS-të multimodel janë mjaft të ndryshme, dhe 'mbështetja e disa modeleve' mund të duket ndryshe. Për të kuptuar atë që quhet 'multimodeli' në çdo rast konkret, është e dobishme të përgjigjet në pyetjet e mëposhtme:
- A bëhet fjalë për mbështetje të modeleve tradicionale apo për një 'model hibrid'?
- A janë modelet 'të barabarta', apo njëra prej tyre është nënorin për të tjerat?
- A janë modelet indiferente ndaj njëra-tjetrës? A mund të lexohen të dhënat e shkruara në një model në një tjetër ose madje të përsëriten?
Mendoj se tani mund të japim një përgjigje pozitive për pyetjen mbi rëndësinë e DBMS-ve multimonedha, por është interesante të dimë se cilat lloje të tyre do të jenë më të kërkuara në të ardhmen e afërt. Duke dukur se DBMS-të multimonedha që mbështesin modelet tradicionale, së pari ato relacionale, do të jenë më të kërkuara; popullariteti i DBMS-ve multimonedha që ofrojnë modele të reja, duke kombinuar përfitimet e disa tradicionaleve, është një çështje më e largët.
Vetëm përdoruesit e regjistruar mund të marrin pjesë në anketë. , ju lutem.
A përdorni DBMS multimonedha?
Nuk përdorim, e ruajmë gjithçka në një DBMS dhe në një model.
Përdorim mundësitë multimonedha të DBMS-ve tradicionale.
Praktikojmë ruajtjen shumëvariantësh (polyglot persistence).
Përdorim DBMS të reja multimonedha (Arango, Orient, CosmosDB).
19 përdorues votuan. 4 përdorues u abstenuan.
Burimi: habr.com
