

Përshëndetje të gjithëve. Po ndajmë përkthimin e pjesës përfundimtare të artikullit, përgatitur posaçërisht për studentët e kursit . Mund të njiheni me pjesën e parë .
Apache Beam dhe DataFlow për pipeline të vërtetë në kohë reale
Konfigurimi i Google Cloud
Shënim: Për të ekzekutuar linjën e prodhimit dhe publikimin e të dhënave nga regjistri i përdoruesit, kam përdorur Google Cloud Shell, pasi kam pasur probleme me ekzekutimin e linjës në Python 3. Google Cloud Shell përdor Python 2, i cili është më i përshtatshëm për Apache Beam.
Për të ekzekutuar linjën, na nevojitet pak të thellojmë në konfigurime. Për ata prej jush që nuk e kanë përdorur më parë GCP, duhet të kryeni 6 hapat e mëposhtëm që janë cituar në këtë .
Pas kësaj, do të duhet të ngarkojmë skenarët tanë në ruajtjen e re të Google dhe t'i kopjojmë në Google Cloud Shell tonë. Ngarkimi në ruajtjen e re është mjaft i thjeshtë (përshkrimi mund të gjendet ). Për të kopjuar skedarët tanë, mund të hapim Google Cloud Shell nga paneli i mjeteve duke klikuar ikonen e parë nga majtas në figurën 2 më poshtë.
Figura 2
Komandat që na nevojiten për kopjimin e skedarëve dhe instalimin e bibliotekave të nevojshme janë listuar më poshtë.
# Copy file from cloud storage
gsutil cp gs://<YOUR-BUCKET>/ * .
sudo pip install apache-beam[gcp] oauth2client==3.0.0
sudo pip install -U pip
sudo pip install Faker==1.0.2
# Environment variables
BUCKET=<YOUR-BUCKET>
PROJECT=<YOUR-PROJECT>
Krijimi i bazës sonë të të dhënave dhe tabelës
Pas kryerjes së të gjitha hapave të lidhura me konfigurimin, gjëja tjetër që na nevojitet të bëjmë është krijimi i një grupi të dhënash dhe tabelës në BigQuery. Ka disa mënyra për ta bërë këtë, por më e thjeshta është përdorimi i konsolës së Google Cloud, duke krijuar fillimisht një grup të dhënash. Ju mund të kryeni veprimet e listuara nga , për të krijuar një tabelë me skemë. Tabela jonë do të ketë 7 kolona, të cilat korrespondojnë me komponentët e çdo regjistri të përdoruesit. Për shkak të lehtësisë, ne do t'i përcaktojmë të gjitha kolonat si string (tipi string), përveç variablës timelocal, dhe do t'i quajmë sipas variablave që kemi gjeneruar më parë. Skema e tabelës sonë duhet të duket si në figurën 3.
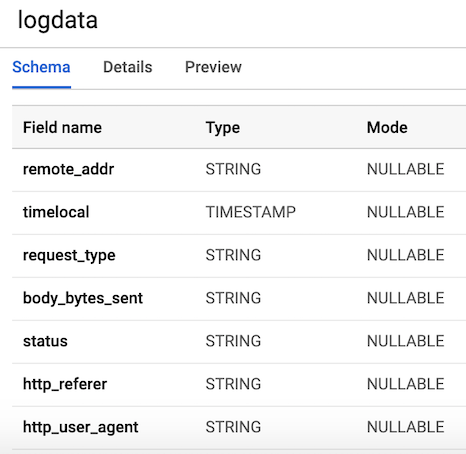
Figura 3. Skema e tabelës
Publikimi i të dhënave nga regjistri i përdoruesit
Pub/Sub është një komponent kritik i linjës tonë, pasi lejon aplikacione të pavarura të komunikojnë midis tyre. Në veçanti, ai funksionon si një ndërmjetës, duke na lejuar të dërgojmë dhe marrim mesazhe midis aplikacioneve. E para që na nevojitet të bëjmë është krijimi i një teme (topic). Mjafton të kaloni në Pub/Sub në konsolë dhe të klikoni krijo teme (CREATE TOPIC).
Kodi i mëposhtëm thërret skriptin tonë për të gjeneruar të dhënat e logutsi, të cilat janë përcaktuar më parë, dhe pastaj lidhet dhe dërgon loget në Pub/Sub. E vetmja gjë që na duhet të bëjmë është të krijojmë një objekt PublisherClient, të përcaktojmë rrugën e temës me metodën topic_path dhe të thërrasim funksionin publish me topic_path me të dhënat. Vini re se ne importojmë generate_log_line nga skripti ynë stream_logs, prandaj sigurohuni që këto skedarë janë në të njëjtën dosje, përndryshe do të merrni një gabim importi. Më pas, mund ta ekzekutojmë këtë përmes konsolës sonë të Google, duke përdorur:
python publish.pyfrom stream_logs import generate_log_line
import logging
from google.cloud import pubsub_v1
import random
import time
PROJECT_ID="user-logs-237110"
TOPIC = "userlogs"
publisher = pubsub_v1.PublisherClient()
topic_path = publisher.topic_path(PROJECT_ID, TOPIC)
def publish(publisher, topic, message):
data = message.encode('utf-8')
return publisher.publish(topic_path, data = data)
def callback(message_future):
# Kur koha e skadencës nuk është e përcaktuar, metoda e përjashtimit presin pafundësisht.
if message_future.exception(timeout=30):
print('Dërgimi i mesazhit në {} ndodhi një përjashtim {}.'.format(
topic_name, message_future.exception()))
else:
print(message_future.result())
if __name__ == '__main__':
while True:
line = generate_log_line()
print(line)
message_future = publish(publisher, topic_path, line)
message_future.add_done_callback(callback)
sleep_time = random.choice(range(1, 3, 1))
time.sleep(sleep_time)Sa kohë që skedari është i aktivizuar, do të mund të shohim daljen e të dhënave të logut në konsolë, siç tregohet në figurën më poshtë. Ky skript do të funksionojë derisa të përdorim CTRL+C, për ta ndaluar atë.
Figura 4. Dalja publish_logs.py
Shkrimi i kodit tonë për tubin
Tani që kemi përgatitur gjithçka, mund të kalojmë në pjesën më interesante — shkrimi i kodit tonë për tubin, duke përdorur Beam dhe Python. Për të krijuar një tub të Beam-it, na nevojitet të krijojmë një objekt tubi (p). Pasi të kemi krijuar objektin e tubit, mund të aplikojmë disa funksione njëra pas tjetrës, duke përdorur operatorin pipe (|). Në përgjithësi, procesi i punës duket si në figurën më poshtë.
[Dalja përfundimtare PCollection] = ([PCollection e Input të Parë] | [Transformimi i Parë]
             | [Transformimi i Dytë]
             | [Transformimi i Tretë])
Në kodin tonë do të krijojmë dy funksione të personalizuara. Funksionin regex_clean, i cili skanon të dhënat dhe nxjerr një varg të përshtatshëm në bazë të listës PATTERNS, duke përdorur funksionin re.search. Funksioni kthen një varg të ndarë me virgula. Nëse nuk jeni ekspert në shprehjet e rregullta, ju rekomandoj të njiheni me këtë dhe të praktikoni në blloknot për të verifikuar kodin. Pas kësaj, ne përcaktojmë një funksion ParDo të personalizuar të quajtur Ndarja, i cili është një variacion i transformimit Beam për përpunim paralel. Në Python, kjo bëhet në një mënyrë të veçantë — ne duhet të krijojmë një klasë që trashëgon nga klasa DoFn e Beam. Funksioni Ndarja merr një varg të analizuar nga funksioni paraprak dhe kthen një listë dictionaries me çelësa që korrespondojnë me emrat e kolonave në tabelën tonë BigQuery. Ka diçka që duhet theksuar në lidhje me këtë funksion: më duhej të importoja datetime brenda funksionit për të punuar. Marrja e një mesazhi gabimi gjatë importimit në fillim të skedarit ishte e çuditshme. Kjo listë më pas i kalon funksionit WriteToBigQuery, i cili thjesht shton të dhënat tona në tabelë. Kodi për Batch DataFlow Job dhe Streaming DataFlow Job është i dhënë më poshtë. Diferenca e vetme midis kodit paketor dhe atij rrjedhësor është se në përpunimin e paketave lexojmë CSV nga src_path, duke përdorur funksionin ReadFromText nga Beam.
Batch DataFlow Job (përpunimi i paketave)
import apache_beam as beam
from apache_beam.options.pipeline_options import PipelineOptions
from google.cloud import bigquery
import re
import logging
import sys

PROJECT='user-logs-237110'
schema = 'remote_addr:STRING, timelocal:STRING, request_type:STRING, status:STRING, body_bytes_sent:STRING, http_referer:STRING, http_user_agent:STRING'


src_path = "user_log_fileC.txt"

def regex_clean(data):

    PATTERNS =  [r'(^S+.[S+.]+S+)s',r'(?<=[).+?(?=])',
           r'"(S+)s(S+)s*(S*)"',r's(d+)s',r"(?<=[).d+(?=])",
           r'"[A-Z][a-z]+', r'"(http|https):\/\/[a-z]+.[a-z]+.[a-z]+']
    result = []
    for match in PATTERNS:
      try:
        reg_match = re.search(match, data).group()
        if reg_match:
          result.append(reg_match)
        else:
          result.append(" ")
      except:
        print("Ka ndodhur një gabim me kërkimin regex")
    result = [x.strip() for x in result]
    result = [x.replace('"', "") for x in result]
    res = ','.join(result)
    return res


class Split(beam.DoFn):

    def process(self, element):
        from datetime import datetime
        element = element.split(",")
        d = datetime.strptime(element[1], "%d\/\b\/\%Y:%H:%M:%S")
        date_string = d.strftime("%Y-%m-%d %H:%M:%S")

        return [{
            'remote_addr': element[0],
            'timelocal': date_string,
            'request_type': element[2],
            'status': element[3],
            'body_bytes_sent': element[4],
            'http_referer': element[5],
            'http_user_agent': element[6]

        }]

def main():

   p = beam.Pipeline(options=PipelineOptions())

   (p
      | 'ReadData' >> beam.io.textio.ReadFromText(src_path)
      | "pastroni adresën" >> beam.Map(regex_clean)
      | 'ParseCSV' >> beam.ParDo(Split())
      | 'WriteToBigQuery' >> beam.io.WriteToBigQuery('{0}:userlogs.logdata'.format(PROJECT), schema=schema,
        write_disposition=beam.io.BigQueryDisposition.WRITE_APPEND)
   )

   p.run()

if __name__ == '__main__':
  logger = logging.getLogger().setLevel(logging.INFO)
  main()
Streaming DataFlow Job (përpunimi i rrjedhës)
nga apache_beam.options.pipeline_options import PipelineOptions
nga google.cloud import pubsub_v1
nga google.cloud import bigquery
import apache_beam si beam
import logging
import argparse
import sys
import re


PROJEKTI="user-logs-237110"
schema = 'remote_addr:STRING, timelocal:STRING, request_type:STRING, status:STRING, body_bytes_sent:STRING, http_referer:STRING, http_user_agent:STRING'
TOPIKU = "projekti/user-logs-237110/topikët/userlogs"


def regex_clean(të dhëna):

    PATTERNET =  [r'(^S+.[S+.]+S+)s',r'(?<=[).+?(?=])',
           r'"(S+)s(S+)s*(S*)"',r's(d+)s',r"(?> beam.io.ReadFromPubSub(topic=TOPIKU).with_output_types(bytes)
      | "Decode" >> beam.Map(lambda x: x.decode('utf-8'))
      | "Pastrimi i të Dhënave" >> beam.Map(regex_clean)
      | 'AnalizaCSV' >> beam.ParDo(Ndara())
      | 'ShkruajNëBigQuery' >> beam.io.WriteToBigQuery('{0}:userlogs.logdata'.format(PROJEKTI), schema=schema,
        write_disposition=beam.io.BigQueryDisposition.WRITE_APPEND)
   )
   rezultati = p.run()
   rezultati.wait_until_finish()

nëse __name__ == '__main__':
  logger = logging.getLogger().setLevel(logging.INFO)
  main()
Fillimi i konvejrit
Ne mund të nisim tubin në disa mënyra të ndryshme. Nëse do të donim, do të mund ta nisnim thjesht lokal nga terminali, duke hyrë larg në GCP.
python -m main_pipeline_stream.py
 --input_topic "projekti/user-logs-237110/topikët/userlogs"
 --streaming
Megjithatë, ne do ta nisim atë duke përdorur DataFlow. Ne mund ta bëjmë këtë me komandën e mëposhtme, duke vendosur parametrat e detyrueshëm të mëposhtëm.
projekt— ID e projektit tuaj GCP.runner— mjeti që nxit tubin, i cili do të analizojë programin tuaj dhe do të ndërtojë tubin tuaj. Për të funksionuar në re, duhet të specifikoni DataflowRunner.staging_location— rruga drejt ruajtjes në re Cloud Dataflow për indeksimin e paketave të kodit që nevojiten për përpunuesit që kryejnë punën.temp_location— rruga drejt ruajtjes në re Cloud Dataflow për ruajtjen e skedarëve përkohësorë të detyrave që krijohen gjatë funksionimit të tubit.streaming
python main_pipeline_stream.py
--runner DataFlow
--project $PROJECT
--temp_location $BUCKET/tmp
--staging_location $BUCKET/staging
--streaming
Ndërsa ky komandë po ekzekutohet, mund të kalojmë në skedën DataFlow në google-console dhe të shqyrtojmë pipeline tonë. Duke klikuar në pipeline, duhet të shohim diçka të ngjashme me figurën 4. Për qëllime debuguese, mund të jetë shumë e dobishme të kalojmë në log-et dhe pastaj në Stackdriver për të parë log-et me detaje. Kjo më ndihmoi të zgjidhja probleme me pipeline në disa raste.
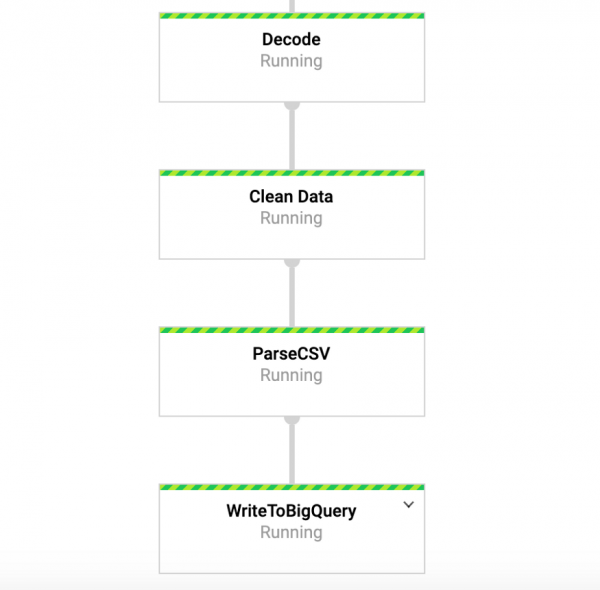
Figura 4: Pipeline Beam
Qasja në të dhënat tona në BigQuery
Pra, tashmë duhet të kemi një pipeline të aktivizuar me të dhëna që po i japin tabelës tonë. Për ta kontrolluar këtë, mund të kalojmë te BigQuery dhe të shohim të dhënat. Pas përdorimit të komandës më poshtë, duhet të shihni disa rreshta të parë nga seti i të dhënave. Tani që kemi të dhëna të ruajtura në BigQuery, mund të bëjmë analiza të mëtejshme dhe gjithashtu të ndajmë të dhënat me kolegët dhe të fillojmë të përgjigjemi në pyetje biznesi.
SELECT * FROM `user-logs-237110.userlogs.logdata` LIMIT 10; 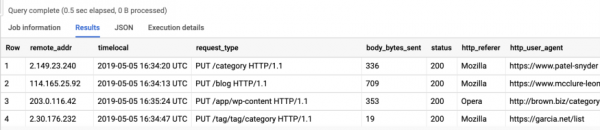
Figura 5: BigQuery
Përfundim
Shpresojmë që ky postim të shërbejë si një shembull i dobishëm për krijimin e një pipeline të të dhënave streaming dhe gjithashtu për gjetjen e mënyrave për ta bërë të dhënat më të aksesueshme. Ruajtja e të dhënave në një format të tillë na ofron shumë përfitime. Tani mund të fillojmë të përgjigjemi në pyetje të rëndësishme, siç janë: sa njerëz po e përdorin produktin tonë? A po rritet numri i përdoruesve me kalimin e kohës? Me cilat aspekte të produktit ndërveprojnë më shumë njerëzit? Dhe a ka gabime atje ku nuk duhet të jenë? Këto janë pyetje që do të jenë të rëndësishme për organizatën. Në bazë të ideve që rrjedhin nga përgjigjet për këto pyetje, do të jemi në gjendje të përmirësojmë produktin dhe të rrisim angazhimin e përdoruesve.
Beam është vërtet i dobishëm për këtë lloj ushtrimesh, si dhe ka një numër rastesh interesantë të tjera për përdorim. Për shembull, mund të analizoni të dhënat nga tick-at e bursës në kohë reale dhe të kryeni tregti në bazë të analizës, ndoshta keni të dhëna sensorësh që vijnë nga automjetet dhe dëshironi të llogaritni nivelin e trafikut. Po ashtu, mund të jeni një kompani lojërash që mbledh të dhëna nga përdoruesit dhe i përdor ato për të krijuar bordet informuese për të ndjekur indikatorët kyç. Mirë, zotërinj, kjo është një temë për një post tjetër, faleminderit për leximin dhe për ata që duan të shohin kodin e plotë, më poshtë është lidhja për GitHub-in tim.
Këtu përfundon gjithçka. .
Burimi: habr.com
