

Thuhet se në jetë çdo gjë duhet provuar të paktën një herë. Dhe nëse jeni mësuar të punoni me DB-relacionale, atëherë është e rekomandueshme të njihet praktikisht me NoSQL, fillimisht për zhvillim të përgjithshëm. Tani, për shkak të zhvillimit të shpejtë të teknologjisë, ka shumë opinione të kundërta dhe debate të nxehta në lidhje me këtë temë, të cilat veçanërisht nxjerrin në pah interesin.
Nëse thellohesh në thelbin e të gjitha këtyre debateve, mund të shohësh se ato lindin nga një qasje e gabuar. Ata që përdorin bazat e të dhënave NoSQL atje ku janë të nevojshme janë të kënaqur dhe përfitojnë nga ky zgjidhje. Ndërsa eksperimentuesit, që besojnë në këtë teknologji si një ilaç për atje ku ajo nuk aplikohet asnjëherë, përjetojnë zhgënjim, duke humbur përfitimet e forta të bazave të të dhënave relacionale pa fituar ndonjë përfitim të rëndësishëm.
Do të flas për përvojën tonë në zbatimin e një zgjidhjeje, të bazuar në DB-në Cassandra: me çfarë jemi përballur, si kemi dalë nga situatat e vështira, nëse arritëm të përfitonim nga përdorimi i NoSQL dhe ku duhej të investonim përpjekje/shtëpi.
Detyra fillestare është ndërtimi i një sistemi për regjistrimin e thirrjeve në një ruajtje të caktuar.
Parimi i funksionimit të sistemit është si në vijim. Në hyrje vijnë skedarë me një strukturë të caktuar, që përshkruan strukturën e thirrjes. Pastaj aplikacioni siguron ruajtjen e kësaj strukture në kolonat përkatëse. Më pas, thirrjet e ruajtura përdoren – për të treguar informacionin mbi konsumimin e trafikut për abonentët (lëvizjet, thirrjet, historia e bilancit).
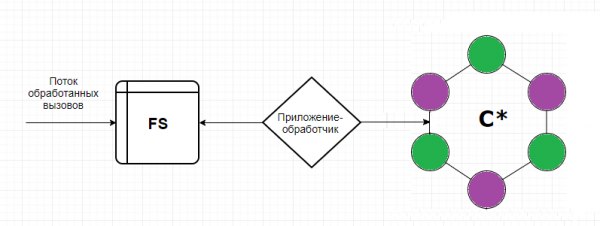
Pse zgjodhëm Cassandra është e qartë – ajo regjistron si një mitraloz, është lehtë e shkallëzueshme, e qëndrueshme ndaj dështimeve.
Pra, ja çfarë na dhuroi përvoja.
Po, një nod i rënë nuk është një tragjedi. Kjo është thelbi i qëndrueshmërisë së Cassandra-s. Por nodi mund të jetë aktiv dhe në të njëjtën kohë të fillojë të bie në performancë.. Siç u zbulua, kjo ndikon menjëherë në performancën e tërë klasterit.
Cassandra nuk do të të ndihmojë atje ku Oracle shpëton me kufizimet e tij.. Dhe nëse autori i aplikacionit nuk e kuptoi këtë paraprakisht, atëherë dyfishimi i ardhur për Cassandra-n është njëlloj i mirë sa origjinali. Nëse ka ardhur, ne e fusim.
Cassandra falas "nga kutia" nuk i pëlqeu aspak shumicës së informacionit për të dhëna: nuk ka regjistrim të veprimeve të përdoruesve, as ndarjen e të drejtave gjithashtu.Informacioni në lidhje me thirrjet i përket të dhënave personale, duke nënkuptuar se çdo përpjekje për ta kërkuar/ndryshuar atë duhet të regjistrohet me mundësinë e auditimit të mëvonshëm. Po ashtu, duhet të kuptohet nevoja për të ndarë të drejtat në nivele të ndryshme për përdorues të ndryshëm. Një inxhinier i zakonshëm i operimit dhe një superadmin, i cili mund të fshijë gjithçka në keyspace – janë role të ndryshme, me përgjegjësi dhe kompetenca të ndryshme. Pa një ndarje të tillë të të drejtave të aksesit, vlera dhe integriteti i të dhënave menjëherë do të vihet në dyshim më shpejt se në nivelin e qëndrueshmërisë ANY.
Nuk e kemi marrë parasysh se për thirrjet kërkohet një analizë serioze, si dhe mostra të përkohshme sipas kushtesh të ndryshme. Duke pasur parasysh se regjistrimet e zgjedhura pastaj mendohet të fshihen dhe të rivendosen (në kuadër të detyrës duhet të mbajmë procesin e aktualizimit të të dhënave për të dhënat që fillimisht na janë dërguar gabimisht), Cassandra këtu nuk na ndihmon. Cassandra, si një kasafortë – është e lehtë të vendosësh gjëra atje, por nuk do të jesh në gjendje të bësh llogari.
Jemi ballafaquar me problemin e transferimit të të dhënave në zonat testuese. (5 nod në test në krahasim me 20 në prodhim). Në këtë rast, nuk do të mund të përdorim dump-in.
Problemi i përditësimeve të skemës së të dhënave të aplikacionit që shkruan në Cassandra. Rikthimi do të sjellë një numër të madh varresh, që në mënyrë të paparashikueshme mund të na ulin performancën.Cassandra është optimizuar për shkrim, dhe para se të shkruajë, shumë nuk mendon. Çdo operacion me të dhëna ekzistuese atje është gjithashtu një shkrim. Domethënë, duke fshirë të tepërta, ne thjesht do të krijojmë më shumë shkrime, dhe vetëm një pjesë prej tyre do të shënohet si varre.
Kohët e pritjes gjatë hyrjes. Cassandra është perfekte për shkrime, por ndonjëherë fluksi i hyrës mund ta shqetësojë atë ndjeshëm.Kjo ndodh kur aplikacioni fillon të ruajë disa regjistrime në një rreth që nuk mund të hynë për ndonjë arsye. Dhe na nevojitet një DBA i vërtetë, që do të monitorojë gc.log, log-et e sistemit dhe debug për query të ngadalta, metrikat për kompresimin e pritur.
Disa qendra të të dhënave në klaster. Nga ku të lexojmë dhe ku të shkruajmë?
A është e mundur të ndajmë mes leximit dhe shkrimit? Dhe nëse po, a duhet të jetë DCB afër aplikacionit për shkrim apo për lexim? A do të kemi një vërtetë "split brain" nëse zgjedhim gabim nivelin e koherencës? Ka shumë pyetje, shumë parametra të panjohur, mundësi që do të dëshironim t'i eksploronim.
Si e zgjidhëm
Për të mos rënë nodi, e çaktivizuam SWAP. Tani, kur ka mungesë të memories, nodi duhet të shkojë poshtë, e jo të prodhojë bllokime të mëdha GC.
Pra, tashmë nuk besojmë më në logjikën e DB. Zhvilluesit e aplikacionit po e rishikojnë dhe fillojnë të mbrohen aktivisht në kodin e tyre. Ndarje perfekte e qartë mes ruajtjes dhe përpunimit të të dhënave.
Kemi blerë mbështetje nga DataStax. Kassandran kutisë ka ndaluar së zhvilluari (komitimi i fundit në shkurt 2018). Megjithatë, Datastax ofron një shërbim të shkëlqyer dhe shumë zgjidhje të përmirësuara dhe të përshtatura sipas sistemeve ekzistuese.
Dua gjithashtu të theksoj se Kassandra nuk është shumë e përshtatshme për kërkesat e seleksionimit. Natyrisht, CQL është një hap i madh drejt përdoruesve (krahasuar me Thrift). Por, nëse keni departamente të tëra që janë mësuar me bashkime të tilla të përshtatshme, filtrime të lira sipas çdo fushe dhe mundësi optimizimi të kërkesave, atëherë zgjidhja në Kassandër duket për ta si një armik i padurueshëm dhe absurd. Dhe ne filluam të zgjidhim pyetjen se si mund t'i bëjmë seleksionet kolegëve tanë.
U shqyrtuar dy variante. Në variantin e parë, shkruajmë thirrje jo vetëm në C*, por edhe në bazën e të dhënave arkivore Oracle. Megjithatë, ndryshe nga C*, në këtë BDB ruhen thirrjet vetëm për muajin aktual (thellësia e mjaftueshme e ruajtjes së thirrjeve për rastet e ri tarifimit). Këtu u shfaq problemi tjetër: nëse shkruajmë në mënyrë sinkrone, ne humbim të gjitha përparësitë e C*, lidhur me insertimin e shpejtë; nëse asinkrone – nuk ka garantim që të gjitha thirrjet e nevojshme do të përfshihen gjithsesi në Oracle. Një përparësi e madhe ishte se për përdorim mbetet e njëjta PL/SQL Developer, pra, praktikisht realizojmë modelin "Fasadë". Variante alternative. Realizojmë një mekanizëm që nxjerr thirrjet nga C*, merr disa të dhëna për pasurimin nga tabelat përkatëse në Oracle, bashkon seleksionet e marra dhe na jep rezultatin e marrë, që pastaj ne e përdorim ndonjëherë (e kthejmë, e ripërsërisim, e analizojmë, e admirojmë). Disavantazhet: procesi bëhet mjaft shumë-hapësh, dhe për më tepër, nuk ka një ndërlidhje për punonjësit e operimit.
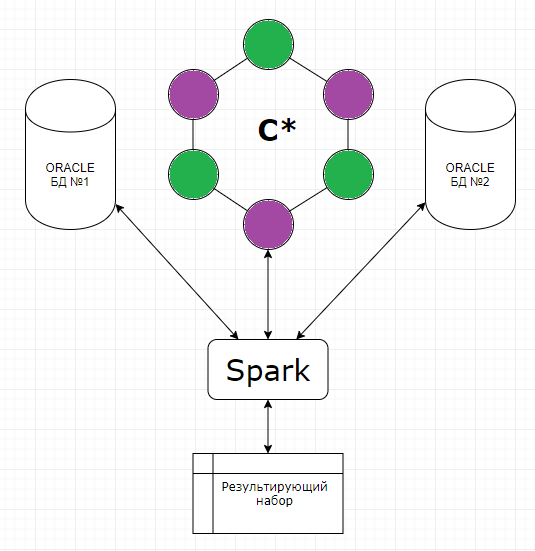
Në përfundim, u ndalëm në variantin e dytë. Për seleksionet nga banka të ndryshme përdorëm Apache Spark. Esenca e mekanizmit u reduktua në një kod Java, i cili sipas çelësave të caktuar (abonenti, koha e thirrjes – çelësat e seksionit) nxjerr të dhëna nga C*, si dhe të dhënat e nevojshme për pasurimin nga çdo BDB tjetër. Pas kësaj, i bashkon ato në kujtesën e tij dhe jep rezultatin në tabelën përfundimtare. Për Spark, krijuam një ndërfaqe web dhe rezultoi të ishte plotësisht e përdorshme.
Në trajtimin e çështjes së azhurnimit të të dhënave, ne sërish shqyrtuam disa mënyra zgjidhjeje. Si kalimi përmes Sstloader, ashtu dhe varianti me ndarjen e klasterit në zonën e testimit në dy pjesë, ku secila herë hyn në një klaster me atë të prodhimit, duke u furnizuar në këtë mënyrë prej tij. Kur u planifikua azhurnimi i testit, ishte parashikuar të këmbenim vendet: ajo pjesë që punonte në test do të pastronte dhe do të hynte në prodhim, ndërsa tjetra fillonte të punonte me të dhëna ndaras. Megjithatë, duke e menduar përsëri, ne e vlerësuam më racionalisht të dhënat që duhet të transferohen dhe kuptuam se vetë thirrjet janë një entitet jo konsistent për testet, që krijohet shpejt në rast nevoje, dhe pikërisht grupi i të dhënave të prodhimit nuk ka vlerë për transferim në test. ka disa objekte-akumulatorë që duhet të transferohen, por kjo është për të thënë disa tabela, të cilat nuk janë shumë të rënda. Prandaj, ne si zgjidhje përsëri erdhi në ndihmë Spark, me të cilin ne shkruam dhe filluam të përdorim aktivisht skriptin për transferimin e të dhënave midis tabelave prodhim-test.
Politika jonë aktuale e deplojtimit na lejon të punojmë pa rregullime. Para prodhimit, ka një aplikuar obligativ në test, ku gabimi nuk është aq i kushtueshëm. Në rast dështimi, gjithmonë mund të fshijmë case-space dhe të aplikojmë tërë skemën nga fillimi.
Për të siguruar disponueshmërinë e vazhdueshme të Cassandra-s, nevojitet një DBA dhe jo vetëm ai. Të gjithë ata që punojnë me aplikacionin duhet të kuptojnë se ku dhe si të shikojnë situatën aktuale dhe si të diagnostikojnë problemet në kohë. Për këtë ne përdorim aktivisht DataStax OpsCenter (Administrimi dhe monitorimi i ngarkesave të punës), metrikat sistemike të Cassandra Driver (numri i kohëve të pritura për shkrim në C*, numri i kohëve të pritura për lexim nga C*, latenca maksimale etj.), monitorojmë punën e vetë aplikacionit, që punon me Cassandra.
Kur kërkuam përgjigje për pyetjen e mëparshme, e kuptuam se ku mund të fshihet rreziku kryesor. Ky është formati i shfaqjes së të dhënave, i cili nxjerr të dhëna nga disa kërkesa të pavarura njëra nga tjetra në depo. Kështu mund të marrim informacione mjaft të papajtueshme. Por kjo problematikë do të ishte e pranishme edhe në rastin nëse do të punonim vetëm me një qendër të dhënash. Prandaj, e vetmja zgjidhje logjike këtu është të krijojmë një funksion grupor për leximin e të dhënave në një aplikacion të jashtëm, i cili do të garantojë marrjen e të dhënave në një periudhë të vetme kohore. Sa i përket ndarjes së leximit dhe shkruajtjes në planin e performancës, këtu u ndalëm nga rreziku se, në rast të humbjes së lidhjes midis QDC-ve, mund të marrim dy klasterë krejtësisht të papajtueshëm me njëri-tjetrin.
Si përfundim, deri në këtë moment u ndaluam në nivelin e pajtueshmërisë për shkruaj EACH_QUORUM, për leximin – LOCAL_QUORUM
Përmbledhje dhe përfundime të shkurtra
Për të vlerësuar zgjidhjen e arritur nga pikëpamja e mbështetjes funksionale dhe perspektivave për zhvillimin e mëtejshëm, vendosëm të mendojmë se ku mund të aplikojmë një zhvillim të tillë.
Nëse flasim shpejt, ndihma e të dhënave për programe si "Paguaj, kur të dëshirosh" (ngarko informacionin në S*, llogaritje në skenarët Spark), llogaria e kërkesave me agregimin sipas drejtimeve, ruajtja e roleve dhe llogaritja sipas matricës së rolit për të drejtat e qasjes së përdoruesve.
Siç e shohim, repertori është i gjerë dhe i larmishëm. Dhe nëse duhet të zgjedhim anën e mbështetësve/kundërshtarëve të NoSQL, ne do të anojmë kah mbështetësit, pasi kemi arritur përfitime, dhe pikërisht aty ku e prisnim.
Madje, varianti Cassandra nga kuti lejon të bëhet shkallëzim horizontal në kohë reale, duke zgjidhur pa dhimbje çështjen e rritjes së të dhënave në sistem. Arritëm të ndajmë një mekanizëm shumë me ngarkesë për llogaritjen e agregateve për thirrjet në një kontur të veçantë, si dhe të ndajmë skemën dhe logjikën e aplikacionit, duke u liruar nga praktika e keqe e shkruarjes së punëve dhe objekteve të personalizuara në vetë DB. Kemi fituar mundësinë të zgjedhim dhe konfigurojmë, për shpejtësi, në cilat QDC do të bëjmë llogaritjen dhe në cilat do të shkruajmë të dhënat, duke u mbrojtur ndaj rënieve si të nyjeve të veçanta, ashtu edhe në përgjithësi të QDC.
Duke përdorim arkitekturën tonë për projektet e reja, dhe, duke pasur tashmë disa përvojë, do të doja që menjëherë të marrim parasysh nuancat e përmendura më sipër dhe të shmangim disa gabime, duke zbutur disa këndvështrime të ashpra që nuk arritëm t'i evitojmë fillimisht.
Për shembull, të monitorojmë në kohë përditësimet e Cassandra-s, sepse shumë nga problemet që kemi pasur, ishin tashmë të njohura dhe ishin rregulluar.
Të mos vendosim si bazën e të dhënave ashtu edhe Spark në të njëjtat nodet. (ose të ndahen rreptësisht sipas sasisë së përdorimit të lejuar të burimeve), pasi Spark mund të konsumojë më shumë RAM sesa e lejuar, dhe ne do të kemi shpejt problemin numër 1 nga lista jonë.
Të zhvillojmë monitorimin dhe kompetencën e operimit edhe në fazën e testimit të projektit. Fillimisht të kemi sa më shumë parasysh të gjithë konsumatorët e mundshëm të zgjidhjes sonë, sepse pikërisht nga kjo do të varet struktura e bazës së të dhënave në fund.
Të rrokim disa herë diagramin e rezultuar për mundësitë e optimizimit. Të përcaktojmë cilat fusha mund të serializohen. Të kuptojmë cilat tabela të tjera duhet të krijojmë, në mënyrë që të marrim informacionin e kërkuar sa më saktë dhe optimalisht (p.sh., duke supozuar se të dhënat e njëjta mund të ruhen në tabela të ndryshme, duke marrë parasysh ndarjen e ndryshme sipas kritereve të ndryshme, mund të kursenim ndjeshëm kohën e procesorit gjatë kërkesave të leximit).
Nuk do të ishte keq të parashikohet menjëherë ndarja e TTL dhe pastrimi i të dhënave të skaduara.
Gjatë eksportit të të dhënave nga Cassandra logjika e aplikacionit duhet të funksionojë sipas parimit FETCH, në mënyrë që jo të gjitha rreshtat të ngarkohen në memorie njëherësh, por të zgjidhen në grupe.
Është e dëshirueshme që para kalimit të projektit në zgjidhjen e përshkruar të kontrollohet qëndrueshmëria e sistemit, duke kryer një seri testesh crash, si humbja e të dhënave në një Qendrën e të Dhënave, rikuperimi i të dhënave të dëmtuara për një periudhë të caktuar, ngadalësimi i rrjetit midis Qendrave të të Dhënave. Këto teste jo vetëm që do të lejojnë vlerësimin e avantazheve dhe disavantazheve të arkitekturës së propozuar, por gjithashtu do t'u japin inxhinierëve që i realizojnë ato një praktikë të mirë, dhe aftësia e fituar nuk do të jetë aspak e tepërt nëse dështimet e sistemit ndodhin në prodhim.
Nëse po punojmë me informacion kritik (siç janë të dhënat për faturim, llogaritjen e borxhit të klientit), ka kuptim të kushtohet vëmendje mjeteve që do të lejojnë uljen e rreziqeve që lindin për shkak të veçorive të DBMS. Për shembull, përdorimi i utilitarit nodesync (Datastax), duke zhvilluar një strategji optimale të përdorimit të tij, në mënyrë që për shkak të konsistencës të mos formohet një ngarkesë tepër në Cassandra dhe ta përdorim vetëm për tabela të caktuara në periudha të caktuara.
Çfarë ndodhi pas gjashtë muajve me Cassandra? Në përgjithësi, nuk ka probleme të zgjidhura. Nuk kemi lejuar as shpërthime serioze dhe as humbje të të dhënave. Po, ishte e nevojshme të mendohej për kompenzimin e disa problemeve që nuk ishin shfaqur më parë, por në fund kjo nuk e rëndoi shumë zgjidhjen tonë arkitekturore. Nëse dëshiron dhe nuk ke frikë të provosh diçka të re, dhe në të njëjtën kohë nuk dëshiron të zhgënjehesh shumë, përgatitu për faktin se asgjë nuk është falas. Do të duhet të merresh me detaje, të thellohet në dokumentacion dhe të mbledhësh gropat e tua individuale më tepër se me zgjidhjen e vjetër legacy dhe asnjë teori nuk do të të japë informacion paraprak për ato gropa që të presin.
Burimi: habr.com
