

Gjatë viteve të saj të ekzistencës, Pinterest ka 300 milion përdorues që kanë krijuar më shumë se 200 miliard pinë në më shumë se 4 miliard tabela. Për të shërbyer këtë ushtri përdoruesish dhe bazën e gjerë të përmbajtjeve, portali ka zhvilluar mijëra shërbime, duke filluar nga mikroshërbimet që mund të menaxhohen nga disa CPU, deri te gjigantët monolitë që funksionojnë në të gjithë një park të makinave virtuale. Dhe ja, erdhi momenti kur kompania i hodhi sytë mbi k8s. Çfarë e tërhoqi "kubin" tek "Pinterest"? Këtë do ta mësoni në përkthimin tonë të artikullit të fundit nga .
Pra, qindra miliona përdorues dhe qindra miliard pinë. Për të shërbyer këtë ushtri përdoruesish dhe bazën e gjerë të përmbajtjeve, ne kemi zhvilluar mijëra shërbime, duke filluar nga mikroshërbimet që mund të menaxhohen nga disa CPU, deri te gjigantët monolitë që funksionojnë në të gjithë një park të makinave virtuale. Për më tepër, ne kemi një përzgjedhje të ndryshme framework-esh, të cilat gjithashtu mund të kërkojnë burime CPU, memorie ose qasje në operacione të hyrjes-daljes.
Gjatë mbështetjes së këtij zooteku mjetesh, ekipi i zhvillimit përballet me një sërë problemesh:
- Inxhinierët nuk kanë një mënyrë të unifikuar për të nisur ambientin e punës. Shërbimet pa gjendje, shërbimet me gjendje dhe projektet në zhvillim aktiv bazohen në grupe të ndryshme teknologjike. Kjo ka çuar në krijimin e një kursi të tërë trajnimi për inxhinierët, si dhe e komplikon seriozisht punën e ekipit tonë infrastrukturor.
- Zhvilluesit, të cilët kanë në dispozicion parkun e tyre të makinave virtuale, krijojnë një ngarkesë të madhe për administratorët e brendshëm. Si rezultat, operacione të thjeshta, si përditësimi i OS-së ose AMI-së, shtrihen për javë dhe muaj. Kjo çon në një rritje të ngarkesës në situata që duket se janë krejtësisht rutinë.
- Vështirësi në krijimin e mjeteve globale për menaxhimin e infrastrukturës mbi zgjidhjet ekzistuese. Situata shpërndahet edhe më shumë nga fakti se është e vështirë të gjejmë pronarët e makinave virtuale. Pra, ne nuk dimë nëse është e sigurt të nxjerrim këto kapacitete për t'u përdorur në seksione të tjera të infrastrukturës sonë.
Sistemet e orkestrimit të kontejnerëve janë një mënyrë për të unifikuar menaxhimin e ngarkesës së punës. Ato ju hapin rrugën për të rritur shpejtësinë e zhvillimit dhe e lehtësojnë menaxhimin e infrastrukturës, pasi të gjitha burimet e angazhuara në projekt menaxhohen nga një sistem qendror.
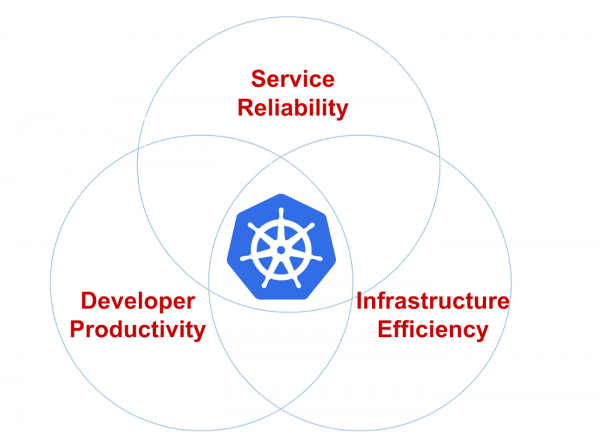
Figura 1: Prioritetet e infrastrukturës (besueshmëria, performanca e zhvilluesve dhe efikasiteti).
Ekipa e Platformës së Menaxhimit të Rejllave në Pinterest u njoh me K8s në vitin 2017. Gjatë gjysmës së parë të vitit 2017 ne dokumentuam pjesën më të madhe të kapaciteteve tona të prodhimit, duke përfshirë API-në dhe të gjitha serverët web.Më pas ne kryem një vlerësim të kujdesshëm të sistemeve të ndryshme të orkestrimit të zgjidhjeve të kontejnerëve, ndërtimit të klasterëve dhe operimit me to. Në fund të vitit 2017 vendosëm të shfrytëzojmë Kubernetes. Ai ishte mjaft fleksibël dhe mbështetej gjerësisht në komunitetin e zhvilluesve.
Në momentin e tanishëm, ne krijuam mjetet tona për ngarkimin e parë të klasterit bazuar në Kops dhe e kaluam në Kubernetes komponentet ekzistuese të infrastrukturës — si rrjeti, siguria, metrikat, regjistrimi, menaxhimi i identitetit dhe trafiku. Në të njëjtën kohë, ne implementuam një sistem modelimi të ngarkesave të punës për burimin tonë, kompleksiteti i të cilit është i fshehur nga zhvilluesit. Tani jemi të fokusuar në sigurimin e stabilitetit të klasterit, shkallëzimin e tij dhe lidhjen e klientëve të rinj.
Kubernetes: Rruga e Pinterest
Fillimi i punës me Kubernetes në shkallë të gjerë në Pinterest si një platformë që do të donin inxhinierët tanë, rezultoi me shumë vështirësi.
Si një kompani e madhe, ne kemi investuar shuma të konsiderueshme në mjetet infrastrukturore. Një shembull mund të jenë mjetet e sigurisë, të cilat përcjellin certifikatat dhe shpërndajnë çelësat, komponentet e kontrollit të trafikut, sistemet e zbulimit të shërbimeve, komponentet e dukshmërisë dhe regjistrimit të metrikave. Të gjitha këto u mblodhën jo thjesht kështu: ne kaluam një rrugë normale për provë dhe gabim, dhe për këtë arsye donim të integronim të gjithë këtë pasuri në infrastrukturën e re në Kubernetes në vend që të shpiknim nga e para një biçikletë të vjetër në një platformë të re. Ky qasje, në përgjithësi, e thjeshtoi migrimin, pasi mbështetje për aplikacionet tashmë ekziston, nuk është e nevojshme ta krijosh nga e para.
Po anën tjetër, modelet e parashikimit të ngarkesave në vetë Kubernetes (siç janë shpërndarjet, detyrat dhe grupe të daemon-ve) nuk janë të mjaftueshme për projektin tonë. Këto probleme përdorimi përbëjnë pengesa të mëdha në rrugën drejt kalimit në Kubernetes. Për shembull, kemi dëgjuar si zhvilluesit e shërbimeve ankohen për mungesën ose konfigurimin e papërshtatshëm të hyrjes. Gjithashtu, kemi hasur në përdorimin e gabuar të shabloneve, kur janë krijuar qindra kopje me specifikime dhe detyra identike, që ka çuar në probleme të tmerrshme me debugimin.
Ishte gjithashtu shumë e vështirë të mbahet versionet e ndryshme në të njëjtin klaster. Imagjinoni vështirësitë në mbështetje për klientët, nëse duhet të punoni në të njëjtën kohë me shumë versione të të njëjtit ambient ekzekutimi, me të gjitha problemet, defektet dhe azhurnimet e tyre.
Burimet dhe kontrollet e personalizuara të Pinterest
Për të lehtësuar procesin e implementimit të Kubernetes për inxhinierët tanë, si dhe për të thjeshtuar infrastrukturën dhe për të përshpejtuar funksionimin e saj, ne zhvilluam definicionet tona të burimeve të personalizuara (CRD).
CRD ofrojnë funksionalitetet e mëposhtme:
- Kombinimi i burimeve të ndryshme natively të Kubernetes, në mënyrë që ato të funksionojnë si një ngarkesë e vetme. Për shembull, burimi PinterestService përfshin shpërndarjen, shërbimin e hyrjes dhe hartën e konfigurimit. Kjo i lejon zhvilluesit të mos shqetësohen për konfigurimin e DNS.
- Implementimi i mbështetjes së nevojshme për aplikacionet. Përdoruesi duhet të përqendrohet vetëm në specifikimin e kontejnerit sipas logjikës së tij të biznesit, ndërsa kontrolluesi CRD implementon të gjitha init-kontejnerët e nevojshëm, variablat e mjedisit dhe specifikimet e pod-it. Kjo siguron një nivel ndryshe komoditeti për zhvilluesit.
- Kontrolluesit CRD gjithashtu menaxhojnë ciklin e jetës së burimeve të tyre dhe rrisin disponueshmërinë e debugimit. Kjo përfshin pajtimin e specifikimeve të dëshiruara dhe reale, përditësimin e statusit CRD dhe mbajtjen e log-eve të ngjarjeve dhe jo vetëm. Pa CRD, zhvilluesit do të ishin të detyruar të menaxhonin një grup të madh burimesh, çka vetëm do të rrisë mundësinë e gabimeve.
Ja një shembull i PinterestService dhe një burim të brendshëm që menaxhohet nga kontrolluesi ynë:
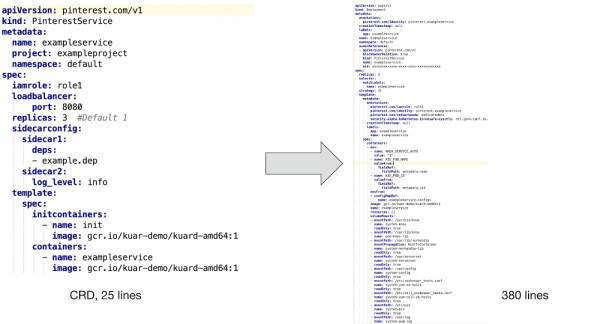
Si mund të shihet më sipër, për të mbështetur enën e përdoruesit, na nevojitet të integrojmë brenda saj një enë inicializimi dhe disa shtesa për të siguruar sigurinë, dukshmërinë dhe funksionimin me trafikun rrjetës. Për më tepër, ne krijuam skema konfigurimi dhe zbatuam mbështetje për shabllon PVC për punët e paketuar, si dhe gjurmimin e shumë variablave të ambientit për të ndjekur identifikimin, konsumimin e burimeve dhe mbledhjen e "plehrave".
Është e vështirë të imagjinohet se zhvilluesit do të dëshironin të shkruanin këto skedat konfigurimi manualisht pa mbështetje CRD, për të mos përmendur mbështetje të mëtejshme dhe shpërndarje të konfigurations.
Fluksi i aplikacioneve të shpërndarjes
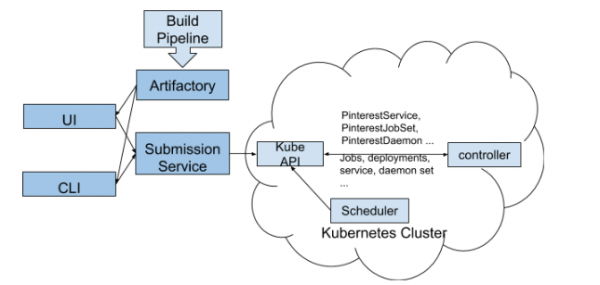
Në diagramin më sipër tregohet si të shpërndani burimin e përdoruesve Pinterest në një klaster Kubernetes:
- Zhvilluesit ndërveprojnë me klasterin tonë Kubernetes përmes CLI dhe ndërfaqes përdoruesit.
- Mjetet CLI / UI nxjerrin skedarët YAML të konfigurimit të fluksit të punës dhe pronësi të tjera të ndërtimit (të njëjtin identifikues versioni) nga Artifactory, dhe më pas i dërgojnë ato në Shërbimin e Dhënies së Punëve. Ky hap siguron që në klaster të dërgohen vetëm versionet funksionale.
- JSS është një portë për platforma të ndryshme, duke përfshirë Kubernetes. Këtu ndodh autentikimi i përdoruesit, dhënia e kuotave dhe verifikimi i pjesëmarrës i konfigurimit të CRD tonë.
- Pas verifikimit të CRD-së në anën e JSS-së, informacioni dërgohet në API-në e platformës k8s.
- Kontrollori ynë CRD ndjek ngjarjet në të gjitha burimet e përdoruesve. Ai shndërron CR në burime natyrale k8s, shton modulat e nevojshme, vendos variablat përkatëse të ambientit dhe realizon punë të tjera mbështetëse, duke garantuar për aplikacionet e përdoruesve të kontejnerëve mbështetje të mjaftueshme infrastrukturore.
- Më pas kontrollori CRD dërgon të dhënat e marra në API-në Kubernetes për t'u procesuar nga planifikuesi dhe për t'u nxjerrë në punë.
Shënim: ky ky ky ky ky ky ky ky ky ky ky ky ky ky ky ky. Tani jemi duke punuar për të përmirësuar këtë proces që të integrohemi plotësisht me CI/CD-në tonë të re. Kjo do të thotë se nuk mund të ndajmë të gjithë detajet e lidhura me Kubernetes. Jemi në pritje për të ndarë eksperiencën tonë dhe për të folur për përparimin e ekipit në këtë drejtim në postimin tonë të ardhshëm në blogun "Ndërtimi i një platforme CI/CD për Pinterest".
Llojet e burimeve speciale
Duke u bazuar në nevojat specifike të Pinterest, ne zhvilluam CRD-të e mëposhtme që përshtaten për procese të ndryshme pune:
- PinterestService është shërbimet stateless që funksionojnë prej kohësh. Shumë nga sistemet tona kryesore bazohen në një grup të tillë shërbimesh.
- PinterestJobSet modelon punët me cikël të plotë. Në Pinterest, ka një skenar të zakonshëm, ku disa punë nisin të njëjtat kontejnerë në mënyrë paralele, pa qenë e varur nga proceset e ngjashme.
- PinterestCronJob aplikohet gjerësisht për ngarkesa të vogla periodike. Kjo është një mbështetje për funksionimin natyror të cron me mekanizma mbështetje për Pinterest, të cilët janë përgjegjës për sigurinë, trafik, regjistrat dhe metrikat.
- PinterestDaemon përfshin daemonët e infrastrukturës. Ky grup vazhdon të rritet, ndërsa ne shtojmë mbështetje për klasteret tona.
- PinterestTrainingJob zgjerohet në proceset Tensorflow dhe Pytorch, duke ofruar të njëjtin nivel mbështetjeje gjatë funksionimit, ashtu si të gjitha CRD-të e tjera. Duke qenë se përdorim shumë Tensorflow dhe sisteme të tjera të të mësuarit të makinerive në Pinterest, na erdhi në ndihmë të ndërtosh një CRD të veçantë për to.
Gjithashtu po punojmë mbi PinterestStatefulSet, që së shpejti do të adaptohet për magazinat e të dhënave dhe sisteme të tjera stateful.
Mbështetje për mjedisin e ekzekutimit
Kur moduli i aplikacioneve starton në Kubernetes, ai merr automatikisht një certifikatë për identifikimin e tij. Kjo certifikatë përdoret për qasje në depo sekrete ose për komunikim me shërbime të tjera përmes mTLS. Ndërkohë, konfiguratori i inicializimit të konteinerëve dhe Daemon do të ngarkojnë të gjitha varësitë e nevojshme para se të nisin aplikacionin në konteiner. Kur gjithçka të jetë gati, sidecar i trafikut dhe Daemon do të regjistrojnë adresën IP të modulit në Zookeeper tonë, në mënyrë që klientët ta zbulojnë atë. Të gjitha këto do të funksionojnë, pasi moduli rrjetor ishte konfiguruar para nisjes së aplikacionit.
Më sipër janë disa shembuj tipikë të mbështetjes për ngarkesat gjatë ekzekutimit. Për lloje të tjera ngarkesash mund të nevojitet pak mbështetje ndryshe, por të gjitha ato paraqiten si sidecar në nivel pod, në nivel node ose Daemon në nivelin e makinave virtuale. Ne sigurohemi që gjithçka të jetë e implementuar brenda infrastrukturës menaxhuese dhe e harmonizuar mes aplikacioneve, gjë që në fund ul ndjeshëm ngarkesën në punët teknike dhe mbështetje për klientët.
Testimi dhe QA
Ne krijuam një pipeline testimi end-to-end mbi infrastrukturën ekzistuese të testimeve të Kubernetes. Këto teste shtrihen mbi të gjitha klasterët tanë. Pipeline ynë ka kaluar shumë riformatime para se të bëhet pjesë e klasterit të produktit.
Përveç sistemeve të testimit, ne kemi sisteme monitorimi dhe alarmi që ndjekin përhershëm gjendjen e komponentëve të sistemit, konsumimin e burimeve dhe tregues të tjerë të rëndësishëm, duke na njoftuar vetëm kur nevojitet ndërhyrja e njeriut.
Alternativat
Ne shqyrtuam disa alternativa të burimeve të personalizuara, siç janë kontrollet e aksesit dhe sistemet e shablloneve. Megjithatë, të gjitha ato lidhen me vështirësi të konsiderueshme, kështu që ne zgjodhëm të shkonim me rrugën e CRD.
Kontrolli mujor i lejes është përdorur për të futur sidecar, variablin e ambientit dhe mbështetje të tjera gjatë ekzekutimit. Megjithatë, ai hasi në probleme të ndryshme, siç janë lidhja e burimeve dhe menaxhimi i ciklit të jetës së tyre, ndryshe nga CRD që nuk ka këto probleme.
Vërejtje: Sistemat e shablloneve, si diagramet Helm, përdoren gjerësisht për të bërë lançime aplikacionesh me konfigurime të ngjashme. Megjithatë, aplikacionet tona të punës janë shumë të ndryshme për t'u menaxhuar përmes shablloneve. Gjithashtu, gjatë implementimit të vazhdueshëm duke përdorur shabllone, do të ketë shumë gabime.
Puna e ardhshme
Aktualisht po merremi me një ngarkesë të kombinuar në të gjitha klasteret tona. Për të mbështetur procese të tilla të llojeve dhe madhësive të ndryshme, ne punojmë në drejtimet e mëposhtme:
- Kombinimi i klastereve shpërndan aplikacione të mëdha në klastere të ndryshme për të siguruar shkallëzueshmërinë dhe stabilitetin.
- Të sigurojmë stabilitet, shkallëzim dhe dukshmëri të klasterit për të krijuar lidhjen midis aplikacionit dhe SLA-së së tij.
- Menaxhimi i burimeve dhe kuotave, në mënyrë që aplikacionet të mos përplasen ndërsjelltas, dhe shkalla e klasterit të kontrollohet nga ana jonë.
- Platforma e re CI/CD për mbështetje dhe shpërndarjen e aplikacioneve në Kubernetes.
Burimi: habr.com
