

Përshëndetje të gjithëve. Në këtë artikull do të flas për arsyet pse ne në Avito zgjodhëm Kafka nëntë muaj më parë, dhe çfarë përfaqëson ajo. Do të ndaj një nga rastet e përdorimit - broker mesazhesh. Dhe në fund, do të flasim për përfitimet që kemi marrë nga aplikimi i qasjes Kafka si Shërbim.
Problemi
Fillimisht, pak kontekst. Disa kohë më parë filluam të largoheshim nga arkitektura monolitike, dhe tani në Avito kemi disa qindra shërbime të ndryshme. Ato kanë depozitat e tyre, stakun e teknologjisë dhe përgjigjen për pjesën e tyre të logjikës së biznesit.
Një nga problemet me numrin e madh të shërbimeve është komunikimi. Shërbimi A shpesh dëshiron të dijë informacionin që ka shërbimi B. Në këtë rast, shërbimi A i drejtohet shërbimit B nëpërmjet një API-së sinkrone. Shërbimi B dëshiron të dijë se çfarë ndodh me shërbimet G dhe D, dhe ato, nga ana e tyre, interesohen për shërbimet A dhe B. Kur ka shumë shërbime 'kurioze', lidhjet mes tyre kthehen në një kaçubë të ngatërruar.
Megjithatë, në çdo moment shërbimi A mund të bëhet i papërshkueshëm. Çfarë duhet të bëjë shërbimi B dhe të gjithë shërbimet e tjera të lidhura me të në këtë rast? Dhe nëse për të realizuar një operacion biznesi duhet të kryhen një zinxhir thirrjesh sinkrone, probabiliteti i dështimit të tërë operacionit bëhet edhe më i lartë (dhe aq më i lartë sa më i gjatë të jetë ky zinxhir).
Zgjedhja e teknologjisë
Mirë, problemet janë të qarta. Ato mund të zgjidhen duke krijuar një sistem të centralizuar të shkëmbimit të mesazheve midis shërbimeve. Tani çdo shërbim duhet vetëm të dijë për këtë sistem shkëmbimi mesazhesh. Për më tepër, vetë sistemi duhet të jetë i qëndrueshëm ndaj parëveshjeve dhe në gjendje të shkallëzohet horizontalisht, si dhe, në rast të një defekti, të mbajë një tampon thirrjesh për përpunimin e mëvonshëm.
Tani le të zgjedhim teknologjinë në të cilën do të realizohet dorëzimi i mesazheve. Për këtë, së pari, le të kuptojmë çfarë presim nga ajo:
- mesazhet mes shërbimeve nuk duhet të humbasin;
- mesazhet mund të jenë të dyfishuara;
- mesazhet mund të ruhen dhe të lexohen për një thellësi prej disa ditësh (tampon i qëndrueshëm);
- shërbimet mund të regjistrohen për të dhënat që i interesojnë;
- disa shërbime mund të lexojnë të njëjtat të dhëna;
- mesazhet mund të përmbajnë një payload të detajuar dhe voluminoz (transfer i gjendjes së mbajtur nga ngjarjet);
- ndonjëherë nevojitet një garanci për rendin e mesazheve.
Po tërheqjes, ishte kritikisht e rëndësishme për ne të zgjidhnim një sistem sa më të shkallëzues dhe të besueshëm me kapacitet të lartë (të paktën 100k mesazhe për disa kilobajt në sekondë).
Në këtë fazë, ne u ndamë me RabbitMQ (e vështirë për ta mbajtur stabil në rps të larta), PGQ nga SkyTools (jo mjaft i shpejtë dhe i shkallëzueshëm) dhe NSQ (jo i përhershëm). Të gjitha këto teknologji përdoren në kompaninë tonë, por për detyrën e zgjidhur ato nuk ishin të përshtatshme.
Pastaj filluam të shqyrtonim teknologji të reja për ne — Apache Kafka, Apache Pulsar dhe NATS Streaming.
I pari që e përjashtuam ishte Pulsar. Ne vendosëm se Kafka dhe Pulsar janë zgjidhje mjaft të ngjashme. Pavarësisht se Pulsar është provuar nga kompani të mëdha, është më e re dhe ofron latencë më të ulët (në teori), ne vendosëm të mbetemi me Kafka si standart de facto për këto lloj detyrash. Ndoshta do t’i kthehemi Apache Pulsar në të ardhmen.
Dhe kështu mbetën dy kandidatët: NATS Streaming dhe Apache Kafka. Ne studiuam mjaft në detaje të dyja zgjidhjet, dhe të dyja ishin të përshtatshme për detyrë. Por në fund, ne u frikësuam nga rinia relative e NATS Streaming (dhe nga fakti se një nga zhvilluesit kryesorë, Tyler Treat, vendosi të largohet nga projekti dhe të fillojë të vetin — Liftbridge). Ndërkohë, modelet e Klasterizimit të NATS Streaming nuk ofronin mundësi të shkallëzimit horizontal të fuqishëm (ndoshta kjo nuk është më një problem pas shtimit të modeleve të ndarjes në 2017).
Megjithatë, NATS Streaming është një teknologji e shkëlqyer, e shkruar në Go dhe me mbështetje nga Cloud Native Computing Foundation. Ndryshe nga Apache Kafka, ajo nuk kërkon Zookeeper për të funksionuar (ndoshta, ), pasi brenda saj realizon RAFT. Në këtë mënyrë, NATS Streaming është më e lehtë për administrim. Ne nuk përjashtojmë që në të ardhmen mund të kthehemi përsëri tek kjo teknologji.
Sidoqoftë, deri më sot, fituesi ynë është Apache Kafka. Në testet tona, ajo tregoi se është mjaft e shpejtë (më shumë se një milion mesazhe në sekondë për lexim dhe shkrim me volum mesazhesh prej 1 kilobajt), mjaft e besueshme, e shkallëzueshme mirë dhe e provuar në prodhim nga kompani të mëdha. Për më tepër, Kafka mbështetet nga disa kompani komerciale të mëdha (ne, për shembull, përdorim versionin Confluent), dhe gjithashtu ka një ekosistem të zhvilluar.
Pasqyrë e Kafka
Para se të filloni, menjëherë do t'ju rekomandoj një libër të shkëlqyer — «Kafka: The Definitive Guide» (ka ka është edhe në përkthimin rus, por terminologjia është paksa e komplikuar). Aty mund të gjeni informacionin e nevojshëm për një kuptim bazik të Kafka-s dhe madje edhe më shumë. Dokumentacioni nga Apache dhe blogu nga Confluent gjithashtu janë shkruar në mënyrë të shkëlqyer dhe lehtë për t'u lexuar.
Pra, le ta shohim se si funksionon Kafka nga një perspektivë më e lartë. Topologjia bazike e Kafka-s përbëhet nga prodhuesi, konsumatori, brokeri dhe zookeeper.
Broker
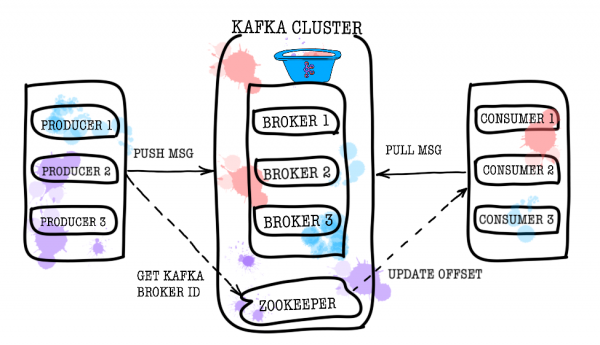
Brokeri është përgjegjës për ruajtjen e të dhënave tuaja. Të gjitha të dhënat ruhen në formë binare, dhe brokeri di pak për përmbajtjen dhe strukturën e tyre.
Çdo lloj logjik i ngjarjeve zakonisht ndodhet në një temë të veçantë (topic). Për shembull, ngjarja e krijimit të një njoftimi mund të shkojë në temën item.created, ndërsa ngjarja e ndryshimit të tij në item.changed. Temat mund të merren si klasifikues ngjarjesh. Në nivelin e temës, mund të caktohen parametra të tillë konfigurations si:
- vëllimi i të dhënave të ruajtura dhe/ose mosha e tyre (retention.bytes, retention.ms);
- faktori i redundancës së të dhënave (replication factor);
- madhësia maksimale e një mesazhi të vetëm (max.message.bytes);
- numri minimal i kopjeve të pajtueshme, në të cilat mund të shkruhen të dhëna në temë (min.insync.replicas);
- mundësia për të kaluar në një kopje të prapambetur të pa-sinkronizuar me humbje të mundshme të të dhënave (unclean.leader.election.enable);
- dhe shumë të tjera ().
Nga ana tjetër, çdo temë ndahet në një ose më shumë parti (partition). Pikërisht në parti përfundojnë ngjarjet. Nëse në klasër ka më shumë se një broker, partitë do të shpërndahen në të gjithë brokerët sa më shumë të jetë e mundur, që do t'i lejojë të shkallëzojnë ngarkesën për të shkruar dhe lexuar në një temë në të njëjtën kohë në disa brokerë.
Në disk, të dhënat për secilën parti ruhen si skedarë segmentesh, të barabarta me një gigabayt (kjo kontrollohet përmes log.segment.bytes). Një veçori e rëndësishme është se fshirja e të dhënave nga partitë (kur aktivizohet retention) ndodh pikërisht nëpërmjet segmenteve (nuk mund të fshihet një ngjarje e vetme nga një parti, por mund të fshihet vetëm një segment i tërë, dhe vetëm ai i pasivizuar).
Zookeeper
Zookeeper ka rolin e një depoje për metadatat dhe koordinatori. Ai mund të thotë nëse brokerët janë aktivë (mund ta shihni këtë nga këndvështrimi i zookeeper me komandën zookeeper-shell ls /brokers/ids), cili nga brokerët është kontrollues (get /controller), a janë pjesët në gjendje të sinkronizuar me replikat e tyre (get /brokers/topics/topic_name/partitions/partition_number/state). Po ashtu, fillimisht te zookeeper do të shkojnë prodhuesi dhe konsumatori, për të mësuar se në cilin broker cila tematika dhe pjesët ruhen. Në rastet kur për temën është caktuar një faktor replikimi më shumë se 1, zookeeper do të tregojë cilat pjesë janë lider (në to do të bëhet shkrimi dhe nga to do të bëhet edhe leximi). Në rastin e dështimit të brokerit, pikërisht te zookeeper do të regjistrohet informacioni mbi lider-pjesët e reja (nga versioni 1.1.0 asinkronisht, ).
Në versionet më të vjetra të Kafka, zookeeper ka ndihmuar gjithashtu në ruajtjen e offset-eve, por tani ato ruhen në një tematike speciale __consumer_offsets në broker (edhe pse ju mund të vazhdoni të përdorni zookeeper për këto qëllime).
Mënyra më e thjeshtë për të shndërruar të dhënat tuaja në një pumpë është pikërisht humbja e informacionit nga zookeeper. Në një skenar të tillë, do të jetë shumë e vështirë të kuptohet se çfarë dhe nga ku duhet të lexoni.
Producer
Prodhuesi është shpesh një shërbim që kryen shkrimin e drejtpërdrejtë të të dhënave në Apache Kafka. Prodhuesi zgjedh temën në të cilën do të ruhen mesazhet e tij tematike dhe fillon të shkruajë në të. Për shembull, një prodhues mund të jetë një shërbim shpalljesh. Në këtë rast, ai do të dërgojë në tematikat përkatëse ngjarje të tilla si "shpallje e krijuar", "shpallje e azhurnuar", "shpallje e fshirë" etj. Çdo ngjarje përfaqëson një çift çelës-vlerë.
Sipas parazgjedhjes, të gjitha ngjarjet shpërndahen nëpër pjesët e temës në mënyrë rrethore, nëse çelësi nuk është caktuar (duke humbur renditjen), dhe përmes MurmurHash (çelësi), nëse çelësi është i pranishëm (renditje brenda një pjese).
Këtu është e rëndësishme të theksohet se Kafka garanton rendin e ngjarjeve vetëm brenda një pjese. Por në të vërtetë, shpesh kjo nuk përbën një problem. Për shembull, mund të garantoni se të gjitha ndryshimet e një shpalljeje të njëjtë do të shtohen në një pjesë (duke ruajtur kështu rendin e këtyre ndryshimeve brenda shpalljes). Gjithashtu, mund të kaloni numrin radhës në një nga fushat e ngjarjes.
Consumer
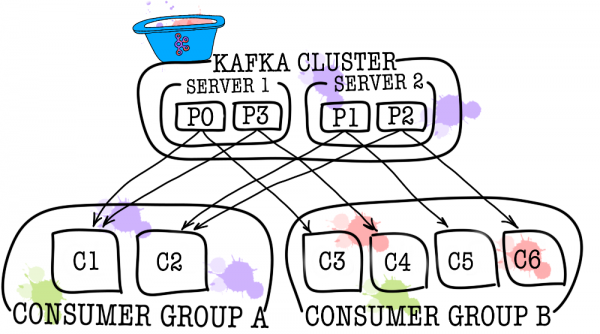
Konsumatori është përgjegjës për marrjen e të dhënave nga Apache Kafka. Nëse kthehemi te shembulli më sipër, konsumatori mund të jetë shërbimi i moderimit. Ky shërbim do të jetë i regjistruar në temën e shërbimit të shpalljeve, dhe kur një shpallje e re shfaqet, ai do ta marrë dhe do ta analizojë për t'u përputhur me disa politika të caktuara.
Apache Kafka mban mend, cilat janë ngjarjet më të fundit që ka marrë konsumatori (për këtë përdoret tema e shërbimit __consumer__offsets), duke garantuar në këtë mënyrë që pas një leximi të suksesshëm, konsumatori mos të marrë të njëjtën mesazh dy herë. Megjithatë, nëse përdoret opsioni enable.auto.commit = true dhe i jepet krejtësisht puna e ndjekjes së pozicionit të konsumatorit në temë Kafkës, atëherë mund të . Në kodin e prodhimit, më shpesh pozicioni i konsumatorit kontrollohet manualisht (programuesi menaxhon momentin kur duhet të ndodhi patjetër komitimi i ngjarjes së lexuar).
Në rastet kur një konsumator është i pamjaftueshëm (për shembull, kur fluksi i ngjarjeve të reja është shumë i madh), mund të shtohen disa konsumatorë të tjerë, duke i lidhur ata së bashku në një grup konsumatorësh. Grupi i konsumatorëve përfaqëson logjikisht një konsumator të njëjtë, por me shpërndarjen e të dhënave mes anëtarëve të grupit. Kjo i lejon çdo anëtari të marrë pjesën e tij të mesazheve, duke rritur kështu shpejtësinë e leximit.
Rezultatet e testimit
Këtu nuk do të shkruaj shumë tekst shpjegues, vetëm do të ndaj rezultatet e marra. Testimi u krye në 3 makina fizike (12 CPU, 384GB RAM, 15k SAS DISK, 10GBit/s Net), brokerat dhe zookeeper ishin instaluar në lxc.
Testimi i performancës
Gjatë testimit u arritën rezultatet e mëposhtme.
- Shpejtësia e shkrimit të mesazheve me madhësi 1KB në të njëjtën kohë nga 9 prodhuesit është 1300000 ngjarje në sekond.
- Shpejtësia e leximit të mesazheve me madhësi 1KB në të njëjtën kohë nga 9 konsumatorët është 1500000 ngjarje në sekond.
Testimi i qëndrueshmërisë
Gjatë testimit u arritën rezultatet e mëposhtme (3 brokerë, 3 zookeeper).
- Ndërprerja e papritur e një prej brokerëve nuk çon në ndalimin ose papërshtatshmërinë e klasterit. Puna vazhdon në mënyrë normale, por ngarkesa kalon te brokerët e mbetur.
- Mbyllja e jashtme e dy brokerëve në rastin e një klusteri me tre brokerë dhe min.isr = 2 çon në pamundësinë e shkruarjes në kluster, por klusteri mbetet i aksesueshëm për lexim. Nëse min.isr = 1, klusteri vazhdon të jetë i aksesueshëm si për lexim ashtu edhe për shkruarje. Megjithatë, ky mod është në kundërshtim me kërkesën për ruajtje të lartë të të dhënave.
- Mbyllja e jashtme e njërit prej serverëve Zookeeper nuk çon në ndalimin ose pamundësinë e klusterit. Puna vazhdon në mënyrë normale.
- Mbyllja e jashtme e dy serverëve Zookeeper çon në pamundësinë e klusterit deri në momentin kur një nga serverët Zookeeper rikthen funksionimin e tij. Ky pohim është i vërtetë për një kluster Zookeeper me 3 serverë. Si rezultat i hulumtimeve, u vendos të zgjeroheshin klustera Zookeeper në 5 serverë për të rritur qëndrueshmërinë.
Kafka si një shërbim
Ne u siguruam që Kafka është një teknologji e shkëlqyer, që na ndihmon të zgjidhim detyrën që kemi përpara (implementimin e brokerit të mesazheve). Megjithatë, vendosëm të ndalojmë shërbimet që të aksesojnë direkt Kafka dhe e mbyllëm atë ndërsa e përdorin shërbimin data-bus. Pse e bëmë këtë? Në të vërtetë ka disa arsye.
Data-bus mori përsipër të gjitha detyrat e lidhura me integrimin me Kafka (implementimi dhe konfigurimi i consumera dhe producera, monitorimi, alarmin, regjistrimi, shkallëzimi, etj.). Në këtë mënyrë, integrimi me brokerin e mesazheve ndodh në mënyrën më të thjeshtë.
Data-bus na mundësoi të abstenojmë nga gjuha ose biblioteka specifike për të punuar me Kafka.
Data-bus u mundësoi shërbimeve të tjera të abstenojmë nga shtresa e ruajtjes. Ndoshta, në një moment, ne do të zëvendësojmë Kafka me Pulsar, dhe askush nuk do ta vërejë këtë (të gjitha shërbimet dinë vetëm për API-në e data-bus).
Data-bus mori përsipër validimin e skemave të ngjarjeve.
Me ndihmën e data-bus është realizuar autentifikimi.
Nën mbulimin e data-bus ne mund të përditësojmë versionet e Kafka pa ndalim, në mënyrë të padukshme, dhe të menaxhojmë centralizuar konfigurimet e producerëve, consumerëve, brokerëve, etj.
Data-bus na mundësoi të shtojmë funksionalitetet e nevojshme që nuk i kemi në Kafka (siç janë auditimi i temave, kontrolli për anomalitë në kluster, krijimi i DLQ, etj.).
Data-bus lejon realizimin e failover-it centralizuar për të gjitha shërbimet.
Aktualisht, për të filluar dërgimin e ngjarjeve në brokerin e mesazheve, mjafton të lidheni një librari të vogël në kodin e shërbimit tuaj. Kjo është e gjitha. Ju krijohet mundësia të shkruani, të lexoni dhe të shkallëzoni me një rresht kodi. E gjithë implementimi është i fshehur nga ju; jashtë duken vetëm disa doreza si madhësia e grupit. Nën kapak, shërbimi data-bus ngre në Kubernetes numrin e nevojshëm të instancave të prodhuesve dhe konsumatorëve dhe u vendos atyre konfigurimin e nevojshëm, por e gjithë kjo është transparente për shërbimin tuaj.
Sigurisht, nuk ka një zgjidhje të artë, dhe ky qasje ka kufizimet e veta.
- Data-bus duhet të mbështetet nga forcat tuaja, ndryshe nga libraritë e treta.
- Data-bus rrit numrin e ndërveprimeve midis shërbimeve dhe brokerit të mesazheve, gjë që çon në uljen e performancës krahasuar me Kafka-n e papërpunuar.
- Nuk gjithçka mund të fshihet kaq lehtë nga shërbimet, nuk dëshirojmë të kopjojmë funksionalitetin e KSQL ose të Kafka Streams në data-bus, prandaj ndonjëherë na nevojitet të lejojmë shërbimet të shkojnë drejtpërdrejt.
Në rastin tonë, përfitimet e kaluan disavantazhet dhe vendimi për të mbuluar brokerin e mesazheve me një shërbim të veçantë u justifikua. Gjatë një viti të përdorimit, nuk patëm asnjë aksident apo problem serioz.
P.S. Faleminderit të dashurës sime, Ekaterina Obalayeva, për ilustrimet e mrekullueshme në këtë artikull. Nëse ju pëlqyen, do të gjejmë edhe më shumë ilustrime.
Burimi: habr.com
