

Pra, po mbledhni metrika. Ashtu si ne. Ne gjithashtu mbledhim metrika. Sigurisht, ato të nevojshme për biznesin. Sot do të flasim për lidhjen e parë të sistemit tonë të monitorimit — serverin e agregatës që është në përputhje me statsd , përse e shkruam atë dhe pse hoqëm dorë nga brubeck.
Nga artikujt tanë të mëparshëm (, ) mund të mësoni se deri në një moment të caktuar ne mbledhim etiketat duke përdorur . Ai është shkruar në C. Nga pikëpamja e kodit — i thjeshtë si një kork (kjo është e rëndësishme, kur dëshironi të kontribuoni) dhe, më e rëndësishmja, përballon pa ndonjë problem volume tona prej 2 milion metrike në sekondë (MPS) në kulm. Dokumentacioni deklaron mbështetje për 4 milion MPS me një yll. Kjo do të thotë se numri i deklaruar do të merrni, nëse e konfiguroni drejt rrjetin në Linux. (Sa MPS mund të merrni, nëse e lini rrjetin siç është, nuk e dimë). Pavarësisht këtyre avantazheve, ne kishim disa ankesat serioze lidhur me brubeck.
Ankesa 1. Github — zhvilluesi i projektit — e ndali mbështetje atë: të publikojmë patch-e dhe rregullime, të pranojmë PR-të tona dhe (jo vetëm tonat). Në muajt e fundit (diku që nga shkurt-marsi 2018) aktiviteti rinisi, por para kësaj kishte pothuajse 2 vjet qetësi të plotë. Për më tepër, projekti po zhvillohet , që mund të bëhet një pengesë e madhe për implementimin e mundësive të reja.
Ankesa 2. Saktësia e llogaritjeve. Brubeck mbledh vetëm 65536 vlera për agregim. Në rastin tonë, për disa metrika gjatë periudhës së agregimit (30 sekonda) mund të vijnë shumë më shumë vlera (1 527 392 në kulm). Si rezultat i këtij kampioni, vlerat e maksimumeve dhe minimaleve duken të padobishme. Për shembull, ja kështu:
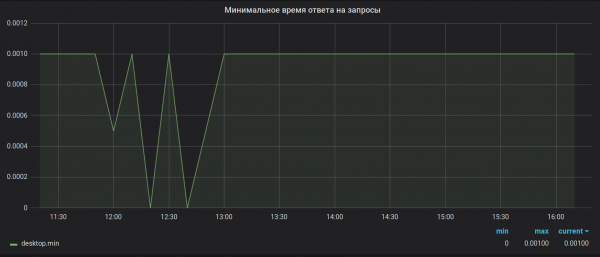
Si ishte
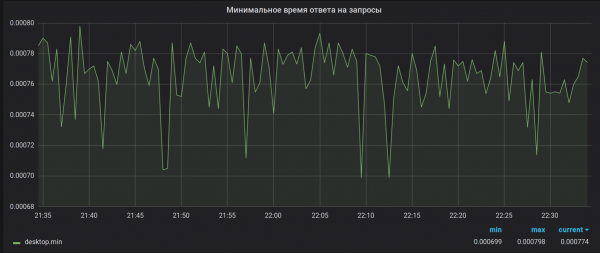
Si duhej të ishte
Për të njëjtën arsye, shumat llogariten krejtësisht të papërshtatshme. Shtoni këtu një bug me mbushjen e float-it 32-bit, i cili dërgon serverin në segfault kur merr një metrikë që duket e pafajshme, dhe bëhet krejtësisht e shkëlqyer. Ky bug, për më tepër, nuk është rregulluar ende.
Dhe, në fund, Ankesa X. Në momentin e shkruarjes së këtij artikulli, jemi të gatshëm të paraqesim të gjitha 14 implementimet më shumë ose më pak funksionale të statsd që arritëm të gjejmë. Le të imagjinojmë se ndonjë infrastrukturë e veçantë është rritur aq shumë sa që pranimet prej 4 milion MPS nuk janë më të mjaftueshme. Ose ndoshta nuk është rritur ende, por metrikat për ju janë aq të rëndësishme sa që edhe ndërprerje të shkurtra, 2-3 minuta në grafikë, mund të bëhen kritike dhe të shkaktojnë episode të pashmangshme depresioni te menaxherët. Duke qenë se trajtimi i depresionit është një punë e falenderueshme, janë të nevojshme zgjidhje teknike.
Së pari, qëndrueshmëria për të shmangur një problem të papritur në server që të mos shkaktojë një apokalips zombi në zyrë. Së dyti, shkallëzimi për të marrë mundësinë të pranojmë më shumë se 4 milion MPS, pa nxjerrë me thellësi në stakun e rrjetit Linux dhe duke u zgjeruar qetësisht deri në përmasat e nevojshme.
Duke qenë se kishte hapësirë për shkallëzim, vendosëm të fillonim me qëndrueshmërinë. "Oh! Qëndrueshmëria! Kjo është e thjeshtë, ne e dimë të bëjmë", menduam dhe aktivizuam 2 servera, duke ngritur në çdo server një kopje të brubeck. Për këtë na duhej të kopjonim trafikun me metrikat në të dy serverat dhe madje të shkruanim për këtë . Problemin e qëndrueshmërisë e zgjidhëm kështu, por... jo shumë mirë. Në fillim, gjithçka dukej mjaft në rregull: çdo brubeck mbledh versionin e tij të agregimit, shkruan të dhënat në Graphite çdo 30 sekonda, duke riparuar intervalin e vjetër (kjo bëhet në anën e Graphite). Nëse ndonjëherë një server dështon, ne gjithmonë kemi një të dytë me një kopje të vetë të dhënave të agreguara. Por ja problemi: nëse serveri dështon, në grafikë shfaqet "shkalla serratuar". Kjo ndodh sepse intervalet 30 sekondëshe të brubeck nuk janë të sinkronizuara, dhe në momentin e rënies një nga ato nuk riparon. Në momentin e aktivizimit të serverit të dytë ndodh e njëjta gjë. Mjaft e përballueshme, por dëshirojmë më mirë! Problemi i shkallëzueshmërisë gjithashtu nuk është zhdukur. Të gjitha metrikat vazhdojnë të "fluturojnë" në një server të vetëm, dhe prandaj jemi të kufizuar në të njëjtat 2-4 milion MPS varësisht nga përmirësimi i rrjetit.
Nëse mendojmë pak për problemin dhe njëkohësisht gërmojmë në borë me një bajonete, na vjen në mendje një ide kaq e qartë: na nevojitet një statsd që punon në një mod të shpërndarë. Kështu, një që implementon sinkronizimin midis nyjeve sipas kohës dhe metrikeve. "Sigurisht, një zgjidhje e tillë padyshim që ekziston", thamë ne dhe shkuam të kërkojmë në Google... dhe nuk gjetëm asgjë. Pas një shqyrtimi të dokumentacionit për statsd të ndryshme ( në datën 11.12.2017), nuk gjetëm asgjë. Duket se as zhvilluesit as përdoruesit e këtyre zgjidhjeve deri tani nuk janë përballur me një KAQ shumë metrikash, ndryshe ata do të kishin përcaktuar diçka.
Dhe këtu na erdhën në mendje statsd 'loja' - bioyino, që e kishim shkruar në hackathon thjesht për argëtim (emri i projektit ishte gjeneruar nga një skript para se të fillonte hackathon) dhe kuptuam se na nevojitet urgjentisht një statsd i vet. Pse?
- sepse në botë ka shumë pak klone statsd,
- sepse mund të sigurojmë qëndrueshmëri dhe shkallëzim të dëshirueshëm ose të afërt me të dëshiruarin (përfshirë sinkronizimin e metrikave të agreguara midis serverëve dhe zgjidhjen e problemeve të konflikteve gjatë dërgimit),
- sepse mund të llogarisim metrikat më saktë se çfarë bën brubeck,
- sepse mund të mbledhim vetë statistika më të detajuara, të cilat brubeck nuk na i ofronte pothuajse fare,
- sepse na u dha mundësia të programojmë aplikacionin tonë të shpërndarë me performancë të lartë, i cili nuk do të ishte një kopje e plotë e arkitekturës së një aplikacioni tjetër të tillë hyperfor... nuviponeli.
Në çfarë të shkruajmë? Sigurisht, në Rust. Pse?
- sepse tashmë kishte një prototip zgjidhjeje,
- sepse autori i këtij artikulli atëherë e dinte Rust dhe donte të shkruante diçka për prodhim me mundësinë e publikimit në open-source,
- sepse gjuhët me GC nuk na përshtaten për shkak të natyrës së trafikut që merrnim (praktikisht realtime) dhe pauzat e GC janë pothuajse të papranueshme,
- sepse na nevojitet performancë maksimale, krahasueshme me C
- sepse Rust na ofron një konkurencë pa frikë, dhe nëse do të fillonim ta shkruanim këtë në C/C++, do të kishim më shumë, shumë më tepër, siç ishim me brubeck, dobësi, mbushje të bufferëve, race conditions dhe fjalë të tjera të frikshme.
I had an argument against Rust. The company lacked experience in creating projects with Rust, and we currently do not plan to use it in our main project. Therefore, there were serious concerns that it might not work out, but we decided to take the risk and give it a try.
Time went on…
Finally, after several unsuccessful attempts, the first working version was ready. What did we get? We got something like this.
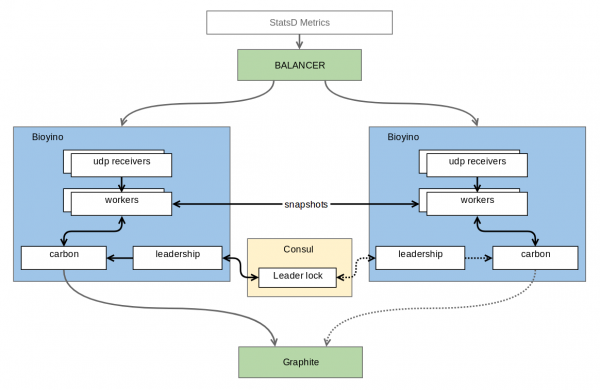
Each node receives its own set of metrics and accumulates them without aggregating metrics for those types where their complete set is required for final aggregation. The nodes are interconnected by a distributed lock protocol, which allows selecting among them the one and only (here we cried) that is worthy of sending metrics to The Great. Currently, this issue is being addressed using , but in the future, the author's ambitions extend to Raft, where that very worthy one will undoubtedly be the consensus leader node. Besides consensus, nodes very often (by default once a second) send their neighbors the parts of the pre-aggregated metrics that managed to be gathered during that second. Thus, scalability and fault tolerance are maintained — each of the nodes still holds the complete set of metrics, but the metrics are now sent aggregated, over TCP and encoded in a binary protocol, significantly reducing the duplication costs compared to UDP. Despite a fairly large number of incoming metrics, accumulation requires very little memory and even less CPU. For our well-compressible metrics, this amounts to just a few tens of megabytes of data. An additional bonus is the absence of unnecessary data rewrites in Graphite, unlike what occurred with burbeck.
UDP paketet me metrike janë disbalancuar midis nyjeve në pajisjet rrjetit përmes një Round Robin të thjeshtë. Natyrisht, aparatet rrjetore nuk analizojnë përmbajtjen e paketave dhe prandaj mund të përballojnë shumë më tepër se 4M paketa në sekondë, për të mos përmendur metrikat, për të cilat ato nuk dinë asgjë. Duke marrë parasysh se metrikat vijnë jo vetëm një në çdo paketë, nuk parashikojmë probleme me performancën këtu. Në rast të rënies së serverit, pajisja rrjetore e zbulon atë shpejt (brenda 1-2 sekondash) dhe e heq serverin që ka rënë nga rotacioni. Si rezultat, nyjet pasive (t.e. ato që nuk janë lider) mund të aktivizohen dhe deaktivizohen pothuajse pa vënë re rëniet në grafikë. Maksimumi që humbasim — është një pjesë e metrikave që kanë ardhur për sekondën e fundit. Humbja e papritur / çaktivizimi / kalimi i liderit do të tërheqë gjithnjë një anomalie të vogël (intervali 30-sekondësh është ende i asinkronizuar), por nëse ka lidhje mes nyjeve, këto probleme mund të minimizohen, për shembull, duke dërguar paketat e sinkronizimit.
Pak rreth strukturës së brendshme. Aplikacioni, natyrisht, është me shumë线程, por arkitektura e threadave ndryshon nga ajo që përdoret në brubeck. Threadat në brubeck janë të njëjtë — çdo një prej tyre përgjigjet njëkohësisht për mbledhjen e informacionit dhe për agregimin. Në bioyino, threadat e punës (workers) janë të ndarë në dy grupe: përgjegjës për rrjetin dhe përgjegjës për agregimin. Kjo ndarje e lejon menaxhimin më fleksibël të aplikacionit në varësi të llojit të metrikave: aty ku kërkohet një agregim intensiv, mund të shtojmë agregatorë, aty ku ka shumë trafik rrjeti — mund të rrisim numrin e threadave rrjetorë. Momentalisht, në serverët tanë po punojmë me 8 threadat rrjetorë dhe 4 threadat agregues.
Pjesa llogaritëse (përgjegjëse për agregimin) është mjaft e mërzitshme. Bufrat e mbushur me threadat rrjetorë shpërndahen ndërmjet threadave llogaritës, ku më pas përpunohen dhe agregohen. Në kërkesë, metrikat dërgohen për t'u dërguar në nyje të tjera. E gjithë kjo, duke përfshirë dërgimin e të dhënave midis nyjeve dhe punën me Consul, kryhet asinkronisht, duke punuar mbi frameworkun .
Çdo problem më të madh gjatë zhvillimit e shkaktoi pjesa rrjetore, e cila ishte përgjegjëse për pranimin e metrikave. Qëllimi kryesor i ndarjes së rrjedhave rrjetore në entitete të veçanta ishte të zvogëlohej koha që rrjedha shpenzon jo në leximin e të dhënave nga socket. Opsionet që përdorin UDP asinkron dhe recvmsg të zakonshëm u hodhën shpejt: e para konsumon shumë CPU në hapësirën e përdoruesit për përpunimin e ngjarjeve, e dyta — shumë ndërrime konteksti. Prandaj tani përdoret me bufe të mëdha (dhe buferat, zotërinj oficerë, nuk janë çështje e zakontë!). Mbështetje për UDP të zakonshëm është lënë për raste të papërgjegjshme, kur nuk ka nevojë për recvmmsg. Në modin multimessage arrijmë të arrihet e madhja: shumica dërrmuese e kohës rrjedha rrjetore pastron radhën e OS — lexon të dhënat nga socket dhe i zhvendos ato në buferin e hapësirës së përdoruesit, vetëm ndonjëherë duke kaluar për të dhënë buferin e mbushur agregatorëve. Radhët në socket praktikisht nuk grumbullohen, numri i paketimeve të hedhura praktikisht nuk rritet.
Shënim
Në cilësimet e paracaktuara, madhësia e buferit është caktuar mjaft e madhe. Nëse papritur vendosni të provoni serverin vetë, ndoshta do të përballeni me faktin që pas dërgimit të një sasie të vogël metrike, ato nuk do të arrijnë në Graphite, duke mbetur në buferin e rrjedhës rrjetore. Për të punuar me një numër të vogël metrike, duhet të caktohet në konfigurim vlera më të vogla për bufsize dhe task-queue-size.
Në fund — disa grafika për ata që i pëlqejnë grafikat.
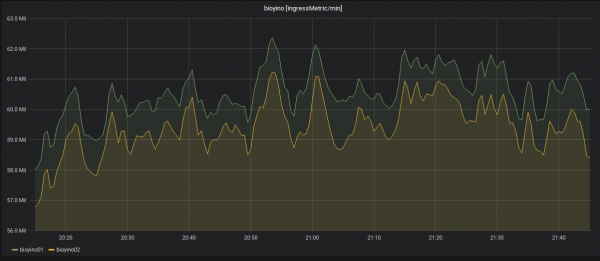
Statistika e numrit të metrikave në hyrje për secilin server: më shumë se 2 milion MPS.
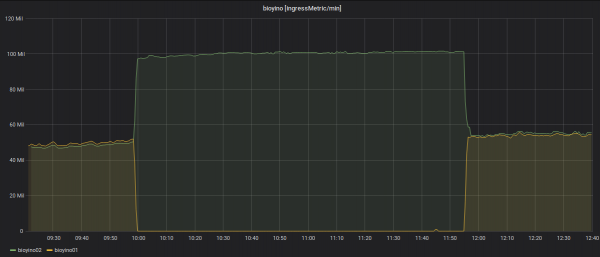
Çaktivizimi i njërit nga nodet dhe riparimi i metrikave në hyrje.
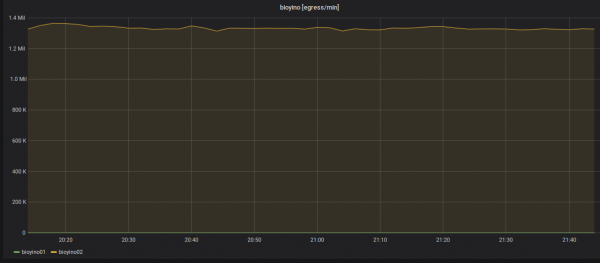
Statistika për metrikat në dalje: gjithmonë dërgohet vetëm një nod — raidboss.
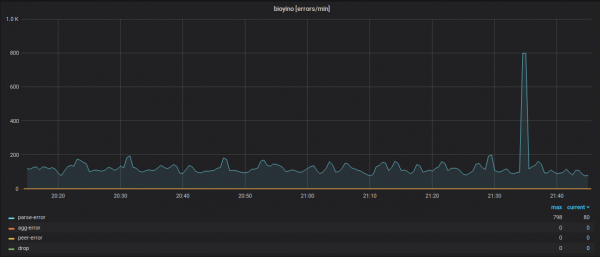
Statistika e punës së secilit nod duke marrë parasysh gabimet në modulet e ndryshme të sistemit.
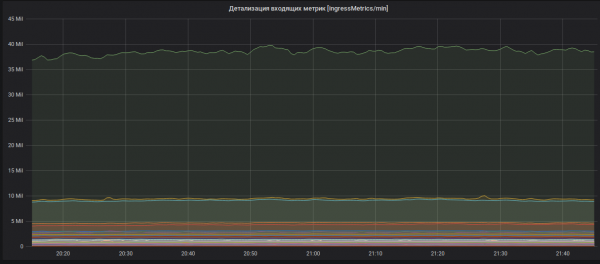
Detajet e metrikave në hyrje (emrat e metrikave janë të fshehur).
Çfarë planifikojmë të bëjmë më tej me të gjitha këto? Sigurisht që do të shkruajmë kod, bl…! Projekti fillimisht ishte planifikuar si open-source dhe do të mbetet i tillë gjatë gjithë jetës së tij. Në planet e afërta — kalimi në versionin tonë të Raft, ndërrimi i protokollit peer në një më të portueshëm, futja e statistikave të brendshme të mëtejshme, tipe të reja metrikash, rregullimi i gabimeve dhe përmirësime të tjera.
Sigurisht, të gjithë ata që duan të ndihmojnë në zhvillimin e projektit janë të mirëpritur: krijoni PR, Issues, dhe ne do të mundohemi të përgjigjemi dhe të punojmë më shumë kur të jetë e mundur.
Me këtë, siç thonë, kjo është gjithçka, blini elefantët tanë!
Burimi: habr.com
