

Sot në projektin tonë, përveç kodit monolitik, funksionojnë dhjetëra mikrosisteme. Çdo njëri prej tyre kërkon monitorim. Të bësh këtë në një masë të tillë me forcat e inxhinierëve DevOps është problematike. Ne kemi zhvilluar një sistem monitorimi që funksionon si shërbim për zhvilluesit. Ata mund të shkruajnë metrika në sistemin e monitorimit, t'i përdorin ato, të ndërtojnë panele mbi bazën e tyre, të lidhin alerte që do të aktivizohen kur arrihen përcaktimet e caktuara. Prej inxhinierëve DevOps — vetëm infrastruktura dhe dokumentacioni.
Ky post është një transkriptim i fjalimit tim nga në RIT++. Shumë na kërkuan të bëjmë versione tekstuale të raportimeve nga aty. Nëse ishit në konferencë ose e shihnit videon, nuk do të gjeni asgjë të re. Ndërsa të tjerët — mirë se erdhët poshtë. Do t'ju tregoj si arritëm në një sistem të tillë, si funksionon dhe si e planifikojmë për ta përmirësuar.
E kaluara: skemat dhe planet
Si arritëm në sistemin ekzistues të monitorimit? Për të përgjigjur në këtë pyetje, duhet të shkojmë në vitin 2015. Kështu dukej atëherë:
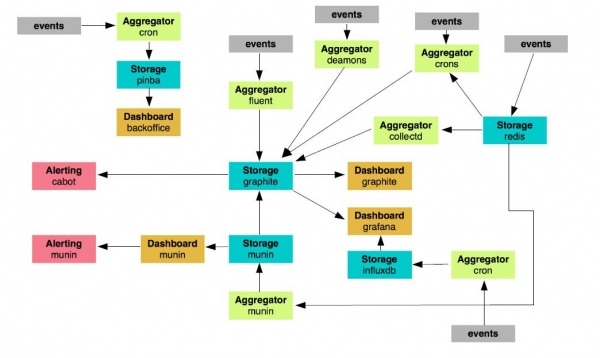
Kishim rreth 24 nodë që ishin përgjegjës për monitorimin. Këtu ka një grumbull të madh kroneve, skriptesh, demonësh, që monitorojnë diçka diku, dërgojnë mesazhe, dhe përmbushin funksione. Menduam se sa më shumë të shkonim përpara, aq më pak do të jetë e qëndrueshme një sistem i tillë. Nuk kishte kuptim ta zhvillonim atë: ishte shumë ngarkuese.
Vendosëm të zgjedhim ato elemente të monitorimit që do të mbeteshim dhe do t'i zhvillonim, dhe ato që do të heqnim dorë prej tyre. U dukën 19. Mbetën vetëm grafitët, agregatorët dhe Grafana si panel. Por si do të dukej sistemi i ri? Ja kështu:
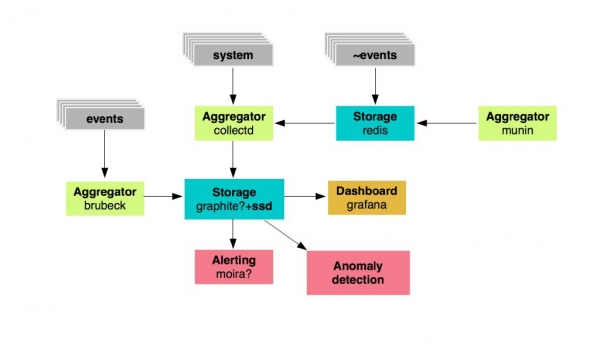
Kemi një depo të metrikave: këto janë grafitët, të cilat do të bazohen në SSD të shpejtë, dhe disa agregatorë për metrikat. Më pas — Grafana për shfaqjen e paneleve dhe Moira për alarmin. Po ashtu, donim të zhvillonim një sistem për gjetjen e anomalive.
Standart: Monitorimi 2.0
Kështu dukej plani në vitin 2015. Por na duhej të përgatitnim jo vetëm infrastrukturën dhe shërbimin vetë, por edhe dokumentacionin për të. Ne zhvilluam një standart korporativ, të quajtur monitorimi 2.0. Cilat ishin kërkesat për sistemin?
- disponueshmëri të vazhdueshme;
- intervali i ruajtjes së metrikave = 10 sekonda;
- ruajtja e strukturuar e metrikave dhe panelëve;
- SLA > 99,99%
- mbledhja e metrikave të ngjarjeve përmes UDP (!).
Na duhej UDP, sepse kemi një fluks të madh trafiku dhe ngjarjesh që gjenerojnë metrika. Nëse i shkruajmë të gjitha menjëherë në Graphite, depoja do të bjerë. Gjithashtu, zgjodhëm parafikat e nivelit të parë për të gjitha metrikat.
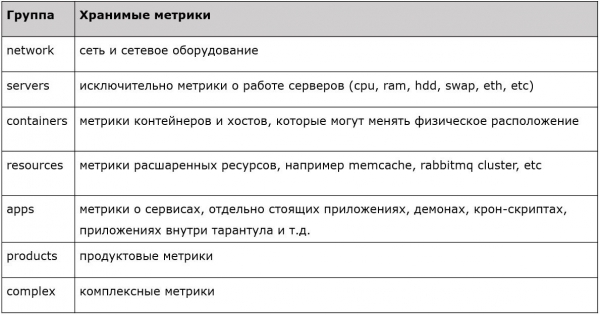
Çdo parafik ka një pronësitë të caktuar. Ka metrika për serverët, rrjetet, kontejnerët, burimet, aplikacionet dhe kështu me radhë. Është realizuar një filtrim i qartë, tërësor, tipizuar, ku pranojmë metrikat e nivelit të parë, ndërsa të tjerat thjesht i heqim. Kështu e planifikuam këtë sistem në vitin 2015. Çfarë ndodhi tani?
E tashmja: skema e bashkëpunimit të komponenteve të monitorimit
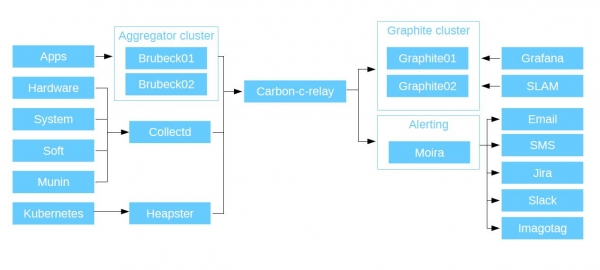
Në radhë të parë, ne monitorojmë aplikacionet: kodin tonë PHP, aplikacionet dhe mikroshërbimet - në një fjalë, gjithçka që shkruajnë zhvilluesit tanë. Të gjitha aplikacionet dërgojnë metrika në agregatorin Brubeck (statsd, e shkruar në C) përmes UDP. Ai rezultoi të ishte më i shpejti në përfundimet e testeve sintetikë. Dhe ai dërgon metrikat e agreguara në Graphite përmes TCP.
Ai ka një lloj metrikash, siç janë timerët. Kjo është një gjë shumë e dobishme. Për shembull, për çdo lidhje të përdoruesit me shërbimin, ju dërgoni në Brubeck një metrikë me kohën e përgjigjes. Erdhën një milion përgjigje, ndërsa agregatori dha vetëm 10 metrika. Keni numrin e njerëzve që erdhën, kohën maksimale, minimale dhe mesatare të përgjigjes, median dhe 4 percentilat. Më pas të dhënat dërgohen në Graphite dhe ne i shohim të gjitha në kohë reale.
Ne kemi gjithashtu agregimin e metrikave për harduerin, softuerin, metrikat sistemike dhe sistemin tonë të vjetër të monitorimit Munin (që ka funksionuar deri në vitin 2015). Të gjitha këto i mbledhim përmes demonit CollectD, i cili përmban një mori plugins të ndryshme; ai mund të anketojë të gjitha burimet e sistemit host në të cilin është instaluar, thjesht trego në konfigurim se ku të shkruash të dhënat dhe i dërgon ato në Graphite. Ai gjithashtu mbështet plugins python dhe skriptet shell, kështu që mund të shkruani zgjidhje të personalizuara: CollectD do të mbledhë këto të dhëna nga një host lokal ose të largët (le të supozojmë se ka Curl) dhe do t'i dërgojë ato në Graphite.
Pastajmë metrikat e grumbulluara dërgojmë në Carbon-c-relay. Ky është një zgjidhje Carbon Relay nga Graphite, e përmirësuar në C. Ky është një router që mbledh të gjitha metrikat që dërgojmë nga agregatorët tanë dhe i drejton ato në nodet. Po ashtu, gjatë fazës së drejtimit ai kontrollon vlefshmërinë e metrikave. Së pari, ato duhet të përputhen me skemën e prefikseve që tregova më herët dhe, së dyti, të jenë të vlefshme për Graphite. Nëse jo, ato eliminohen.
Më pas, Carbon-c-relay dërgon metrikat në klasterin Graphite. Ne përdorim si ruajtjen kryesore të metrikave Carbon-cache, të rishtypura në Go. Go-carbon, për shkak të multithread-it, tejkalon shumë performancën e Carbon-cache. Ai pranon të dhënat dhe i shkruan ato në disqe me ndihmën e paketës whisper (standarde, e shkruar në python). Për të lexuar të dhënat nga ruajtjet tona, përdorim Graphite API. Ai punon shumë më shpejt se sa Graphite WEB standard. Çfarë ndodh më pas me të dhënat?
Ato shkojnë në Grafana. Si burimi kryesor i të dhënave përdorim klasteret tona të Graphite-it, plus kemi Grafana si ndërfaqe në web për shfaqjen e metrikave dhe ndërtimin e dashboard-ëve. Çdo zhvillues krijon dashboard-in e tij për shërbimet e veta. Më pas ata ndërtojnë grafike sipas tyre, në të cilat shfaqen metrikat që ata dërgojnë nga aplikacionet e tyre. Përveç Grafana kemi edhe SLAM. Ky është një demon python-i që llogarit SLA-në mbi bazën e të dhënave nga Graphite. Siç e thashë, kemi disa dhjetëra mikrosisteme, secili me kërkesat e veta. Me ndihmën e SLAM shkojmë në dokumentacion dhe e krahasojmë atë me atë që ka Graphite dhe shikojmë sa përputhen kërkesat me disponibilitetin e shërbimeve tona.
Shkojmë përpara: alerimi. Ai është organizuar me një sistem të fuqishëm - Moira. Ajo është e pavarur sepse nën kapak ka Graphite-n e saj. E zhvilluar nga djemtë në SKB "Kontur", e shkruar në python dhe Go, plotësisht open-source. Moira merr të njëjtin flux të të dhënave që shkon në Graphite. Nëse për ndonjë arsye ruajtja juaj dështon, alerimi juaj do të funksionojë.
Ne ushtruam Moira në Kubernetes, duke përdorur një grup serverësh Redis si bazën e saj kryesore të të dhënave. Si rezultat, u krijua një sistem me qëndrueshmëri të lartë. Ajo krahasohet me fluxin e metrikeve me listën e triggereve: nëse nuk ka përmendje, ajo e hedh jashtë metrikën. Kështu ajo është në gjendje të procesojë gigabajt të metrikave në minutë.
Gjithashtu, ne e lidhëm atë me LDAP-in e korporatës, me anë të të cilit çdo përdorues i sistemit korporativ mund të krijojë njoftime për triggere ekzistuese (ose të sapokrijuara). Pasi Moira përmban Graphite, ajo mbështet të gjitha funksionet e tij. Prandaj, filloni duke marrë një rresht dhe duke e kopjuar atë në Grafana. Shikoni si paraqiten të dhënat në grafika. Pastaj merrni të njëjtin rresht dhe kopjoni atë në Moira. Shtoni kufij dhe merrni alarmin në përfundim. Për të bërë gjithçka këtë, ju nuk keni nevojë për njohuri specifike. Moira mund të japë alarme përmes SMS, email, në Jira, Slack... Ajo mbështet gjithashtu ekzekutimin e skripteve të zakonshme. Kur ndodh një trigger dhe ajo është e regjistruar në një skript të zakonshëm ose një binar, e ekzekuton atë dhe ia jep në stdin këtij binari JSON. Pra, programi juaj duhet ta analizojë atë. Çfarë do të bëni me këtë JSON, vendosni vetë. Nëse dëshironi, dërgojini në Telegram, nëse dëshironi, hapni detyra në Jira, bëni çfarë të doni.
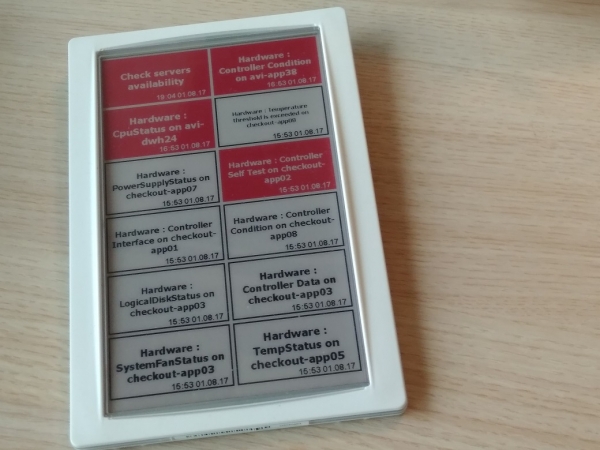
Për alarmin përdorim gjithashtu një zhvillim të vetin — Imagotag. Ne e përshtatëm panelin që zakonisht përdoret për etiketat elektronike në dyqane për detyrat tona. Ne e nxorëm triggere nga Moira në të. Aty shfaqet në cilin gjendje janë ato dhe kur ndodhi. Disa nga ekipi i zhvillimit u tërhoqën nga njoftimet në Slack dhe e-mail në favor të këtij paneli.
Dhe duke qenë se jemi një kompani progresive, ne kemi monitoruar gjithashtu Kubernetes në këtë sistem. E kemi përfshirë në sistem përmes Heapster, të cilin e kemi instaluar në grup, ai mbledh të dhëna dhe i dërgon në Graphite. Si rezultat, skema duket kështu:
Komponentët e monitorimit
Këtu është lista e linkeve për komponentët që përdorëm për këtë detyrë. Të gjithë ata janë me burim të hapur.
Graphite:
- go-carbon:
- whisper:
- graphite-api:
Carbon-c-relay:
Brubeck:
Collectd:
Moira:
Grafana:
Heapster:
Statistika
Dhekë disa shifra për mënyrën se si sistemi funksionon tek ne.
Aggregator (brubeck)
Numri i metrikave: ~ 300 000 / sec
Intervali i dërgimit të metrikave në Graphite: 30 sec
Përdorimi i resurseve të serverit: ~ 6% CPU (bëhet fjalë për serverë të plotë); ~ 1Gb RAM; ~ 3 Mbps LAN
Graphite (go-carbon)
Numri i metrikave: ~ 1 600 000 / min
Intervali i përditësimit të metrikave: 30 sec
Skema e ruajtjes së metrikave: 30sec 35d, 5min 90d, 10min 365d (jep një kuptim për atë që ndodh me shërbimin për një periudhë të gjatë kohore)
Përdorimi i resurseve të serverit: ~ 10% CPU; ~ 20Gb RAM; ~ 30 Mbps LAN
Fleksibiliteti
Ne në Avito e vlerësojmë shumë fleksibilitetin në shërbimin tonë të monitorimit. Pse e realizuam këtë? Së pari, komponentët e tij janë të zëvendësueshëm: si vetë komponentët ashtu edhe versionet e tyre. Së dyti — mbështetshmëria. Duke qenë se projekti është ndërtuar në open source, ju mund të rregulloni kodin, të bëni ndryshime, të realizoni funksione që nuk janë të disponueshme nga kutia. Përdoren steka mjaft të zakonshëm, kryesisht Go dhe Python, prandaj kjo bëhet mjaft e thjeshtë.
Ja një shembull i një problemi real që ka lindur. Një metrikë në Graphite — është një skedar. Ajo ka një emër. Emri i skedarit = emri i metrikës. Dhe ka një rrugë deri tek ai. Emrat e skedarëve në Linux janë të kufizuar në 255 karaktere. Ndërsa ne kemi (si “porosi të brendshme”) djemtë nga departamenti i bazave të të dhënave. Ata na thonë: “Duam të monitorojmë kërkesat tona SQL. E ato nuk janë 255 karaktere, por 8 MB secila. Duam t’i shohim ato në Grafana, të shohim parametrat për këtë kërkesë, e më mirë akoma, duam të shohim të dhënat më të mira të tillë. Do të ishte e shkëlqyer nëse do të shfaqej në kohë reale. E do të ishte akoma më mirë nëse do të vendosnim ato në alerting.”
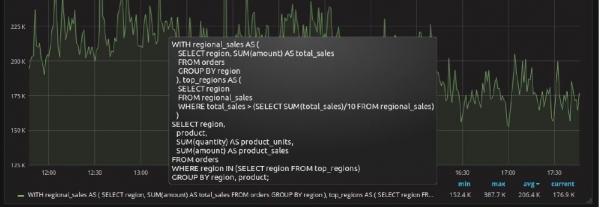
Shembulli i kërkesës SQL është marrë si një shembull nga
Ne ngritim serverin Redis dhe me plugins tonë Collectd, të cilët shkojnë në Postgres dhe marrin të dhënat, dërgojmë metrikat në Graphite. Por e zëvendësojmë emrin e metrikës me hash-et. Ky hash dërgohet gjithashtu në Redis si çelësi, ndërsa tërë SQL pyetjen si vlerë. Na mbetet të bëjmë që Grafana të mund të shkojë në Redis dhe të marrë këtë informacion. Ne hapim Graphite API, pasi ky është ndërfaqja kryesore e komunikimit mes të gjithë komponenteve të monitorimit me Graphite dhe shtojmë një funksion të ri, i quajtur aliasByHash() — nga Grafana marrim emrin e metrikës dhe e përdorim atë në kërkesën drejt Redis si çelësi, duke marrë si kthim vlerën e çelësit, e cila është kërkesa jonë “SQL”. Kështu, ne e nxorrëm në Grafana përfaqësimin e kërkesës SQL, e cila në teori nuk mund të paraqitej atje, së bashku me statistikat mbi të (calls, rows, total_time, ...).
Përfundime
Disponibiliteti. Shërbimi ynë i monitorimit është i disponueshëm 24/7 nga çdo aplikacion dhe çdo kod. Nëse keni qasje në ruajtjet, mund të shkruani të dhëna në shërbim. Gjuha nuk ka rëndësi, zgjidhjet nuk kanë rëndësi. Ju duhet vetëm të dini si të hapni një socket, të dërgoni metrikat atje dhe të mbyllni socketin.
Qëndrueshmëria. Të gjitha komponentët janë të qëndrueshëm dhe përballojnë ngarkesat tona mirë.
Pragu i ulët i hyrjes. Për të përdorur këtë sistem, nuk keni nevojë të mësoni gjuhë programimi dhe kërkesa në Grafana. Thjesht hapni aplikacionin tuaj, shkruani në të socketin që do të dërgojë metrikat në Graphite, mbylleni, hapni Grafana, krijoni dashboard-e atje dhe shikoni sjelljen e metrikave tuaja, duke marrë njoftime përmes Moira.
Autonomia. Të gjitha këto mund të bëhen vetë, pa ndihmën e inxhinierëve DevOps. Dhe kjo është e tepërt, sepse mund të monitoroni projektin tuaj tani, pa pasur nevojë të kërkoni ndihmë — as për fillimin e punës, as për ndryshime.
Në çfarë synojmë?
Të gjitha të renditura më poshtë — këto nuk janë vetëm mendime abstrakte, por ato për të cilat janë bërë të paktën hapat e parë.
- Detektori i anomalive. Duam të krijojmë një shërbim që do të hyjë në ruajtjet tona Graphite dhe do të kontrollojë çdo metrikë përmes algoritmeve të ndryshme. Padyshim që ekzistojnë algoritme që duam të shqyrtojmë, kemi të dhënat, dimë si të punojmë me to.
- Metadatet. Ne kemi shumë shërbime, që me kalimin e kohës ndryshojnë, ashtu si njerëzit që punojnë me to. Të mbash dokumentacionin manualisht përherë nuk është një opsion. Prandaj tani metadata-in integrohen në shërbimet tona mikro. Atje është shkruar kush e zhvilloi, gjuhët me të cilat bie në kontakt, kërkesat për SLA, ku dhe kujt dërgohen njoftimet. Kur vendoset shërbimi, të gjitha të dhënat e entitetit krijohen vetë. Si rezultat, ju merrni dy lidhje - një për triggere, tjetra për dashboardet në Grafana.
- Monitorimi në çdo shtëpi. Ne mendojmë se një sistem i tillë duhet të përdoret nga të gjithë zhvilluesit. Në këtë rast, ju gjithmonë kuptoni se ku është trafiku juaj, çfarë po ndodh me të, ku po bie, ku janë dobësitë e tij. Nëse, për shembull, ndodh diçka që e mbatë shërbimin tuaj, do ta mësoni atë jo gjatë një telefonate nga menaxheri, por nga një alert, dhe menjëherë do të jeni në gjendje të hapni log-et e freskëta dhe të shihni çfarë ndodhi.
- Performancë e lartë. Projekti ynë vazhdon të rritet dhe sot përpunon rreth 2,000,000 vlera metrikash në minutë. Një vit më parë, ky tregues ishte 500,000. Dhe rritja vazhdon, dhe kjo do të thotë se pas disa kohësh Graphite (whisper) do të fillojë të ngarkojë shumë sistemin disk. Siç e kam thënë më parë, ky sistem monitorimi është shumë universalisht për shkak të ndërrueshmërisë së komponenteve. Disa e shërbejnë veçanërisht Graphite dhe vazhdojnë të zgjasin infrastrukturën e tyre, por ne vendosëm të shkojmë në një rrugë tjetër: të përdorim si një depo për metrikat tona. Ky kalim është gati i përfunduar dhe shumë shpejt do t'ju tregoj më shumë se si u realizua: cilat ishin vështirësitë dhe si u përballua me to, si kaloi procesi i migrimit, do të përshkruaj komponentët e zgjedhur si lidhje dhe konfigurimet e tyre.
Faleminderit për vëmendjen! Ju lutem, bëni pyetje në lidhje me temën, do të përpiqem të përgjigjem këtu ose në postimet e ardhshme. Ndoshta disa nga ju kanë përvojë në ndërtimin e një sistemi monitorimi të tillë ose në kalimin në ClickHouse në një situatë të ngjashme - ndani atë në komentet.
Burimi: habr.com
