

Përshëndetje, Habr! Unë jam Artem Karamychev, lideri i ekipit të administratës së sistemit. . Gjatë vitit të kaluar, ne kishim shumë lançime të produkteve të reja. Donim që shërbimet API të ishin të lehta për t'u skaluar, të qëndrueshme dhe të gatshme për rritjen e shpejtë të ngarkesës së përdoruesve. Platforma jonë është realizuar në OpenStack, dhe unë dëshiroj të tregoj se cilat probleme të qëndrueshmërisë së komponentëve na duhej të zgjidhnim për të pasur një sistem të qëndrueshëm. Mendoj se do të jetë interesante për ata që gjithashtu zhvillojnë produkte në OpenStack.
Qëndrueshmëria e përgjithshme e platformës përbëhet nga qëndrueshmëria e komponentëve të saj. Pra, ne do të kalojmë gradualisht përmes të gjitha niveleve ku kemi zbuluar rreziqe dhe i kemi eliminuar ato.
Versionin video të kësaj historie, e cila është origjinarisht një raport në konferencën Uptime day 4, të organizuar nga , mund ta shikoni .
Qëndrueshmëria e arkitekturës fizike
Pjesa publike e cloud-it MCS tani është bazuar në dy qendra të të dhënave të nivelit Tier III, midis të cilave ka fibra të errët private, të rezervuar në nivelin fizik përmes rrugëve të ndryshme, me një kapacitet kalimi prej 200 Gbit/s. Niveli Tier III siguron nivelin e nevojshëm të qëndrueshmërisë së infrastrukturës fizike.
Fibra e errët është e rezervuar si në nivelin fizik ashtu edhe në atë logjik. Procesi i rezervimit të kanaleve ka qenë iterativ, ka pasur probleme dhe ne vazhdojmë të përmirësojmë lidhjen midis qendrave të të dhënave.
Për shembull, jo shumë kohë më parë, gjatë punëve në një kanale afër një nga qendrat e të dhënave, një ekskavator shkatërroi një tub, brenda të cilit ndodhej si kablli optik kryesor ashtu edhe ai rezervë. Kanali ynë i qëndrueshëm i komunikimit me qendrën e të dhënave doli të ishte i ndjeshëm në një pikë, në kanal. Si pasojë, ne humbëm një pjesë të infrastrukturës. Ne nxorrëm disa mësime, ndërmorrëm një sërë veprimesh, duke përfshirë kalimin e optikës shtesë përmes një kanali fqinje.
Në qendrat e të dhënave, ka pika pranimi të ofruesve të shërbimeve dhe ne transmetojmë prefiksat tanë përmes BGP. Për çdo drejtim rrjeti zgjidhet metrika më e mirë, e cila lejon ofrimin e cilësisë më të mirë të lidhjes për klientët tanë. Nëse lidhja përmes një ofruesi ndërpritet, ne ristrukturim rrugëtimin tonë përmes ofruesve të tjerë të disponueshëm.
Në rastin e një dështimi të ofruesit, ne kalojmë automatikisht te ofruesi tjetër. Në rastin e dështimit të njërit nga qendrat e të dhënave, ne kemi një kopje të dyfishtë të shërbimeve tona në qendrën tjetër të të dhënave, e cila merr të gjithë ngarkesën.
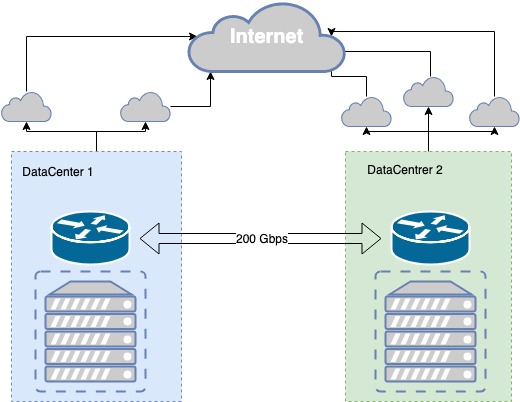
Qëndrueshmëria fizike e infrastrukturës
Çfarë përdorim për qëndrueshmërinë në nivelin e aplikacioneve
Shërbimi ynë është ndërtuar mbi disa komponentë opensource.
ExaBGP — një shërbim që zbaton një sërë funksionesh duke përdorur protokollin e rrugëtimit dinamik bazuar në BGP. Ne e përdorim aktivisht atë për të shpallur adresat tona IP të bardha, përmes të cilave përdoruesit qasen në API.
HAProxy — një balancues ngarkese me kapacitet të lartë, i cili lejon konfigurimin e rregullave shumë fleksibël të balancimit të trafikut në nivele të ndryshme të modelit OSI. Ne e përdorim atë për balancimin e të gjitha shërbimeve: bazat e të dhënave, brokerët e mesazheve, shërbimet API, shërbimet web, projektet tona të brendshme — gjithçka mbështetet pas HAProxy.
API application — një aplikacion web, i shkruar në python, me ndihmën e të cilit përdoruesi menaxhon infrastrukturën e tij, shërbimin e tij.
Worker application (në vazhdim thjesht worker) — në shërbimet OpenStack, ky është një demon infrastrukture, i cili lejon transmetimin e komandave API në infrastrukturë. Për shembull, krijimi i një disku ndodh saktësisht në worker, ndërsa kërkesa për krijimin — në aplikacionin API.
Arkitektura standarde e aplikacionit OpenStack
Shumica e shërbimeve që zhvillohen për OpenStack përpiqen të ndjekin një paradigmë të vetme. Shërbimi zakonisht përbëhet nga 2 pjesë: API dhe worker’ë (ekzekutuesit e backend-it). Zakonisht, API është një aplikacion WSGI në Python, i cili ekzekutohet si një proces i veçantë (daemon) ose me ndihmën e një serveri web të gatshëm si Nginx ose Apache. API përpunon kërkesën e përdoruesit dhe dërgon udhëzime të mëtejshme për ekzekutimin e aplikacionit të worker’it. Transferimi ndodh me ndihmën e një brokeri të mesazheve, zakonisht është RabbitMQ, ndërsa të tjerët përkrahen dobët. Kur mesazhet arrijnë te brokeri, ato përpunohen nga worker’ët dhe, në rast nevoje, kthejnë përgjigjen.
Kjo paradigëm nënkupton pika të izoluara të përgjegjësisë: RabbitMQ dhe baza e të dhënave. Megjithatë, RabbitMQ është i izoluar brenda një shërbimi dhe, në teori, mund të jetë individual për çdo shërbim. Pra, ne në MCS e ndajmë maksimalisht këto shërbime, për çdo projekt të veçantë krijojmë një bazë të veçantë, një RabbitMQ të veçantë. Ky qasje është e mirë, sepse në rast avarie në disa pika të ndjeshme, nuk shembet e gjithë shërbimi, por vetëm një pjesë e tij.
Numri i aplikacioneve worker nuk ka asnjë kufizim, prandaj API mund të shkallëzohet lehtësisht horizontalisht përmes balancuesve me qëllim rritjen e performancës dhe besueshmërisë.
Në disa shërbime, është e nevojshme koordinimi brenda shërbimit — kur ndodhin operacione të ndërlikuara sekondare mes API-ve dhe punëtorëve. Në këtë rast, përdoret një qendër e vetme koordinimi, një sistem klasteri si Redis, Memcache, etcd, i cili lejon një punëtor të informojë një tjetër se kjo detyrë i është caktuar atij ("ti, të lutem, mos e merr"). Ne përdorim etcd. Si rregull, punëtorët komunikojnë aktivisht me bazën e dhënash, shkruajnë dhe lexojnë informacion nga ajo. Si bazë të dhënash ne përdorim mariadb, e cila ndodhet në një klaster me multimaster.
Një shërbim klasik i vetëm është organizuar në mënyrë të zakonshme për OpenStack. Ai mund të konsiderohet si një sistem i mbyllur, për të cilin janë mjaft të qarta metodat e shkallëzimit dhe besueshmërisë. Për shembull, për besueshmëri, është e mjaftueshme të vendosni një balancues përpara API-ve. Shkallëzimi i worker’ëve arrihet përmes rritjes së numrit të tyre.
Dobësia e gjithë skemës është RabbitMQ dhe MariaDB. Arkitektura e tyre meriton një artikull të veçantë. Në këtë artikull do të fokusohem në qëndrueshmërinë e API-ve.
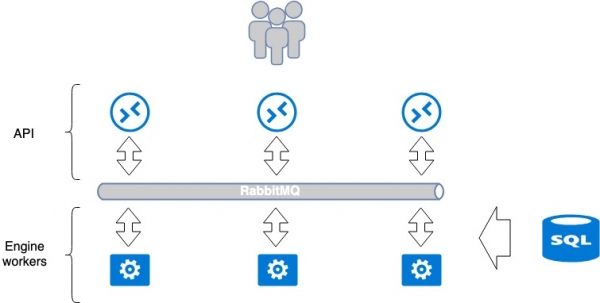
Arkitektura e Aplikacionit Openstack. Balancimi dhe qëndrueshmëria e platformës cloud.
Dërgojmë balancuesin HAProxy në një qëndrueshmëri me ndihmën e ExaBGP.
Për ta bërë API-të tona të shkallëzuara, të shpejta dhe të qëndrueshme, vendosëm një balancues para tyre. Zgjedhim HAProxy. Sipas mendimit tim, ai ka të gjitha karakteristikat e nevojshme për detyrën tonë: balancimi në nivele të ndryshme OSI, një ndërfaqe menaxhimi, fleksibilitet dhe shkallëzim, një numër të madh metodash balancimi dhe mbështetje për tabela sesionesh.
Problemi i parë që duhej zgjidhur ishte qëndrueshmëria e vetë balancuesit. Thjesht vendosja e balancuesit gjithashtu krijon një pikë dështimi: nëse balancuesi dështon, shërbimi bie. Për të shmangur këtë, përdorëm HAProxy së bashku me ExaBGP.
ExaBGP lejon implementimin e një mekanizmi për kontrollin e qëndrueshmërisë së shërbimit. Përdorëm këtë mekanizëm për të verifikuar funksionimin e HAProxy dhe në rast problemesh për të çaktivizuar shërbimin HAProxy nga BGP.
Skema ExaBGP+HAProxy.
- Instalojmë softin e nevojshëm, ExaBGP dhe HAProxy, në tre servera.
- Krijojmë një ndërfaqe loopback në secilin nga serverat.
- Në të tre serverat, vendosim të njëjtin adresë IP të bardhë në këtë ndërfaqe.
- Adresa IP e bardhë anonsohet në internet përmes ExaBGP.
Qëndrueshmëria arrihet duke anonsuar të njëjtën adresë IP nga të tre serverat. Nga perspektiva e rrjetit, e njëjta adresë është e qasshme nga tre hop-e të ndryshme. Ruter-i sheh tri rute të njëjta, zgjidh sipas metrikës së tij më të lartë (gjithmonë është e njëjta zgjedhje), dhe trafiku kalon vetëm në një nga serverat.
Në rast problemesh me funksionimin e HAProxy ose dështimit të serverit, ExaBGP ndalon anonsimin e rutes dhe trafiku kalon pa probleme në një server tjetër.
Kështu arritëm qëndrueshmërinë e balancuesit.
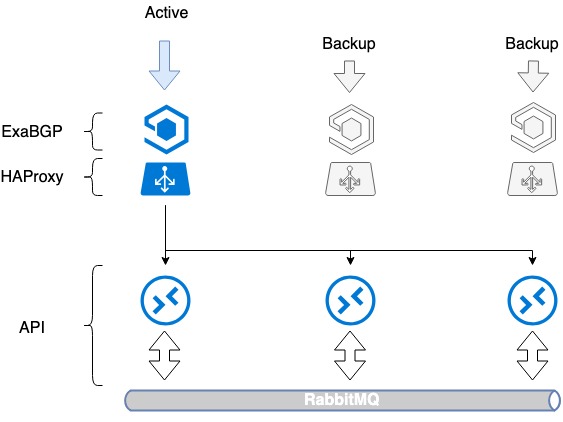
Qëndrueshmëria e balancuesve HAProxy.
Skema nuk doli ideale: mësuam të rezervojmë HAProxy, por nuk mësuam si të shpërndajmë ngarkesën brenda shërbimeve. Prandaj, këtë skemë e zgjeruam pak: kaluam në balancim midis disa adresave IP të bardha.
Balancimi mbi DNS dhe BGP
Ende nuk është zgjidhur problemi i balancimit të ngarkesës për HAProxy tonë. Megjithatë, është e mundur ta zgjidhim mjaft thjesht, ashtu siç e bëmë edhe ne.
Për balancimin e tre serverëve do të nevojiten 3 adresa IP të bardha dhe e vjetra DNS. Çdo një nga këto adresa përcaktohet në ndërfaqen loopback të çdo HAProxy dhe shpallet në internet.
Në OpenStack për menaxhimin e burimeve përdoret një katalog shërbimesh, ku caktohet endpoint API i çdo shërbimi. Në këtë katalog ne shkruajmë emrin e domenit — public.infra.mail.ru, i cili zgjidhet përmes DNS me tre adresa IP të ndryshme. Si rezultat, marrim shpërndarjen e ngarkesës midis tre adresave përmes DNS.
Por, pasi që gjatë shpalljes së adresave IP të bardha nuk menaxhojmë prioritetet e zgjedhjes së serverit, për momentin nuk është balancim. Zakonisht do të zgjidhet vetëm një server sipas rendit të adresës IP, ndërsa dy të tjerat do të qëndrojnë të papërdorura, pasi nuk janë caktuar asnjë metrikë në BGP.
Kemi filluar të japim rrugë përmes ExaBGP me metrikë të ndryshme. Çdo balancues shpall të tre adresat IP të bardha, por njëra prej tyre, kryesore për këtë balancues, shpallet me metrikën më të ulët. Prandaj, ndërsa të tre balancuesit janë në punë, kërkesat për adresën e parë shkojnë te balancuesi i parë, kërkesat për të dytën te i dyti, dhe për të tretën te të treti.
Çfarë ndodh në momentin kur një nga balancuesit dështon? Në rastin e dështimit të cilitdo balancues, adresa e tij kryesore ende shpallet nga dy të tjerët, dhe trafiku midis tyre shpërndahet. Kështu, ne i japim përdoruesit përmes DNS disa adresa IP menjëherë. Nëpërmjet balancimit përmes DNS dhe metrikës të ndryshme ne marrim një shpërndarje të barabartë të ngarkesës mbi të gjithë tre balancuesit. Dhe njëkohësisht nuk humbasim disponueshmërinë.
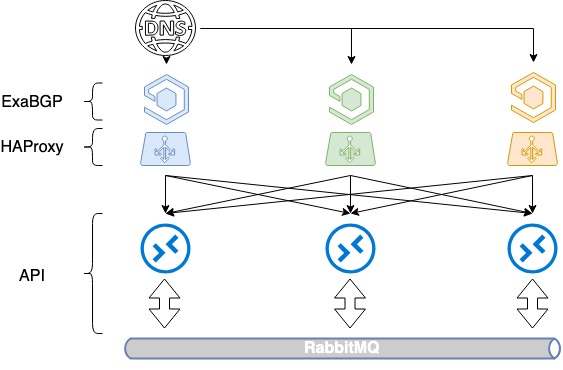
Balancimi i HAProxy mbi DNS + BGP
Ndërveprimi midis ExaBGP dhe HAProxy
Pra, ne kemi implementuar disponueshmërinë në rast se serveri largohet, mbi bazën e ndërprerjes së shpalljes së rrugëve. Por HAProxy mund të ndalojë edhe për arsye të tjera përveç dështimit të serverit: gabime administrimi, çrregullime brenda shërbimit. Ne duam të heqim balancuesin e prishur nga ngarkesa dhe në këto raste, dhe nevojitet një mekanizëm tjetër.
Prandaj, duke vazhduar me skemën e mëparshme, realizuam një heartbeat midis ExaBGP dhe HAProxy. Kjo është një realizim softuerik i ndërveprimit midis ExaBGP dhe HAProxy, kur ExaBGP përdor skriptet e personalizuara për të kontrolluar statusin e aplikacioneve.
Për këtë, në konfigurimin e ExaBGP është e domosdoshme të konfigurohet një health checker, i cili mund të kontrollojë statusin e HAProxy. Në rastin tonë, konfigurimi i backend-it shëndetësor në HAProxy u përgatit, dhe nga ana e ExaBGP ne kontrollojmë me një kërkesë të thjeshtë GET. Nëse njoftimi ndalon, atëherë HAProxy, me sa duket, nuk funksionon, dhe nuk duhet të njoftojmë atë.
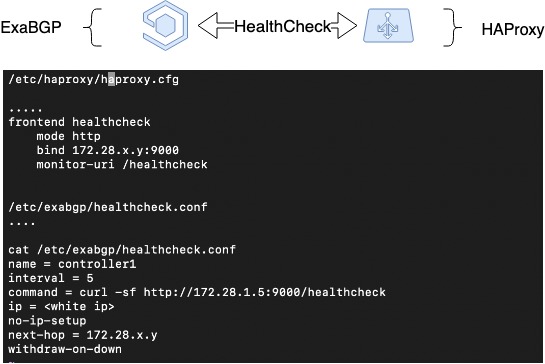
Kontrolli i Shëndetit të HAProxy
Miqtë e HAProxy: sinkronizimi i seancave
Gjithashtu, gjëja e ardhshme që duhej bërë ishte sinkronizimi i seancave. Kur punojmë përmes balancuesve të shpërndarë, është e vështirë të organizohet ruajtja e informacionit mbi seancat e klientëve. Por HAProxy është një nga pak balancuesit që di ta bëjë këtë për shkak të funksionalitetit të Peers — mundësia për të transmetuar mes proceseve të ndryshme HAProxy tabelat e seancave.
Ekzistojnë metoda të ndryshme balancimi: të thjeshta, si , dhe të avancuara, kur ruhet seanca e klientit dhe ai çdo herë shkon në serverin e njëjtë si më parë. Ne donim të realizonim variantin e dytë.
Në HAProxy, për të ruajtur seancat e klientit, përdoret mekanizmi i stick-tables. Këto ruajnë adresën origjinale IP të klientit, adresën e përzgjedhur të destinacionit (backend) dhe disa informacione të shërbimit. Zakonisht, stick-tables përdoren për të ruajtur çiftin source-IP + destination-IP, që është veçanërisht e dobishme për aplikacionet që nuk mund të transmetojnë kontekstin e seancës së përdoruesit kur kalojnë në një balancues tjetër, për shembull — në modin e balancimit RoundRobin.
Nëse stick-table mëson të lëvizë midis proceseve të ndryshme HAProxy (ndërmjet të cilave ndodh balancimi), balancuesit tanë do të mund të punojnë me një grup të vetëm stick-tables. Kjo do të ofrojë mundësinë e kalimit të pandërprerë të rrjetit të klientit në rastin e dështimit të një nga balancuesve, duke vazhduar punën me seancat e klientëve në backend-et e njëjta që ishin përzgjedhur më parë.
Për funksionimin e duhur, duhet të zgjidhet problemi i adresës IP të burimit të balancuesit, nga i cili është vendosur seanca. Në rastin tonë, kjo është një adresë dinamike në interfacin e loopback.
Funksioni i duhur i peers arrihet vetëm në kushte të caktuara. Kjo do të thotë se TCP-të duhet të jenë mjaft të gjata ose kalimi duhet të jetë mjaft i shpejtë, në mënyrë që seanca TCP të mos ndërpritet. Megjithatë, kjo lejon kalimin pa ndjeshmëri.
Ne kemi në IaaS një shërbim të ndërtuar me të njëjtën teknologji. Ky është , i quajtur Octavia. Ai bazohet në dy procese HAProxy dhe ka fillimisht mbështetje për peers. Në këtë shërbim ata kanë treguar rezultate të shkëlqyera.
Në imazh përshkruhet në mënyrë skematike lëvizja e tabelave të peers midis tre instancave të HAProxy, dhe është paraqitur një konfigurim se si mund të konfigurohet kjo:
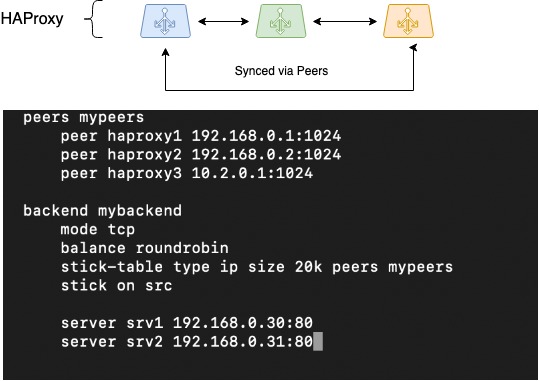
HAProxy Peers (sinkronizimi i seancave)
Nëse do të implementoni një skemë të tillë, duhen testuar me kujdes. Nuk është e sigurt që do të funksionojë në të njëjtën formë në 100% të rasteve. Por, së paku, nuk do të humbni tabelat e stick kur duhet të mbani mend adresën IP të burimit të klientit.
Kufizimi i numrit të kërkesave të njëkohshme nga një klient i vetëm
Të gjitha shërbimet që janë në akses të hapur, përfshirë API-të tona, mund të jenë nën presionin e kërkesave të shumta. Shkaqet mund të jenë të ndryshme, nga gabimet e përdoruesve deri te sulmet e drejtuara qëllimisht. Ndonjëherë, përjetojmë sulme DDoS përmes adresave IP. Klientët shpesh gabojnë në skriptet e tyre, duke na bërë mini-DDoS.
Në çdo rast, është e nevojshme të parashikohet mbrojtje shtesë. Një zgjidhje e qartë është kufizimi i numrit të kërkesave ndaj API-së dhe mosshpenzimi i kohës së procesorit për trajtimin e kërkesave të dëmshme.
Për të realizuar këto kufizime ne përdorim limite për shpejtësinë, të organizuara mbi bazën e HAProxy, duke përdorur tabelat e stick. Limitet konfigurohen mjaft thjesht dhe lejojnë kufizimin e përdoruesve për numrin e kërkesave ndaj API-së. Algoritmi mban mend adresën IP të burimit nga e cila bëhen kërkesat dhe kufizon numrin e kërkesave të njëkohshme nga një përdorues. Natyrisht, ne kemi llogaritur profilin mesatar të ngarkesës në API për çdo shërbim dhe kemi vendosur limitin ≈ 10 herë më të madh se ky vlerë. Ende po e ndjekim me kujdes situatën dhe po mbajmë dorën mbi puls.
Si e përjetësohet kjo në praktikë? Ne kemi klientë që vazhdimisht shfrytëzojnë API-të tona për automatizimin e shkallëzimit. Ata krijojnë rreth dyqind deri në treqind makina virtuale në mëngjes dhe i fshijnë ato deri në mbrëmje. Për OpenStack, krijimi i një makine virtuale, së bashku me shërbimet PaaS, do të kërkonte të paktën 1000 kërkesa API, pasi komunikimi mes shërbimeve gjithashtu ndodh përmes API-ve.
Këto trasferime të detyrave shkaktojnë një ngarkesë të konsiderueshme. Ne e kemi vlerësuar këtë ngarkesë, kemi mbledhur majat e përditshme, i kemi shumzuar ato me dhjetë, dhe kjo është bërë kufiri ynë i ritmit. Ne jemi gjithmonë të vëmendshëm. Shpesh shohim bots dhe skanera që përpiqen të na analizojnë, për të parë nëse kemi ndonjë skript CGA që mund të aktivizojnë; ne i ndalim ato me fuqishëm.
Si të përditësojmë bazën e kodit pa e vënë re nga përdoruesit
Ne realizojmë qëndrueshmërinë edhe në nivelin e proceseve të shpërndarjes së kodit. Gjatë lançimeve ndodhin dështime, por ndikimi i tyre në disponueshmërinë e shërbimeve mund të minimizohet.
Ne vazhdimisht përditësojmë shërbimet tona dhe duhet të sigurojmë procesin e përditësimit të bazës së kodit pa shkaktuar efekte për përdoruesit. Kjo çështje u zgjidh duke përdorur mundësitë e menaxhimit të HAProxy dhe implementimin e Graceful Shutdown në shërbimet tona.
Për zgjidhjen e kësaj çështjeje, duheshin siguruar menaxhimi i balancuesit dhe "shkëputja e duhur" e shërbimeve:
- Në rastin e HAProxy, menaxhimi bëhet përmes skedarit të statistikave, i cili në thelb është një soket dhe përcaktohet në konfigurimin e HAProxy. Komandat mund të dërgohen përmes stdio. Por, instrumenti ynë kryesor për kontrollin e konfigurimeve është ansible, prandaj ai ka një modul të integruar për menaxhimin e HAProxy, të cilin ne e përdorim aktivisht.
- Shumica e shërbimeve tona API dhe Engine mbështesin teknologjitë graceful shutdown: gjatë ndalimit, ato presin përfundimin e plotë të detyrës aktuale, qoftë kjo një kërkesë http ose një detyrë ndihmëse. E njëjta gjë ndodhe me punëtorin. Ai di për të gjitha detyrat që bën dhe përfundon kur gjithçka ka përfunduar me sukses.
Falë këtyre dy elementeve, algoritmi ynë i sigurt për shpërndarjen duket si më poshtë.
- Zhvilluesi përgatit një paketë të re të kodit (për ne kjo është RPM), e teston në mjedisin dev, e teston në stage, dhe e lë në depozita stage.
- Programatori cakton një detyrë për depoy me përshkrim sa më të detajuar "artefaktesh": versioni i paketës së re, përshkrimi i funksionalitetit të ri dhe detaje të tjera rreth depoy-it në rast nevoje.
- Administratori i sistemit fillon përditësimin. Ai fillon playbook-un Ansible, i cili nga ana e tij bën sa vijon:
- Merr paketën nga depoja stage, në përmjet saj përditëson versionin e paketës në depoja produktive.
- Përgatit një listë të backend-eve të shërbimit që po përditësohet.
- Çon në ndalim shërbimin e parë në HAProxy dhe pret përfundimin e proceseve të tij. Falë mbylljes së përmirësuar ne jemi të sigurtë se të gjitha kërkesat aktuale të klientëve do të përfundojnë me sukses.
- Pas ndalimit të plotë të API-së, punëtorëve, dhe ndalimit të HAProxy, ndodh përditësimi i kodit.
- Ansible fillon shërbimet.
- Për çdo shërbim tërheq "duar" të caktuara, të cilat kryejnë testimin njësi sipas një grupi të caktuar testesh përpara. Kryhet një kontroll bazik i kodit të ri.
- Nëse në hapin e mëparshëm nuk janë zbuluar gabime, backend-i aktivizohet.
- Kalohet te backend-i tjetër.
- Pas përditësimit të të gjitha backend-eve, kryhen testet funksionale. Nëse ato nuk mjaftojnë, programatori shqyrton çdo funksionalitet të ri që ka bërë.
Në këtë pikë depoy është përfunduar.
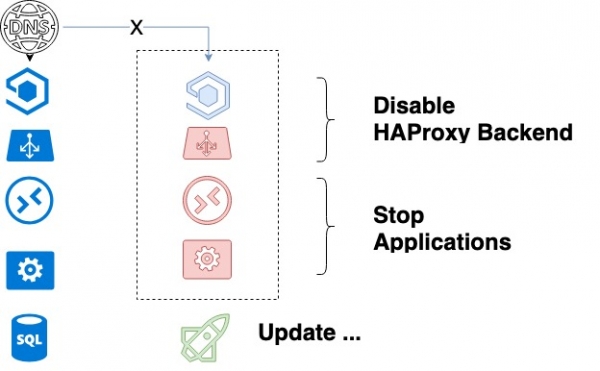
Cikli i përditësimit të shërbimit
Kjo skemë nuk do të funksiononte nëse nuk do të kishim një rregull. Ne mbështesim në prodhim në të njëjtën kohë versionet e vjetra dhe të reja. Me kohë, gjatë zhvillimit të softuerit, planifikohet që edhe nëse ka ndryshime në bazën e të dhënave të shërbimit, ato nuk do të prishin kodin e mëparshëm. Si rezultat, ndodh një përditësim gradual i kodit.
Përfundim
Duke ndarë mendimet e mia rreth arkitekturës WEB-mundësuese, dua ta theksoj edhe një herë pikat e saj kyçe:
- qëndrueshmëria fizike;
- qëndrueshmëria rrjetësore (balancuesit, BGP);
- qëndrueshmëria e softuerit të përdorur dhe të zhvilluar.
Të gjithë me uptime të qëndrueshëm!
Burimi: habr.com
