

Në Kemi shqyrtuar klasterizimin e RabbitMQ për të siguruar tolerancë ndaj dështimeve dhe disponueshmëri të lartë. Tani do të hyjmë më thellë në Apache Kafka.
Këtu njësia e replikimit është particioni (partition). Çdo topic ka një ose më shumë particione. Në çdo partition ka një lider, me ose pa followers. Gjatë krijimit të topic përcaktohen numri i particioneve dhe faktori i replikimit. Vlera tipike është 3, që do të thotë tre replika: një lider dhe dy followers.
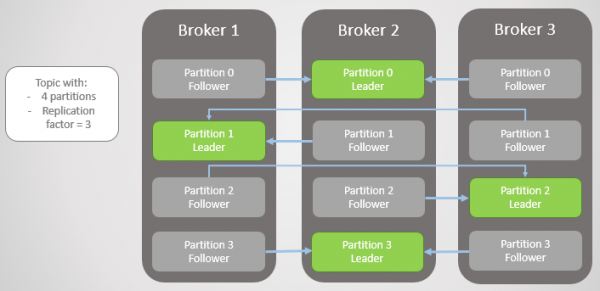
Fig. 1. Katër particione janë shpërndarë midis tre brokerëve
Të gjitha kërkesat për lexim dhe shkrim i dërgohen liderit. Followers i dërgojnë periodikisht liderit kërkesa për të marrë mesazhet më të fundit. Konsumatorët nuk i drejtohen kurrë followers; këta të fundit ekzistojnë vetëm për tepricë dhe tolerancë ndaj dështimeve.
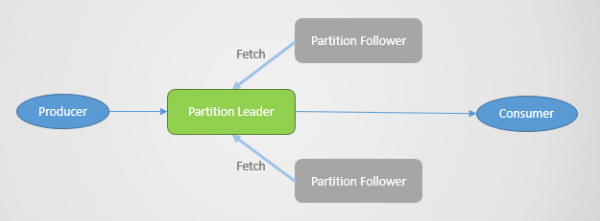
Dështimi i partition
Kur një broker bie, shpesh dalin jashtë funksioni liderët e disa particioneve. Në secilin prej tyre, lider bëhet një follower nga një nyje tjetër. Në praktikë, kjo nuk ndodh gjithmonë kështu, sepse ndikon edhe faktori i sinkronizimit: a ka followers të sinkronizuar dhe, nëse jo, a lejohet kalimi te një replikë e pasinkronizuar. Por për momentin të mos e komplikojmë.
Brokeri 3 del nga rrjeti dhe për partition 2 zgjidhet një lider i ri në brokerin 2.
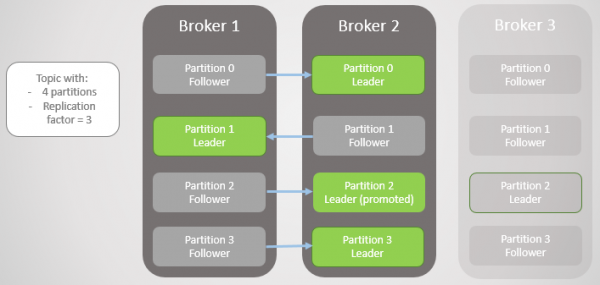
Fig. 2. Brokeri 3 bie dhe follower-i i tij në brokerin 2 zgjidhet lideri i ri i partition 2
Më pas bie edhe brokeri 1 dhe partition 1 humbet gjithashtu liderin e vet, roli i të cilit kalon te brokeri 2.
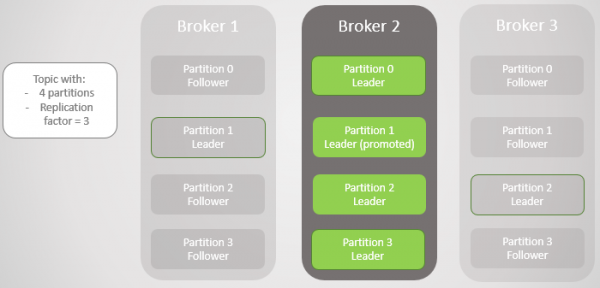
Fig. 3. Ka mbetur vetëm një broker. Të gjithë liderët ndodhen në një broker me tepricë zero
Kur brokeri 1 rikthehet në rrjet, ai shton katër followers, duke siguruar njëfarë teprice për çdo partition. Por të gjithë liderët mbeten ende në brokerin 2.
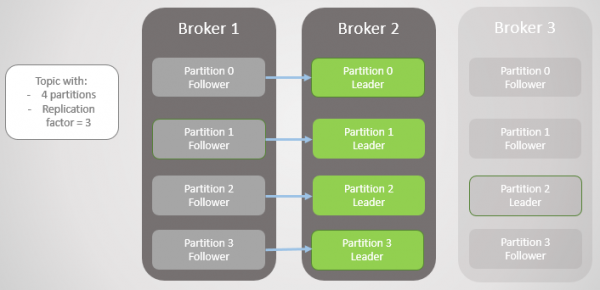
Fig. 4. Liderët mbeten në brokerin 2
Kur ngrihet brokeri 3, kthehemi te tre replika për partition. Por të gjithë liderët mbeten ende në brokerin 2.
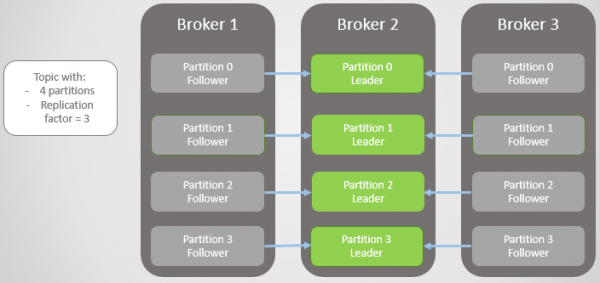
Fig. 5. Vendosje e pabalancuar e liderëve pas rikthimit të brokerëve 1 dhe 3
Kafka ka një mjet për ribalancim të liderëve më cilësor se RabbitMQ. Atje duhej përdorur një plugin ose script i palës së tretë, i cili ndryshonte politikat për të migruar nyjen kryesore duke ulur tepricën gjatë migrimit. Për më tepër, për radhë të mëdha duhej pranuar edhe mosdisponueshmëria gjatë sinkronizimit.
Kafka ka konceptin e «replikave të preferuara» për rolin e liderit. Kur krijohen particionet e një topic-u, Kafka përpiqet t’i shpërndajë liderët në mënyrë të barabartë nëpër nyje dhe i shënon këta liderë fillestarë si të preferuar. Me kalimin e kohës, për shkak të rinisjeve të serverëve, dështimeve dhe problemeve të lidhjes, liderët mund të përfundojnë në nyje të tjera, si në rastin ekstrem të përshkruar më sipër.
Për ta korrigjuar këtë, Kafka ofron dy mundësi:
- Opcioni auto.leader.rebalance.enable=true i lejon nyjes kontrolluese të ricaktojë automatikisht liderët te replikat e preferuara dhe kështu të rikthejë shpërndarjen e barabartë.
- Administratori mund të ekzekutojë skriptin kafka-preferred-replica-election.sh për ricaktim manual.
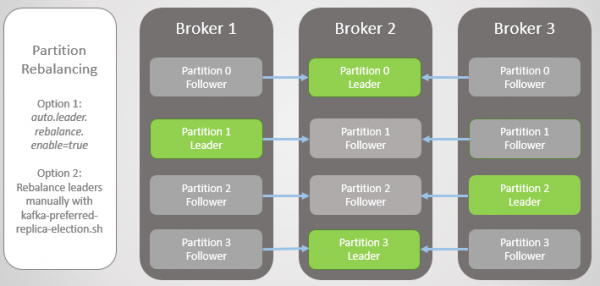
Fig. 6. Replikat pas ribalancimit
Ky ishte një version i thjeshtuar i një dështimi, por realiteti është më kompleks, megjithëse këtu nuk ka asgjë tepër të vështirë. Gjithçka reduktohet te replikat e sinkronizuara (In-Sync Replicas, ISR).
Replikat e sinkronizuara (ISR)
ISR është grupi i replikave të një particioni që konsiderohet «i sinkronizuar» (in-sync). Këtu ka një lider, ndërsa followers mund të mungojnë. Një follower konsiderohet i sinkronizuar nëse ka bërë kopje të sakta të të gjitha mesazheve të liderit para skadimit të intervalit replica.lag.time.max.ms.
Një follower hiqet nga grupi ISR nëse:
- nuk ka bërë një kërkesë fetch brenda intervalit replica.lag.time.max.ms (konsiderohet i vdekur)
- nuk ka arritur të përditësohet brenda intervalit replica.lag.time.max.ms (konsiderohet i ngadaltë)
Followers bëjnë kërkesa fetch në intervalin replica.fetch.wait.max.ms, i cili si parazgjedhje është 500 ms.
Për të shpjeguar qartë qëllimin e ISR, duhet të shohim konfirmimet nga producer dhe disa skenarë dështimi. Producers mund të zgjedhin kur broker dërgon konfirmimin:
- acks=0, konfirmimi nuk dërgohet
- acks=1, konfirmimi dërgohet pasi lideri e ka shkruar mesazhin në log-un e tij lokal
- acks=all, konfirmimi dërgohet pasi të gjitha replikat në ISR e kanë shkruar mesazhin në log-et lokale
Në terminologjinë e Kafka-s, nëse ISR e ka ruajtur mesazhin, ndodh «commit». Acks=all është opsioni më i sigurt, por sjell edhe latencë shtesë. Le të shqyrtojmë dy shembuj dështimesh dhe si bashkëveprojnë opsionet e ndryshme ‘acks’ me konceptin e ISR.
Acks=1 dhe ISR
Në këtë shembull do të shohim se, nëse lideri nuk pret ruajtjen e çdo mesazhi nga të gjithë followers, në rast të dështimit të liderit mund të ndodhë humbje e të dhënave. Kalimi te një follower i pasinkronizuar mund të lejohet ose të ndalohet nga konfigurimi unclean.leader.election.enable.
Në këtë shembull, te producer është vendosur vlera acks=1. Particioni është shpërndarë në të tre brokerët. Brokeri 3 ka mbetur prapa; ai u sinkronizua me liderin tetë sekonda më parë dhe tani ka vonesë prej 7456 mesazhesh. Brokeri 1 ka mbetur prapa vetëm me një sekondë. Producer-i ynë dërgon mesazhin dhe merr shpejt ack mbrapsht, pa overhead nga followers të ngadaltë ose të dështuar, të cilët lideri nuk i pret.
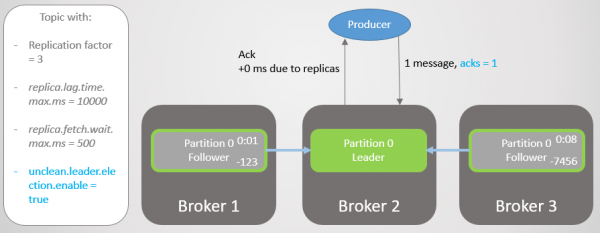
Fig. 7. ISR me tre replika
Brokeri 2 del jashtë funksionit dhe producer merr një gabim lidhjeje. Pas kalimit të lidershipit te brokeri 1, humbasim 123 mesazhe. Follower në brokerin 1 ishte pjesë e ISR, por nuk ishte sinkronizuar plotësisht me liderin kur ai ra.
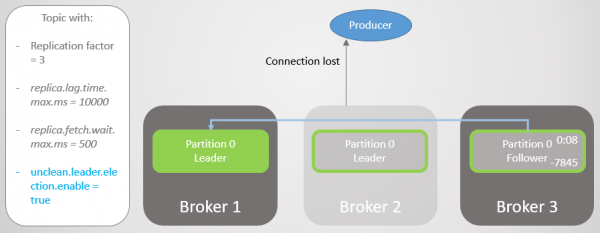
Fig. 8. Gjatë dështimit humben mesazhe
Në konfigurimin bootstrap.servers te producer janë listuar disa brokerë, dhe ai mund të pyesë një broker tjetër se kush është bërë lideri i ri i particionit. Më pas ai krijon lidhje me brokerin 1 dhe vazhdon të dërgojë mesazhe.
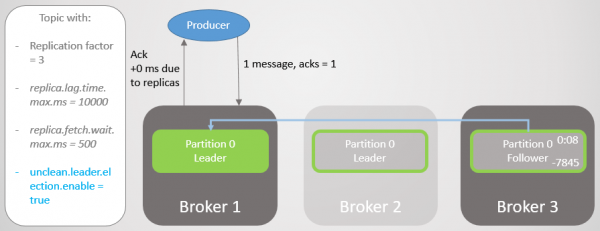
Fig. 9. Dërgimi i mesazheve rifillon pas një ndërprerjeje të shkurtër
Brokeri 3 mbetet edhe më shumë prapa. Ai bën kërkesa fetch, por nuk mund të sinkronizohet. Kjo mund të lidhet me një lidhje të ngadaltë rrjeti midis brokerëve, një problem me storage etj. Ai hiqet nga ISR. Tani ISR përbëhet nga një replikë të vetme — lideri! Producer vazhdon të dërgojë mesazhe dhe të marrë konfirmime.
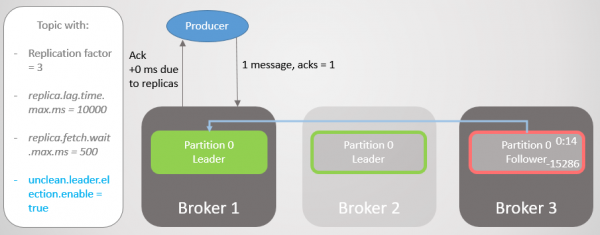
Fig. 10. Follower në brokerin 3 hiqet nga ISR
Brokeri 1 bie dhe roli i liderit kalon te brokeri 3 me humbjen e 15286 mesazheve! Producer merr një mesazh për gabim lidhjeje. Kalimi te një lider jashtë ISR ishte i mundur vetëm për shkak të konfigurimit unclean.leader.election.enable=true. Nëse do të ishte vendosur në false, atëherë kalimi nuk do të ndodhte dhe të gjitha kërkesat për lexim dhe shkrim do të refuzoheshin. Në këtë rast presim rikthimin e brokerit 1 me të dhënat e tij të paprekura në replikë, e cila do të marrë sërish rolin e liderit.
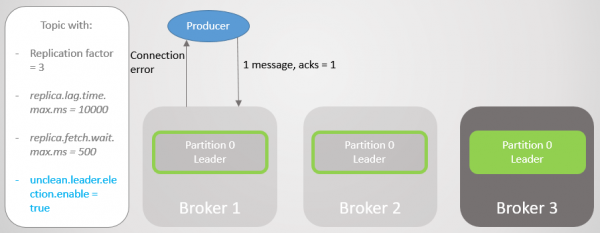
Fig. 11. Brokeri 1 bie. Gjatë dështimit humbet një sasi e madhe mesazhesh
Prodhuesi krijon lidhje me brokerin e fundit dhe sheh që ai tani është lideri i particionit. Ai fillon t’i dërgojë mesazhe brokerit 3.
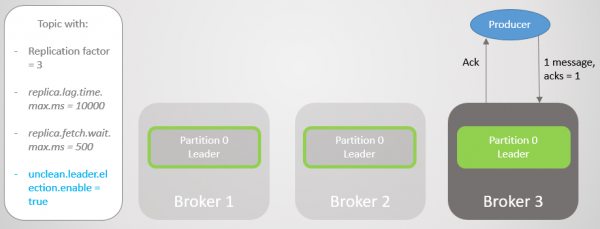
Fig. 12. Pas një ndërprerjeje të shkurtër, mesazhet dërgohen sërish në particionin 0
Pamë që, përveç ndërprerjeve të shkurtra për krijimin e lidhjeve të reja dhe gjetjen e liderit të ri, prodhuesi vazhdimisht dërgonte mesazhe. Një konfigurim i tillë siguron disponueshmëri në kurriz të konsistencës (sigurisë së të dhënave). Kafka humbi mijëra mesazhe, por vazhdoi të pranonte regjistrime të reja.
Acks=all dhe ISR
Le ta përsërisim këtë skenar edhe një herë, por me acks=all. Vonesa e brokerit 3 është mesatarisht katër sekonda. Prodhuesi dërgon një mesazh me acks=all, dhe tani nuk merr një përgjigje të shpejtë. Lideri pret derisa mesazhi të ruhet nga të gjitha replikat në ISR.
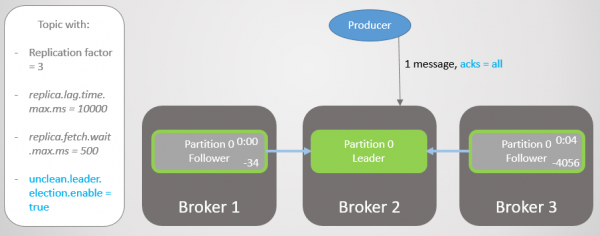
Fig. 13. ISR me tre replika. Njëra punon ngadalë, gjë që sjell vonesë në shkrim
Pas katër sekondash vonesë shtesë, brokeri 2 dërgon ack. Tani të gjitha replikat janë plotësisht të përditësuara.
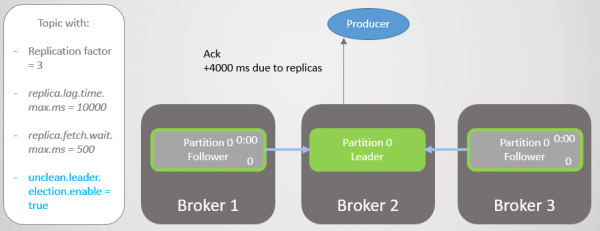
Fig. 14. Të gjitha replikat i ruajnë mesazhet dhe dërgohet ack
Brokeri 3 tani mbetet edhe më shumë pas dhe hiqet nga ISR. Vonesa ulet ndjeshëm, sepse në ISR nuk kanë mbetur replika të ngadalta. Brokeri 2 tani pret vetëm brokerin 1, dhe ai ka një lag mesatar prej 500 ms.
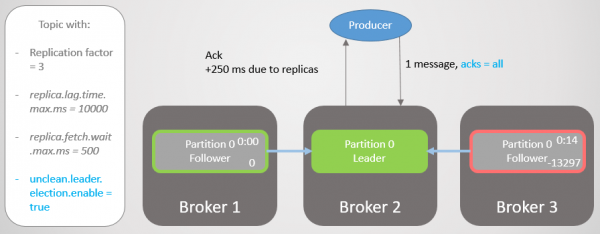
Fig. 15. Replika në brokerin 3 hiqet nga ISR
Më pas bie brokeri 2 dhe lidershipi kalon te brokeri 1 pa humbje mesazhesh.
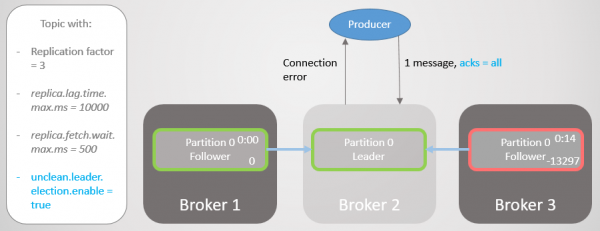
Fig. 16. Brokeri 2 bie
Prodhuesi gjen liderin e ri dhe fillon t’i dërgojë atij mesazhe. Vonesa ulet edhe më shumë, sepse tani ISR përbëhet nga një replikë e vetme! Prandaj opsioni acks=all nuk shton tepricë.
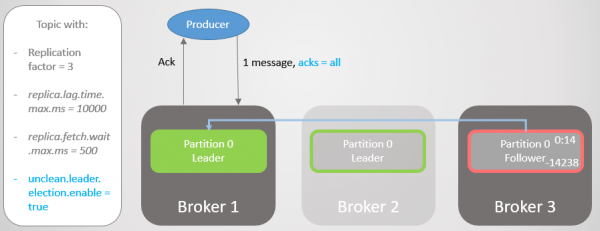
Fig. 17. Replika në brokerin 1 merr lidershipin pa humbje mesazhesh
Më pas bie brokeri 1 dhe lidershipi kalon te brokeri 3 me humbjen e 14238 mesazheve!
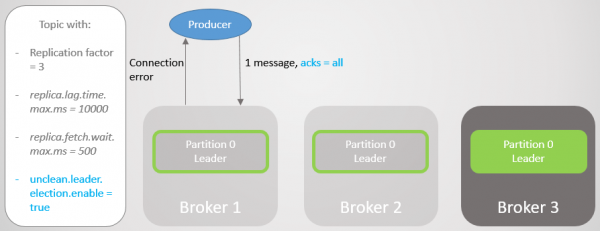
Fig. 18. Brokeri 1 ndalet, ndërsa kalimi i lidershipit me cilësimin unclean çon në humbje të mëdha të të dhënave
Mund të mos e vendosnim opsionin unclean.leader.election.enable në vlerën true. Si parazgjedhje, ai është false. Cilësimi acks=all me unclean.leader.election.enable=true siguron disponueshmëri me një nivel shtesë të sigurisë së të dhënave. Por, siç e shihni, prapë mund të humbasim mesazhe.
Po sikur të duam të rrisim sigurinë e të dhënave? Mund të vendosim unclean.leader.election.enable = false, por kjo nuk do të na mbrojë domosdoshmërisht nga humbja e të dhënave. Nëse lideri rrëzohet rëndë dhe humbet edhe të dhënat me vete, atëherë mesazhet gjithsesi humbasin, ndërsa disponueshmëria humbet derisa administratori të rikthejë situatën.
Është më mirë të garantohet teprica e të gjitha mesazheve, përndryshe të refuzohet shkrimi. Atëherë, të paktën nga këndvështrimi i broker-it, humbja e të dhënave bëhet e mundur vetëm në rast të dy ose më shumë dështimeve të njëkohshme.
Acks=all, min.insync.replicas dhe ISR
Me konfigurimin e topic-ut min.insync.replicas ne e rrisim nivelin e sigurisë së të dhënave. Le ta kalojmë edhe një herë pjesën e fundit të skenarit të mëparshëm, por këtë herë me min.insync.replicas=2.
Pra, te broker 2 ndodhet replika lider, ndërsa follower-i në broker 3 është hequr nga ISR.
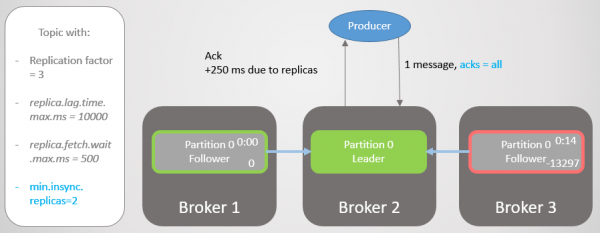
Fig. 19. ISR me dy replika
Broker 2 rrëzohet dhe lidershipi kalon te broker 1 pa humbje mesazhesh. Por tani ISR përbëhet vetëm nga një replikë. Kjo nuk përputhet me numrin minimal të kërkuar për të pranuar shkrime, ndaj broker-i i përgjigjet përpjekjes së shkrimit me gabimin NotEnoughReplicas.
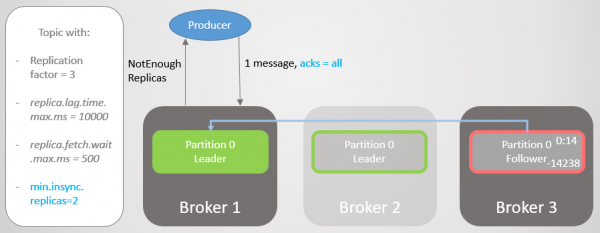
Fig. 20. Numri i ISR është një më i ulët se ai i përcaktuar në min.insync.replicas
Ky konfigurim sakrifikon disponueshmërinë në favor të konsistencës. Para se të konfirmojmë mesazhin, ne garantojmë që ai të shkruhet të paktën në dy replika. Kjo i jep producer-it shumë më tepër siguri. Këtu humbja e mesazheve është e mundur vetëm në rast të dështimit të njëkohshëm të dy replikave brenda një intervali të shkurtër, përpara se mesazhi të replikohet te një follower shtesë, gjë që ka pak gjasa të ndodhë. Por nëse jeni superparanojak, mund ta vendosni faktorin e replikimit në 5, ndërsa min.insync.replicas në 3. Në këtë rast, duhen të rrëzohen menjëherë tre broker-a njëkohësisht që të humbet një shkrim! Natyrisht, për një besueshmëri të tillë do të paguani me vonesë shtesë.
Kur disponueshmëria është e nevojshme për sigurinë e të dhënave
Ashtu si në , ndonjëherë disponueshmëria është e nevojshme për sigurinë e të dhënave. Duhet të mendoni për sa vijon:
- A mundet publisher-i thjesht të kthejë një gabim, ndërsa shërbimi në shtresën sipër ose përdoruesi të provojë sërish më vonë?
- A mundet publisher-i ta ruajë mesazhin lokalisht ose në një bazë të dhënash, që të provojë sërish më vonë?
Nëse përgjigjja është negative, atëherë optimizimi i disponueshmërisë rrit sigurinë e të dhënave. Do të humbni më pak të dhëna nëse zgjidhni disponueshmërinë në vend të refuzimit të shkrimit. Pra, gjithçka varet nga gjetja e ekuilibrit, dhe vendimi varet nga situata konkrete.
Kuptimi i ISR
Mekanizmi ISR ju lejon të zgjidhni ekuilibrin optimal midis sigurisë së të dhënave dhe vonesës. Për shembull, të siguroni disponueshmëri në rast dështimi të shumicës së replikave, duke minimizuar ndikimin e replikave të vdekura ose të ngadalta në aspektin e vonesës.
Vlerën e zgjedhim vetë replica.lag.time.max.ms sipas nevojave tona. Në thelb, ky parametër tregon se çfarë vonese jemi të gatshëm të pranojmë gjatë acks=all. Vlera e paracaktuar është dhjetë sekonda. Nëse kjo është shumë për ju, mund ta ulni. Atëherë do të rritet shpeshtësia e ndryshimeve në ISR, sepse followers do të hiqen dhe do të shtohen më shpesh.
Në RabbitMQ ekziston thjesht një grup pasqyrash që duhen replikuar. Pasqyrat e ngadalta sjellin vonesë shtesë, ndërsa përgjigjja nga pasqyrat e vdekura mund të pritet derisa të skadojë koha e jetës së paketave që kontrollojnë disponueshmërinë e çdo nyjeje (net tick). ISR është një mënyrë interesante për t’i shmangur këto probleme pa rritur vonesën. Megjithatë, rrezikojmë të humbasim tepricën, sepse ISR mund të tkurret deri vetëm te lideri. Për të shmangur këtë rrezik, përdorni cilësimin min.insync.replicas.
Garancia e lidhjes së klientëve
Në cilësimet e bootstrap.servers prodhuesit dhe konsumatorit mund të specifikohen disa brokerë për lidhjen e klientëve. Ideja është që, nëse një nyje del jashtë funksionit, të mbeten disa opsione rezervë me të cilat klienti mund të hapë lidhjen. Këto nuk janë domosdoshmërisht liderë të partizioneve, por thjesht një pikënisje për ngarkimin fillestar. Klienti mund t’i pyesë se në cilën nyje ndodhet lideri i partizionit për lexim/shkrim.
Në RabbitMQ klientët mund të lidhen me çdo nyje, ndërsa rutimi i brendshëm e dërgon kërkesën aty ku duhet. Kjo do të thotë se përpara RabbitMQ mund të vendosni një balancues ngarkese. Kafka kërkon që klientët të lidhen me nyjen ku ndodhet lideri i partizionit përkatës. Në këtë rast, nuk mund të vendoset një balancues ngarkese. Lista bootstrap.servers është me rëndësi kritike që klientët të mund t’u drejtohen nyjeve të duhura dhe t’i gjejnë ato pas një dështimi.
Arkitektura e konsensusit në Kafka
Deri tani nuk kemi shqyrtuar se si klasteri e kupton që një broker ka rënë dhe si zgjidhet një lider i ri. Për të kuptuar se si Kafka punon me ndarjet e rrjetit, fillimisht duhet të kuptoni arkitekturën e konsensusit.
Çdo klaster Kafka vendoset së bashku me një klaster Zookeeper — një shërbim i konsensusit të shpërndarë që i lejon sistemit të arrijë konsensus për një gjendje të caktuar, duke i dhënë përparësi konsistencës ndaj disponueshmërisë. Për të miratuar operacionet e leximit dhe shkrimit kërkohet pëlqimi i shumicës së nyjeve Zookeeper.
Zookeeper ruan gjendjen e klasterit:
- Listën e topic-eve, ndarjeve, konfigurimin, replikat aktuale të liderit, replikat e preferuara.
- Anëtarët e klasterit. Çdo broker dërgon ping te klasteri Zookeeper. Nëse ai nuk merr ping brenda një periudhe të caktuar kohe, Zookeeper e shënon brokerin si të padisponueshëm.
- Zgjedhjen e nyjeve kryesore dhe rezervë për kontrolluesin.
Nyja e kontrolluesit është një nga brokerët Kafka që përgjigjet për zgjedhjen e liderëve të replikave. Zookeeper i dërgon kontrolluesit njoftime për anëtarësinë në klaster dhe ndryshimet e topic-eve, dhe kontrolluesi duhet të veprojë në përputhje me këto ndryshime.
Për shembull, le të marrim një topic të ri me dhjetë ndarje dhe koeficient replikimi 3. Kontrolluesi duhet të zgjedhë liderin e secilës ndarje, duke u përpjekur t’i shpërndajë liderët në mënyrë optimale mes brokerëve.
Për çdo ndarje, kontrolluesi:
- përditëson informacionin në Zookeeper për ISR dhe liderin;
- dërgon komandën LeaderAndISRCommand te çdo broker që mban një replikë të kësaj ndarjeje, duke i informuar brokerët për ISR dhe liderin.
Kur bie brokeri me liderin, Zookeeper i dërgon njoftim kontrolluesit dhe ai zgjedh një lider të ri. Edhe në këtë rast, kontrolluesi fillimisht përditëson Zookeeper dhe më pas i dërgon komandë secilit broker, duke i njoftuar për ndryshimin e lidershipit.
Çdo lider mban përgjegjësi për një grup ISR. Konfigurimi replica.lag.time.max.ms përcakton se kush do të përfshihet aty. Kur ISR ndryshon, lideri i transmeton Zookeeper informacionin e ri.
Zookeeper është gjithmonë i informuar për çdo ndryshim, në mënyrë që në rast dështimi drejtimi të kalojë pa probleme te lideri i ri.
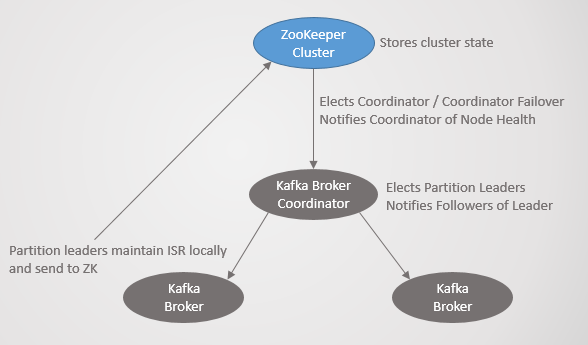
Fig. 21. Konsensusi i Kafka
Protokolli i replikimit
Kuptimi i detajeve të replikimit ndihmon për të kuptuar më mirë skenarët e mundshëm të humbjes së të dhënave.
Kërkesat e tërheqjes, Log End Offset (LEO) dhe Highwater Mark (HW)
Pamë se followers u dërgojnë periodikisht kërkesa fetch liderit. Intervali i parazgjedhur është 500 ms. Kjo ndryshon nga RabbitMQ, ku replikimi nuk niset nga pasqyra e radhës, por nga master-i. Master-i i shtyn ndryshimet te pasqyrat.
Lideri dhe të gjithë followers ruajnë Log End Offset (LEO) dhe shenjën Highwater (HW). Shenja LEO ruan offset-in e mesazhit të fundit në replikën lokale, ndërsa HW ruan offset-in e commit-it të fundit. Mbani mend se, që një mesazh të marrë statusin «commit», ai duhet të ruhet në të gjitha replikat ISR. Kjo do të thotë se LEO zakonisht është pak përpara HW.
Kur lideri merr një mesazh, ai e ruan lokalisht. Followers dërgojnë një kërkesë fetch duke kaluar LEO-n e tyre. Më pas, lideri dërgon një paketë mesazhesh duke filluar nga ky LEO, si edhe vlerën aktuale të HW. Kur lideri merr informacion se të gjitha replikat e kanë ruajtur mesazhin me offset-in e caktuar, ai lëviz shenjën HW. Vetëm lideri mund ta lëvizë HW, dhe kështu të gjithë followers mësojnë vlerën aktuale në përgjigjet ndaj kërkesave të tyre. Kjo do të thotë se followers mund të mbeten prapa liderit si për mesazhet, ashtu edhe për njohjen e vlerës HW. Konsumatorët marrin mesazhe vetëm deri te HW aktual.
Vini re se «persisted» do të thotë i shkruar në memorie, jo në disk. Për arsye performance, Kafka kryen sinkronizimin në disk me një interval të caktuar. Edhe RabbitMQ ka një interval të tillë, por ai do t’i dërgojë konfirmim publisher-it vetëm pasi master-i dhe të gjitha pasqyrat ta kenë shkruar mesazhin në disk. Zhvilluesit e Kafka, për arsye performance, kanë vendosur të dërgojnë ack sapo mesazhi të shkruhet në memorie. Kafka mbështetet te fakti që teprica e kopjeve kompenson rrezikun e ruajtjes afatshkurtër të mesazheve të konfirmuara vetëm në memorie.
Dështimi i liderit
Kur lideri bie, Zookeeper njofton controller-in dhe ai zgjedh një replikë të re lidere. Lideri i ri vendos një shenjë të re HW në përputhje me LEO-n e vet. Më pas, followers marrin informacionin për liderin e ri. Në varësi të versionit të Kafka, follower do të zgjedhë një nga dy skenarët:
- Do ta shkurtojë log-un lokal deri te HW i njohur dhe do t’i dërgojë liderit të ri një kërkesë për mesazhet pas kësaj shenje.
- Do t’i dërgojë liderit një kërkesë për të marrë HW në momentin kur ai u zgjodh lider dhe më pas do ta shkurtojë log-un deri në atë offset. Më pas do të nisë të bëjë kërkesa periodike fetch duke filluar nga ai offset.
Follower-it mund t’i duhet ta shkurtojë log-un për arsyet e mëposhtme:
- Kur ndodh një dështim i liderit, follower-i i parë nga grupi ISR i regjistruar në Zookeeper fiton zgjedhjet dhe bëhet lider. Të gjithë follower-ët në ISR, megjithëse konsiderohen «të sinkronizuar», mund të mos kenë marrë nga lideri i mëparshëm kopjet e të gjitha mesazheve. Është plotësisht e mundur që follower-i i zgjedhur të mos ketë kopjen më të përditësuar. Kafka garanton që midis replikave të mos ketë divergjencë. Prandaj, për të shmangur divergjencën, çdo follower duhet ta shkurtojë log-un e vet deri te vlera HW e liderit të ri në momentin e zgjedhjes së tij. Kjo është një arsye tjetër pse konfigurimi acks=all është kaq i rëndësishëm për konsistencën.
- Mesazhet shkruhen periodikisht në disk. Nëse të gjitha nyjet e klasterit dështojnë njëkohësisht, në disqe do të mbeten replika me offset-e të ndryshme. Është plotësisht e mundur që, kur broker-at të rikthehen sërish në rrjet, lideri i ri që do të zgjidhet të jetë prapa follower-ëve të tij, sepse ai është ruajtur në disk më herët se të tjerët.
Ribashkimi me klasterin
Gjatë ribashkimit me klasterin, replikat veprojnë njësoj si në rastin e dështimit të liderit: kontrollojnë replikën e liderit dhe e shkurtojnë log-un e tyre deri te HW i tij (në momentin e zgjedhjes). Për krahasim, RabbitMQ i trajton nyjet e ribashkuara njësoj si nyje krejtësisht të reja. Në të dyja rastet, broker-i hedh poshtë çdo gjendje ekzistuese. Nëse përdoret sinkronizimi automatik, atëherë master duhet të replikojë të gjithë përmbajtjen aktuale në pasqyrën e re me qasjen «le të presë gjithë bota». Gjatë këtij operacioni, master nuk pranon asnjë operacion leximi apo shkrimi. Një qasje e tillë krijon probleme në radhë të mëdha.
Kafka është një log i shpërndarë dhe, në përgjithësi, ruan më shumë mesazhe sesa radha RabbitMQ, ku të dhënat hiqen nga radha pasi lexohen. Radhët aktive duhet të mbeten relativisht të vogla. Por Kafka është një log me politikën e vet të ruajtjes, e cila mund të përcaktojë një afat prej ditësh ose javësh. Qasja me bllokimin e radhës dhe sinkronizimin e plotë është krejtësisht e papranueshme për një log të shpërndarë. Në vend të kësaj, follower-at e Kafka thjesht e shkurtojnë log-un e tyre deri te HW e leader-it (në momentin e zgjedhjes së tij) nëse kopja e tyre është më përpara se leader-i. Në rastin më të mundshëm, kur follower-i mbetet pas, ai thjesht nis të bëjë kërkesa fetch duke filluar nga LEO i tij aktual.
Follower-at e rinj ose të rilidhur nisin jashtë ISR dhe nuk marrin pjesë në commit-e. Ata thjesht punojnë paralelisht me grupin, duke marrë mesazhe sa më shpejt që munden, derisa të arrijnë leader-in dhe të hyjnë në ISR. Këtu nuk ka bllokim dhe nuk ka nevojë të hidhen poshtë të gjitha të dhënat e tyre.
Ndërprerja e lidhjes
Kafka ka më shumë komponentë se RabbitMQ, prandaj këtu ka një grup sjelljesh më kompleks kur në cluster prishet lidhja. Por Kafka është projektuar që në fillim për cluster-a, ndaj zgjidhjet janë menduar shumë mirë.
Më poshtë janë disa skenarë të ndërprerjes së lidhjes:
- Skenari 1. Follower-i nuk e sheh leader-in, por ende e sheh Zookeeper.
- Skenari 2. Leader-i nuk sheh asnjë follower, por ende e sheh Zookeeper.
- Skenari 3. Follower-i e sheh leader-in, por nuk e sheh Zookeeper.
- Skenari 4. Leader-i i sheh follower-at, por nuk e sheh Zookeeper.
- Skenari 5. Follower-i është plotësisht i ndarë si nga nyjet e tjera Kafka, ashtu edhe nga Zookeeper.
- Skenari 6. Leader-i është plotësisht i ndarë si nga nyjet e tjera Kafka, ashtu edhe nga Zookeeper.
- Skenari 7. Nyja e controller-it Kafka nuk e sheh një nyje tjetër Kafka.
- Skenari 8. Controller-i Kafka nuk e sheh Zookeeper.
Për secilin skenar është parashikuar sjellja përkatëse.
Skenari 1. Follower-i nuk e sheh leader-in, por ende e sheh Zookeeper
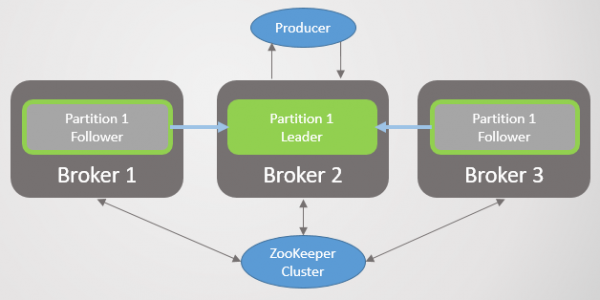
Fig. 22. Skenari 1. ISR me tre replika
Ndërprerja e lidhjes e ndan broker-in 3 nga broker-at 1 dhe 2, por jo nga Zookeeper. Broker-i 3 nuk mund të dërgojë më kërkesa fetch. Pas skadimit të kohës replica.lag.time.max.ms ai hiqet nga ISR dhe nuk merr pjesë në commit-et e mesazheve. Sapo lidhja të rikthehet, ai do të rifillojë kërkesat fetch dhe do t’i bashkohet ISR-së kur të arrijë liderin. Zookeeper do të vazhdojë të marrë ping-e dhe do të konsiderojë se brokeri është aktiv dhe funksionon normalisht.
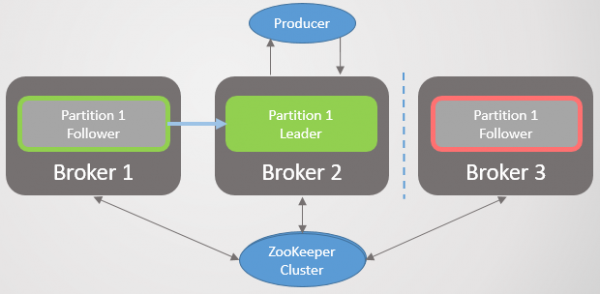
Fig. 23. Skenari 1. Brokeri hiqet nga ISR nëse nuk merret asnjë kërkesë fetch prej tij brenda intervalit replica.lag.time.max.ms
Nuk ka asnjë ndarje logjike (split-brain) ose pezullim të nyjës, si në RabbitMQ. Në vend të kësaj, zvogëlohet redundanca.
Skenari 2. Lideri nuk sheh asnjë follower, por ende sheh Zookeeper
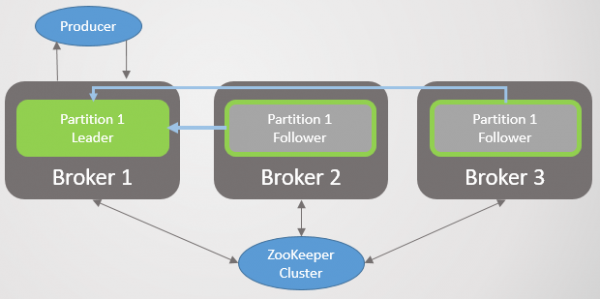
Fig. 24. Skenari 2. Lideri dhe dy follower
Një ndërprerje e lidhjes së rrjetit e ndan liderin nga follower-at, por brokeri ende sheh Zookeeper. Ashtu si në skenarin e parë, ISR tkurret, por këtë herë vetëm deri te lideri, sepse të gjithë follower-at ndalojnë së dërguari kërkesa fetch. Sërish, nuk ka asnjë ndarje logjike. Në vend të kësaj, ndodh humbje e redundancës për mesazhet e reja derisa lidhja të rikthehet. Zookeeper vazhdon të marrë ping-e dhe konsideron se brokeri është aktiv dhe funksionon normalisht.
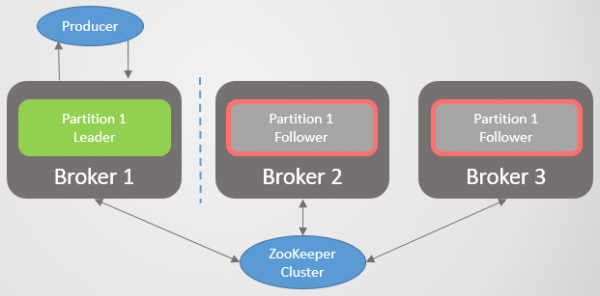
Fig. 25. Skenari 2. ISR u tkurr vetëm deri te lideri
Skenari 3. Follower-i sheh liderin, por nuk sheh Zookeeper
Follower-i ndahet nga Zookeeper, por jo nga brokeri lider. Si rezultat, follower-i vazhdon të bëjë kërkesa fetch dhe të mbetet anëtar i ISR-së. Zookeeper nuk merr më ping-e dhe regjistron rënien e brokerit, por meqë ky është vetëm një follower, pas rikthimit nuk ka pasoja.
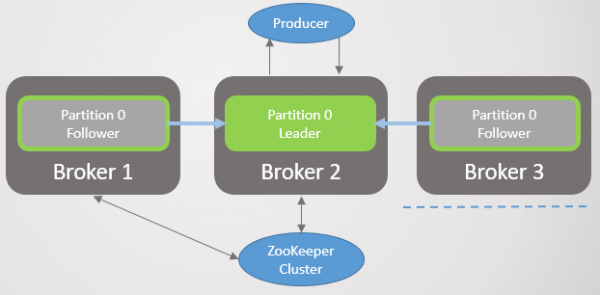
Fig. 26. Skenari 3. Follower-i vazhdon t’i dërgojë liderit kërkesa fetch
Skenari 4. Lideri sheh follower-at, por nuk sheh Zookeeper
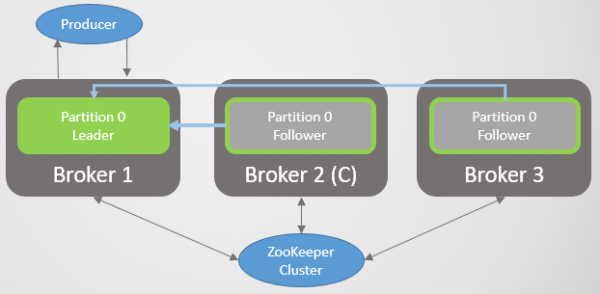
Fig. 27. Skenari 4. Lideri dhe dy follower
Lideri është i ndarë nga Zookeeper, por jo nga brokerët follower.
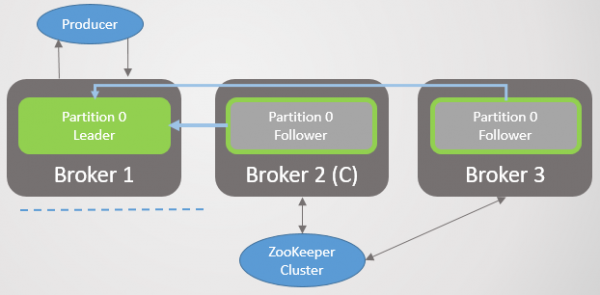
Fig. 28. Skenari 4. Lideri është i izoluar nga Zookeeper
Pas një kohe, Zookeeper do të regjistrojë rënien e brokerit dhe do ta njoftojë kontrolluesin për këtë. Ky i fundit do të zgjedhë një lider të ri nga follower-at. Megjithatë, lideri fillestar do të vazhdojë të mendojë se është lider dhe do të vazhdojë të pranojë shkrime me acks=1. Follower-at nuk do t’i dërgojnë më kërkesa fetch, ndaj ai do t’i konsiderojë të vdekur dhe do të përpiqet ta tkurrojë ISR vetëm te vetja. Por meqë nuk ka lidhje me Zookeeper, nuk do të mund ta bëjë këtë dhe në atë moment do të refuzojë të pranojë shkrime të mëtejshme.
Mesazhet acks=all nuk do të marrin konfirmim, sepse fillimisht ISR përfshin të gjitha replikat, ndërsa mesazhet nuk arrijnë deri te ato. Kur lideri fillestar të përpiqet t’i heqë ato nga ISR, ai nuk do të mund ta bëjë këtë dhe do të ndalojë së pranuari çdo mesazh.
Klientët e vërejnë shpejt ndryshimin e liderit dhe nisin të dërgojnë regjistrime në serverin e ri. Sapo rrjeti të rikthehet, lideri fillestar sheh se nuk është më lider dhe e shkurton log-un e tij deri te vlera HW që kishte lideri i ri në momentin e ndërprerjes, për të shmangur mospërputhjet në log. Më pas ai do të nisë të dërgojë kërkesa fetch te lideri i ri. Humbasin të gjitha regjistrimet e liderit fillestar që nuk janë replikuar te lideri i ri. Kjo do të thotë se do të humben mesazhet që nuk u konfirmuan nga lideri fillestar gjatë atyre pak sekondave kur funksionuan dy liderë.
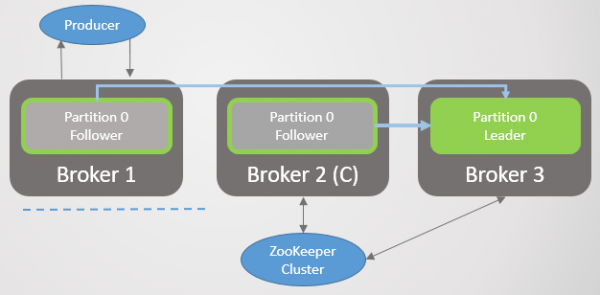
Fig. 29. Skenari 4. Lideri në brokerin 1 bëhet follower pas rikthimit të rrjetit
Skenari 5. Follower është plotësisht i ndarë si nga nyjat e tjera Kafka, ashtu edhe nga Zookeeper
Follower është plotësisht i izoluar si nga nyjat e tjera Kafka, ashtu edhe nga Zookeeper. Ai thjesht hiqet nga ISR derisa rrjeti të rikthehet, dhe më pas arrin pjesën tjetër.

Fig. 30. Skenari 5. Follower-i i izoluar hiqet nga ISR
Skenari 6. Lideri është plotësisht i ndarë si nga nyjat e tjera Kafka, ashtu edhe nga Zookeeper
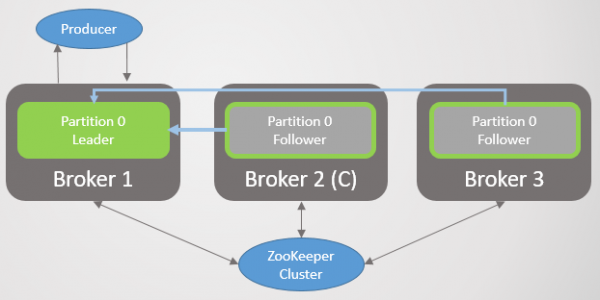
Fig. 31. Skenari 6. Lideri dhe dy followers
Lideri është plotësisht i izoluar nga followers-at e tij, kontrolluesi dhe Zookeeper. Për një periudhë të shkurtër ai do të vazhdojë të pranojë regjistrime nga acks=1.
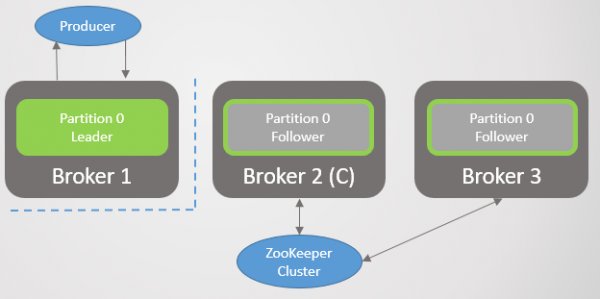
Fig. 32. Skenari 6. Izolimi i liderit nga nyjat e tjera Kafka dhe Zookeeper
Pa marrë kërkesa pas skadimit të replica.lag.time.max.ms, ai do të përpiqet ta reduktojë ISR vetëm te vetja, por nuk do të mund ta bëjë këtë, sepse nuk ka lidhje me Zookeeper, ndaj do të ndalojë së pranuari regjistrime.
Ndërkohë, Zookeeper do ta shënojë brokerin e izoluar si të vdekur, ndërsa kontrolluesi do të zgjedhë një lider të ri.
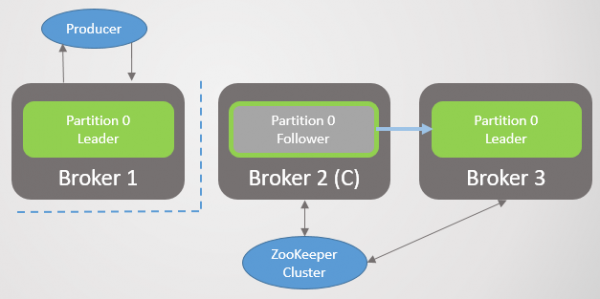
Fig. 33. Skenari 6. Dy liderë
Lideri fillestar mund të pranojë regjistrime për disa sekonda, por më pas ndalon së pranuari çdo mesazh. Klientët përditësohen çdo 60 sekonda me metadata-t më të fundit. Ata do të njoftohen për ndryshimin e liderit dhe do të fillojnë të dërgojnë regjistrime te lideri i ri.
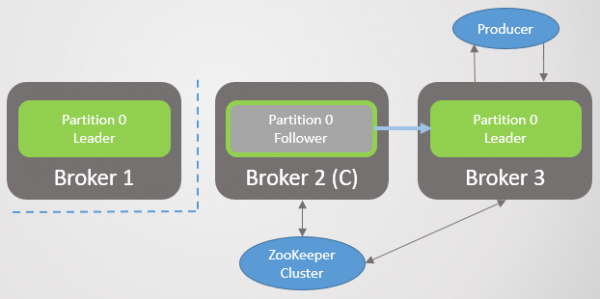
Fig. 34. Skenari 6. Producer-at kalojnë te lideri i ri
Të gjitha regjistrimet e konfirmuara, të bëra nga lideri fillestar që nga momenti i humbjes së lidhjes, do të humbasin. Sapo rrjeti të rikthehet, lideri fillestar do të zbulojë përmes Zookeeper se nuk është më lider. Më pas do ta shkurtojë log-un e vet deri te HW e liderit të ri në momentin e zgjedhjes dhe do të nisë të dërgojë kërkesa si follower.
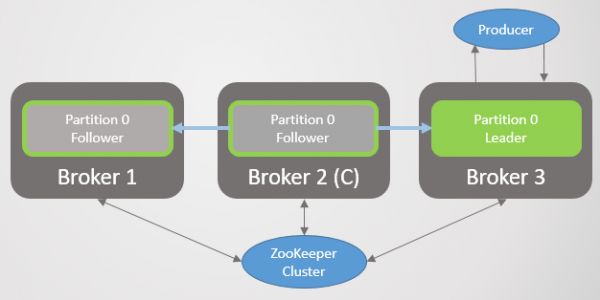
Fig. 35. Skenari 6. Lideri fillestar bëhet follower pas rikthimit të lidhjes së rrjetit
Në këtë situatë, për një periudhë të shkurtër mund të vërehet një ndarje logjike, por vetëm nëse acks=1 dhe min.insync.replicas është gjithashtu 1. Ndarja logjike përfundon automatikisht ose pas rikthimit të rrjetit, kur lideri fillestar e kupton se nuk është më lider, ose kur të gjithë klientët e kuptojnë se lideri ka ndryshuar dhe fillojnë të shkruajnë te lideri i ri — varësisht se cila ndodh më parë. Në çdo rast, do të ketë humbje të disa mesazheve, por vetëm nga acks=1.
Ekziston edhe një variant tjetër i këtij skenari, kur menjëherë para ndarjes së rrjetit followers kishin mbetur prapa dhe lideri e kishte ngjeshur ISR vetëm te vetja. Më pas ai izolohet për shkak të humbjes së lidhjes. Zgjidhet një lider i ri, por lideri fillestar vazhdon të pranojë regjistrime, edhe acks=all, sepse në ISR nuk ka askënd tjetër përveç tij. Këto regjistrime do të humbasin pas rikthimit të rrjetit. E vetmja mënyrë për ta shmangur këtë variant është — min.insync.replicas = 2.
Skenari 7. Nyja e kontrolluesit Kafka nuk e sheh një nyje tjetër Kafka
Në përgjithësi, pas humbjes së lidhjes me një nyje Kafka, kontrolluesi nuk do të mund t’i transmetojë asnjë informacion për ndryshimin e liderit. Në rastin më të keq, kjo do të çojë në një ndarje logjike afatshkurtër, si në skenarin 6. Më shpesh, broker-i thjesht nuk do të bëhet kandidat për lidership në rast dështimi të këtij të fundit.
Skenari 8. Kontrolluesi Kafka nuk e sheh Zookeeper
Nga kontrolluesi i shkëputur, Zookeeper nuk do të marrë ping dhe do të zgjedhë si kontrollues një nyje të re Kafka. Kontrolluesi fillestar mund të vazhdojë ta konsiderojë veten të tillë, por ai nuk merr njoftime nga Zookeeper, prandaj nuk do të ketë asnjë detyrë për të ekzekutuar. Sapo rrjeti të rikthehet, ai do ta kuptojë se nuk është më kontrollues, por është bërë një nyje e zakonshme Kafka.
Përfundime nga skenarët
Shohim se humbja e lidhjes së follower-ëve nuk çon në humbje mesazhesh, por vetëm ul përkohësisht tepricën derisa rrjeti të rikthehet. Kjo, sigurisht, mund të çojë në humbje të të dhënave nëse humbasin një ose më shumë nyje.
Nëse për shkak të humbjes së lidhjes lideri ndahet nga Zookeeper, kjo mund të çojë në humbje mesazhesh me acks=1. Mungesa e lidhjes me Zookeeper shkakton një ndarje logjike afatshkurtër me dy liderë. Kjo problematikë zgjidhet nga parametri acks=all.
Parametri min.insync.replicas në dy ose më shumë replika jep garanci shtesë që skenarë të tillë afatshkurtër nuk do të çojnë në humbje mesazhesh, si në skenarin 6.
Përmbledhje mbi humbjen e mesazheve
Le të rendisim të gjitha mënyrat se si mund të humben të dhënat në Kafka:
- Çdo dështim i liderit, nëse mesazhet konfirmoheshin me acks=1
- Çdo kalim i papastër (unclean) i lidershipit, pra te një follower jashtë ISR, edhe me acks=all
- Izolimi i liderit nga Zookeeper, nëse mesazhet konfirmoheshin me acks=1
- Izolimi i plotë i liderit, i cili tashmë e ka ngushtuar grupin ISR vetëm te vetja. Do të humben të gjitha mesazhet, edhe acks=all. Kjo është e vërtetë vetëm nëse min.insync.replicas=1.
- Dështime të njëkohshme të të gjitha nyjeve të ndarjes. Meqë mesazhet konfirmohen nga memoria, disa prej tyre mund të mos jenë shkruar ende në disk. Pas rinisjes së serverëve, disa mesazhe mund të mungojnë.
Kalimet e papastra të lidershipit mund të shmangen ose duke i ndaluar ato, ose duke siguruar tepricë prej të paktën dy replikash. Konfigurimi më i qëndrueshëm është kombinimi i acks=all dhe min.insync.replicas më shumë se 1.
Krahasim i drejtpërdrejtë i besueshmërisë së RabbitMQ dhe Kafka
Për të garantuar besueshmëri dhe disponueshmëri të lartë, të dyja platformat zbatojnë një sistem replikimi primar dhe sekondar. Megjithatë, RabbitMQ ka një pikë të dobët kritike. Kur nyjet ribashkohen pas një dështimi, ato i hedhin poshtë të dhënat e tyre dhe sinkronizimi bllokohet. Ky goditje e dyfishtë vë në pikëpyetje qëndrueshmërinë e radhëve të mëdha në RabbitMQ. Do t’ju duhet të pranoni ose uljen e tepricës, ose bllokime të gjata. Ulja e tepricës rrit rrezikun e humbjes masive të të dhënave. Por nëse radhët janë të vogla, për të ruajtur tepricën me periudha të shkurtra mosdisponueshmërie (disa sekonda), kjo mund të përballohet me riprovime të lidhjes.
Në Kafka nuk ka një problem të tillë. Ajo hedh poshtë të dhënat vetëm nga pika ku lideri dhe follower-i fillojnë të ndryshojnë. Të gjitha të dhënat e përbashkëta ruhen. Për më tepër, replikimi nuk e bllokon sistemin. Lideri vazhdon të pranojë shkrime ndërsa follower-i i ri e arrin, kështu që për DevOps bashkimi ose ribashkimi i cluster-it bëhet një detyrë triviale. Sigurisht, mbeten ende çështje të tilla si gjerësia e brezit të rrjetit gjatë replikimit. Nëse shtohen njëkohësisht disa follower-a, mund të përballeni me kufirin e bandwidth-it.
RabbitMQ e tejkalon Kafka në besueshmëri kur ndodh dështim i njëkohshëm i disa serverëve në cluster. Siç e thamë tashmë, RabbitMQ i dërgon publisher-it konfirmim vetëm pasi mesazhi të shkruhet në disk te master-i dhe te të gjitha pasqyrat. Por kjo shton vonesë shtesë për dy arsye:
- fsync çdo disa qindra milisekonda
- Dështimi i pasqyrës mund të zbulohet vetëm pasi të kalojë koha e jetës së paketave që kontrollojnë disponueshmërinë e çdo nyje (net tick). Nëse pasqyra ngadalësohet ose bie, kjo shton vonesë.
Kafka mbështetet te ideja se, nëse një mesazh ruhet në disa nyje, mesazhet mund të konfirmohen sapo të kenë arritur në memorie. Për këtë arsye ekziston rreziku i humbjes së mesazheve të çdo lloji (madje edhe acks=all, min.insync.реплики=2) në rast dështimi të njëkohshëm.
Në përgjithësi, Kafka tregon performancë më të lartë dhe që në fillim është projektuar për cluster-a. Numri i follower-ëve mund të rritet deri në 11, nëse kjo kërkohet për besueshmëri. Një faktor replikimi 5 dhe numri minimal i replikave në gjendje të sinkronizuar min.insync.replicas=3 do ta bëjnë humbjen e një mesazhi një ngjarje shumë të rrallë. Nëse infrastruktura juaj mund të sigurojë një faktor të tillë replikimi dhe këtë nivel redundance, mund të zgjidhni këtë variant.
Cluster-izimi i RabbitMQ është i mirë për radhë të vogla. Por edhe radhët e vogla mund të rriten shpejt kur trafiku është i lartë. Sapo radhët bëhen të mëdha, do t’ju duhet të bëni një zgjedhje të vështirë midis disponueshmërisë dhe besueshmërisë. Cluster-izimi i RabbitMQ është më i përshtatshëm për situata jo shumë tipike, ku avantazhet e fleksibilitetit të RabbitMQ i tejkalojnë çdo mangësi të cluster-izimit të tij.
Një nga mënyrat për të zbutur dobësinë e RabbitMQ ndaj radhëve shumë të mëdha është ndarja e tyre në shumë më të vogla. Nëse nuk kërkohet renditja e plotë e gjithë radhës, por vetëm e mesazheve përkatëse (për shembull, mesazhet e një klienti të caktuar), ose nëse renditja nuk është fare e nevojshme, atëherë kjo qasje është e pranueshme: shikoni projektin tim për ndarjen e radhës (projekti është ende në fazë të hershme).
Së fundi, mos harroni për një sërë gabimesh në mekanizmat e klasterizimit dhe replikimit si te RabbitMQ, ashtu edhe te Kafka. Me kalimin e kohës, sistemet janë bërë më të pjekura dhe më të qëndrueshme, por asnjë mesazh nuk do të jetë kurrë 100% i mbrojtur nga humbja! Për më tepër, në qendrat e të dhënave ndodhin edhe avari në shkallë të gjerë!
Nëse kam lënë diçka pa përmendur, kam bërë ndonjë gabim ose nuk pajtoheni me cilindo nga pohimet, mos hezitoni të lini një koment ose të më kontaktoni.
Shpesh më pyesin: «Çfarë të zgjedh, Kafka apo RabbitMQ?», «Cila platformë është më e mirë?». E vërteta është se kjo varet vërtet nga situata juaj, përvoja aktuale e kështu me radhë. Nuk guxoj të jap një mendim të prerë, sepse do të ishte një thjeshtim i tepruar të rekomandoja një platformë të vetme për të gjitha rastet e përdorimit dhe kufizimet e mundshme. E kam shkruar këtë seri artikujsh që të mund të formoni mendimin tuaj.
Dua të them se të dy sistemet janë liderë në këtë fushë. Ndoshta jam pak i njëanshëm, sepse nga përvoja në projektet e mia prirem të vlerësoj më shumë gjëra si renditja e garantuar e mesazheve dhe besueshmëria.
Shoh teknologji të tjera që nuk e kanë këtë besueshmëri dhe këtë renditje të garantuar, pastaj shoh RabbitMQ dhe Kafka — dhe kuptoj vlerën e jashtëzakonshme të të dy këtyre sistemeve.
Burimi: habr.com
